日语学习作答数据集:2026 年 8 月
📢 已有新版:日语学习作答汇总数据集・2026 年 10 月(v2.0.0,543,344 笔作答)。v2 使用不同的分析集合,与本页数字不能直接相减;本页 v1.1.0 的数字维持不变,可继续引用。
一句话:这是 Nihongo to Japan 站上 56,613 笔匿名作答纪录的汇总统计,来自 1,053 个匿名 learner identifiers、11,987 道题目。
⚠️ 这是 2026 年 8 月的 snapshot,不是 2026 全年研究。 数据只涵盖 2026 年 8 月 2 日至 13 日,共 12 天(汇总管线 8 月 2 日才上线,第一天为部分日)。 这份数据里没有任何长期趋势可读。版本 1.1.0,snapshot 冻结于 2026-08-14。
关于「learner identifiers」:这是浏览器端随机产生的匿名识别码,跨装置无法合并。同一个人使用手机与电脑会产生两个 identifier,因此 1,053 不是经验证的不重复自然人数,只是人数的上界。本页全文一律用「learner identifiers」而不是「人」。
先讲清楚这份数据不是什么。这不是台湾日语学习者的代表性调查。样本是「会主动来这个网站刷题的人」,是自选的观察性样本。所有数字只描述「在 NTJ 的这批作答里发生了什么」,不能外推到任何母体。详见限制。
可直接引用的十条发现
以下每一条都是自足的:句子本身已带数据集名称、snapshot 时间、样本数与信赖区间,记者或研究者可以单独复制任何一条使用,不必再回头找上下文。所有数字都是本数据集内的观察值(主要分析集合为「测验情境首答」,定义见方法),不是对日语学习者母体的推论,也不含任何因果宣称。引用时请一并带上限制。
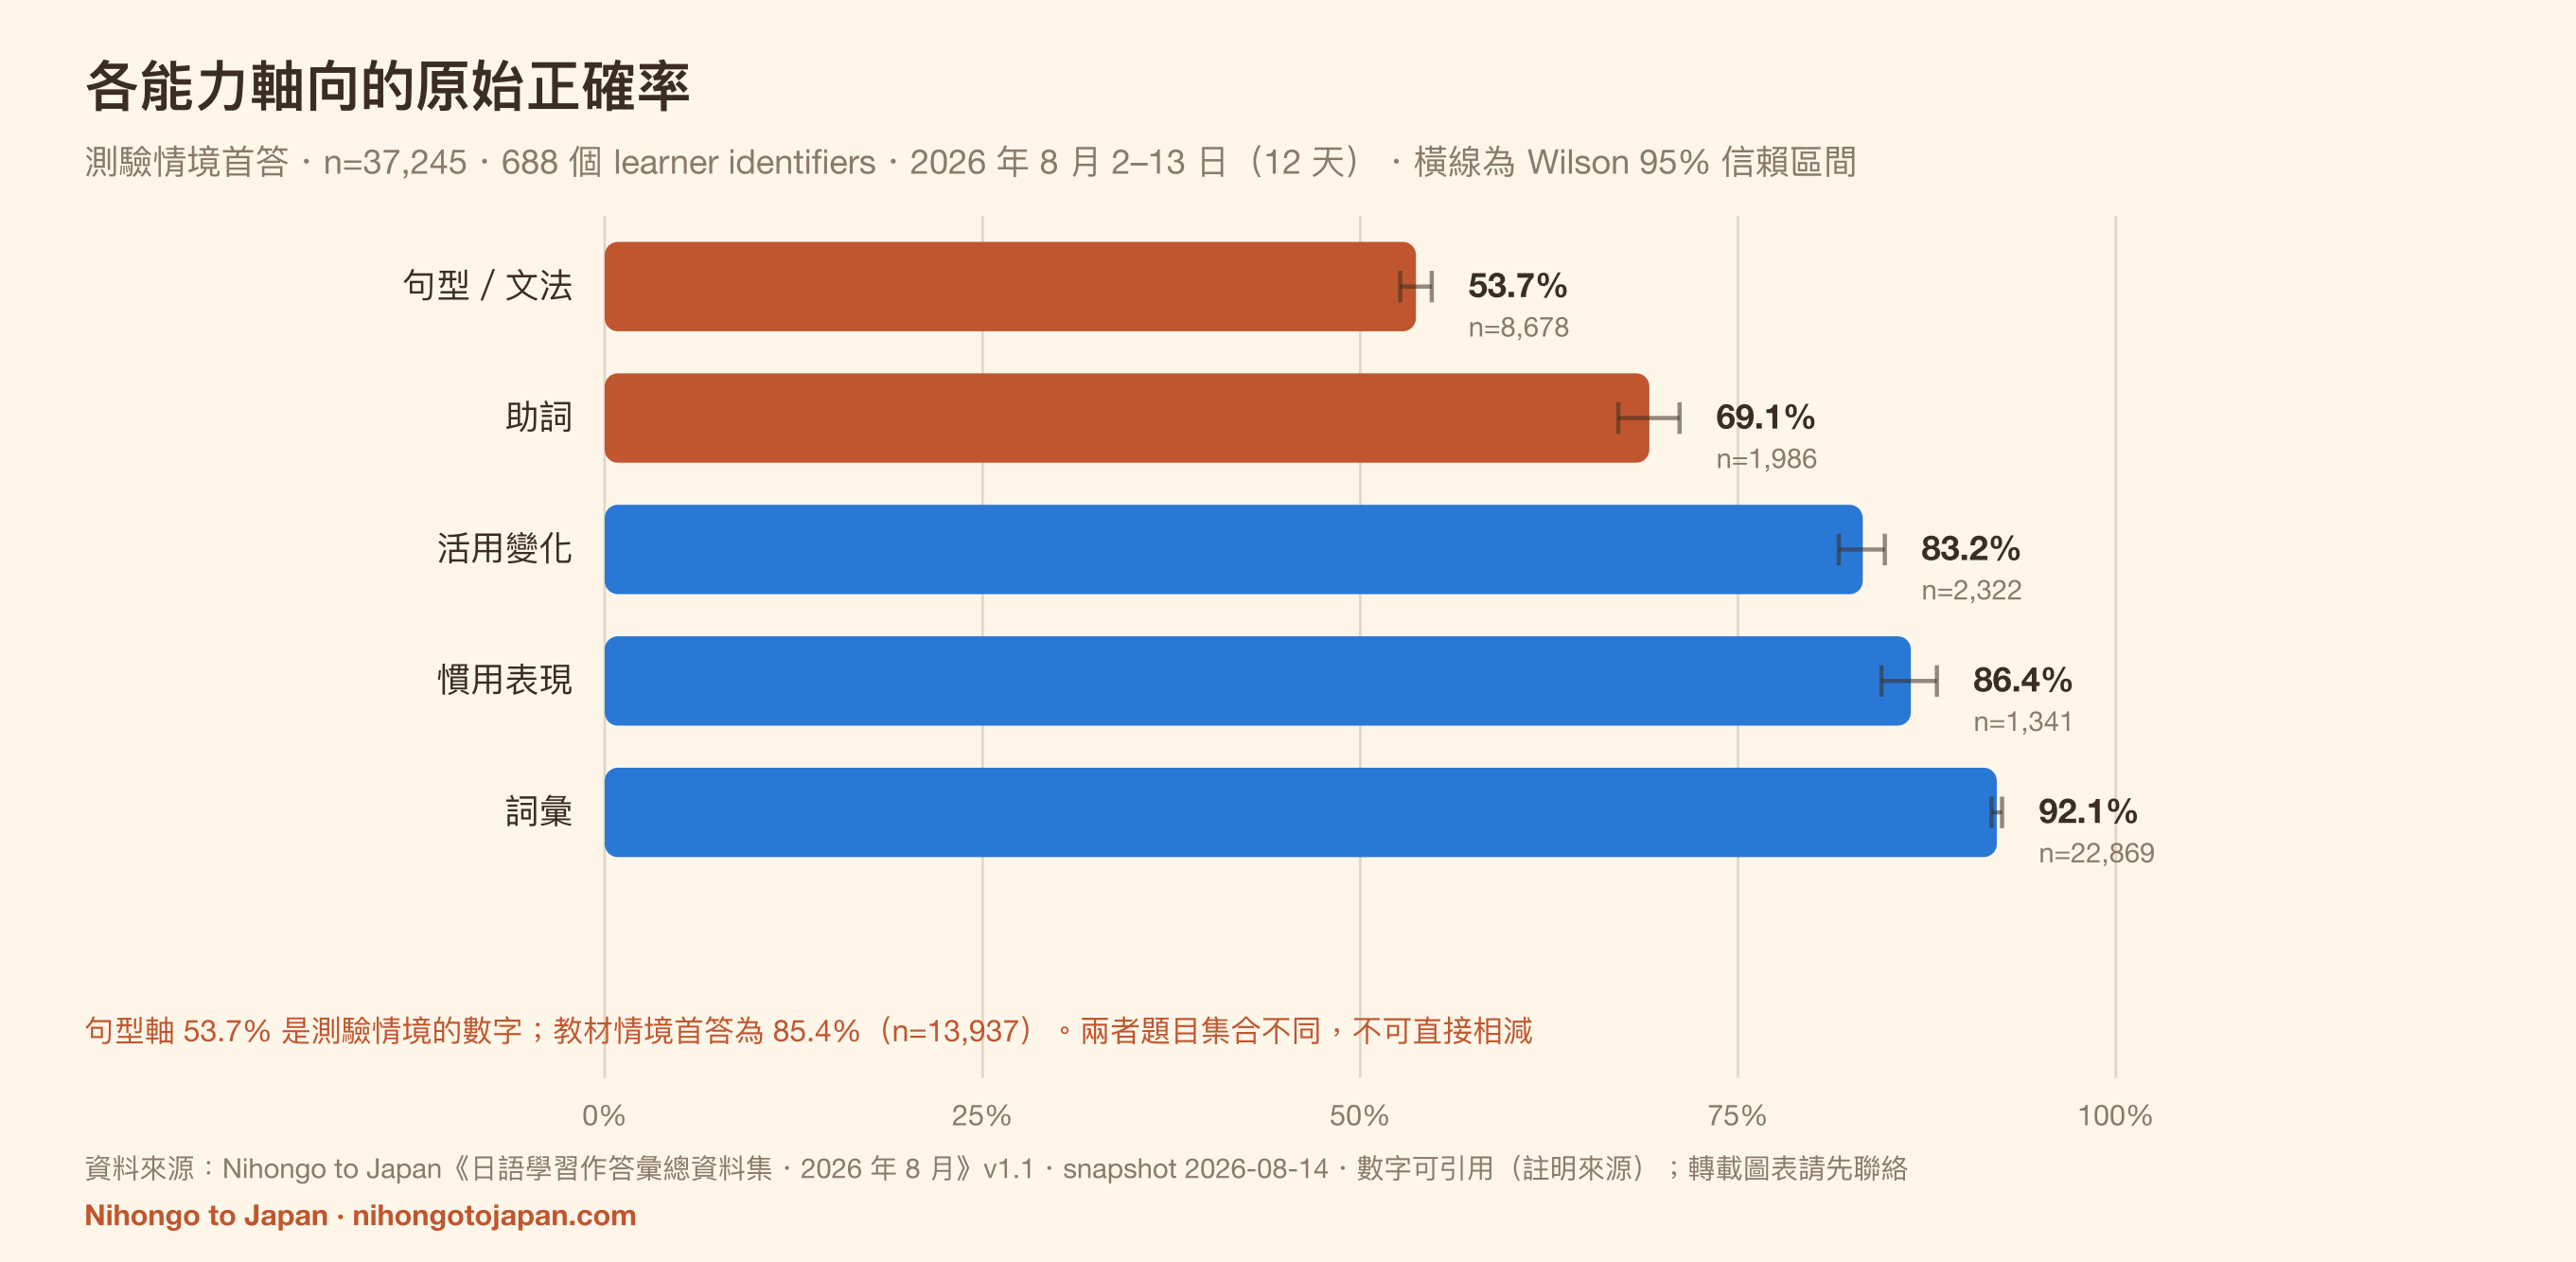
- 在 NTJ 日语学习作答汇总数据集(2026 年 8 月 snapshot,12 天)的测验情境首答中,句型/语法题的正确率为 53.7%(n=8,678,Wilson 95% CI 52.6%–54.7%),词汇题为 92.1%(n=22,869,95% CI 91.8%–92.5%),两者相差 38 个百分点。
两个区间完全不重叠,差距不是抽样杂讯;成因本报告不做宣称。 - 在同一份数据集的测验情境首答中,五个能力轴向由低到高依序为:句型/语法 53.7%(n=8,678)、助词 69.1%(n=1,986,95% CI 67.1%–71.1%)、活用变化 83.2%(n=2,322,95% CI 81.7%–84.7%)、惯用表现 86.4%(n=1,341,95% CI 84.5%–88.2%)、词汇 92.1%(n=22,869)。
各轴向的题目集合不同,这是观察到的正确率排序,不是难度排序。 - 在同一份数据集中,句型/语法轴观察到的正确率会因为纳入哪些作答而落在 53.7% 到 85.4% 之间:测验情境首答 53.7%(n=8,678)、教材情境首答 85.4%(n=13,937)、全部作答 74.1%(n=24,293)。
两种情境几乎使用互不重叠的题目集合(5,772 道句型题中只有 6 道两边都出现过),因此无法把情境效果与题目难度差异分开。这条的重点是:引用学习平台的正确率时,必须问清楚纳入了哪些作答。 - 在同一份数据集的测验情境首答中,N3 的原始正确率为 67.8%(n=5,985,95% CI 66.6%–69.0%),N2 为 69.4%(n=2,726,95% CI 67.6%–71.1%);两者的信赖区间重叠,这份数据无法区分 N2 与 N3。
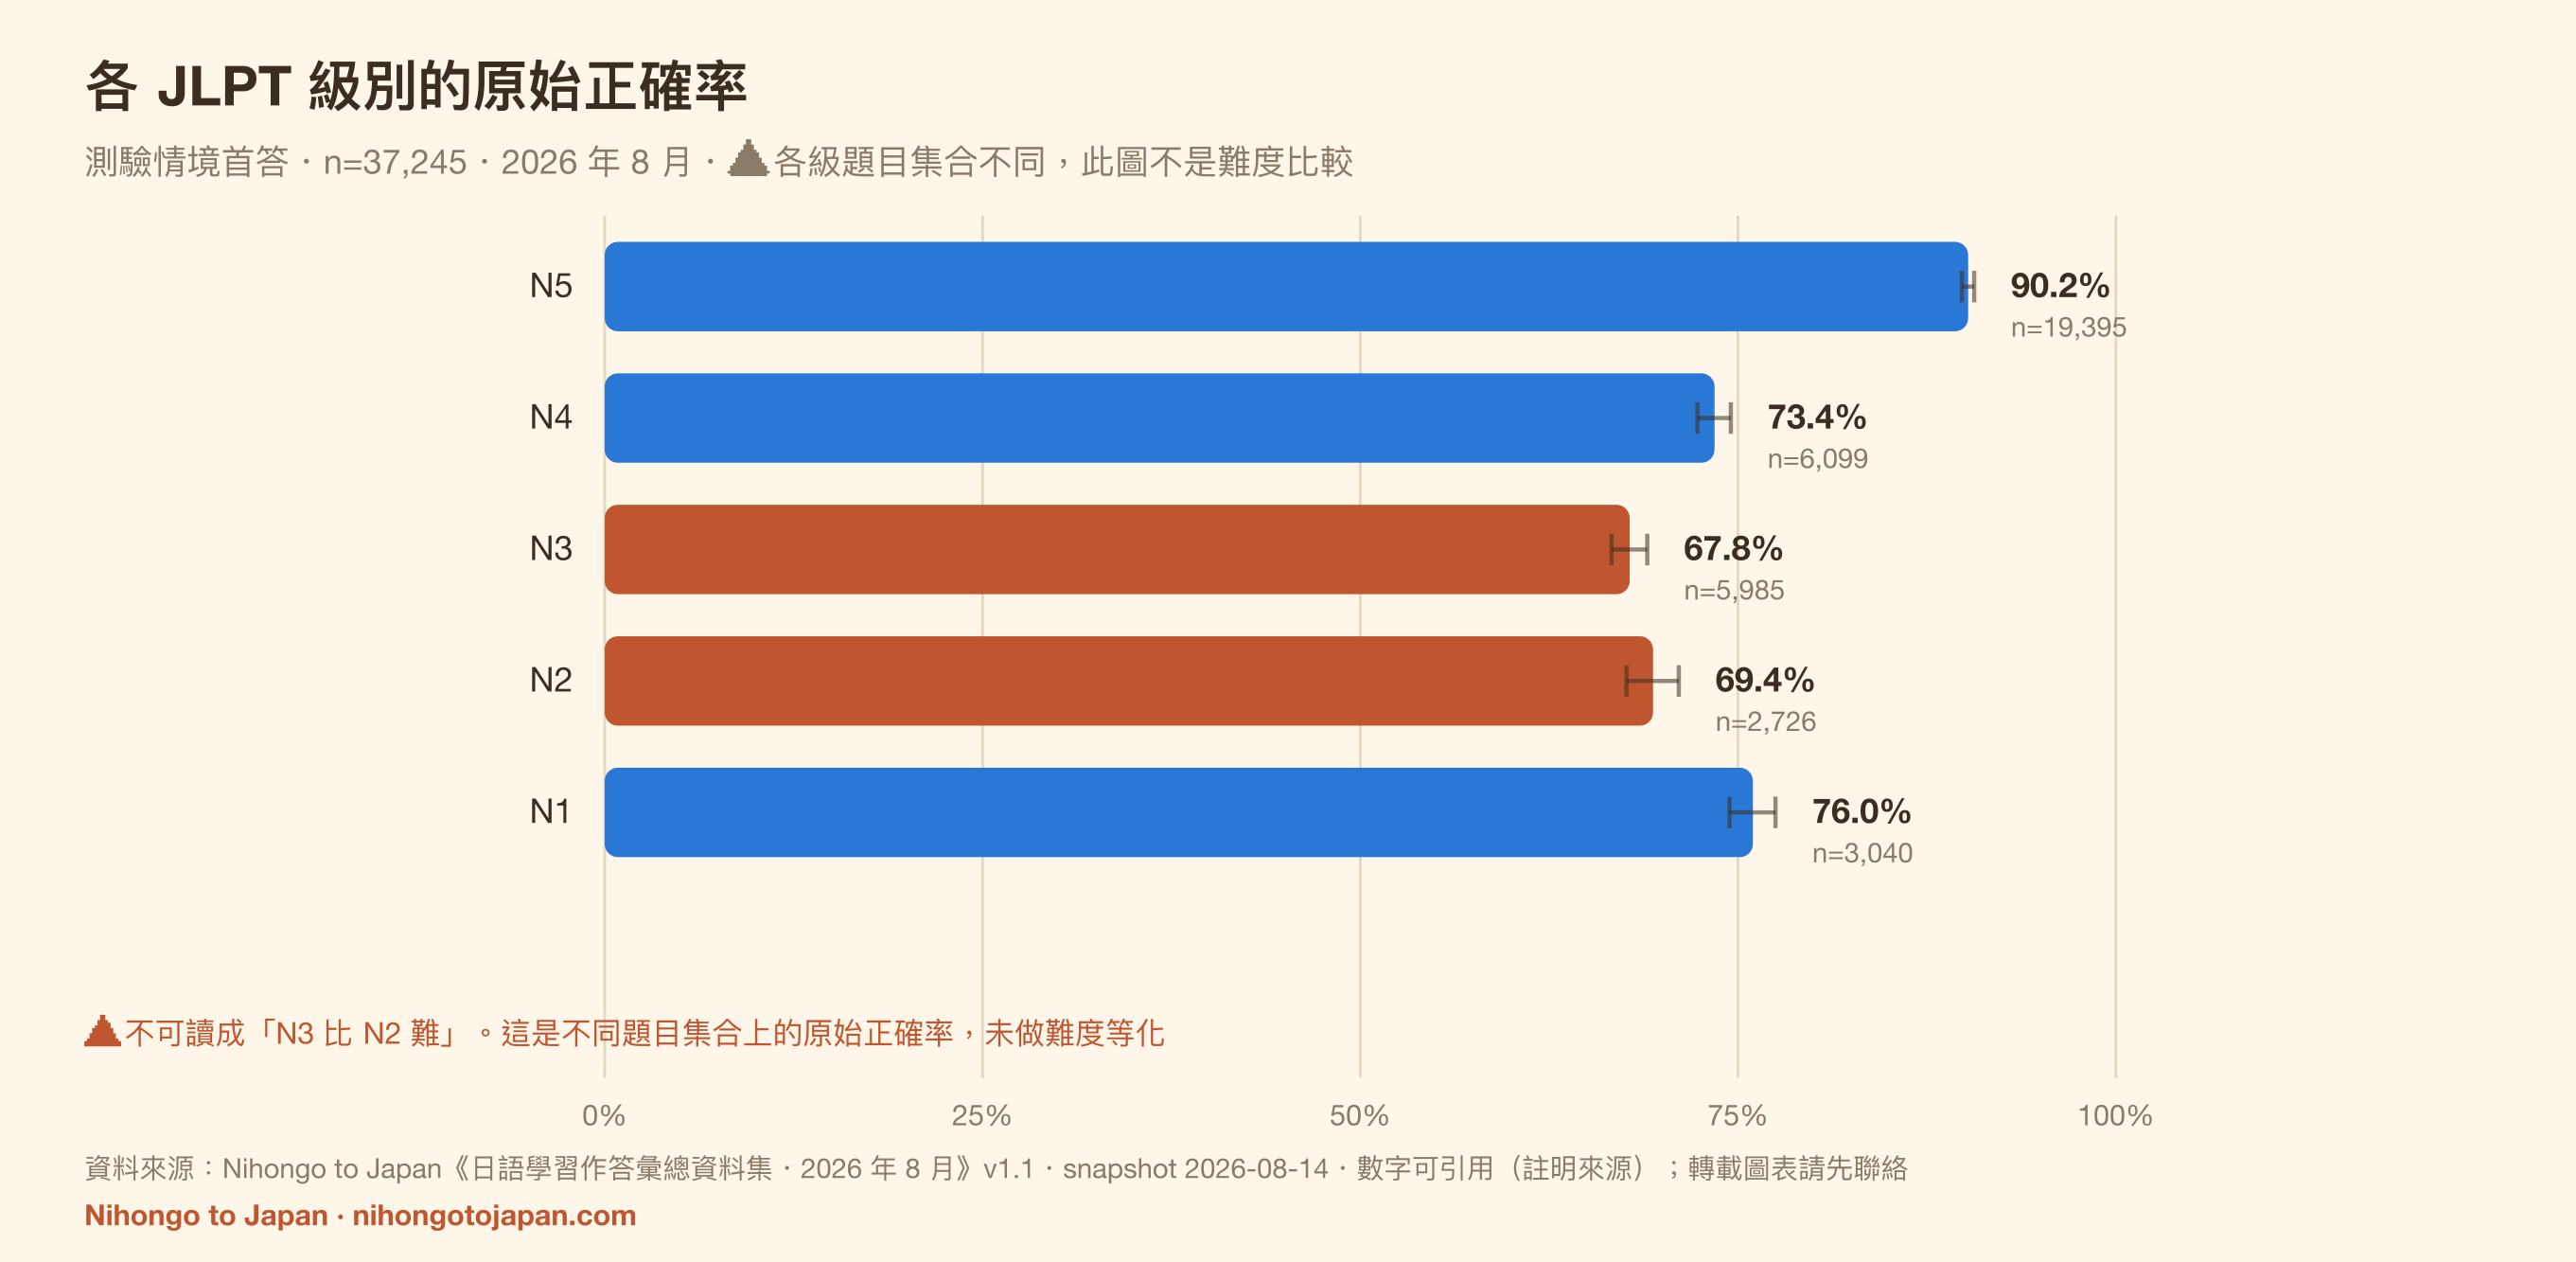
不可写成「N2 比 N3 难」或「N3 比 N2 难」。 - 在同一份数据集的测验情境首答中,各 JLPT 级别的原始正确率为 N5 90.2%(n=19,395)、N1 76.0%(n=3,040)、N4 73.4%(n=6,099)、N2 69.4%(n=2,726)、N3 67.8%(n=5,985)——N1 的原始正确率高于 N2 与 N3。
各级题目集合不同、没有 IRT 难度等化、作答者为自选样本(会挑战 N1 题的多半已有较高程度),因此这串数字不能当成 JLPT 级别的客观难度。 - 在同一份数据集的测验情境首答中,助词内部的落差比级别之间更大:助词「が」正确率 60.9%(n=358,95% CI 55.8%–65.8%)、助词「を」78.7%(n=385,95% CI 74.3%–82.5%),相差 17.8 个百分点,而 N3(67.8%)与 N4(73.4%)之间只差 5.6 个百分点。
对教学设计的意涵是:以「级别」为单位分配练习量,可能比以「知识点」为单位粗糙。 - 在同一份数据集的测验情境首答中,句型/语法轴在每一个 JLPT 级别都是最低的能力轴向:N5 64.0%(n=1,939)、N4 48.0%(n=1,734)、N3 49.2%(n=2,531)、N2 51.1%(n=1,179)、N1 57.0%(n=1,295)。
同一批作答者在同一级别的词汇题正确率为 N5 94.4%、N4 89.0%、N3 84.0%、N2 85.0%、N1 89.2%。 - 在同一份数据集中,用同一批 372 个 learner identifiers、同一批 34,392 笔作答计算:以「每题一票」(事件加权)得到 82.53%,以「每人一票」(identifier 等权)得到 75.49%,相差 7.04 个百分点。
两个数字用完全相同的母体与集合,差异纯粹来自加权方式。任何引用学习平台正确率的报导都应标明用的是哪一种。 - 在同一份数据集中,作答量高度集中:单一 learner identifier 最多占全部 56,613 笔作答的 3.73%,前 10 个 identifiers 合计占 19.44%。
这是「每题一票」与「每人一票」会差 7 个百分点的直接原因,也是所有学习平台数据共有的结构性偏误。 - 在同一份数据集中,针对在两种情境都有作答的 75 个 learner identifiers(每边至少 5 笔)做配对比较:教材情境 86.57%(n=5,858)、测验情境 55.52%(n=2,055),配对平均差 27.47 个百分点(95% CI 22.56–32.39)。
这说明情境之间的差距不是由 learner 组成不同造成的;但同题比较做不到(见第 3 条),所以仍无法把情境效果与题目难度分开。
以上每一条的展开、完整表格与图表,见以下各节。想直接拿数字的人请看下载数据;要引用请看引用方式;有问题请看联系窗口。
一、五个主要发现
1. 句型是唯一低于六成的能力轴向,和词汇差了 38 个百分点
在测验情境首答中(见方法的集合定义),词汇题正确率 92.1%(n=22,869,627 个 learner identifiers,95% CI 91.8%–92.5%),句型题只有 53.7%(n=8,678,532 个 identifiers,95% CI 52.6%–54.7%)。
两者的信赖区间相距极远,这不是抽样杂讯。数据只说明两个轴向的正确率差距很大;至于为什么,本报告不做因果宣称。
2. 句型轴的「正确率」在 53.7% 到 74.1% 之间,取决于纳入哪些作答
在不同 analysis-set 定义下,句型轴观察到的正确率从 53.7%(测验情境首答,n=8,678)到 74.1%(全部作答,n=24,293)。由于纳入的事件与 learner identifier 组成不同,不能把全部差异解读为单一计算规则造成。
逐级拆解:
| 步骤 | n | 原始正确率 | 相对前一步 |
|---|---|---|---|
| 全部作答 | 24,293 | 74.1% | — |
| → 只留每题首答 | 22,638 | 73.2% | -0.87 pp |
| → 只留测验情境(排除教材/复习) | 8,678 | 53.7% | -19.54 pp |
| (对照)教材情境首答 | 13,937 | 85.4% | — |
去掉重复作答只移动 0.9 个百分点;其余几乎全部来自「教材情境」与「测验情境」的差异。
同一批 learner identifier 的成对比较:75 个 identifier 在两种情境各有 ≥5 笔句型首答。他们在教材情境 86.6%(n=5,858)、在测验情境 55.5%(n=2,055),成对平均差 +27.5 pp(95% CI 22.6–32.4,中位数 +26.9)。所以差异不是单纯由「哪些人在答」造成。
⚠️ 同题比较做不到,所以无法下定论。5,772 道句型题里,只有 6 道在两种情境都出现过,其中只有 1 道两边各达 3 笔。两种情境使用几乎互不重叠的题目集合,因此无法把「情境效果」与「题目本身难易」分开。教材情境的题目可能就是比较简单。
能诚实说的只有:引用学习平台的「正确率」时,一定要问是哪一个 analysis set。四个集合的数字都在可下载数据里。
3. N3 与 N2 的原始正确率最低,但两者无法被这份数据区分
测验情境首答的各级别原始正确率:N5 90.2%、N4 73.4%、N3 67.8%、N2 69.4%、N1 76.0%。
N3(95% CI 66.6%–69.0%)与 N2(95% CI 67.6%–71.1%)的信赖区间重叠,所以不能说「N3 比 N2 难」。能说的是:在这批数据里,N2 与 N3 的原始正确率都低于 N4、N1 与 N5。
⚠️ 更重要的是:各级别的题目集合完全不同,这个排序不是难度比较,也不是「哪一级比较难」的证据。
4. 助词内部的落差比级别之间更大
单一助词在测验情境首答的正确率:が 60.9%(n=358,CI 55.8%–65.8%)、に 62.4%(n=370)、で 63.3%(n=330),而 を 78.7%(n=385,CI 74.3%–82.5%)、の 83.3%(n=120)。
が 与 を 的信赖区间不重叠,落差 18 个百分点。
5. 「每人一票」和「每题一票」差 7.04 个百分点
在完全相同的 372 个 learner identifiers、相同分析集合、相同 34,392 笔 eligible events 上计算:
| 加权方式 | 正确率 |
|---|---|
| 事件加权(每一题一票) | 82.5% |
| identifier 加权(每个 identifier 一票) | 75.5%(中位数 76.2%) |
| WEIGHTING_EFFECT_PP | 7.04 pp |
cohort 定义:主要分析集合中作答数 ≥20 的 learner identifiers。两个数字的分子分母来自同一群 identifier,所以这个差值真的只反映加权方式,不掺杂样本组成差异。
原因是重复测量:最活跃的单一 identifier 就占了全部作答的 3.7%,前 10 名合计 19.4%。任何用学习平台数据谈「学习者表现」的研究都会碰到这件事,所以我们把两个数字都给出来。
二、数据集概观
| 项目 | 数值 |
|---|---|
| 有效作答事件 | 56,613 |
| 匿名 learner identifiers(人数上界) | 1,053 |
| 不重复题目 | 11,987 |
| 知识点数 | 39 |
| 数据期间 | 2026-08-02 ~ 2026-08-13(12 天),第一天为部分日 |
| Snapshot 冻结时间 | 2026-08-14T00:00:00Z |
| 首次作答事件(First attempt) | 52,934 |
| 测验情境首答(主要分析集合) | 37,245 |
| 主要集合的 learner identifiers | 688 |
| 教材情境首答(对照集合) | 15,741 |
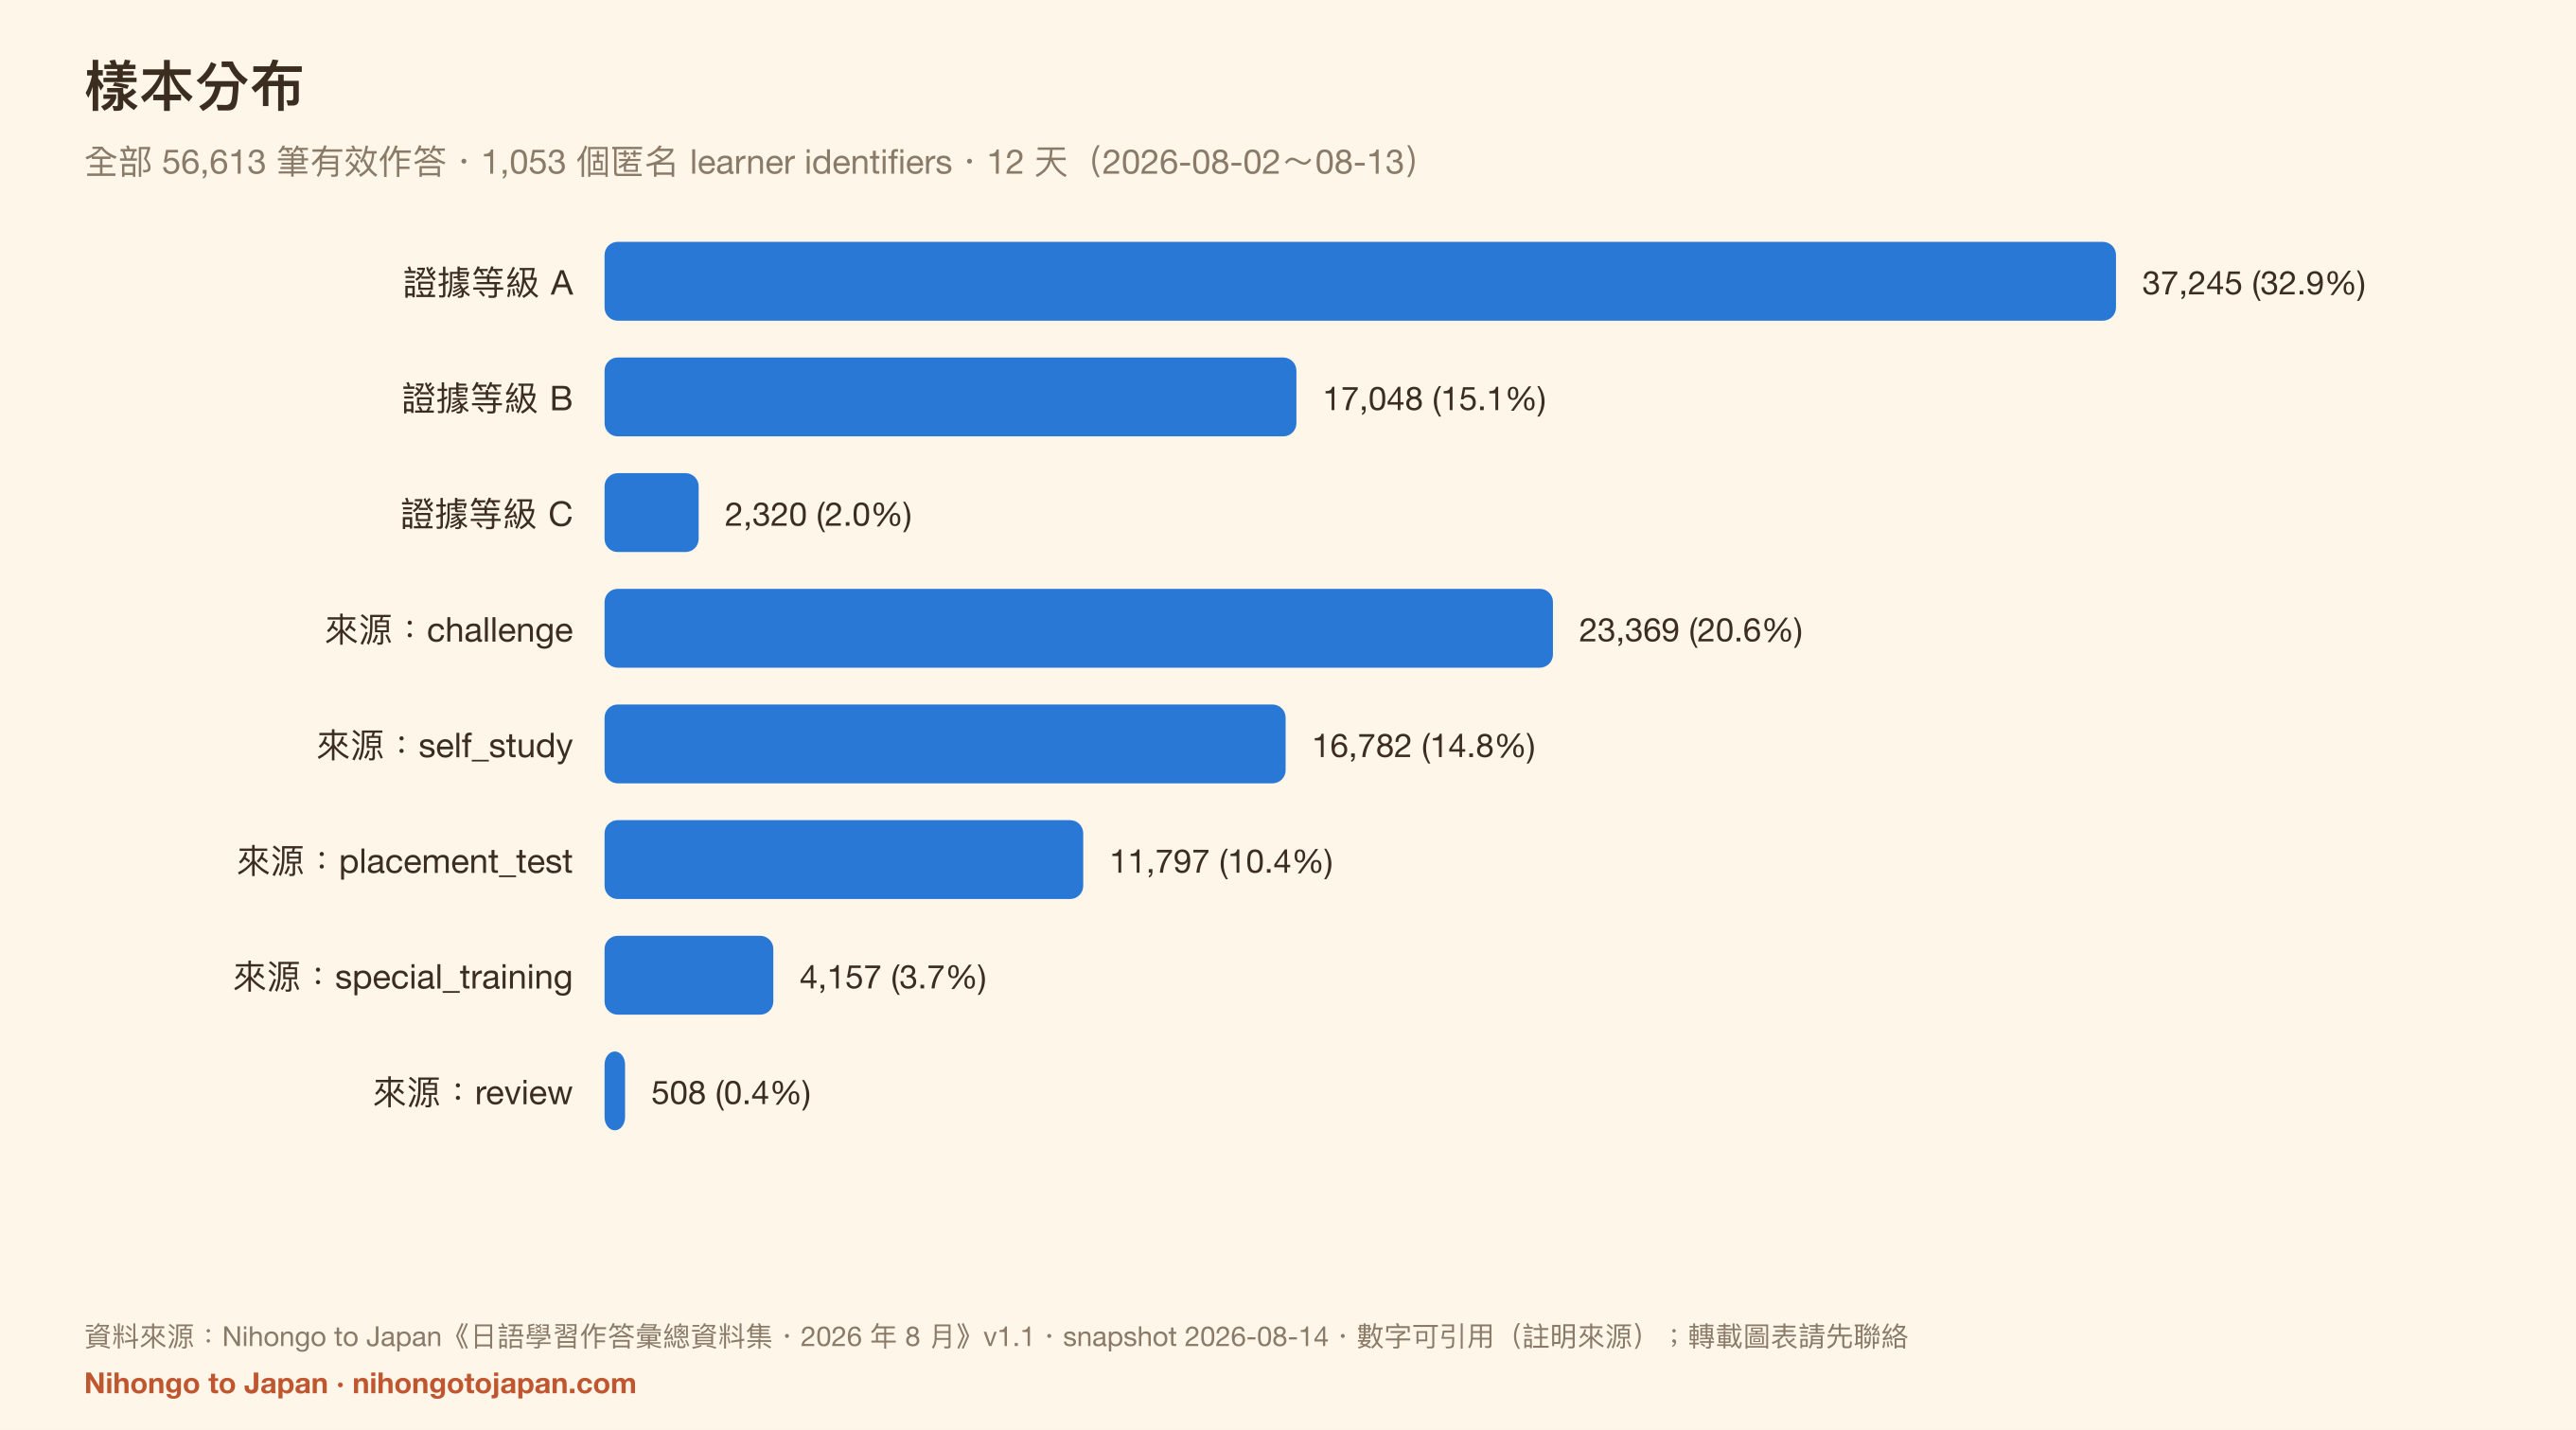
作答来源分布:challenge 23,369(41.3%)、self_study 16,782(29.6%)、placement_test 11,797(20.8%)、special_training 4,157(7.3%)、review 508(0.9%)。
数据库 evidence_class 栏位分布(这是数据表的原始栏位,不是本报告的分析集合名称):A 37,245(65.8%)、B 17,048(30.1%)、C 2,320(4.1%)。主要分析集合等同 evidence_class = A。

三、各能力轴向的正确率

| 能力轴向 | n | identifiers | 原始正确率 | 95% CI | 标记 |
|---|---|---|---|---|---|
| 句型/语法 | 8,678 | 532 | 53.7% | 52.6%–54.7% | OK |
| 助词 | 1,986 | 137 | 69.1% | 67.1%–71.1% | OK |
| 活用变化 | 2,322 | 386 | 83.2% | 81.7%–84.7% | OK |
| 惯用表现 | 1,341 | 261 | 86.4% | 84.5%–88.2% | OK |
| 词汇 | 22,869 | 627 | 92.1% | 91.8%–92.5% | OK |
以下轴向样本过小,依最小格数规则(n<30 或学习者<5)不公开正确率,只公开事件数:综合(n=27,8 个 identifiers)、读解(n=22,4 个 identifiers)。
四、各 JLPT 级别的正确率
⚠️ 这一节最容易被误读。各级别的题目集合完全不同,而且没有做 IRT 难度等化。下面的数字是「在这批题目上答对的比例」,不是「哪一级比较难」的度量。

| JLPT 级别 | n | identifiers | 原始正确率 | 95% CI |
|---|---|---|---|---|
| N5 | 19,395 | 380 | 90.2% | 89.8%–90.6% |
| N4 | 6,099 | 313 | 73.4% | 72.3%–74.5% |
| N3 | 5,985 | 432 | 67.8% | 66.6%–69.0% |
| N2 | 2,726 | 212 | 69.4% | 67.6%–71.1% |
| N1 | 3,040 | 139 | 76.0% | 74.4%–77.5% |
四种分析集合的对照(原始正确率):
| 级别 | 测验情境首答(主要) | 教材情境首答 | 全情境首答 | 全部作答 |
|---|---|---|---|---|
| N5 | 90.2%(n=19,395) | 83.7%(n=11,154) | 87.8%(n=30,495) | 88.2%(n=33,286) |
| N4 | 73.4%(n=6,099) | 83.1%(n=2,694) | 76.5%(n=8,758) | 76.6%(n=9,262) |
| N3 | 67.8%(n=5,985) | 82.1%(n=1,507) | 70.8%(n=7,522) | 71.1%(n=7,727) |
| N2 | 69.4%(n=2,726) | 79.2%(n=260) | 70.2%(n=2,985) | 70.5%(n=3,072) |
| N1 | 76.0%(n=3,040) | 86.5%(n=126) | 76.4%(n=3,174) | 76.5%(n=3,266) |
五、正确率最低的知识点
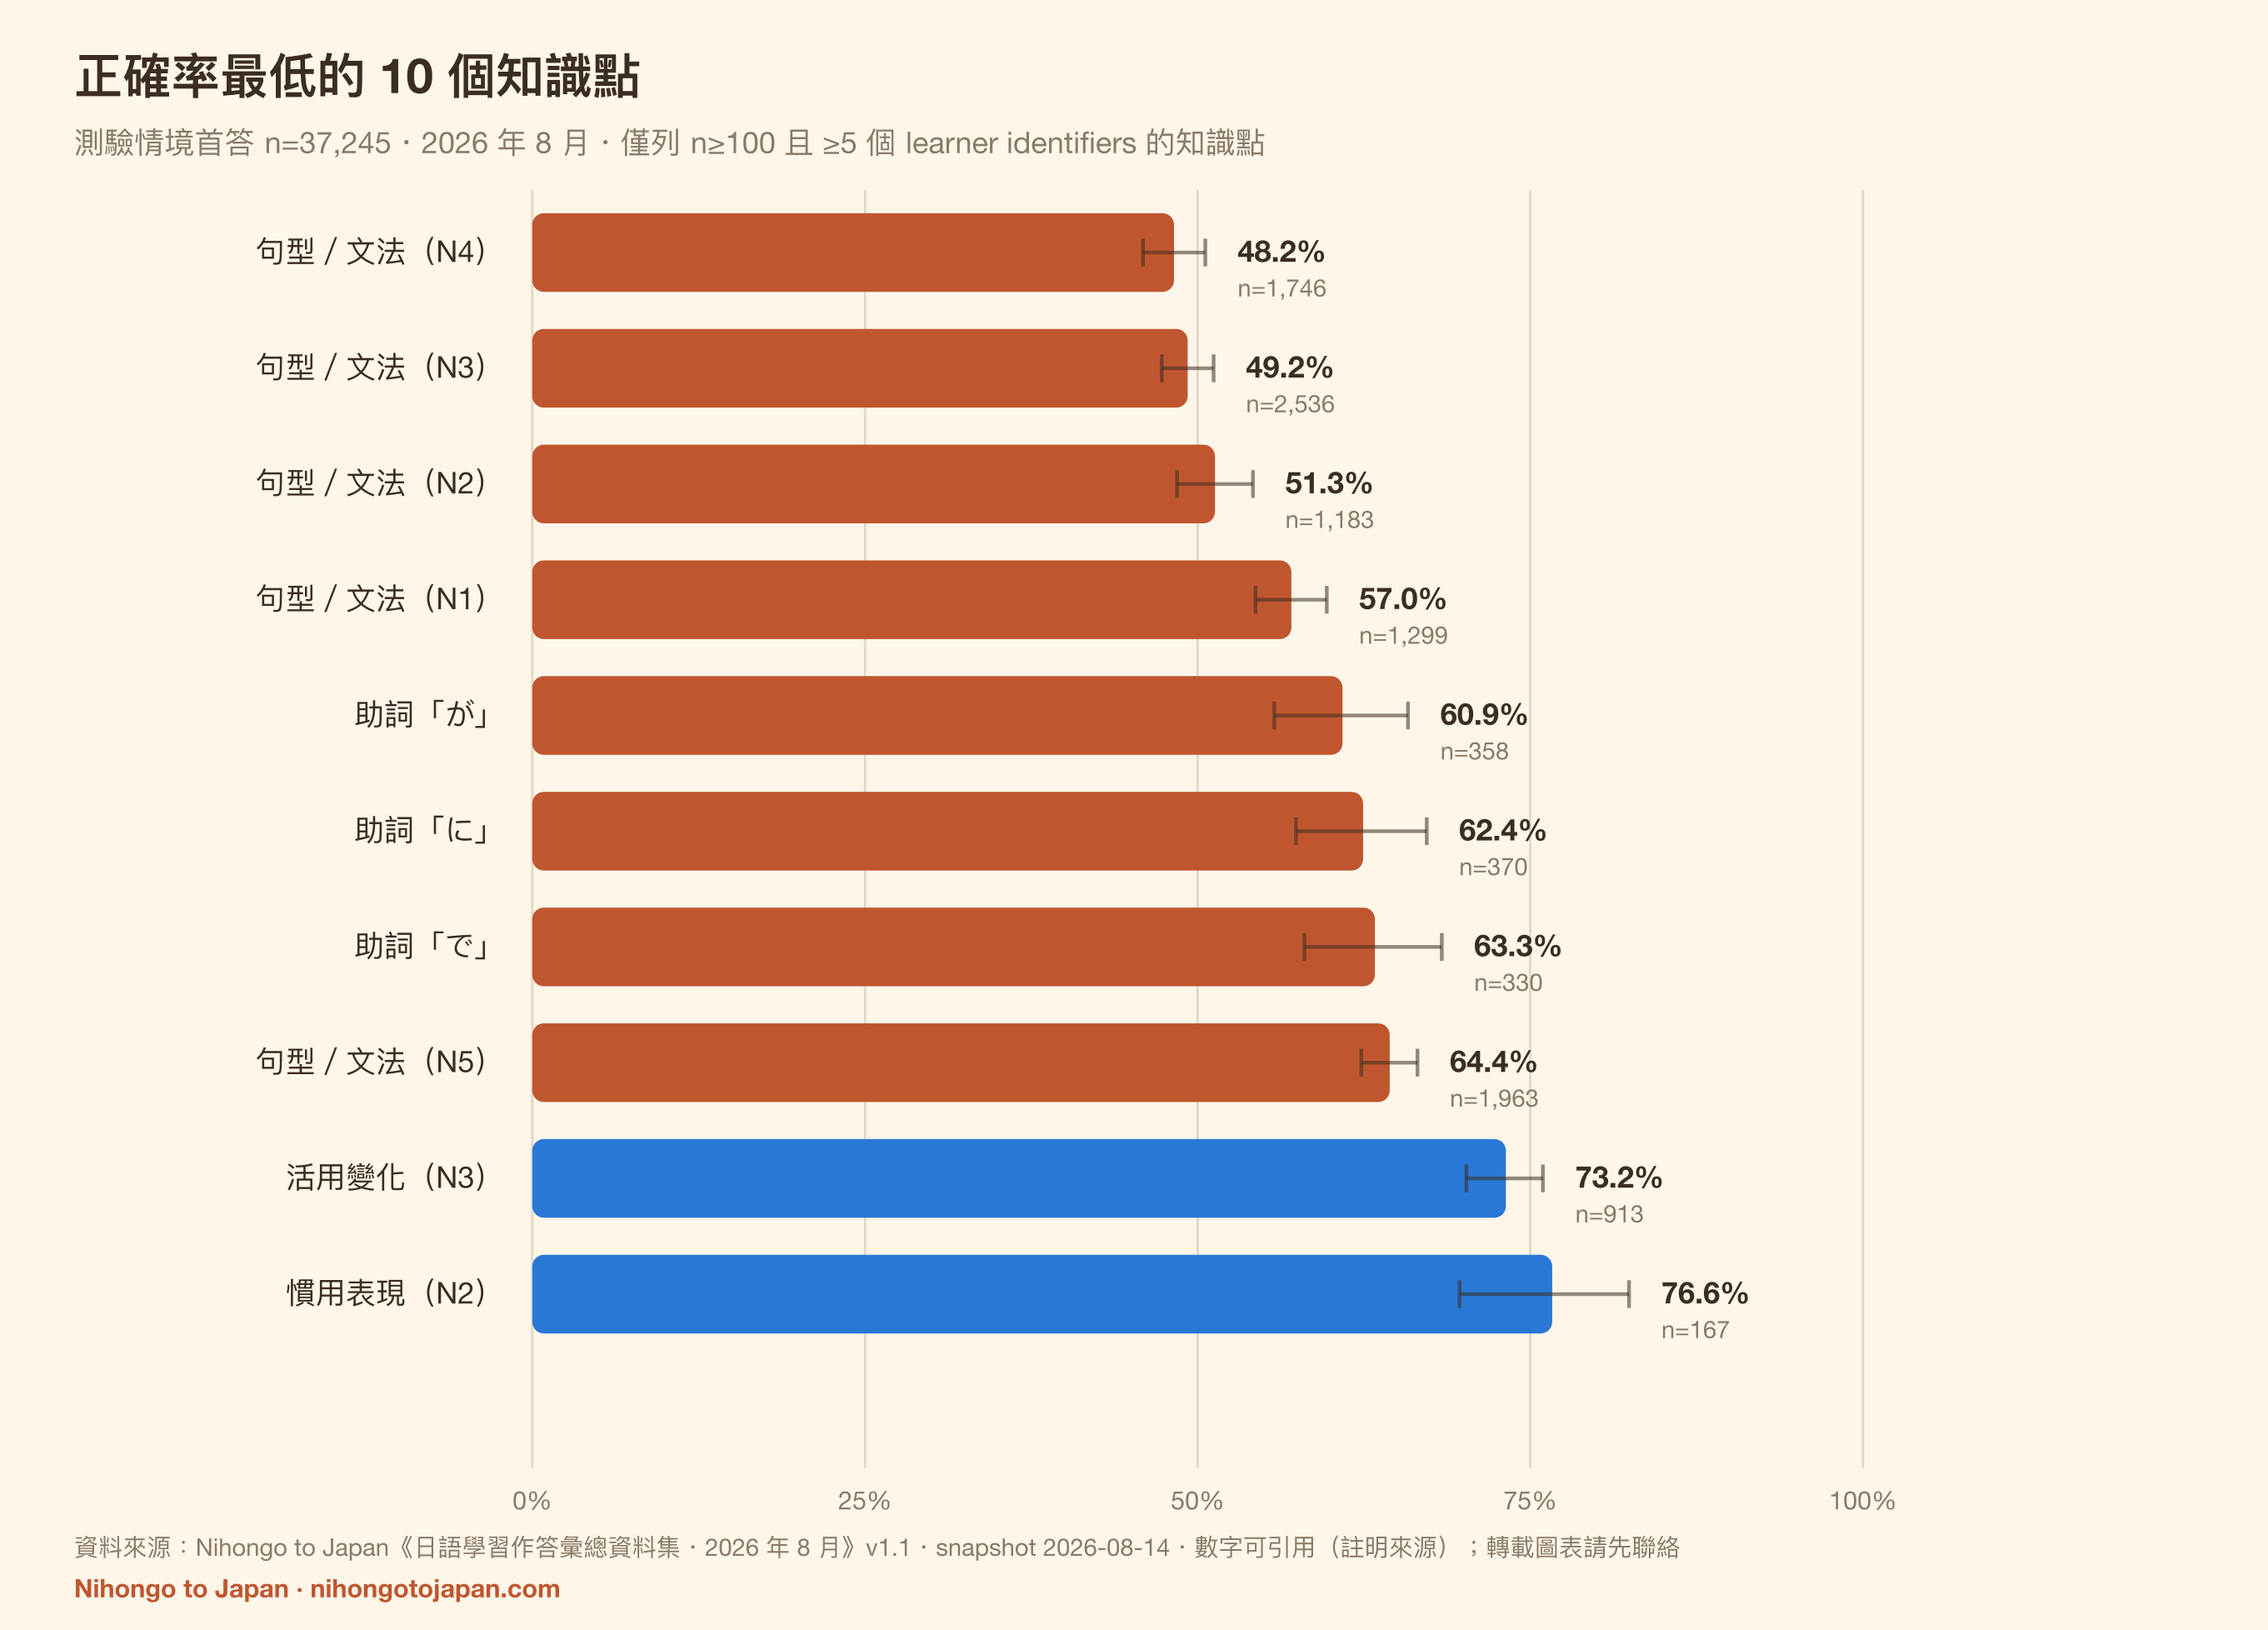
只列入 n≥100 且学习者≥5 的知识点(共 23 个符合)。排序附上 n、级别与类别,不只看百分比——样本小的格子看起来极端,往往只是杂讯。

| # | 知识点 | 类别 | 级别 | n | identifiers | 原始正确率 | 95% CI |
|---|---|---|---|---|---|---|---|
| 1 | 句型/语法(N4) | 句型/语法 | N4 | 1,746 | 234 | 48.2% | 45.9%–50.6% |
| 2 | 句型/语法(N3) | 句型/语法 | N3 | 2,536 | 390 | 49.2% | 47.3%–51.2% |
| 3 | 句型/语法(N2) | 句型/语法 | N2 | 1,183 | 191 | 51.3% | 48.5%–54.1% |
| 4 | 句型/语法(N1) | 句型/语法 | N1 | 1,299 | 118 | 57.0% | 54.3%–59.7% |
| 5 | 助词「が」 | 助词 | — | 358 | 81 | 60.9% | 55.8%–65.8% |
| 6 | 助词「に」 | 助词 | — | 370 | 75 | 62.4% | 57.4%–67.2% |
| 7 | 助词「で」 | 助词 | — | 330 | 85 | 63.3% | 58.0%–68.3% |
| 8 | 句型/语法(N5) | 句型/语法 | N5 | 1,963 | 209 | 64.4% | 62.3%–66.5% |
| 9 | 活用变化(N3) | 活用变化 | N3 | 913 | 294 | 73.2% | 70.2%–75.9% |
| 10 | 惯用表现(N2) | 惯用表现 | N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| 11 | 助词「を」 | 助词 | — | 385 | 61 | 78.7% | 74.3%–82.5% |
| 12 | 活用变化(N2) | 活用变化 | N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
六、最稳定的强项
| # | 知识点 | 类别 | 级别 | n | identifiers | 原始正确率 | 95% CI |
|---|---|---|---|---|---|---|---|
| 1 | 活用变化(N1) | 活用变化 | N1 | 296 | 79 | 95.6% | 92.6%–97.4% |
| 2 | 词汇(N5) | 词汇 | N5 | 16,029 | 311 | 94.4% | 94.0%–94.8% |
| 3 | 词汇(N1) | 词汇 | N1 | 703 | 94 | 89.2% | 86.7%–91.3% |
| 4 | 词汇(N4) | 词汇 | N4 | 2,828 | 243 | 89.0% | 87.8%–90.1% |
| 5 | 惯用表现(N1) | 惯用表现 | N1 | 742 | 111 | 88.8% | 86.3%–90.9% |
| 6 | 活用变化(N4) | 活用变化 | N4 | 461 | 149 | 87.0% | 83.6%–89.8% |
| 7 | 惯用表现(N4) | 惯用表现 | N4 | 140 | 91 | 86.4% | 79.8%–91.1% |
| 8 | 惯用表现(N3) | 惯用表现 | N3 | 290 | 142 | 85.9% | 81.4%–89.4% |
七、值得注意的观察
观察 A:N1 的原始正确率高于 N2 与 N3
N1 76.0%(n=3,040,139 个 identifiers)高于 N2 69.4% 与 N3 67.8%。
这是一个 observed pattern,不是「N1 比较简单」。至少有三个无法用这份数据排除的解释:作答 N1 题目的只有 139 个 identifiers、与作答 N3 的 432 个不是同一群(组成不同);各级题目集合不同;没有做能力值估计。要回答「哪一级真的比较难」需要 IRT 等化与共同题设计,这份数据两者都没有。
观察 B:句型轴在每一个级别都是最低的
| 轴向 × 级别 | n | identifiers | 原始正确率 | 95% CI |
|---|---|---|---|---|
| 句型/语法 × N4 | 1,734 | 233 | 48.0% | 45.6%–50.3% |
| 句型/语法 × N3 | 2,531 | 389 | 49.2% | 47.2%–51.1% |
| 句型/语法 × N2 | 1,179 | 191 | 51.1% | 48.3%–54.0% |
| 句型/语法 × N1 | 1,295 | 118 | 57.0% | 54.3%–59.7% |
| 助词 × N4 | 766 | 92 | 58.5% | 55.0%–61.9% |
| 句型/语法 × N5 | 1,939 | 208 | 64.0% | 61.8%–66.1% |
| 活用变化 × N3 | 948 | 302 | 74.2% | 71.3%–76.8% |
| 助词 × N5 | 1,220 | 111 | 75.8% | 73.3%–78.1% |
| 惯用表现 × N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| 活用变化 × N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
把轴向与级别交叉之后,正确率最低的格子几乎全部是句型。这比单看级别更有信息量。
八、老师与教材设计者可以怎么用
这一节刻意把「数据」与「诠释」分开。数据是可以直接引用的;诠释是我们的判断,你可以不同意。
| 数据(可直接引用) | 诠释(我们的判断,非数据) |
|---|---|
| 测验情境首答:句型轴 53.7%,词汇轴 92.1%(n 分别为 8,678、22,869) | 在这个平台上,认得字与组得出句子之间有明显落差。若要分配练习时间,句型的边际效益可能高于再背单词。 |
| が 60.9%、に 62.4%、で 63.3% 明显低于 を 78.7%、の 83.3% | を 与 の 的用法相对单一,が/に/で 一词多用。教学上把「同一个助词的不同功能」拆开处理,可能比逐一介绍助词有效。 |
| N2 与 N3 的原始正确率(69.4%/67.8%)低于 N4、N1、N5 | ⚠️ 不要用这个排难度。比较可能的解读是「在 N2/N3 阶段作答的学习者组成与其他级别不同」,而不是题目本身。 |
| 句型轴:教材情境首答 85.4%(n=13,937)vs 测验情境首答 53.7%(n=8,678);同一批 75 个 identifier 的成对差 +27.5 pp | 课内作答与测验作答的成绩差很多,用平台内建练习成绩评估学习成效时要注意。⚠️ 但两者题目集合几乎不重叠,无法断定是「情境」还是「题目较简单」造成。 |
九、方法
| 项目 | 说明 |
|---|---|
| Population(母体) | 使用 Nihongo to Japan 的学习者所产生的作答纪录。 |
| Sampling(抽样) | 自选、观察性样本(self-selected, observational)。非随机抽样,非人口代表性样本。 |
| Unit of analysis(分析单位) | answer event(一个 learner identifier 对一道题目的一次作答)。 |
| User count(使用者计数) | learner identifiers=不重复的匿名识别码数。跨装置无法合并,是自然人数的上界,不是经验证的人数。 |
| Metric(指标) | raw accuracy = 答对数 ÷ 有效作答数。不是能力值估计。 |
| 信赖区间 | Wilson 95% CI。只反映抽样误差,不修正选样偏差。 |
四种分析集合
| 集合 | 定义 | n |
|---|---|---|
| 测验情境首答 (主要分析集合) | 来源为 challenge/placement_test/special_training,且为该 learner identifier 对该题的首次作答、非 24 小时内重复、题目后设数据完整。 | 37,245 |
| 教材情境首答 (对照集合) | 来源为 self_study/review 的首次作答,也就是「读教材的过程中作答」。 | 15,741 |
| 全情境首答 | 每个 learner identifier 对每题的第一次作答,不分来源。 | 52,934 |
| 全部作答 | 所有有效作答事件,含重复作答。 | 56,613 |
⚠️ 主要分析集合不宣称「未使用提示」或「未先看解析」。 数据库里used_hint/viewed_explanation/used_answer_key三个栏位全部为 false,但那是因为没有任何前端呼叫点写入它们——全站作答捕捉点都没有传这些参数,而产品目前也没有「作答前提示」或「作答前看答案」的功能。 全 false 是仪器的性质,不是学习者行为的证据,因此本报告不拿它们当任何分析条件,也不对提示行为做任何宣称。
主要集合的独立验证:用伺服器端重算「每个 (identifier, 题目) 的最早一笔」,99.59% 的主要集合事件(37,094/37,245)通过首答检定;不符的 151 笔推测为跨装置(同一人在两台装置各答一次,每台都判定为首答)。集合内 attempt_number 全部为 1。
排除了什么
- 已知退化题目:520 个 question_id 被排除在所有汇总之外。两个来源:(1) 教材填空的非语法题(假名转换、书写常识、数字答案)被误标到句型轴;(2) 旧版「今日一题」用答案 token 当题目识别,把不同题合并成同一个 id。前端已修,历史数据以 denylist 从汇总排除。原始事件一笔未删(append-only)。
- Snapshot 截止后的事件:本报告冻结于 2026-08-14T00:00:00Z。数据每天还在增加,但本页与可下载文件的每一个数字都来自同一个冻结点。
最小格数规则
n<30 或学习者<5 的细格 SUPPRESSED:只公开事件数,不公开正确率。 n≥30 且学习者≥5 但 n<100 标为 LOW_SAMPLE,引用时务必附 n。 n≥100 且学习者≥5 标为 OK。
本次共有 23 个知识点为 OK、12 个 LOW_SAMPLE、3 个 SUPPRESSED。
匿名化
- 每笔事件只带一个浏览器随机产生的匿名装置 UUID。没有姓名、email、IP、装置指纹,也没有任何自由输入的文字。
- 接收端(Cloudflare Pages Function)只写入白名单栏位,程序明确不写入 IP。
- 公开数据集只有汇总统计,没有任何一笔原始作答事件。
- 学习者可在隐私政策页一键退出汇总收集。
十、限制(请务必一起引用)
如果你只读一段,读这段。这份数据描述的是「来 NTJ 刷题的人在 NTJ 的题目上表现如何」。它不是台湾日语学习者的样貌,不是 JLPT 难度的度量,也不能用来比较不同级别的客观难度。
- 选样偏差:样本是主动来刷题的人。这群人比一般学习者更投入,可能也更年轻、更习惯线上工具。
- 重复测量:单一 identifier 最多占全部作答的 3.7%,前 10 名占 19.4%。在同一批 372 个 identifier 上,事件加权与 identifier 加权相差 7.04 个百分点。
- analysis set 之间不可直接相减:教材情境与测验情境使用几乎互不重叠的题目集合(5,772 道句型题中只有 6 道两边都出现),因此两者的正确率差距无法归因于单一原因。
- 提示/看解析行为不可观测:相关栏位从未被写入,本数据集对这些行为不做任何宣称。
- 题目难度不一:各级别、各轴向的题目集合不同,raw accuracy 不是标准化的难度度量。
- 未做 IRT 等化:没有项目反应理论的难度等化,也没有跨级别共同题设计,因此不能回答「哪一级比较难」。
- 样本量不均:N5 的作答数是 N1 的六倍以上。
- 时间窗很短:只有 12 天(汇总管线 2026-08-02 才上线)。没有任何长期趋势可以从这份数据读出来。
- 无法辨识自动化流量:没有机制可以区分真人与脚本。作答回应时间有 94% 为空值,因此连「答太快」这种基本筛选都做不到。这是已知的数据质量缺口。
- 非母体代表:不代表台湾,也不代表任何国家的日语学习者全体。
十一、引用方式
欢迎在论文、研究报告、教学材料与新闻报导中引用。请注明来源并链接回本页。
APA(7th)
Nihongo to Japan. (2026). 日语学习作答汇总数据集・2026 年 8 月 / Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026MLA(9th)
Nihongo to Japan. 日语学习作答汇总数据集・2026 年 8 月. Version 1.1.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026}

}
授权状态
数据采 CC BY 4.0:可自由使用(含商业用途),唯一条件是标示出处。 本站制作的图表与报告文字不在授权范围内。完整条款见授权。
建议的标示方式:
Nihongo to Japan,《日语学习作答汇总数据集・2026 年 8 月》v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026授权:数据采 CC BY 4.0
本数据集的数据采用 Creative Commons 姓名标示 4.0 国际(CC BY 4.0)。你可以自由重制、散布、改作与再发布,包含商业用途,唯一条件是适当标示出处并注明是否修改过。
⚠️ 授权范围只到数据。受 CC BY 4.0 涵盖的是:本页的汇总统计数字,以及japanese-learning-2026.json与japanese-learning-2026.csv两个下载档。本站制作的图表(SVG/PNG)与报告全文不在授权范围内,仍保留权利。
可以做的事(不必先问我们)
- 在论文、研究报告、教学材料、新闻报导中引用统计数字,包含商业出版品。
- 重新分析汇总数字,自行制作新的图表——你画的新图是你的。
- 改作、混合、转换,并以任何形式再发布,包含整批再散布数据档或放进自己的数据产品。
- 课堂与教育场合使用。
标示方式
Nihongo to Japan,《日语学习作答汇总数据集・2026 年 8 月》v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026我们的请求(不是授权条件)
下面这些不是 CC BY 的条件,不照做也不构成侵权。我们仍然请你照做,理由写在每一条后面:
- 一并带上样本限制(自选观察性样本、只有 12 天、非代表性)——拿掉限制转述数字,等于发布一则误导性的统计。
- 链接回本页——让你的读者看得到方法与版本。
- 写「learner identifiers」而不是「人数」——identifier 是自然人数的上界,不是人数。
- 写出版本号(例:v1.1.0,snapshot 2026-08-14)——日后数字更新时,你引用的那一版仍然可以被指认。
不在授权范围内的东西
- 本站制作的图表(
/images/research/*.svg与*.png):转载请先来信取得同意。用数据自己画新图不需要同意。 - 报告全文与网页文字:保留权利。
- 站台名称、标志与品牌识别:本授权不授予使用权。
⚠️ CC BY 是不可撤回的授权。任何依此条款取得数据的人,其权利不会因为本站日后变更条款而失效。我们写在这里,是因为引用者有权知道自己拿到的授权有多稳定。
十二、下载数据
两种格式,内容相同,都是汇总统计(没有任何一笔原始作答事件):
- japanese-learning-2026.json — 含完整后设数据、定义、方法、限制与全部汇总格。
- japanese-learning-2026-LICENSE.txt — 授权声明(CC BY 4.0、范围、标示字串)。CSV 本身没有栏位放授权信息,所以另附一份。
- japanese-learning-2026.csv — 摊平成一列一格,栏位:
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag。
版本 1.1.0・snapshot 2026-08-14・方法版本 1.1。之后更新会提高版本号并保留旧版数字,不会就地改写。
图表文件:本页四张图都提供 PNG(2 倍分辨率,适合投视频与排版)与 SVG(向量,可缩放)。
每张图都内建标题、n、版本与来源标注,单独转出去也看得懂口径;四张图的替代文字集中在 alt-text.json。⚠️ 图表不在 CC BY 范围,转载请先来信(见联系窗口);数据本身采 CC BY 4.0,标示出处即可自由使用(见授权)。
⚠️ 若需引用,请使用版本化冻结数据集,不要引用 /api/aggregates 的数字。
站上另有一个定期更新的汇总端点 /api/aggregates,回传的数字会随时间变动(不是冻结版本)。它与本数据集口径不同:它是「全部作答」口径(不是测验情境首答),而且它的 totalUsers 只计主要集合的 learner identifiers(688),不是全部 1,053 个。那个端点的数字每天都在变,不适合引用。
给记者
- 样本:56,613 笔匿名作答、1,053 个匿名 learner identifiers(不是经验证的人数)、12 天(2026 年 8 月 2–13 日)。
- 方法一句话:自选观察性样本的原始正确率,主要数字采「测验情境首答」集合(challenge/程度测验/特训的首次作答)。
- 限制一句话:不是台湾日语学习者的代表性调查,也不能用来比较 JLPT 各级的客观难度。
三个可以直接写的数字:
- 句型题正确率 53.7%(n=8,678),词汇题 92.1%(n=22,869)——差 38 个百分点。
- 助词「が」正确率 60.9%(n=358),「を」78.7%(n=385)。
- 句型轴的「正确率」在 53.7% 到 74.1% 之间,取决于纳入哪些作答情境(教材情境首答 85.4%,测验情境首答 53.7%)。⚠️ 两种情境的题目集合几乎不重叠,不能断定原因——但这本身就是一则关于「学习平台数据怎么被引用」的故事。
嵌入这份数据(部落格与教材可直接贴)
把下面这段 HTML 贴进你的文章或讲义即可。它已经内建样本数、版本、授权与「不代表母体」的警语——这正是引用统计数字时最常被漏掉、也最容易出错的部分。不需要事先告知我们。
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">在 56,613 笔匿名作答中,测验情境首答的句型/语法正确率为 <strong>53.7%</strong>(n=8,678),词汇为 <strong>92.1%</strong>(n=22,869)。</p><p style="margin:0;font-size:13px;color:#8a7a68">数据:<a href="https://www.nihongotojapan.com/research/japanese-learning-data-2026">Nihongo to Japan《日语学习作答汇总数据集・2026 年 8 月》</a> v1.1.0・CC BY 4.0・自选观察性样本,不代表母体</p></blockquote>
为什么给的是可贴上的 HTML,不是 iframe?两个原因:本站基于资安设置不允许被 iframe 嵌入(全站 frame-ancestors 'none');而且 iframe 里的内容挂在我们的网域,对你的页面来说不算一条你给出的链接,可贴上的区块才是。你也完全可以自己排版——数据是 CC BY 4.0,只要标示出处就好。
要放图的话:本站图表不在授权范围,但你可以用 CSV 自己画,画出来的图是你的。教学或媒体用途想直接拿我们的图,见给媒体。
给媒体:新闻数据包
这一节的内容可以直接复制使用,不需要事先取得同意(图表除外,见下)。快速事实与可直接引用的三个数字在给记者;完整的十条发现在可直接引用的十条发现。
机构简介(boilerplate)
长版:
Nihongo to Japan 是一个由个人开发者独立经营的日文学习网站,免注册,完整课程永远免费,内容涵盖 JLPT N5 到 N1 的语法解说、自学教材与练习题库。本数据集来自站上使用者的匿名作答纪录,依冻结 snapshot 汇总后公开,附完整方法与限制说明。
短版:
Nihongo to Japan,独立经营、完整课程永远免费的日文学习网站,公开其学习者匿名作答的汇总数据集。
媒体用图
本站制作的图表不在 CC BY 4.0 范围内(授权只涵盖数据,见授权)。我们不希望这变成你的阻碍,所以提供两条路:
- 来信索取:我们在 24 小时内寄出可刊登的图档(PNG 与 SVG)+正确的图说、样本数与版本标注。这是图片的快速通道,比一般询问(2–3 个工作日)快。
- 不想等:自己画。数据本身是 CC BY 4.0,你可以直接用 JSON 或 CSV 制作自己的图表,你画的图是你的,不需要任何同意,也不必告知我们。
负责任报导的四个提醒
这些不是条件,是为了让你不用事后更正:
- ✅ 请写「在这批作答里」「在测验情境的首次作答中」——本页所有数字都是这份数据集内的观察值。
- ❌ 不要写成「台湾人如何如何」。样本是自己选择来这个网站刷题的人,不代表任何母体。
- ❌ 不要比较 JLPT 级别的难度。各级题目集合不同、没有做 IRT 难度等化,而且 N3 与 N2 的信赖区间重叠——这份数据无法区分两者。
- ❌ 不要写成因果。数据能说「同时观察到」,不能说「因为所以」。
不确定某个写法可不可以,直接写信问我们——这比见报后更正省事得多。
可署名引述
以下两句可以直接引用,不需另外询问。
「同样是测验题的首次作答,词汇题答对 92.1%,句型题只有 53.7%。这只描述了会主动来这个网站刷题的人身上发生的事,不能推到所有学习者身上。但如果你也卡在『字都看得懂、句子就是组不出来』,至少这不是你一个人的问题。」
— Nihongo to Japan 站长(Founder)
「同一批数据,光是换掉『要纳入哪些作答』的定义,句型正确率就从 53.7% 变成 85.4%。我们把四种口径一起公开,是因为只报一个数字,读者根本看不出来那是哪一种。」
— Nihongo to Japan 站长(Founder)
本站没有研究团队,也没有发言人。以上引述挂在实际制作这份数据的人名下;若需要针对特定问题的回应,请走联系窗口。
给研究者与教育工作者
数据结构:一列=一个汇总格。维度为 dimension(axis/jlpt/knowledge_point/axis_x_jlpt)× analysis_set(quiz_first_attempt/lesson_first_attempt/first_attempt/all_events)。每格提供 n、learners、accuracy、Wilson ci95_low/ci95_high 与 flag。JSON 另含 analysis-set 分解、成对比较与 weighting effect。
抽样:自选、观察性;分析单位为 answer event;learner identifier 为匿名 UUID(跨装置无法合并,因此这个数字是自然人数的上界,不是经验证的不重复人数)。
已知的方法缺口(我们认为值得写出来,而不是藏起来):
- 没有 IRT 难度等化,也没有跨级别共同题设计 → 级别间的比较不成立。
- 教材情境与测验情境的题目集合几乎不重叠(5,772 道句型题只有 6 道重叠)→ 情境效果与题目难度无法分离。
- 提示/看解析/看答案三个栏位从未被写入 → 这些行为不可观测,不能作为分析条件,也不能宣称「没有发生」。
- 回应时间 94% 为空值 → 无法做速度/正确率的权衡分析,也无法过滤异常快的作答。
- 没有人口统计变项(年龄、母语、学习年资、国家)→ 无法做分层分析。数据集没有母语栏位,也没有地理栏位,因此本报告不对学习者的母语或所在地做任何推论。
- 12 天的窗口 → 不能做学习曲线或保留率分析。
- 学习者层级的数据未公开(只有汇总),因此无法在外部重做多层次模型。若研究上有需要,请联系讨论。
媒体与数据联系窗口
Nihongo to Japan 站长(Founder)・Email:[email protected]
可回答:方法论细节、汇总数字的复查、图表使用申请、限制与适用范围、以及「这份数据能不能回答我的问题」这类判断。一般在 2–3 个工作日内回复;媒体索取可刊登图档走快速通道,24 小时内回复(见给媒体)。
本站由一位个人开发者独立经营。本站没有研究团队,也没有发言人——上面这个信箱就是实际做出这份数据的人,不是转接窗口。这点写在这里,是因为引用者有权知道数据背后是谁。
版本与更新纪录
本页网址永远指向最新一版的 snapshot。每一版都有版本号与冻结日期,引用时请一并写出版本(例:v1.1.0,snapshot 2026-08-14)——日后数字更新时,你引用的那一版仍然可以被指认。JSON 与 CSV 下载档内含相同的版本栏位。
| 版本 | snapshot 冻结日 | 涵盖期间 | 说明 |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 至 10-21(81 天) | 新版,另开网址(分析集合不同)。 |
| v1.1.0 | 2026-08-14 | 2026-08-02 至 08-13(12 天) | 首次公开发布。主要分析集合为「测验情境首答」,四种分析集合并列公开。 |
下一版预计在累积约三个月数据后发布,届时才有趋势可谈。数据更新不会改写已发布版本的数字:新版会是新的版本号与新的冻结日期,旧版数字仍以其版本号被指认。若你已在论文或报导中引用某个版本而该版数字有变动,请来信,我们会直接告知差异。