Dataset Jawaban Pembelajaran Bahasa Jepang — Agustus 2026: Tingkat jawaban benar dari 56.613 jawaban anonim (snapshot 12 hari)
📢 Sudah ada rilis yang lebih baru: Dataset Jawaban Pembelajaran Bahasa Jepang — Oktober 2026 (v2.0.0, 543.344 jawaban). v2 memakai himpunan analisis yang berbeda, sehingga angkanya tidak dapat dikurangkan begitu saja dengan angka di halaman ini; angka v1.1.0 di sini tidak berubah dan tetap dapat dikutip.
Ringkasnya: statistik agregat dari 56.613 peristiwa jawaban anonim di Nihongo to Japan, yang berasal dari 1.053 pengenal pembelajar anonim pada 11.987 soal.
⚠️ Ini adalah snapshot Agustus 2026, bukan kajian atas keseluruhan tahun 2026. Data mencakup 2–13 Agustus 2026, total dua belas hari (pipeline agregasi mulai berjalan pada 2 Agustus; data hari pertama tidak lengkap). Tidak ada tren longitudinal yang dapat dibaca dari data ini. Versi 1.1.0, snapshot dibekukan pada 2026-08-14.
Tentang "pengenal pembelajar": ini adalah pengenal anonim yang dibuat secara acak di peramban dan tidak dapat digabungkan lintas perangkat. Satu orang yang memakai ponsel dan laptop menghasilkan dua pengenal, sehingga 1.053 bukan jumlah orang berbeda yang terverifikasi — angka itu adalah batas atas. Di seluruh halaman ini kami menulis "pengenal pembelajar", bukan "orang".
Apa yang bukan merupakan cakupan data ini. Ini bukan survei representatif tentang pembelajar bahasa Jepang di Taiwan atau di mana pun. Sampelnya terdiri atas orang-orang yang memilih berlatih di situs ini — sampel observasional swaseleksi (self-selected). Setiap angka menggambarkan apa yang terjadi dalam kumpulan jawaban ini dan tidak dapat diekstrapolasi ke populasi mana pun. Lihat Keterbatasan.
Sepuluh temuan yang dapat dikutip langsung
Setiap butir di bawah ini berdiri sendiri: kalimatnya sudah memuat nama dataset, rentang snapshot, ukuran sampel, dan selang kepercayaan, sehingga jurnalis atau peneliti dapat menyalin satu butir saja tanpa perlu kembali mencari konteks. Setiap angka adalah nilai teramati di dalam dataset ini (himpunan analisis utama adalah percobaan pertama dalam konteks kuis — lihat Metodologi), bukan inferensi tentang populasi pembelajar bahasa Jepang, dan tidak ada klaim kausal yang dibuat. Mohon kutip Keterbatasan bersama angka-angkanya.
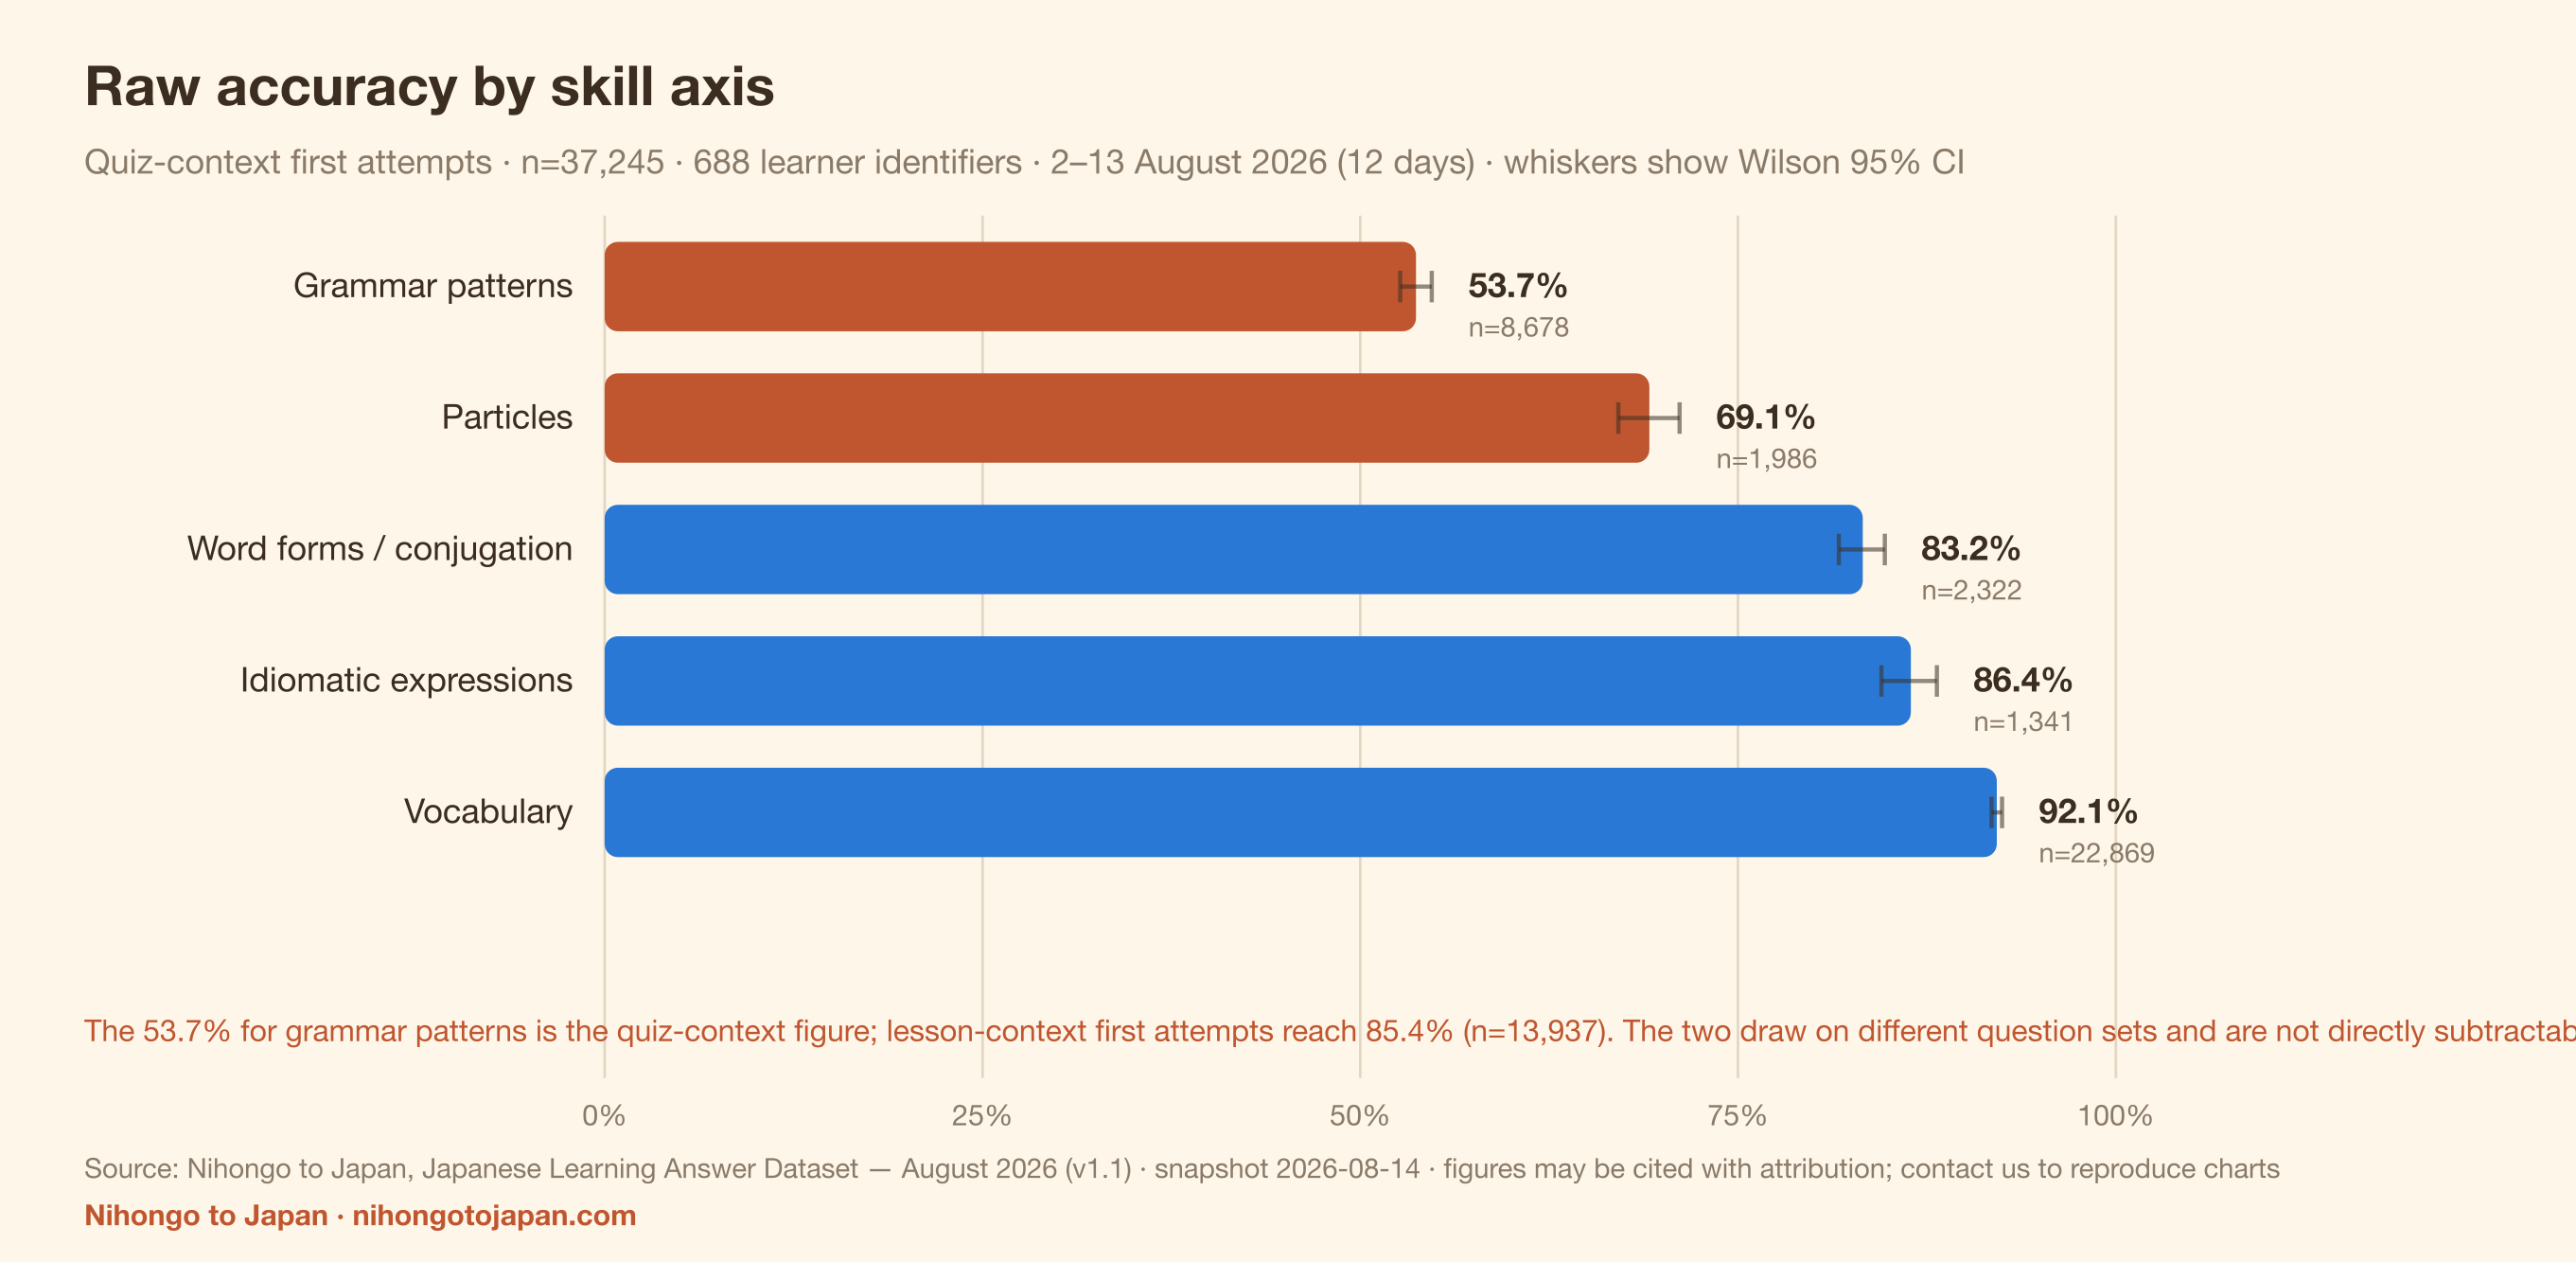
- Pada percobaan pertama dalam konteks kuis di Dataset Jawaban Pembelajaran Bahasa Jepang NTJ (snapshot Agustus 2026, 12 hari), soal pola kalimat dijawab benar 53,7% (n=8.678; selang kepercayaan (SK) Wilson 95% 52,6%–54,7%), dibandingkan 92,1% untuk kosakata (n=22.869; SK 95% 91,8%–92,5%) — selisih 38 poin persentase.
Kedua selang tidak tumpang-tindih, jadi selisih ini bukan derau sampling; laporan ini tidak membuat klaim apa pun tentang penyebabnya. - Pada percobaan pertama dalam konteks kuis di dataset yang sama, kelima sumbu pembelajaran berurutan dari terendah ke tertinggi sebagai berikut: pola kalimat 53,7% (n=8.678), partikel 69,1% (n=1.986; SK 95% 67,1%–71,1%), bentuk kata dan konjugasi 83,2% (n=2.322; SK 95% 81,7%–84,7%), ungkapan idiomatis 86,4% (n=1.341; SK 95% 84,5%–88,2%), dan kosakata 92,1% (n=22.869).
Setiap sumbu memakai himpunan soal yang berbeda, jadi ini adalah urutan akurasi teramati, bukan urutan tingkat kesulitan. - Di dataset yang sama, akurasi teramati pada sumbu pola kalimat berkisar antara 53,7% dan 85,4%, tergantung jawaban mana yang disertakan: 53,7% pada percobaan pertama dalam konteks kuis (n=8.678), 85,4% pada percobaan pertama dalam konteks pelajaran (n=13.937), dan 74,1% pada seluruh peristiwa jawaban (n=24.293).
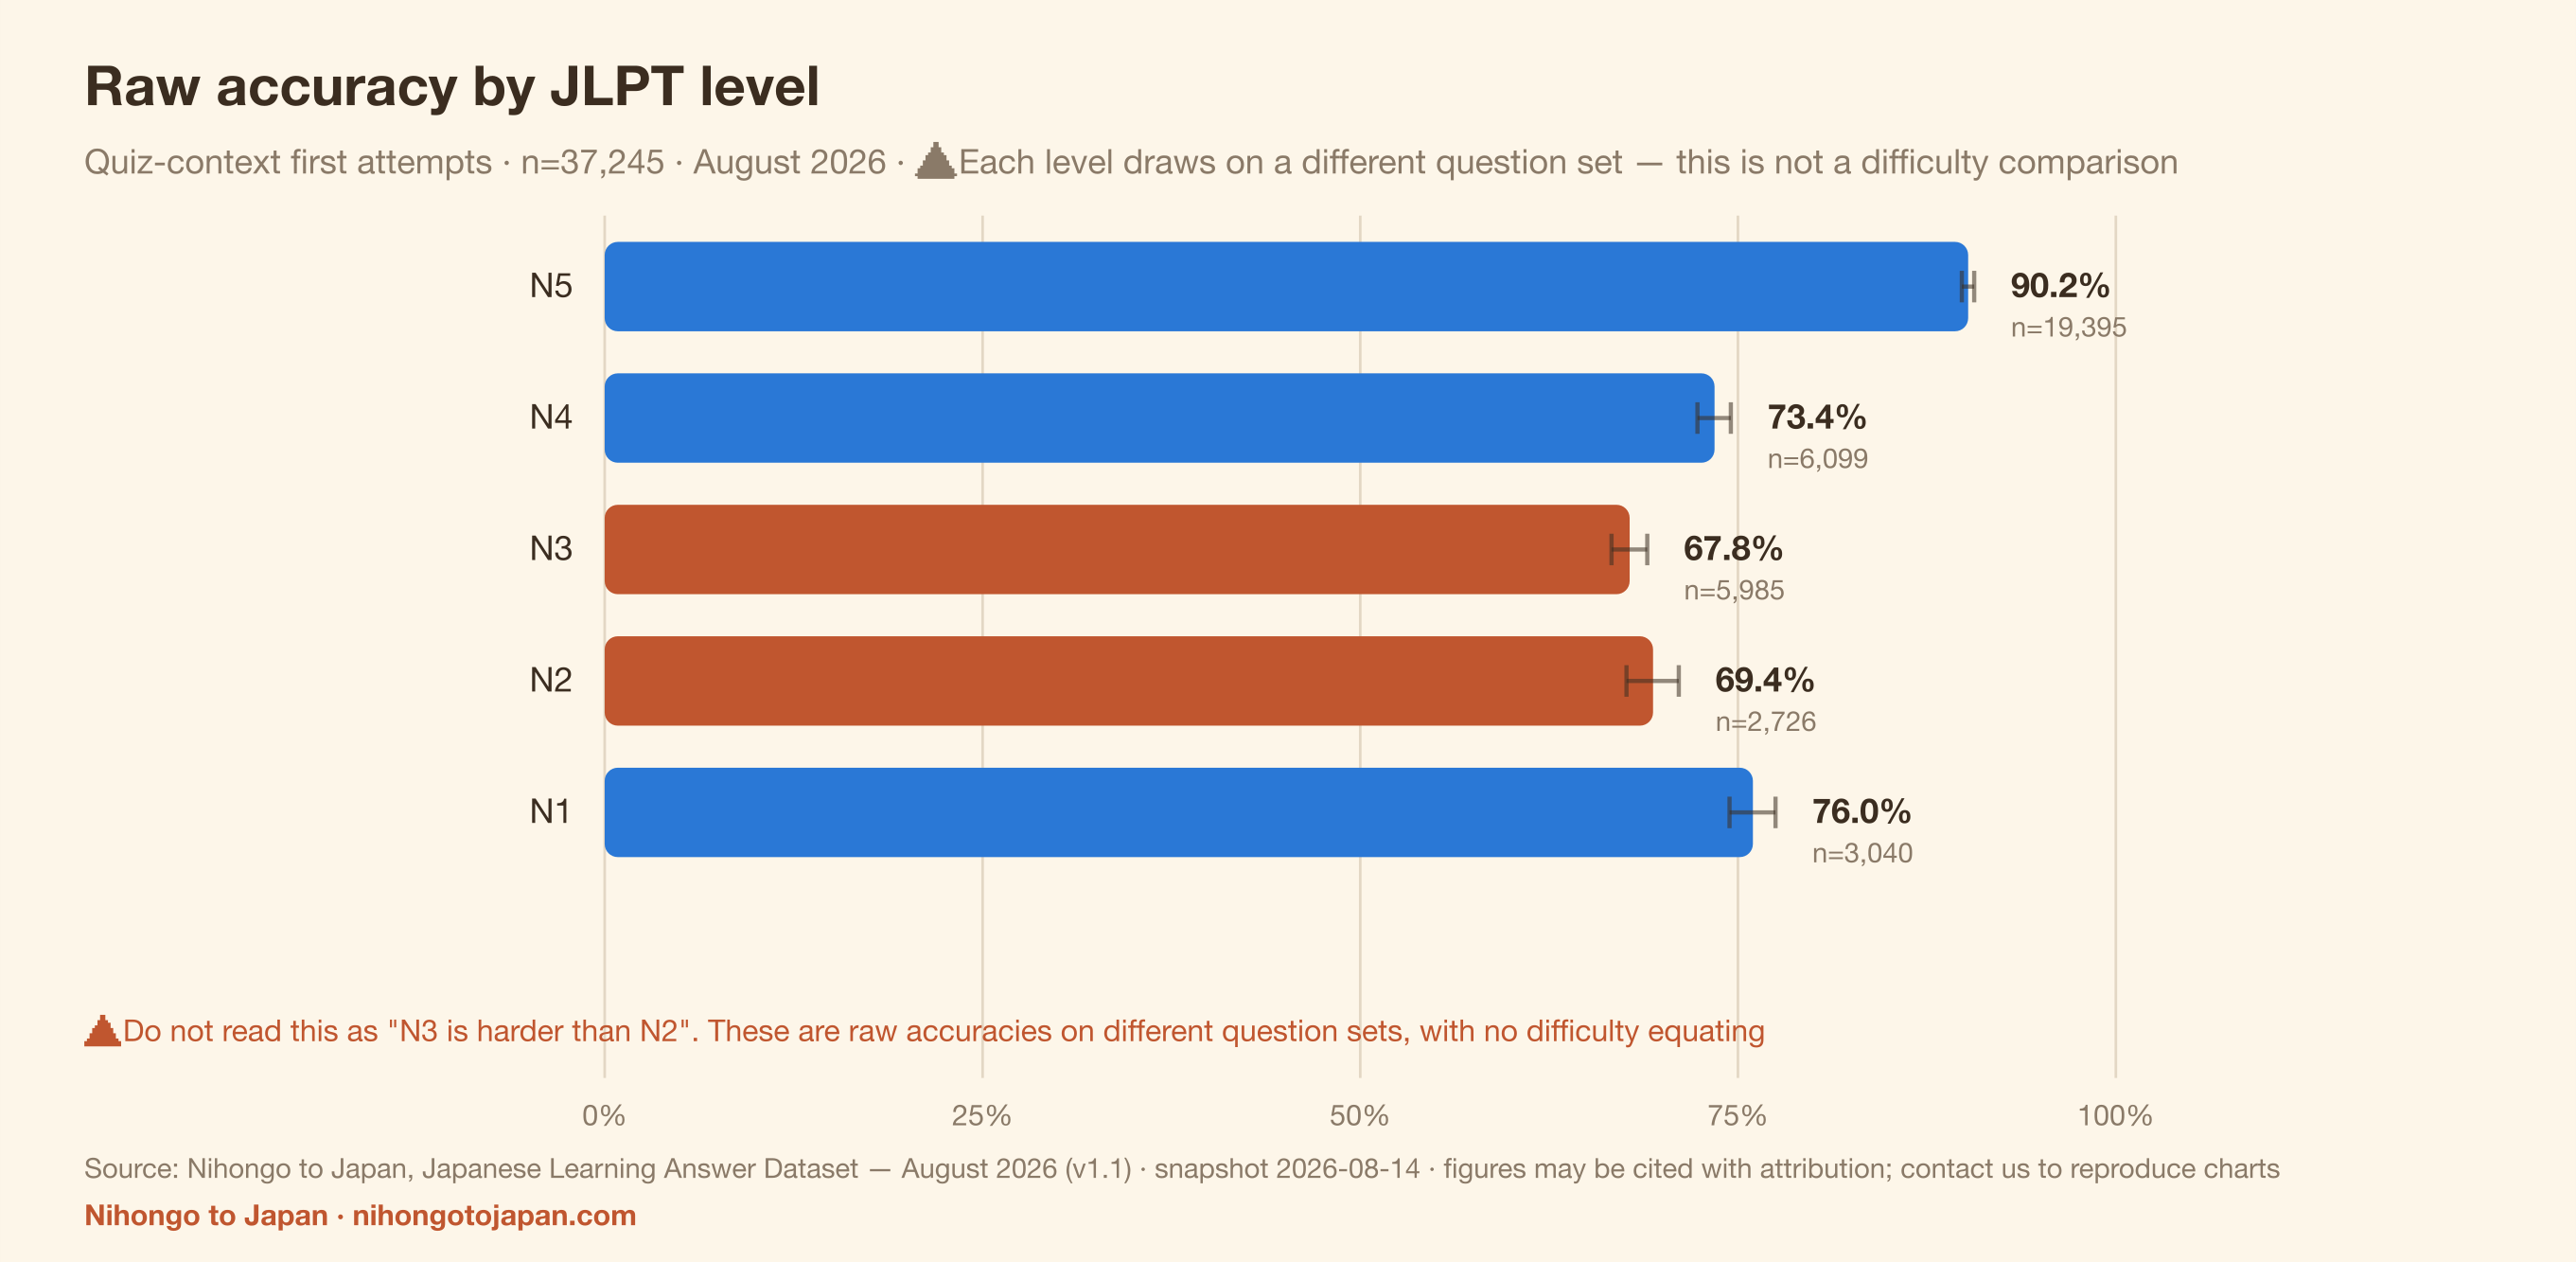
Kedua konteks memakai himpunan soal yang hampir sepenuhnya terpisah — hanya 6 dari 5.772 soal pola kalimat yang berbeda muncul di keduanya — sehingga efek konteks tidak dapat dipisahkan dari perbedaan tingkat kesulitan soal. Inti temuan ini: setiap angka akurasi yang dikutip dari sebuah platform belajar harus menyebutkan jawaban mana saja yang disertakan. - Pada percobaan pertama dalam konteks kuis di dataset yang sama, akurasi mentah adalah 67,8% di N3 (n=5.985; SK 95% 66,6%–69,0%) dan 69,4% di N2 (n=2.726; SK 95% 67,6%–71,1%); selang kepercayaannya tumpang-tindih, sehingga dataset ini tidak dapat membedakan N2 dari N3.
Jangan melaporkannya sebagai "N2 lebih sulit daripada N3" atau sebaliknya. - Pada percobaan pertama dalam konteks kuis di dataset yang sama, akurasi mentah per level JLPT adalah N5 90,2% (n=19.395), N1 76,0% (n=3.040), N4 73,4% (n=6.099), N2 69,4% (n=2.726), dan N3 67,8% (n=5.985) — akurasi mentah N1 berada di atas N2 maupun N3.
Setiap level memakai himpunan soal yang berbeda, tidak ada penyetaraan IRT, dan sampelnya swaseleksi (mereka yang mengerjakan soal N1 cenderung sudah lebih maju), sehingga urutan ini tidak dapat dibaca sebagai tingkat kesulitan objektif level JLPT. - Pada percobaan pertama dalam konteks kuis di dataset yang sama, sebaran di dalam kelompok partikel lebih lebar daripada sebaran antarlevel JLPT: partikel が dijawab benar 60,9% (n=358; SK 95% 55,8%–65,8%) dan を 78,7% (n=385; SK 95% 74,3%–82,5%) — terpaut 17,8 poin, dibandingkan 5,6 poin antara N3 (67,8%) dan N4 (73,4%).
Implikasinya bagi pengajaran: membagi porsi latihan berdasarkan level JLPT mungkin lebih kasar daripada membaginya berdasarkan poin pengetahuan. - Pada percobaan pertama dalam konteks kuis di dataset yang sama, pola kalimat adalah sumbu dengan skor terendah di setiap level JLPT: 64,0% di N5 (n=1.939), 48,0% di N4 (n=1.734), 49,2% di N3 (n=2.531), 51,1% di N2 (n=1.179), dan 57,0% di N1 (n=1.295).
Kosakata pada level yang sama: 94,4% di N5, 89,0% di N4, 84,0% di N3, 85,0% di N2, dan 89,2% di N1. - Di dataset yang sama, jika dihitung atas 372 pengenal pembelajar yang persis sama dan 34.392 peristiwa jawaban yang sama, satu suara per jawaban (pembobotan per peristiwa) menghasilkan 82,53%, sedangkan satu suara per pengenal menghasilkan 75,49% — selisih 7,04 poin persentase.
Kedua angka memakai populasi dan himpunan analisis yang identik; selisihnya murni berasal dari pilihan pembobotan. Setiap laporan yang mengutip angka akurasi dari platform belajar sebaiknya menyebutkan pembobotan yang dipakai. - Di dataset yang sama, volume jawaban sangat terkonsentrasi: satu pengenal pembelajar yang paling aktif menyumbang 3,73% dari seluruh 56.613 peristiwa jawaban, dan 10 pengenal teratas secara bersama-sama menyumbang 19,44%.
Konsentrasi inilah penyebab langsung selisih 7 poin antara kedua pembobotan, dan ini merupakan bias struktural yang umum pada data platform belajar. - Di dataset yang sama, perbandingan berpasangan yang dibatasi pada 75 pengenal pembelajar yang menjawab di kedua konteks (minimal 5 jawaban di masing-masing sisi) menghasilkan 86,57% di konteks pelajaran (n=5.858) berbanding 55,52% di konteks kuis (n=2.055), dengan selisih rata-rata berpasangan 27,47 poin persentase (SK 95% 22,56–32,39).
Ini menunjukkan bahwa selisih antarkonteks bukan artefak dari siapa yang menjawab di mana; tetapi karena perbandingan pada soal yang sama tidak mungkin dilakukan (lihat temuan 3), efek konteks tetap tidak dapat dipisahkan dari tingkat kesulitan soal.
Setiap temuan diuraikan, ditabulasikan, dan digrafikkan pada bagian-bagian di bawah. Jika Anda hanya memerlukan angkanya, buka Unduh data; untuk mengutip, lihat Cara mengutip; untuk pertanyaan, lihat bagian kontak.
1. Lima temuan utama
1. Pola kalimat adalah satu-satunya sumbu di bawah 60%, tertinggal 38 poin dari kosakata
Di antara percobaan pertama dalam konteks kuis (lihat Metodologi untuk definisi himpunannya), soal kosakata dijawab benar 92,1% (n=22.869, 627 pengenal pembelajar, SK 95% 91,8%–92,5%), sedangkan soal pola kalimat hanya mencapai 53,7% (n=8.678, 532 pengenal, SK 95% 52,6%–54,7%).
Selang kepercayaannya berjauhan, jadi ini bukan derau sampling. Data menunjukkan selisih besar antara kedua sumbu; data tidak mengatakan apa pun tentang penyebabnya.
2. "Akurasi" pola kalimat berkisar dari 53,7% sampai 74,1%, tergantung jawaban mana yang disertakan
Dengan definisi himpunan analisis yang berbeda-beda, akurasi teramati pada sumbu pola kalimat berkisar dari 53,7% (percobaan pertama dalam konteks kuis, n=8.678) sampai 74,1% (seluruh peristiwa jawaban, n=24.293). Karena peristiwa yang disertakan maupun komposisi pengenal pembelajarnya sama-sama berbeda, seluruh selisih itu tidak dapat dibaca sebagai hasil dari satu aturan penghitungan saja.
Langkah demi langkah:
| Langkah | n | Akurasi mentah | Perubahan dari langkah sebelumnya |
|---|---|---|---|
| Seluruh peristiwa jawaban | 24.293 | 74,1% | — |
| → hanya percobaan pertama | 22.638 | 73,2% | -0,87 pp |
| → hanya konteks kuis (tanpa pelajaran/ulasan) | 8.678 | 53,7% | -19,54 pp |
| (pembanding) percobaan pertama dalam konteks pelajaran | 13.937 | 85,4% | — |
Menghapus percobaan berulang hanya menggeser angka sebesar 0,9 poin persentase. Hampir seluruh sisanya berasal dari perbedaan antara jawaban dalam konteks pelajaran dan konteks kuis.
Perbandingan berpasangan pada pengenal pembelajar yang sama: 75 pengenal memiliki minimal 5 percobaan pertama soal pola kalimat di masing-masing konteks. Mereka mencapai 86,6% di konteks pelajaran (n=5.858) dan 55,5% di konteks kuis (n=2.055), dengan selisih rata-rata berpasangan +27,5 pp (SK 95% 22,6–32,4; median +26,9). Jadi selisih ini bukan sekadar soal siapa yang menjawab.
⚠️ Perbandingan pada soal yang sama tidak mungkin dilakukan, sehingga tidak ada kesimpulan yang dapat ditarik. Dari 5.772 soal pola kalimat yang berbeda, hanya 6 yang muncul di kedua konteks, dan hanya 1 yang memiliki minimal 3 jawaban di masing-masing sisi. Kedua konteks memakai himpunan soal yang hampir sepenuhnya terpisah, sehingga efek konteks tidak dapat dipisahkan dari perbedaan tingkat kesulitan soal. Bisa jadi soal-soal dalam konteks pelajaran memang lebih mudah.
Yang dapat dikatakan secara jujur adalah ini: ketika mengutip angka akurasi dari sebuah platform belajar, selalu tanyakan dari himpunan analisis mana angka itu berasal. Keempat himpunan tersedia di data yang dapat diunduh.
3. N3 dan N2 memiliki akurasi mentah terendah — tetapi data ini tidak dapat membedakan keduanya
Akurasi mentah percobaan pertama dalam konteks kuis per level: N5 90,2%, N4 73,4%, N3 67,8%, N2 69,4%, N1 76,0%.
Selang untuk N3 (SK 95% 66,6%–69,0%) dan N2 (SK 95% 67,6%–71,1%) tumpang-tindih, sehingga tidak tepat untuk mengatakan "N3 lebih sulit daripada N2". Yang dapat dikatakan adalah bahwa dalam sampel ini, akurasi mentah N2 dan N3 sama-sama berada di bawah N4, N1, dan N5.
⚠️ Yang lebih penting, setiap level memakai himpunan soal yang sama sekali berbeda. Urutan ini bukan perbandingan tingkat kesulitan dan bukan bukti tentang level JLPT mana yang secara objektif lebih sulit.
4. Sebaran di dalam kelompok partikel lebih lebar daripada sebaran antarlevel
Akurasi percobaan pertama dalam konteks kuis untuk masing-masing partikel: が 60,9% (n=358, SK 55,8%–65,8%), に 62,4% (n=370), で 63,3% (n=330), berbanding を 78,7% (n=385, SK 74,3%–82,5%) dan の 83,3% (n=120).
Selang untuk が dan を tidak tumpang-tindih; selisihnya 18 poin persentase.
5. Satu suara per pengenal dan satu suara per jawaban berselisih 7,04 poin
Dihitung atas 372 pengenal pembelajar yang persis sama, himpunan analisis yang sama, dan 34.392 peristiwa memenuhi syarat yang sama:
| Pembobotan | Akurasi |
|---|---|
| Berbobot per peristiwa (satu suara per jawaban) | 82,5% |
| Berbobot per pengenal (satu suara per pengenal) | 75,5% (median 76,2%) |
| WEIGHTING_EFFECT_PP | 7,04 pp |
Kohort: pengenal pembelajar dengan minimal 20 jawaban dalam himpunan analisis utama. Kedua angka berbagi populasi pembilang dan penyebut yang sama, sehingga selisihnya hanya mencerminkan pilihan pembobotan dan tidak tercemar oleh perbedaan komposisi sampel.
Penyebabnya adalah pengukuran berulang: satu pengenal yang paling aktif menyumbang 3,7% dari seluruh jawaban dan sepuluh pengenal teratas 19,4%. Setiap kajian yang memakai data platform akan menghadapi hal ini, karena itu kami menerbitkan kedua angka.
2. Ikhtisar dataset
| Butir | Nilai |
|---|---|
| Peristiwa jawaban yang valid | 56.613 |
| Pengenal pembelajar anonim (batas atas jumlah orang) | 1.053 |
| Soal yang berbeda | 11.987 |
| Poin pengetahuan | 39 |
| Cakupan waktu | 2 sampai 13 Agustus 2026 (12 hari); data hari pertama tidak lengkap |
| Batas waktu snapshot | 2026-08-14T00:00:00Z |
| Peristiwa percobaan pertama | 52.934 |
| Percobaan pertama dalam konteks kuis (himpunan utama) | 37.245 |
| Pengenal pembelajar dalam himpunan utama | 688 |
| Percobaan pertama dalam konteks pelajaran (himpunan pembanding) | 15.741 |
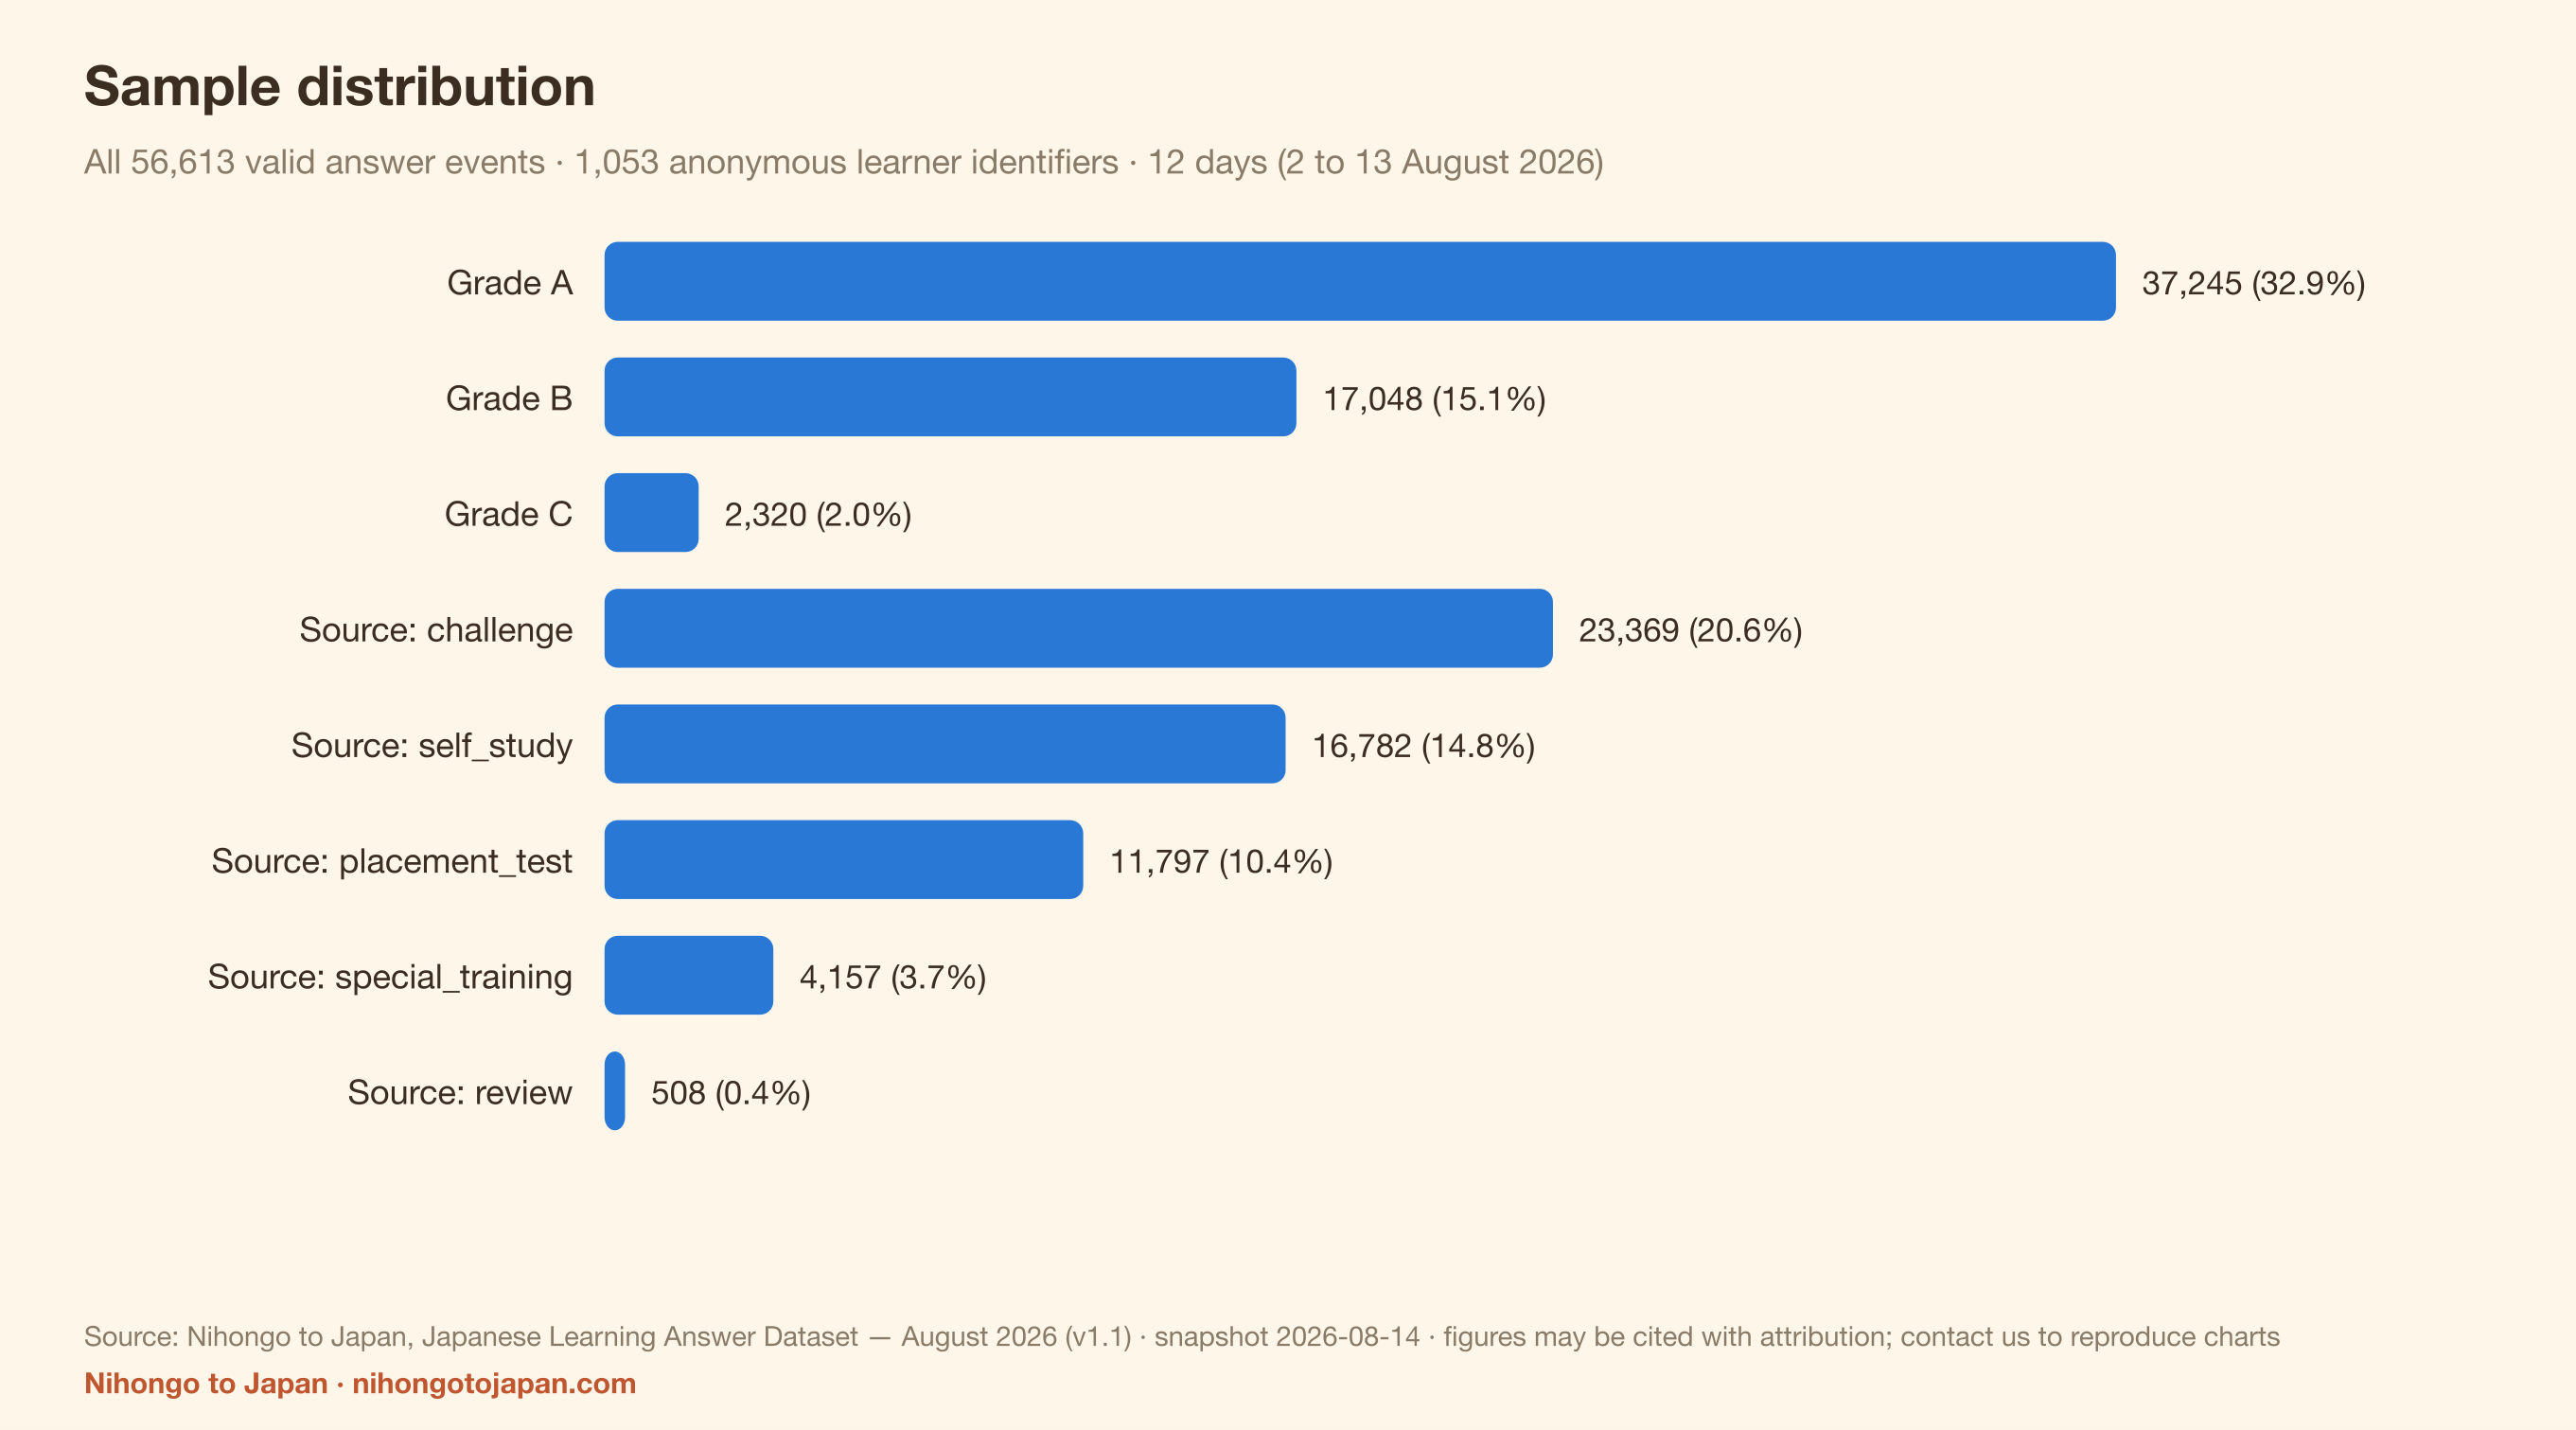
Jawaban menurut sumber: challenge 23.369 (41,3%), self_study 16.782 (29,6%), placement_test 11.797 (20,8%), special_training 4.157 (7,3%), review 508 (0,9%).
Sebaran kolom basis data evidence_class (sebuah field tabel mentah, bukan nama himpunan analisis dalam laporan ini): A 37.245 (65,8%), B 17.048 (30,1%), C 2.320 (4,1%). Himpunan analisis utama persis sama dengan evidence_class = A.

3. Akurasi menurut sumbu pembelajaran

| Sumbu kemampuan | n | Pengenal | Akurasi mentah | SK 95% | Penanda |
|---|---|---|---|---|---|
| Pola kalimat | 8.678 | 532 | 53,7% | 52,6%–54,7% | OK |
| Partikel | 1.986 | 137 | 69,1% | 67,1%–71,1% | OK |
| Bentuk kata / konjugasi | 2.322 | 386 | 83,2% | 81,7%–84,7% | OK |
| Ungkapan idiomatis | 1.341 | 261 | 86,4% | 84,5%–88,2% | OK |
| Kosakata | 22.869 | 627 | 92,1% | 91,8%–92,5% | OK |
Sumbu-sumbu berikut berada di bawah ukuran sel minimum (n<30 atau kurang dari 5 pengenal pembelajar), sehingga tidak ada angka akurasi yang diterbitkan — hanya jumlah peristiwanya: Campuran / menyeluruh (n=27, 8 pengenal), Pemahaman bacaan (n=22, 4 pengenal).
4. Akurasi menurut level JLPT
⚠️ Inilah bagian yang paling mudah disalahartikan. Setiap level memakai himpunan soal yang sama sekali berbeda, dan tidak dilakukan penyetaraan tingkat kesulitan dengan IRT. Angka di bawah adalah proporsi soal-soal tertentu ini yang dijawab benar — bukan ukuran level mana yang lebih sulit.

| Level JLPT | n | Pengenal | Akurasi mentah | SK 95% |
|---|---|---|---|---|
| N5 | 19.395 | 380 | 90,2% | 89,8%–90,6% |
| N4 | 6.099 | 313 | 73,4% | 72,3%–74,5% |
| N3 | 5.985 | 432 | 67,8% | 66,6%–69,0% |
| N2 | 2.726 | 212 | 69,4% | 67,6%–71,1% |
| N1 | 3.040 | 139 | 76,0% | 74,4%–77,5% |
Level yang sama pada keempat himpunan analisis:
| Level | Pertama, konteks kuis (utama) | Pertama, konteks pelajaran | Percobaan pertama (semua) | Seluruh peristiwa |
|---|---|---|---|---|
| N5 | 90,2% (n=19.395) | 83,7% (n=11.154) | 87,8% (n=30.495) | 88,2% (n=33.286) |
| N4 | 73,4% (n=6.099) | 83,1% (n=2.694) | 76,5% (n=8.758) | 76,6% (n=9.262) |
| N3 | 67,8% (n=5.985) | 82,1% (n=1.507) | 70,8% (n=7.522) | 71,1% (n=7.727) |
| N2 | 69,4% (n=2.726) | 79,2% (n=260) | 70,2% (n=2.985) | 70,5% (n=3.072) |
| N1 | 76,0% (n=3.040) | 86,5% (n=126) | 76,4% (n=3.174) | 76,5% (n=3.266) |
5. Poin pengetahuan dengan akurasi terendah
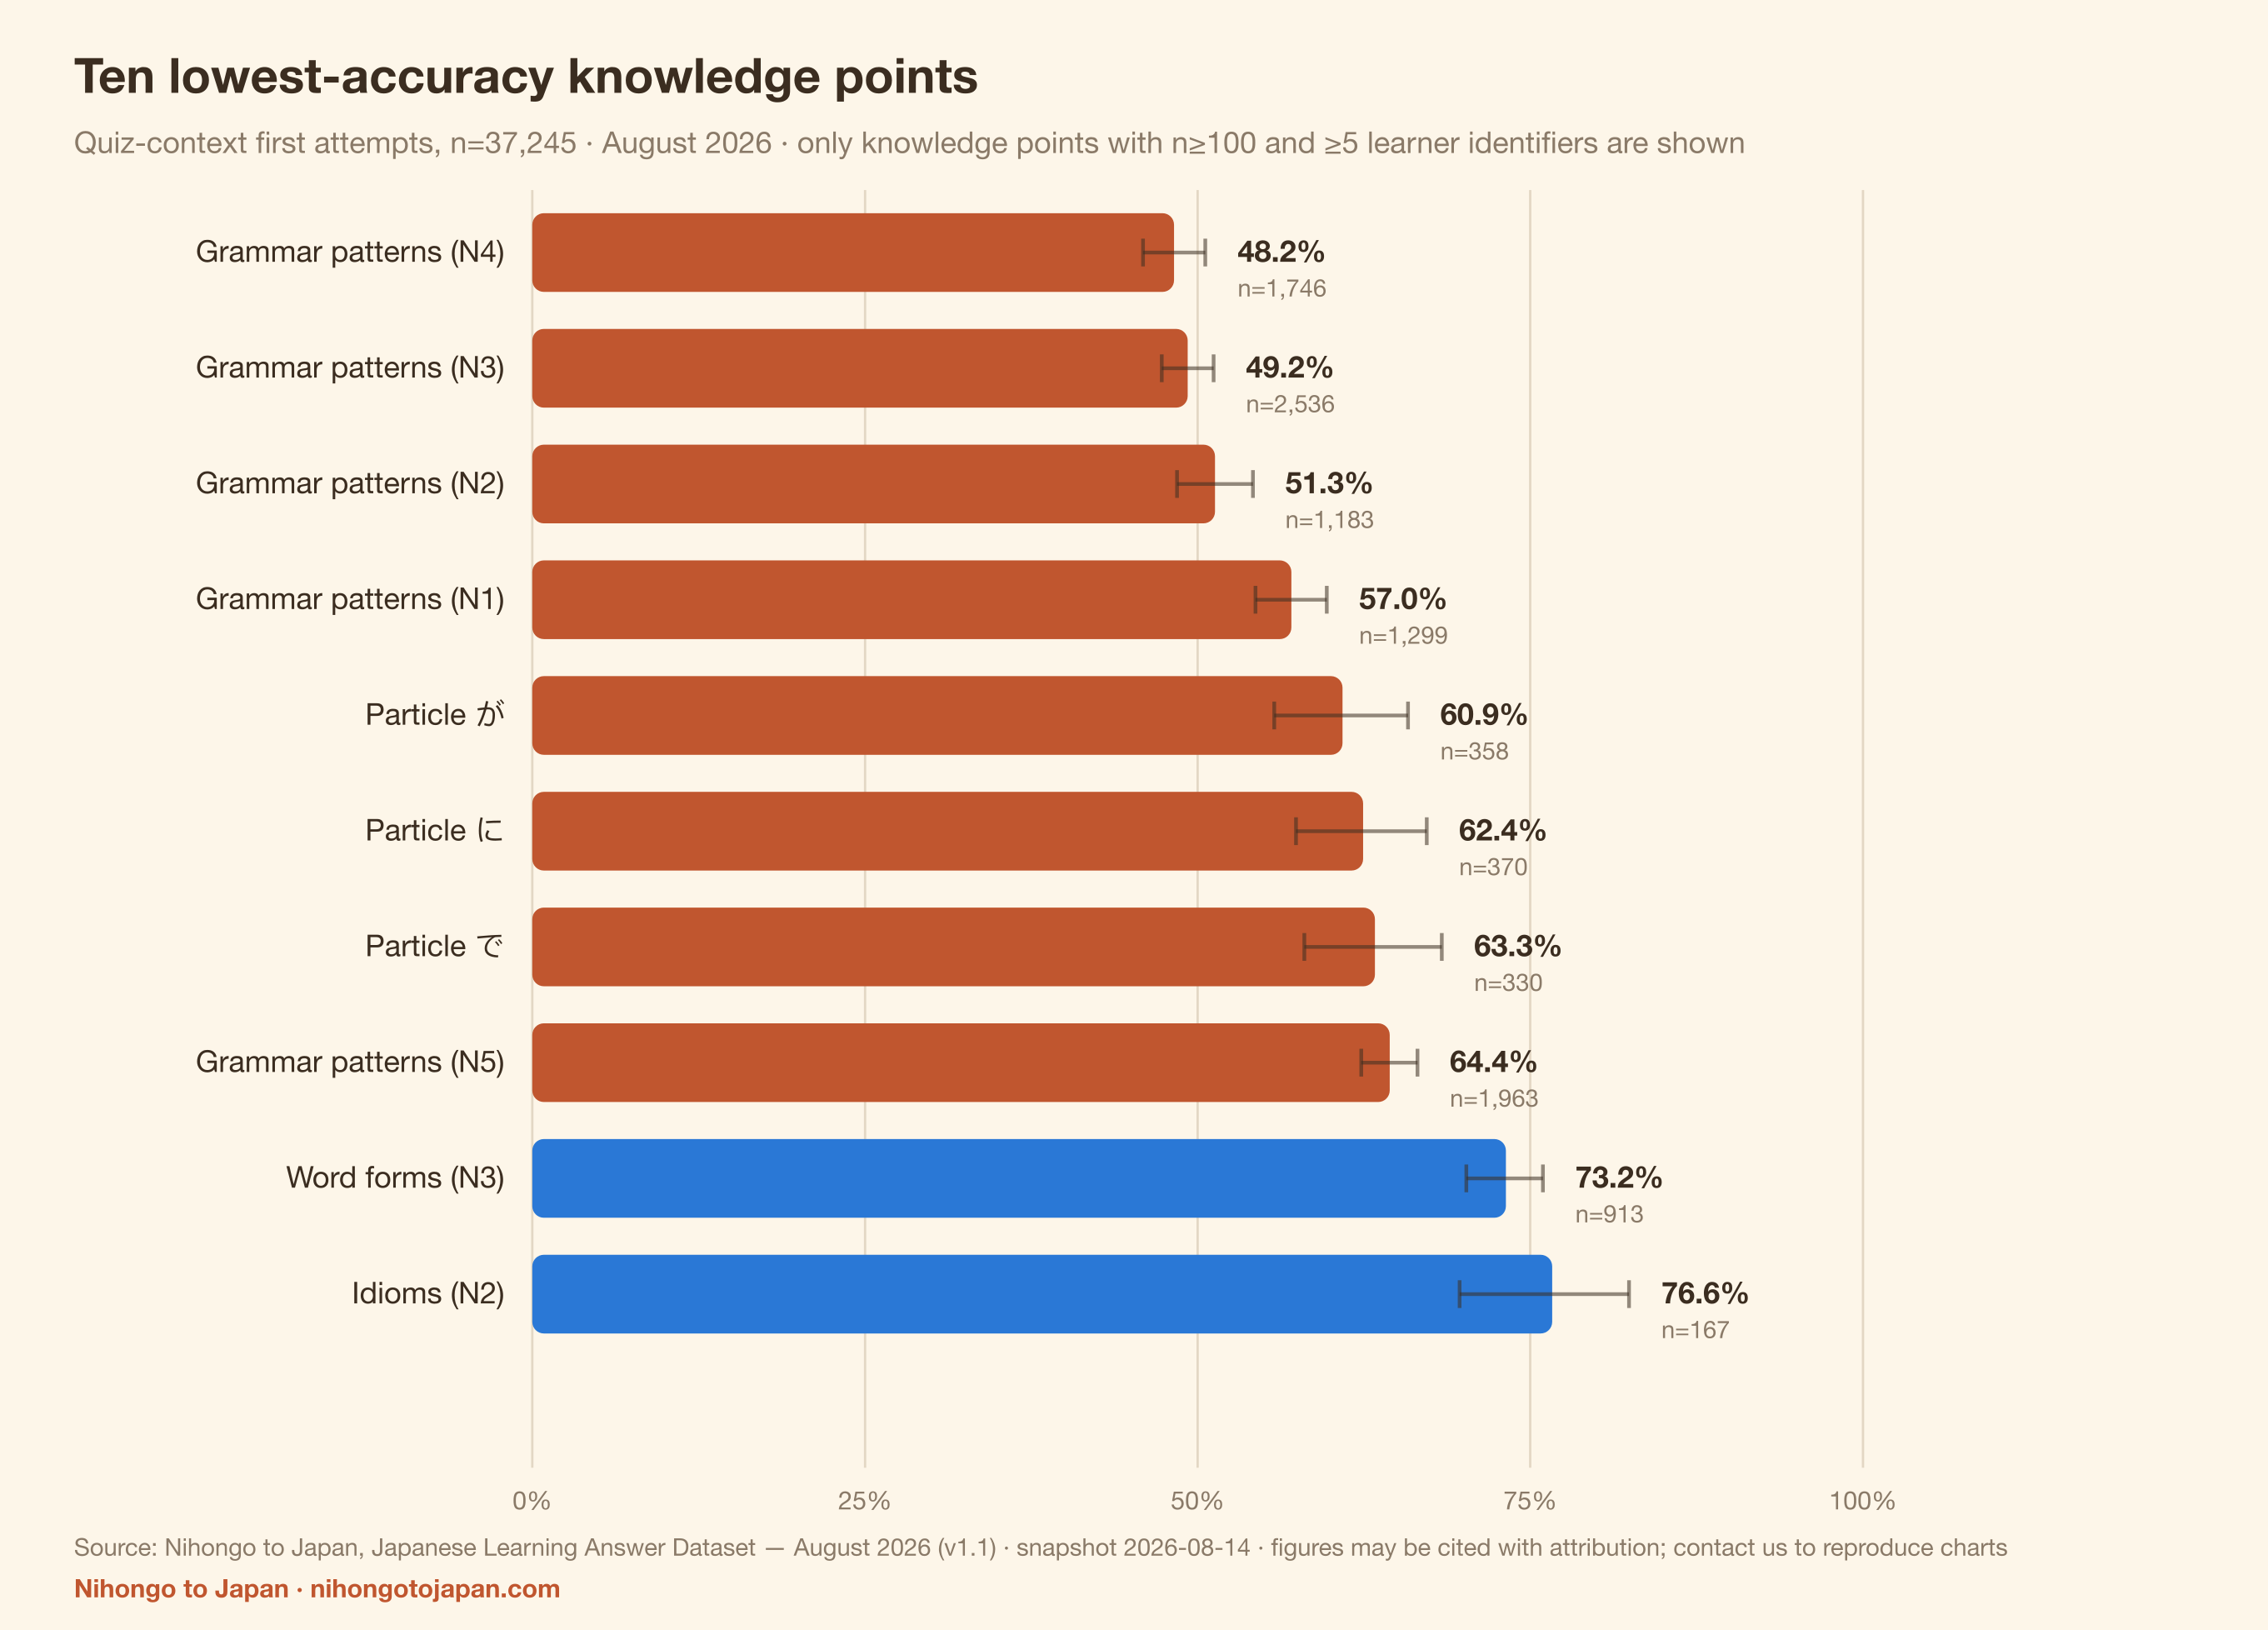
Hanya poin pengetahuan dengan n≥100 dan minimal 5 pengenal pembelajar yang dicantumkan (23 memenuhi syarat). n, level, dan kategori ditampilkan di samping persentasenya — sel yang kecil tampak ekstrem karena alasan yang biasanya hanya derau.

| # | Poin pengetahuan | Kategori | Level | n | Pengenal | Akurasi mentah | SK 95% |
|---|---|---|---|---|---|---|---|
| 1 | Pola kalimat (N4) | Pola kalimat | N4 | 1.746 | 234 | 48,2% | 45,9%–50,6% |
| 2 | Pola kalimat (N3) | Pola kalimat | N3 | 2.536 | 390 | 49,2% | 47,3%–51,2% |
| 3 | Pola kalimat (N2) | Pola kalimat | N2 | 1.183 | 191 | 51,3% | 48,5%–54,1% |
| 4 | Pola kalimat (N1) | Pola kalimat | N1 | 1.299 | 118 | 57,0% | 54,3%–59,7% |
| 5 | Partikel が | Partikel | — | 358 | 81 | 60,9% | 55,8%–65,8% |
| 6 | Partikel に | Partikel | — | 370 | 75 | 62,4% | 57,4%–67,2% |
| 7 | Partikel で | Partikel | — | 330 | 85 | 63,3% | 58,0%–68,3% |
| 8 | Pola kalimat (N5) | Pola kalimat | N5 | 1.963 | 209 | 64,4% | 62,3%–66,5% |
| 9 | Bentuk kata (N3) | Bentuk kata | N3 | 913 | 294 | 73,2% | 70,2%–75,9% |
| 10 | Idiom (N2) | Idiom | N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| 11 | Partikel を | Partikel | — | 385 | 61 | 78,7% | 74,3%–82,5% |
| 12 | Bentuk kata (N2) | Bentuk kata | N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
6. Kekuatan yang paling konsisten
| # | Poin pengetahuan | Kategori | Level | n | Pengenal | Akurasi mentah | SK 95% |
|---|---|---|---|---|---|---|---|
| 1 | Bentuk kata (N1) | Bentuk kata | N1 | 296 | 79 | 95,6% | 92,6%–97,4% |
| 2 | Kosakata (N5) | Kosakata | N5 | 16.029 | 311 | 94,4% | 94,0%–94,8% |
| 3 | Kosakata (N1) | Kosakata | N1 | 703 | 94 | 89,2% | 86,7%–91,3% |
| 4 | Kosakata (N4) | Kosakata | N4 | 2.828 | 243 | 89,0% | 87,8%–90,1% |
| 5 | Idiom (N1) | Idiom | N1 | 742 | 111 | 88,8% | 86,3%–90,9% |
| 6 | Bentuk kata (N4) | Bentuk kata | N4 | 461 | 149 | 87,0% | 83,6%–89,8% |
| 7 | Idiom (N4) | Idiom | N4 | 140 | 91 | 86,4% | 79,8%–91,1% |
| 8 | Idiom (N3) | Idiom | N3 | 290 | 142 | 85,9% | 81,4%–89,4% |
7. Pola teramati yang patut dicatat
Pengamatan A: akurasi mentah N1 berada di atas N2 dan N3
N1 76,0% (n=3.040, 139 pengenal) berada di atas N2 69,4% dan N3 67,8%.
Ini adalah pola teramati, bukan bukti bahwa N1 lebih mudah. Setidaknya ada tiga penjelasan yang tidak dapat dikesampingkan dengan data ini: hanya 139 pengenal yang menjawab soal N1, dibandingkan 432 untuk N3, sehingga komposisi kelompoknya berbeda; himpunan soalnya berbeda; dan tidak dilakukan estimasi kemampuan. Menjawab pertanyaan "level mana yang sebenarnya lebih sulit" memerlukan penyetaraan IRT dan desain butir jangkar (anchor item), dan dataset ini tidak memiliki keduanya.
Pengamatan B: sumbu pola kalimat adalah yang terendah di setiap level
| Sumbu × level | n | Pengenal | Akurasi mentah | SK 95% |
|---|---|---|---|---|
| Pola kalimat × N4 | 1.734 | 233 | 48,0% | 45,6%–50,3% |
| Pola kalimat × N3 | 2.531 | 389 | 49,2% | 47,2%–51,1% |
| Pola kalimat × N2 | 1.179 | 191 | 51,1% | 48,3%–54,0% |
| Pola kalimat × N1 | 1.295 | 118 | 57,0% | 54,3%–59,7% |
| Partikel × N4 | 766 | 92 | 58,5% | 55,0%–61,9% |
| Pola kalimat × N5 | 1.939 | 208 | 64,0% | 61,8%–66,1% |
| Bentuk kata / konjugasi × N3 | 948 | 302 | 74,2% | 71,3%–76,8% |
| Partikel × N5 | 1.220 | 111 | 75,8% | 73,3%–78,1% |
| Ungkapan idiomatis × N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| Bentuk kata / konjugasi × N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
Jika sumbu disilangkan dengan level, hampir semua sel terendah adalah sel pola kalimat. Ini lebih informatif daripada rincian per level saja.
8. Manfaatnya bagi pengajar dan perancang materi
Bagian ini dengan sengaja memisahkan data dari interpretasi. Datanya dapat dikutip; interpretasinya adalah penilaian kami, dan Anda bebas tidak setuju.
| Data (dapat dikutip) | Interpretasi (penilaian kami, bukan data) |
|---|---|
| Percobaan pertama dalam konteks kuis: sumbu pola kalimat 53,7% berbanding kosakata 92,1% (n=8.678 dan 22.869) | Di platform ini ada kesenjangan yang jelas antara mengenali kata dan menyusun kalimat. Jika waktu latihan harus dibagi, pola kalimat mungkin memberikan imbal hasil marginal yang lebih tinggi. |
| が 60,9%, に 62,4%, で 63,3% berada jauh di bawah を 78,7% dan の 83,3% | を dan の memiliki fungsi yang relatif sempit, sedangkan が, に, dan で sangat polisemis. Mengajarkan fungsi-fungsi berbeda dari satu partikel secara terpisah mungkin lebih efektif daripada memperkenalkan partikel satu per satu. |
| Akurasi mentah N2 dan N3 (69,4% / 67,8%) berada di bawah N4, N1, dan N5 | ⚠️ Jangan memakai ini untuk mengurutkan tingkat kesulitan. Pembacaan yang lebih masuk akal adalah bahwa pembelajar yang menjawab di N2/N3 berbeda komposisinya dari mereka yang berada di level lain, bukan karena sesuatu pada soalnya. |
| Pola kalimat: 85,4% di konteks pelajaran (n=13.937) berbanding 53,7% di konteks kuis (n=8.678); selisih berpasangan +27,5 pp pada 75 pengenal | Menjawab di dalam pelajaran dan menjawab kuis menghasilkan angka yang sangat berbeda — perlu diingat ketika skor latihan di platform dipakai untuk menilai hasil belajar. ⚠️ Namun kedua konteks memakai himpunan soal yang hampir sepenuhnya terpisah, sehingga kami tidak dapat mengatakan apakah ini karena konteksnya atau semata-mata karena soalnya lebih mudah. |
9. Metodologi
| Butir | Rincian |
|---|---|
| Populasi | Catatan jawaban yang dihasilkan oleh pembelajar yang memakai Nihongo to Japan. |
| Pengambilan sampel | Sampel observasional swaseleksi. Bukan pengambilan sampel acak; tidak mewakili populasi. |
| Unit analisis | peristiwa jawaban (satu pengenal pembelajar menjawab satu soal satu kali). |
| Jumlah pengguna | pengenal pembelajar = pengenal anonim yang berbeda. Pengenal tidak dapat digabungkan lintas perangkat, sehingga angka ini adalah batas atas jumlah orang, bukan hitungan kepala yang terverifikasi. |
| Metrik | akurasi mentah = jawaban benar ÷ peristiwa jawaban yang valid. Bukan estimasi kemampuan. |
| Selang kepercayaan | SK Wilson 95%. Hanya mencerminkan galat sampling; tidak mengoreksi bias seleksi. |
Empat himpunan analisis
| Himpunan | Definisi | n |
|---|---|---|
| Percobaan pertama dalam konteks kuis (himpunan analisis utama) | Jawaban dari challenge / placement_test / special_training yang merupakan percobaan pertama pengenal pembelajar tersebut pada soal itu, bukan pengulangan dalam 24 jam, dan memiliki metadata soal yang lengkap. | 37.245 |
| Percobaan pertama dalam konteks pelajaran (himpunan pembanding) | Percobaan pertama dari self_study / review — jawaban yang diberikan sambil mengerjakan materi pelajaran. | 15.741 |
| Percobaan pertama (semua konteks) | Jawaban pertama setiap pengenal pembelajar untuk setiap soal, apa pun sumbernya. | 52.934 |
| Seluruh peristiwa jawaban | Setiap peristiwa jawaban yang valid, termasuk pengulangan. | 56.613 |
⚠️ Himpunan utama tidak membuat klaim apa pun tentang petunjuk atau penjelasan. Fieldused_hint/viewed_explanation/used_answer_keybernilai false di seluruh basis data, tetapi hanya karena tidak ada satu pun bagian sistem yang pernah menulisnya — tidak satu pun titik pemanggilan pencatat jawaban yang mengirim parameter ini, dan produk saat ini tidak memiliki fitur petunjuk sebelum menjawab atau fitur membuka kunci jawaban. Nilai false yang konstan itu adalah sifat instrumentasi, bukan bukti tentang perilaku pembelajar. Karena itu field-field ini tidak dipakai sebagai syarat analisis, dan tidak ada klaim yang dibuat tentang penggunaan petunjuk.
Verifikasi independen atas himpunan utama: dengan menghitung ulang peristiwa paling awal per (pengenal, soal) di server, 99,59% peristiwa himpunan utama (37.094 dari 37.245) lolos uji percobaan pertama. 151 yang tidak lolos kemungkinan besar terjadi lintas perangkat — orang yang sama menjawab di dua perangkat, dan masing-masing perangkat mencatat percobaan pertama. Setiap peristiwa dalam himpunan ini memiliki attempt_number = 1.
Yang dikecualikan
- Soal yang diketahui rusak: 520 id soal dikecualikan dari semua agregat. Ada dua penyebab: (1) soal isian rumpang non-tata bahasa dari materi pelajaran (konversi kana, ortografi, jawaban angka) yang salah ditandai masuk ke sumbu pola kalimat; (2) build lama "soal hari ini" yang memakai token jawaban sebagai pengenal soal, sehingga soal-soal yang berbeda tertumpuk pada satu id. Front end sudah diperbaiki; data historis dikecualikan melalui denylist. Tidak ada satu pun peristiwa mentah yang dihapus — tabelnya hanya dapat ditambahi (append-only).
- Peristiwa setelah batas waktu snapshot: laporan ini dibekukan pada 2026-08-14T00:00:00Z. Data terus bertambah, tetapi setiap angka di halaman ini dan di berkas unduhan berasal dari satu titik beku tersebut.
Ukuran sel minimum
Sel dengan n<30 atau kurang dari 5 pengenal pembelajar ditandai SUPPRESSED: jumlah peristiwanya diterbitkan, tetapi akurasinya tidak. Sel dengan n≥30 dan ≥5 pengenal tetapi n<100 ditandai LOW_SAMPLE dan harus selalu dikutip bersama n-nya. Sel dengan n≥100 dan ≥5 pengenal ditandai OK.
Dalam snapshot ini, 23 poin pengetahuan berstatus OK, 12 berstatus LOW_SAMPLE, dan 3 berstatus SUPPRESSED.
Anonimisasi
- Setiap peristiwa hanya membawa UUID perangkat anonim yang dibuat di peramban. Tidak ada nama, email, alamat IP, sidik jari perangkat, atau masukan teks bebas dalam bentuk apa pun.
- Cloudflare Pages Function penerima hanya menulis kolom yang masuk daftar putih dan secara eksplisit tidak pernah menulis alamat IP.
- Dataset publik hanya berisi statistik agregat — tidak ada satu pun peristiwa jawaban mentah.
- Pembelajar dapat memilih keluar dari pengumpulan data agregat dengan satu klik di halaman kebijakan privasi.
10. Keterbatasan (mohon kutip bersama angka-angkanya)
Jika Anda hanya membaca satu paragraf, bacalah yang ini. Data ini menggambarkan bagaimana orang-orang yang datang berlatih di Nihongo to Japan mengerjakan soal-soal Nihongo to Japan. Data ini bukan gambaran pembelajar bahasa Jepang di Taiwan, bukan ukuran tingkat kesulitan JLPT, dan tidak dapat dipakai untuk membandingkan tingkat kesulitan objektif antarlevel.
- Bias seleksi: sampelnya adalah orang-orang yang memilih berlatih di sini. Mereka kemungkinan lebih termotivasi daripada pembelajar pada umumnya, dan mungkin lebih muda serta lebih terbiasa dengan perangkat daring.
- Pengukuran berulang: satu pengenal yang paling aktif menyumbang 3,7% dari seluruh jawaban dan sepuluh pengenal teratas 19,4%. Pada 372 pengenal yang sama, pembobotan per peristiwa dan pembobotan per pengenal berselisih 7,04 poin persentase.
- Himpunan analisis tidak dapat langsung dikurangkan satu sama lain: konteks pelajaran dan konteks kuis memakai himpunan soal yang hampir sepenuhnya terpisah (dari 5.772 soal pola kalimat, hanya 6 yang muncul di keduanya), sehingga selisih akurasi di antara keduanya tidak dapat dikaitkan dengan satu penyebab tunggal.
- Perilaku memakai petunjuk dan penjelasan tidak dapat diamati: field terkait tidak pernah ditulis, sehingga dataset ini sama sekali tidak membuat klaim tentang hal tersebut.
- Tingkat kesulitan soal tidak setara: setiap level dan sumbu memakai himpunan soal yang berbeda, sehingga akurasi mentah bukan ukuran tingkat kesulitan yang dinormalisasi.
- Tidak ada penyetaraan IRT: tidak ada penyetaraan berbasis teori respons butir (item response theory) dan tidak ada desain butir jangkar lintas level, sehingga data ini tidak dapat menjawab level mana yang lebih sulit.
- Ukuran sampel tidak setara: jumlah jawaban N5 lebih dari enam kali jumlah jawaban N1.
- Rentang waktu singkat: hanya 12 hari (pipeline agregasi mulai berjalan pada 2026-08-02). Tidak ada tren longitudinal yang dapat dibaca dari data ini.
- Lalu lintas otomatis tidak dapat diidentifikasi: tidak ada mekanisme untuk membedakan manusia dari skrip. Waktu respons bernilai null pada 94% peristiwa, sehingga penyaringan dasar "jawaban yang mustahil secepat itu" pun tidak tersedia. Ini adalah celah kualitas data yang sudah diketahui.
- Tidak mewakili populasi: data ini tidak mewakili seluruh pembelajar bahasa Jepang di Taiwan maupun di negara lain mana pun.
11. Cara mengutip
Kami menyambut pengutipan dalam makalah, laporan penelitian, materi ajar, dan karya jurnalistik. Mohon cantumkan sumbernya dengan tautan kembali ke halaman ini.
APA (7th)
Nihongo to Japan. (2026). Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/en/research/japanese-learning-data-2026MLA (9th)
Nihongo to Japan. Japanese Learning Answer Dataset — August 2026. Version 1.1.0, 2026, https://www.nihongotojapan.com/en/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/en/research/japanese-learning-data-2026}

}
Status lisensi
Data dirilis dengan lisensi CC BY 4.0: bebas dipakai, termasuk untuk tujuan komersial, asalkan Anda mencantumkan sumbernya. Grafik dan teks laporan tidak termasuk. Ketentuan lengkap ada di bagian Lisensi.
Teks atribusi yang disarankan:
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Lisensi: datanya berlisensi CC BY 4.0
Data dalam dataset ini dirilis dengan lisensi Creative Commons Attribution 4.0 International (CC BY 4.0). Anda boleh menyalin, menyebarluaskan ulang, mengadaptasi, dan mengembangkannya, termasuk untuk tujuan komersial, asalkan Anda mencantumkan sumber dengan semestinya dan menyebutkan jika ada perubahan.
⚠️ Lisensi ini hanya mencakup data. Yang dicakup CC BY 4.0: angka-angka agregat di halaman ini dan dua berkas unduhan,japanese-learning-2026.jsondanjapanese-learning-2026.csv. Grafik yang dibuat oleh Nihongo to Japan (SVG/PNG) dan teks laporan tidak tercakup dan hak ciptanya tetap dilindungi.
Yang boleh Anda lakukan tanpa meminta izin kami
- Mengutip statistiknya dalam makalah, laporan penelitian, materi ajar, dan karya jurnalistik, termasuk publikasi komersial.
- Menganalisis ulang angka agregat dan membuat grafik sendiri — grafik yang Anda buat adalah milik Anda.
- Mengadaptasi, meramu ulang, mengubah, dan menyebarluaskan ulang dalam bentuk apa pun, termasuk menyebarluaskan ulang berkas data secara utuh atau memaketkannya ke dalam produk data Anda sendiri.
- Memakai data ini di kelas dan dalam kegiatan pendidikan.
Atribusi
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Permintaan kami (bukan syarat lisensi)
Hal-hal berikut bukan syarat CC BY, dan mengabaikannya bukan pelanggaran. Kami tetap memintanya, dengan alasan yang kami sertakan untuk masing-masing:
- Sertakan keterbatasan sampelnya (sampel observasional swaseleksi, hanya 12 hari, tidak representatif) — mengutip angka tanpa keterbatasan tersebut berarti menerbitkan statistik yang menyesatkan.
- Tautkan kembali ke halaman ini — agar pembaca Anda dapat melihat metodologi dan versinya.
- Tulis "pengenal pembelajar", bukan "orang" — jumlah pengenal adalah batas atas jumlah orang, bukan hitungan kepala.
- Sebutkan versinya (misalnya v1.1.0, snapshot 2026-08-14) — agar angka yang Anda kutip tetap dapat dikenali setelah pembaruan berikutnya.
Yang tidak dicakup lisensi
- Grafik yang kami buat (
/images/research/*.svgdan*.png): mohon hubungi kami sebelum memperbanyaknya. Membuat grafik sendiri dari data tidak memerlukan izin. - Teks laporan dan teks situs web ini: hak cipta dilindungi.
- Nama situs, logo, dan tanda merek: lisensi ini tidak memberikan hak apa pun untuk memakainya.
⚠️ CC BY tidak dapat dicabut. Siapa pun yang menerima data berdasarkan ketentuan ini tetap memegang hak tersebut meskipun kelak kami mengubah ketentuannya. Kami menyatakannya di sini karena siapa pun yang mengutip data ini berhak mengetahui seberapa stabil izin yang mereka miliki.
12. Unduh data
Dua format dengan isi identik, keduanya hanya berisi statistik agregat (tanpa peristiwa jawaban mentah):
- japanese-learning-2026.json — metadata lengkap, definisi, metodologi, keterbatasan, dan setiap sel agregat.
- japanese-learning-2026-LICENSE.txt — pemberitahuan lisensi (CC BY 4.0, cakupan, teks atribusi). Berkas CSV tidak punya tempat untuk memuatnya, jadi pemberitahuan ini disertakan sebagai berkas terpisah.
- japanese-learning-2026.csv — satu baris per sel. Kolom:
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag.
Versi 1.1.0 · snapshot 2026-08-14 · versi metodologi 1.1. Pembaruan mendatang akan menaikkan nomor versi dan mempertahankan angka-angka sebelumnya, bukan menimpanya.
Berkas grafik: keempat grafik di halaman ini tersedia dalam format PNG (resolusi 2×, untuk slide dan tata letak cetak) dan SVG (vektor, dapat diperbesar).
- Akurasi mentah menurut sumbu pembelajaran: PNG・SVG
- Akurasi mentah menurut level JLPT: PNG・SVG
- Poin pengetahuan dengan akurasi terendah: PNG・SVG
- Sebaran sampel: PNG・SVG
Setiap grafik memuat judul, n, versi, dan label sumbernya sendiri, sehingga tetap menyatakan cakupannya meskipun beredar terpisah; teks alt untuk keempatnya dikumpulkan di alt-text.json. ⚠️ Grafik tidak dicakup oleh CC BY, jadi mohon hubungi kami sebelum memperbanyaknya (lihat kontak); datanya sendiri berlisensi CC BY 4.0 dan bebas dipakai dengan mencantumkan sumber (lihat Lisensi).
⚠️ Untuk pengutipan, gunakan dataset beku yang berversi, bukan endpoint agregat yang diperbarui secara berkala.
Ada pula endpoint agregat yang diperbarui secara berkala di /api/aggregates; angkanya berubah dari waktu ke waktu (bukan versi beku). Endpoint ini memakai definisi yang berbeda: berbasis seluruh peristiwa jawaban, bukan percobaan pertama dalam konteks kuis, dan totalUsers-nya hanya menghitung pengenal pembelajar dalam himpunan utama (688), bukan seluruh 1.053. Angkanya berubah setiap hari dan tidak cocok untuk dikutip.
Untuk jurnalis
- Sampel: 56.613 jawaban anonim dari 1.053 pengenal pembelajar anonim (bukan hitungan kepala yang terverifikasi) selama 12 hari, 2–13 Agustus 2026.
- Metode dalam satu kalimat: akurasi mentah pada sampel observasional swaseleksi; angka utama memakai himpunan percobaan pertama dalam konteks kuis (percobaan pertama dalam konteks tantangan, tes penempatan, dan latihan khusus).
- Keterbatasan dalam satu kalimat: ini bukan survei representatif tentang pembelajar bahasa Jepang, dan tidak dapat dipakai untuk membandingkan tingkat kesulitan objektif level JLPT.
Tiga angka yang dapat dikutip langsung:
- Akurasi pola kalimat 53,7% (n=8.678) berbanding kosakata 92,1% (n=22.869) — selisih 38 poin.
- Partikel が dijawab benar 60,9% (n=358); を mencapai 78,7% (n=385).
- Akurasi pola kalimat berkisar dari 53,7% sampai 74,1%, tergantung konteks menjawab mana yang disertakan (konteks pelajaran 85,4%, konteks kuis 53,7%). ⚠️ Kedua konteks memakai himpunan soal yang hampir sepenuhnya terpisah sehingga penyebabnya tidak dapat dipastikan — tetapi hal itu sendiri sudah merupakan cerita tentang bagaimana data platform belajar dikutip.
Format pengutipan · Unduh data · Kontak
Sematkan data ini (tempel ke tulisan blog atau materi ajar)
Tempelkan HTML di bawah ini ke artikel atau handout Anda. Kode ini sudah memuat ukuran sampel, versi, lisensi, dan catatan "tidak mewakili populasi" — persis bagian-bagian yang biasanya hilang ketika statistik dikutip dari tangan kedua. Tidak perlu memberi tahu kami terlebih dahulu.
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">Dari 56,613 jawaban anonim, akurasi pola kalimat pada percobaan pertama dalam konteks kuis adalah <strong>53.7%</strong> (n=8,678), berbanding <strong>92.1%</strong> untuk kosakata (n=22,869).</p><p style="margin:0;font-size:13px;color:#8a7a68">Sumber: <a href="https://www.nihongotojapan.com/en/research/japanese-learning-data-2026">Nihongo to Japan, Japanese Learning Answer Dataset — August 2026</a> v1.1.0 · CC BY 4.0 · sampel observasional swaseleksi, tidak mewakili populasi</p></blockquote>
Mengapa blok yang dapat ditempel, bukan iframe? Ada dua alasan: situs ini tidak mengizinkan dirinya dimuat di dalam frame (frame-ancestors 'none' di seluruh situs, perlindungan terhadap clickjacking yang ingin kami pertahankan); dan konten di dalam iframe disajikan dari domain kami, sehingga tidak terbaca sebagai tautan yang diberikan oleh halaman Anda — sedangkan blok yang ditempel terbaca demikian. Anda juga sepenuhnya bebas menata tampilannya sendiri: datanya berlisensi CC BY 4.0, jadi yang kami minta hanyalah atribusi.
Untuk gambar: grafik kami tidak dicakup lisensi, tetapi Anda dapat membuat grafik sendiri dari CSV, dan grafik itu menjadi milik Anda. Untuk pemakaian grafik kami sendiri dalam pengajaran atau media, lihat kit pers.
Kit pers
Semua isi bagian ini boleh disalin dan dipakai tanpa meminta izin kami terlebih dahulu (kecuali grafik — lihat di bawah). Fakta singkat dan tiga angka yang dapat dikutip langsung ada di Untuk jurnalis; daftar lengkapnya ada di sepuluh temuan yang dapat dikutip.
Teks profil standar
Versi panjang:
Nihongo to Japan adalah situs belajar bahasa Jepang yang dikelola secara independen oleh seorang pengembang perorangan. Situs ini tidak mewajibkan pendaftaran, seluruh kursusnya gratis selamanya, dan mencakup JLPT N5 sampai N1 melalui penjelasan tata bahasa, pelajaran belajar mandiri, dan soal latihan. Dataset ini diambil dari catatan jawaban anonim yang dihasilkan pembelajar di situs tersebut, diagregasi dari snapshot beku, dan diterbitkan bersama metodologi serta keterbatasannya secara lengkap.
Versi pendek:
Nihongo to Japan, situs belajar bahasa Jepang yang dikelola secara independen dengan seluruh kursus yang gratis selamanya, menerbitkan dataset agregat dari jawaban anonim para pembelajarnya.
Gambar untuk publikasi
Grafik yang kami buat tidak dicakup oleh CC BY 4.0 (lisensi hanya mencakup data — lihat Lisensi). Kami tidak ingin hal itu menjadi hambatan, jadi ada dua jalur:
- Minta kepada kami: kami mengirimkan berkas gambar siap terbit dalam 24 jam (PNG dan SVG), lengkap dengan keterangan, ukuran sampel, dan label versi yang benar. Ini adalah jalur cepat khusus gambar, lebih cepat daripada pertanyaan umum (2–3 hari kerja).
- Atau tidak perlu menunggu — buat sendiri. Datanya sendiri berlisensi CC BY 4.0, jadi Anda dapat membuat grafik sendiri langsung dari JSON atau CSV. Grafik yang Anda buat adalah milik Anda: tidak perlu izin, dan tidak perlu memberi tahu kami.
Empat catatan untuk pemberitaan yang bertanggung jawab
Ini bukan syarat — catatan ini ada agar Anda tidak perlu menerbitkan ralat di kemudian hari:
- ✅ Mohon tulis "dalam kumpulan jawaban ini" atau "pada percobaan pertama soal kuis". Setiap angka di halaman ini adalah nilai teramati di dalam dataset ini.
- ❌ Jangan mengubahnya menjadi "pembelajar Taiwan melakukan X". Sampelnya adalah orang-orang yang memilih berlatih di situs ini; sampel ini tidak mewakili populasi yang lebih luas.
- ❌ Jangan membandingkan tingkat kesulitan level JLPT. Setiap level memakai himpunan soal yang berbeda, tidak ada penyetaraan IRT, dan selang kepercayaan N3 dan N2 tumpang-tindih — data ini tidak dapat membedakan keduanya.
- ❌ Jangan merumuskannya secara kausal. Data dapat mengatakan "teramati bersamaan"; data tidak dapat mengatakan "karena".
Jika Anda ragu apakah suatu rumusan tertentu dapat dipertanggungjawabkan, tanyakan saja kepada kami — jauh lebih murah daripada ralat setelah terbit.
Kutipan yang dapat diatribusikan
Kedua kutipan di bawah boleh dipakai langsung tanpa meminta izin.
"Pada percobaan pertama soal kuis, kosakata 92,1% berbanding pola kalimat 53,7%. Ini hanya menggambarkan orang-orang yang memilih berlatih di situs kami; tidak bisa digeneralisasi ke pembelajar secara umum. Tetapi kalau Anda tersendat di tahap 'saya tahu kata-katanya, hanya saja tidak bisa menyusun kalimatnya', Anda tidak sendirian."
— Pendiri, Nihongo to Japan
"Pada data yang sama, hanya dengan mengubah jawaban mana yang dihitung, akurasi pola kalimat bergeser dari 53,7% ke 85,4%. Kami menerbitkan keempat definisi berdampingan, karena satu angka utama saja tidak memberi pembaca cara untuk mengetahui angka yang mana yang sedang mereka lihat."
— Pendiri, Nihongo to Japan
Tidak ada tim riset dan tidak ada juru bicara pers. Kutipan di atas diatribusikan kepada orang yang benar-benar membangun dataset ini; untuk tanggapan atas pertanyaan tertentu, mohon gunakan bagian kontak.
Untuk peneliti dan pendidik
Struktur: satu baris per sel agregat, diindeks menurut dimension (axis / jlpt / knowledge_point / axis_x_jlpt) × analysis_set (quiz_first_attempt / lesson_first_attempt / first_attempt / all_events). Setiap sel melaporkan n, learners, accuracy, ci95_low/ci95_high Wilson, dan sebuah flag. JSON juga memuat dekomposisi himpunan analisis, perbandingan berpasangan, dan efek pembobotan.
Pengambilan sampel: swaseleksi dan observasional; unit analisisnya adalah peristiwa jawaban; pengenal pembelajar adalah UUID anonim, sehingga jumlah pengenal merupakan batas atas jumlah orang (orang yang sama di dua perangkat menghasilkan dua pengenal, dan pengenal tidak dapat ditautkan satu sama lain).
Celah metodologis yang diketahui — menurut kami lebih baik dinyatakan daripada disembunyikan:
- Tidak ada penyetaraan tingkat kesulitan IRT dan tidak ada butir jangkar lintas level, sehingga perbandingan antarlevel tidak berlaku.
- Konteks pelajaran dan konteks kuis memakai himpunan soal yang hampir sepenuhnya terpisah (hanya 6 dari 5.772 soal pola kalimat yang beririsan), sehingga efek konteks dan tingkat kesulitan soal tidak dapat dipisahkan.
- Field petunjuk / penjelasan / kunci jawaban tidak pernah ditulis, sehingga perilaku tersebut tidak dapat diamati. Field itu tidak dapat dipakai sebagai syarat analisis, dan ketiadaannya tidak dapat dibaca sebagai "hal itu tidak terjadi".
- Waktu respons bernilai null pada 94% peristiwa, sehingga tidak ada analisis trade-off kecepatan–akurasi dan tidak ada penyaringan jawaban yang mustahil cepatnya.
- Tidak ada variabel demografis (usia, bahasa ibu, lama belajar, negara), sehingga analisis berstrata tidak mungkin dilakukan. Dataset ini tidak memiliki field bahasa ibu maupun field geografi, sehingga laporan ini tidak membuat inferensi apa pun tentang bahasa ibu atau lokasi pembelajar.
- Rentang 12 hari, sehingga tidak ada kurva belajar dan tidak ada analisis retensi.
- Data tingkat pembelajar tidak diterbitkan (hanya agregat), sehingga model multilevel tidak dapat dicocokkan ulang secara eksternal. Jika hal ini penting bagi penelitian Anda, silakan hubungi kami.
Unduh JSON · Unduh CSV · Format pengutipan · Metodologi lengkap
Kontak media dan data
Pendiri, Nihongo to Japan · Email: [email protected]
Dengan senang hati kami menjawab: rincian metodologi, pemeriksaan ulang angka agregat mana pun, permintaan untuk memperbanyak grafik, batas-batas hal yang dapat didukung oleh data ini, dan apakah dataset ini dapat menjawab pertanyaan tertentu. Balasan biasanya dalam 2–3 hari kerja; permintaan gambar siap terbit dari media masuk jalur cepat dan dijawab dalam 24 jam (lihat kit pers).
Situs ini dikelola secara independen oleh seorang pengembang perorangan. Tidak ada tim riset dan tidak ada juru bicara pers — alamat di atas langsung sampai ke orang yang benar-benar membangun dataset ini, bukan ke meja resepsionis. Kami menyatakannya di sini karena siapa pun yang mengutip data ini berhak mengetahui siapa yang ada di baliknya.
Versi dan catatan perubahan
URL ini selalu mengarah ke snapshot terbaru. Setiap rilis memiliki nomor versi dan tanggal pembekuan, jadi mohon sertakan versinya saat mengutip (misalnya: v1.1.0, snapshot 2026-08-14) — ketika angka-angkanya diperbarui kelak, versi yang Anda kutip tetap dapat dikenali. Unduhan JSON dan CSV memuat field versi yang sama.
| Versi | Snapshot dibekukan | Cakupan | Catatan |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 sampai 10-21 (81 hari) | Rilis lebih baru di URL tersendiri (himpunan analisis berbeda). |
| v1.1.0 | 2026-08-14 | 2–13 Agustus 2026 (12 hari) | Rilis publik pertama. Himpunan analisis utama: percobaan pertama dalam konteks kuis; keempat himpunan analisis diterbitkan berdampingan. |
Rilis berikutnya diperkirakan terbit setelah terkumpul data tambahan sekitar tiga bulan, yaitu titik paling awal untuk dapat membahas tren apa pun. Pembaruan data tidak akan menulis ulang angka dari versi yang sudah diterbitkan: rilis baru mendapat nomor versi baru dan tanggal pembekuan baru, dan angka-angka sebelumnya tetap dapat dikenali melalui versinya. Jika Anda sudah mengutip suatu versi dan angkanya berubah, kirimkan pesan kepada kami dan kami akan memberi tahu Anda dengan tepat apa yang berbeda.
← Kembali ke Riset dan data | Cara Orang Taiwan Belajar Bahasa Jepang 2026 | Untuk pengajar & perpustakaan