Dataset Jawaban Pembelajaran Bahasa Jepang — Oktober 2026: 543.344 jawaban, tingkat kesulitan yang disesuaikan dengan kemampuan, dan jarak pengulangan
Ringkasnya: statistik agregat dari 543.344 jawaban anonim di Nihongo to Japan, untuk periode 2 Agustus – 21 Oktober 2026 (81 hari) dan 25.850 soal — 9,6 kali volume rilis Agustus (v1.1.0).
⚠️ v2 dan v1 menggunakan himpunan analisis yang berbeda. Jangan mengurangkan tingkat jawaban benar satu rilis dengan rilis lainnya. v1 dihitung langsung dari basis data, dengan "percobaan pertama dalam konteks kuis" sebagai himpunan utamanya. v2 sengaja hanya memakai endpoint agregat publik yang dapat diakses siapa saja (/api/aggregates,/api/community), sehingga ukuran utamanya adalah "semua jawaban" dan "percobaan pertama tingkat soal, satu suara per soal". Kelebihannya adalah keterulangan: sha256 setiap berkas masukan dicatat dalam unduhan, sehingga peneliti dari luar dapat memverifikasi dengan tepat data mana yang kami gunakan. Lihat Metodologi.
Apa yang bukan merupakan dataset ini. Dataset ini bukan survei representatif terhadap pelajar bahasa Jepang. Sampelnya adalah orang-orang yang memilih berlatih di situs ini — sampel observasional yang memilih dirinya sendiri (self-selected). Setiap angka hanya menggambarkan apa yang terjadi dalam log jawaban NTJ; tidak ada yang dapat digeneralisasi ke suatu populasi, dan tidak ada yang merupakan klaim sebab-akibat. Lihat Keterbatasan.
Sepuluh temuan yang dapat dikutip
Setiap butir berdiri sendiri: menyebutkan dataset, periode, ukuran sampel, dan himpunan analisisnya, sehingga dapat dikutip secara terpisah. Mohon sertakan juga keterbatasannya.
- Dataset Jawaban Pembelajaran Bahasa Jepang NTJ (Oktober 2026, v2.0.0) memuat 543.344 jawaban anonim untuk 25.850 soal yang tercatat antara 2 Agustus dan 21 Oktober 2026 — 9,6 kali dari 56.613 jawaban dalam rilis Agustus 2026 situs ini.
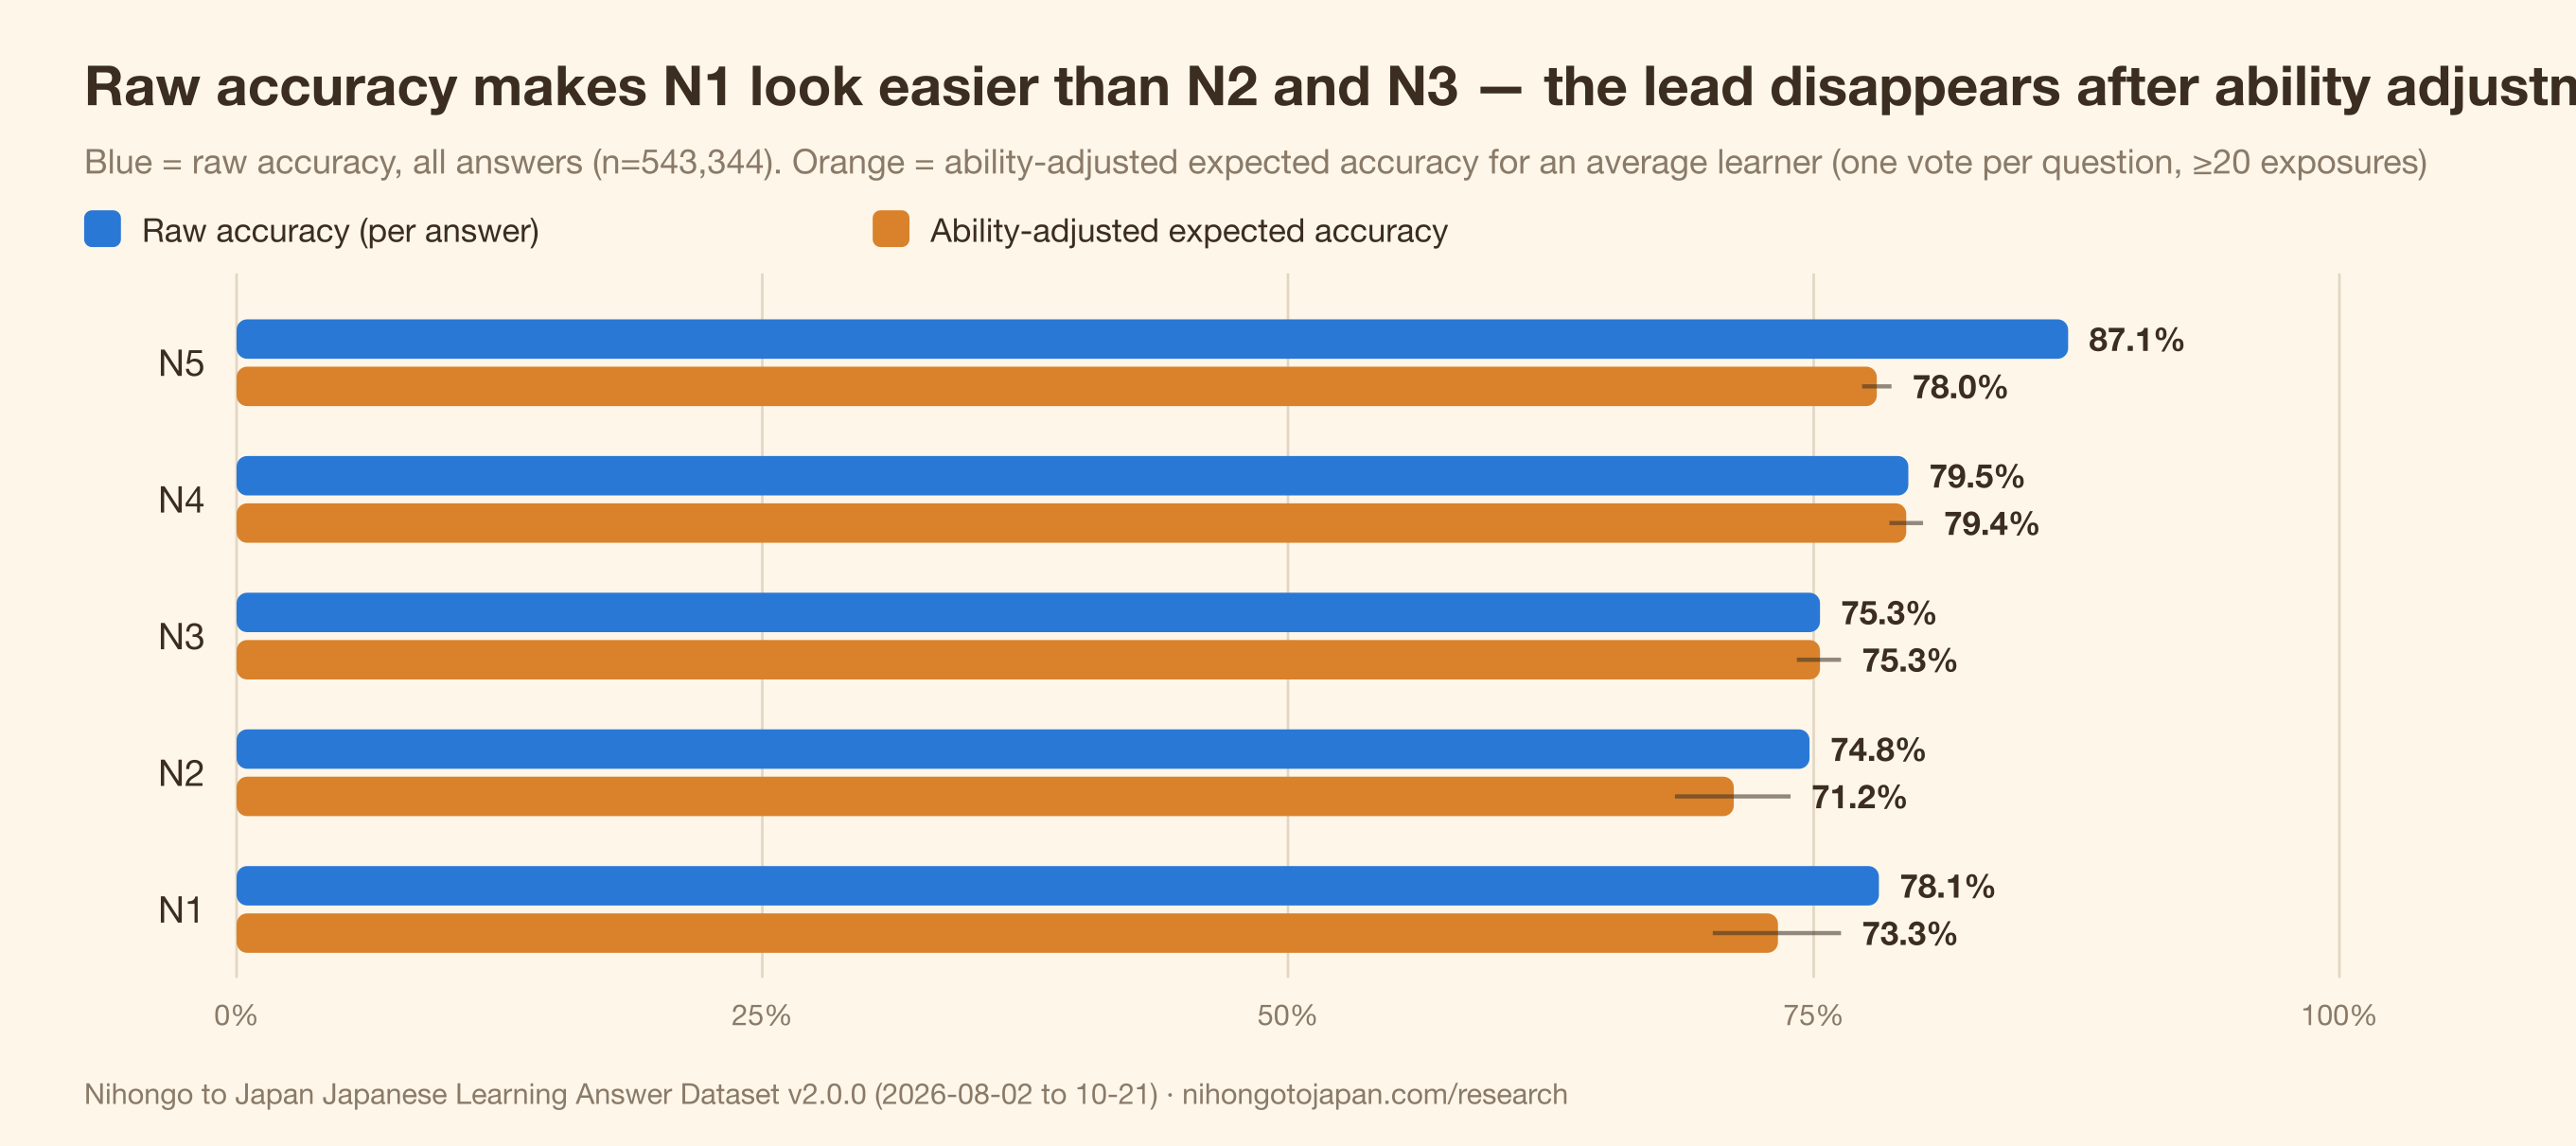
- Pada semua jawaban dalam dataset yang sama, tingkat jawaban benar mentah per level JLPT adalah N5 87,1%, N4 79,5%, N3 75,3%, N2 74,8%, dan N1 78,1% (n=33.082) — N1 lebih tinggi daripada N2 maupun N3.
- Setelah pengaruh kemampuan pelajar dihilangkan dengan estimasi Rasch satu langkah (satu suara per soal, ≥20 kali tampil), tingkat jawaban benar yang diharapkan untuk pelajar berkemampuan rata-rata adalah N3 75,3% (CI 95% 74,2–76,3%, 847 soal), N1 73,3% (70,2–76,3%, 210 soal), dan N2 71,2% (68,4–73,9%, 204 soal). Keunggulan N1 atas N3 hilang, sejalan dengan efek seleksi: pelajar yang lebih kuatlah yang mengerjakan soal N1.
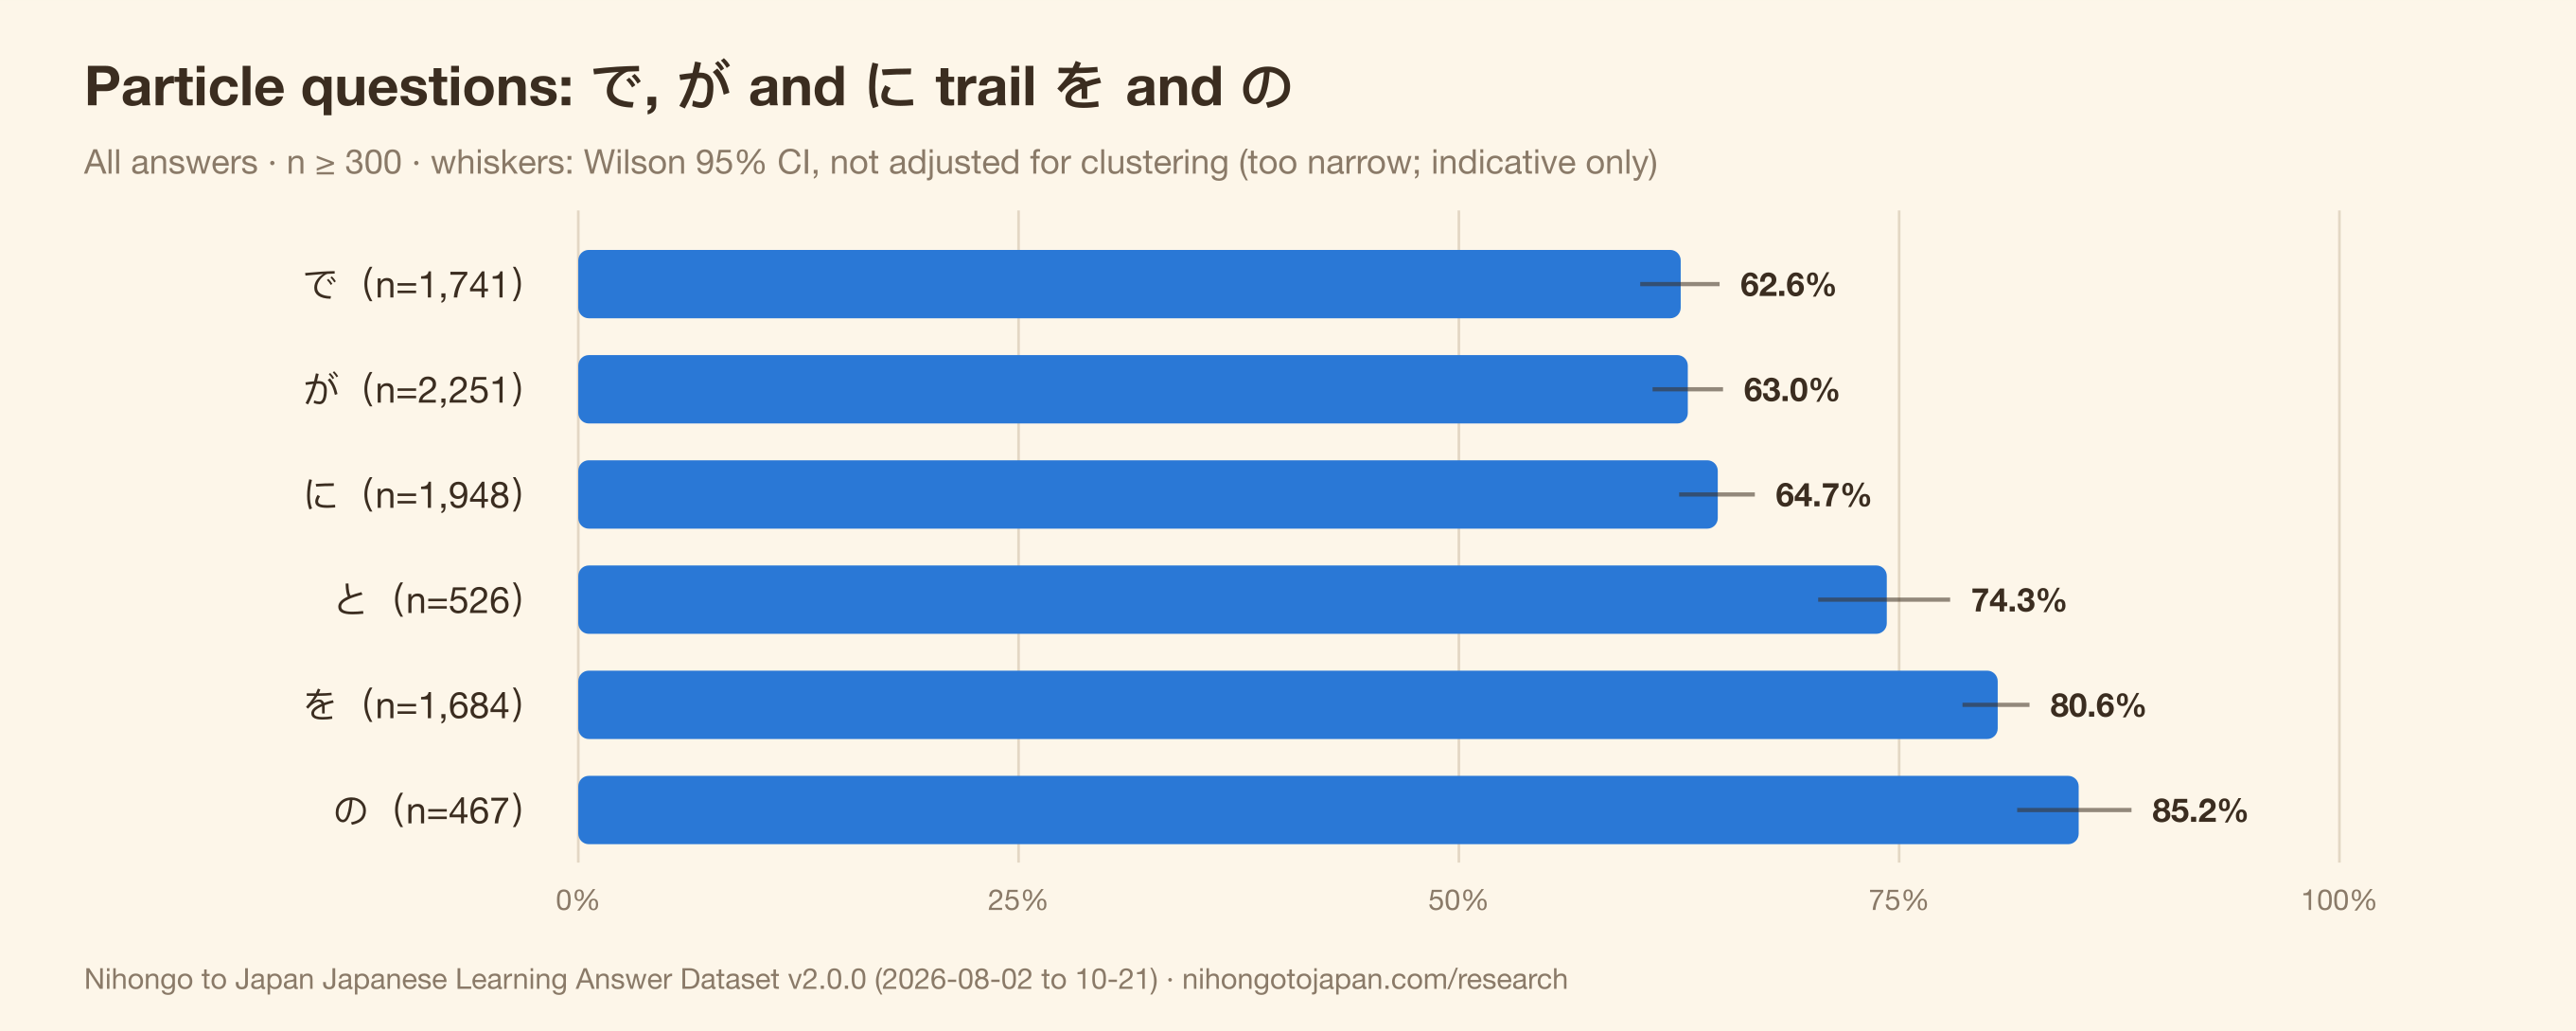
Selang N1 dan N3 setelah penyesuaian saling tumpang tindih, jadi ini tidak menunjukkan bahwa N1 lebih sulit daripada N3 — hanya bahwa urutan mentahnya tidak dapat dipercaya. - Pada semua jawaban, partikel dengan tingkat jawaban benar terendah adalah で 62,6% (n=1.741), が 63,0% (n=2.251), dan に 64,7% (n=1.948); yang tertinggi adalah を 80,6% (n=1.684) dan の 85,2% (n=467) — selisih 22,6 poin antara で dan の.
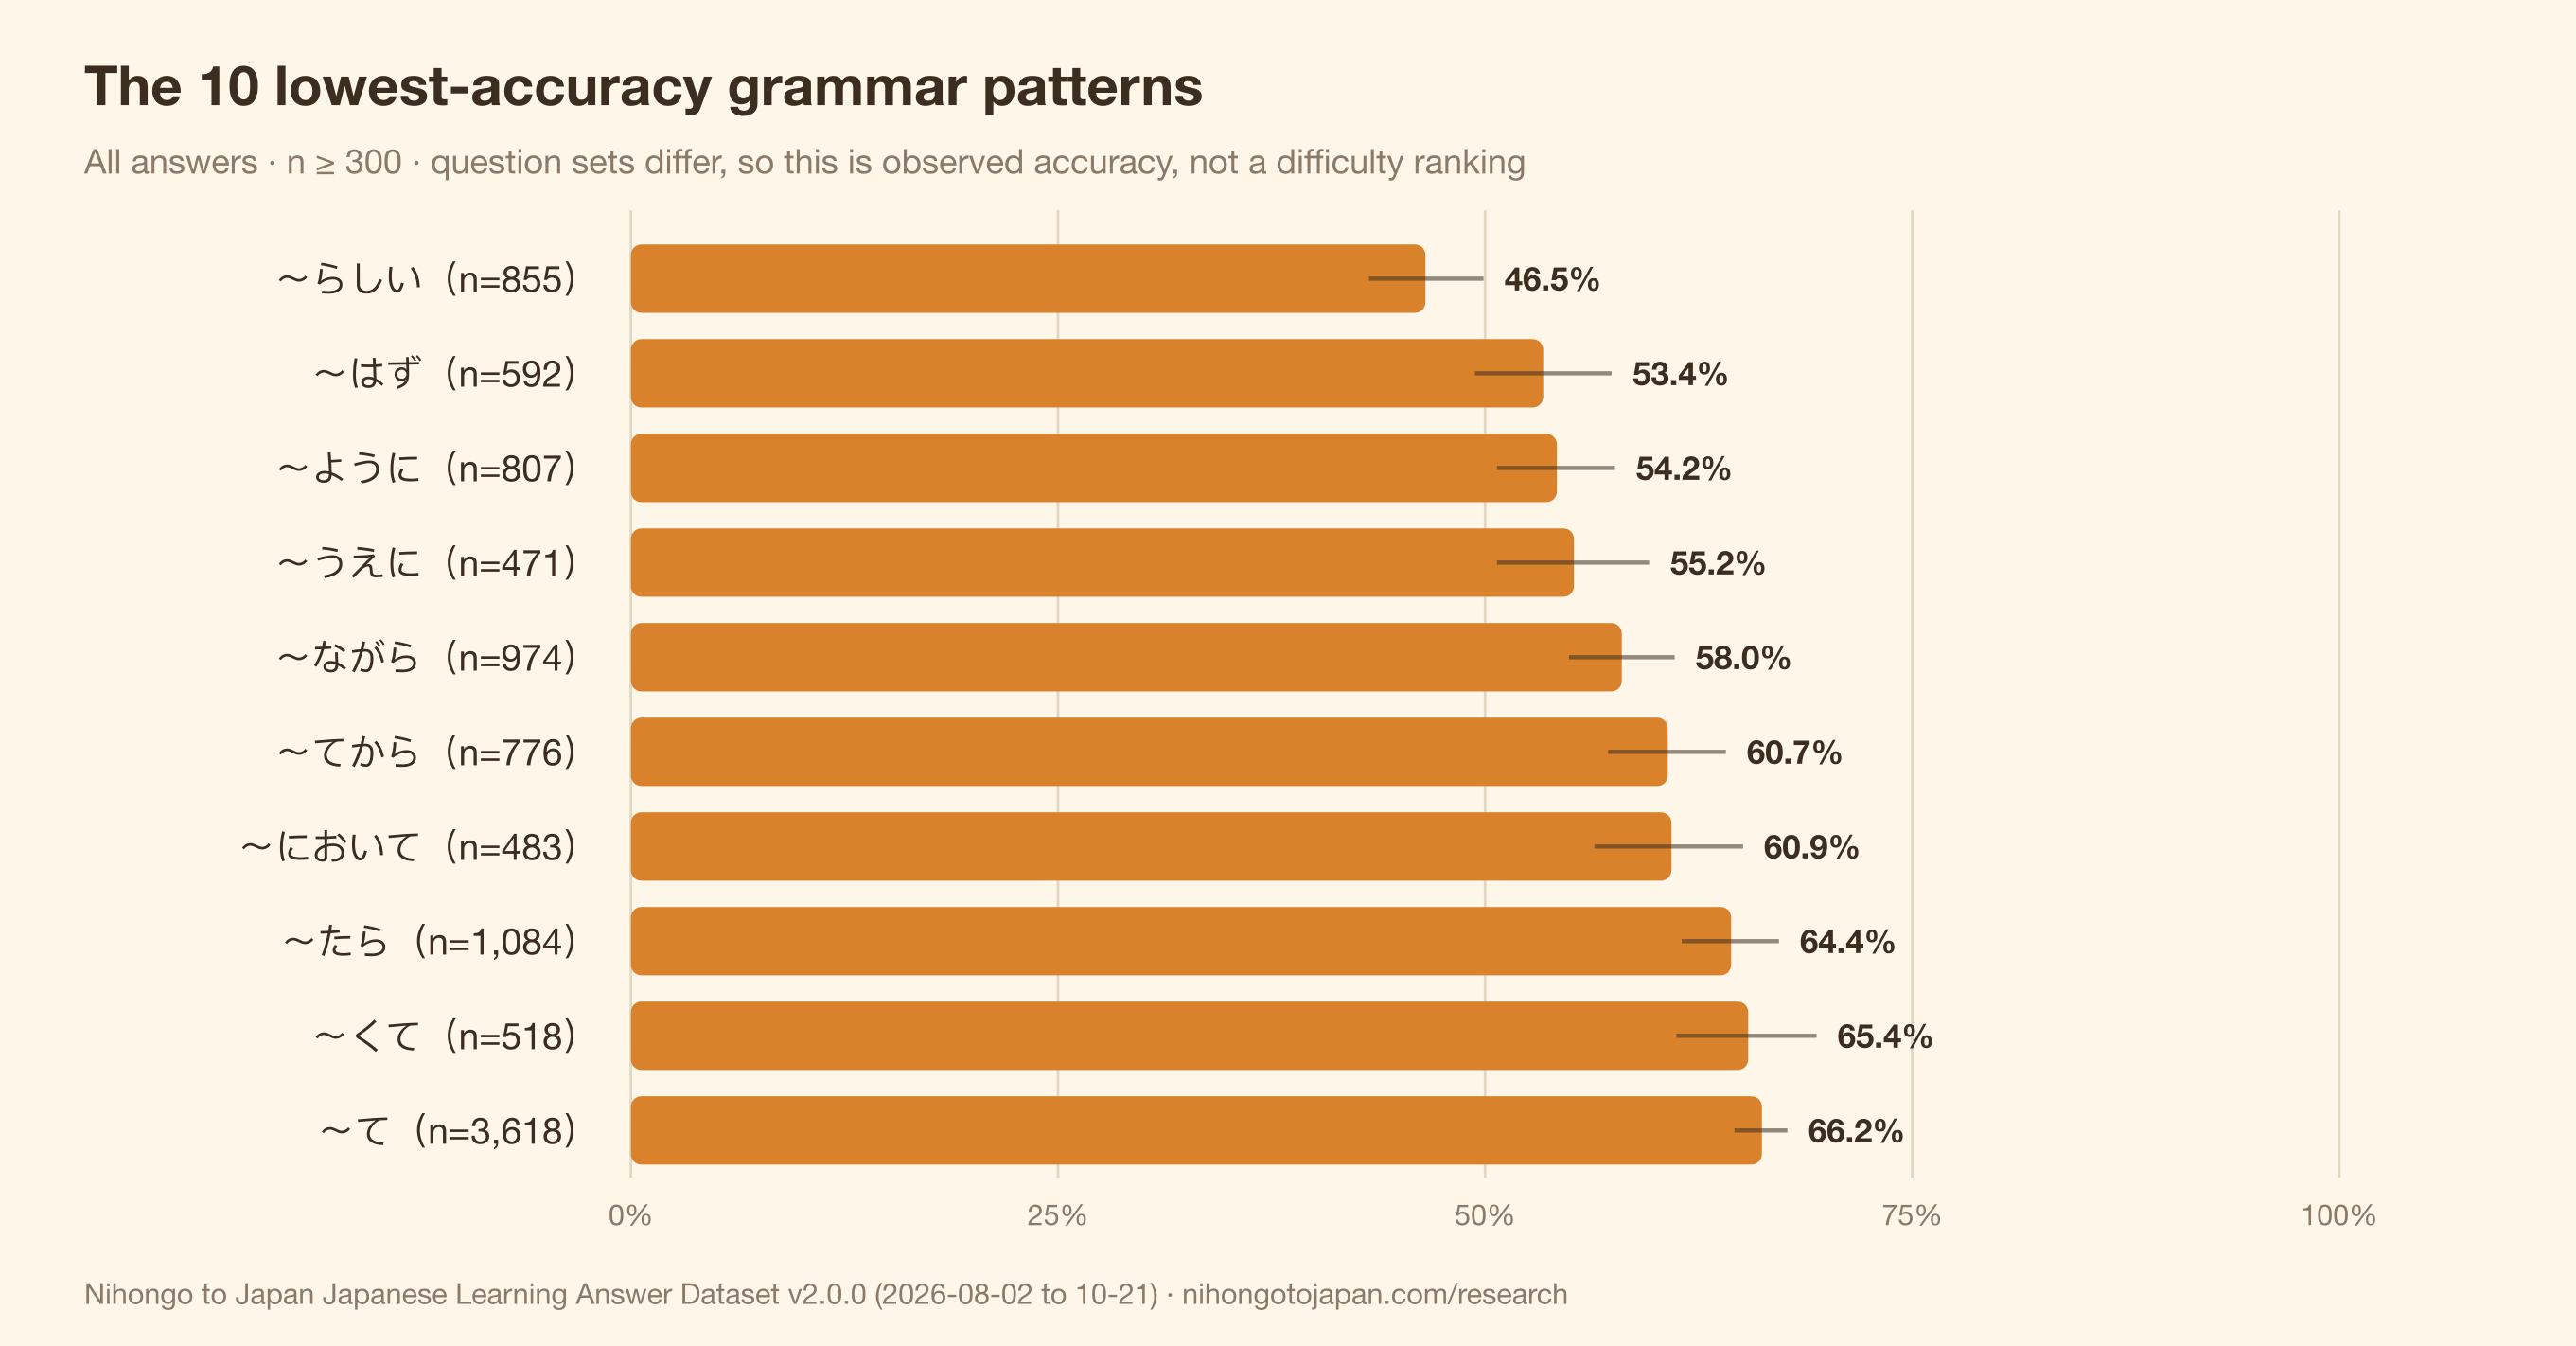
- Di antara pola tata bahasa dengan n ≥ 300, tingkat jawaban benar semua jawaban yang terendah adalah 〜らしい 46,5% (n=855), disusul 〜はず 53,4% (n=592), 〜ように 54,2% (n=807), 〜うえに 55,2% (n=471), dan 〜ながら 58,0% (n=974).
- Di antara soal bentuk kata kerja, bentuk potensial paling rendah, yaitu 64,5% (n=1.923), dan bentuk ます paling tinggi, yaitu 84,0% (n=2.270); bentuk た 70,7%, bentuk て 74,1%, dan bentuk ない 75,0% berada di antaranya.
- Dengan menghitung satu suara per soal (7.057 soal dengan ≥20 kali tampil), rata-rata tingkat jawaban benar pada percobaan pertama adalah 89,1% untuk kosakata (CI 95% 88,7–89,5%), 73,9% untuk pola tata bahasa (73,1–74,7%), dan 67,6% untuk partikel (64,9–70,4%).
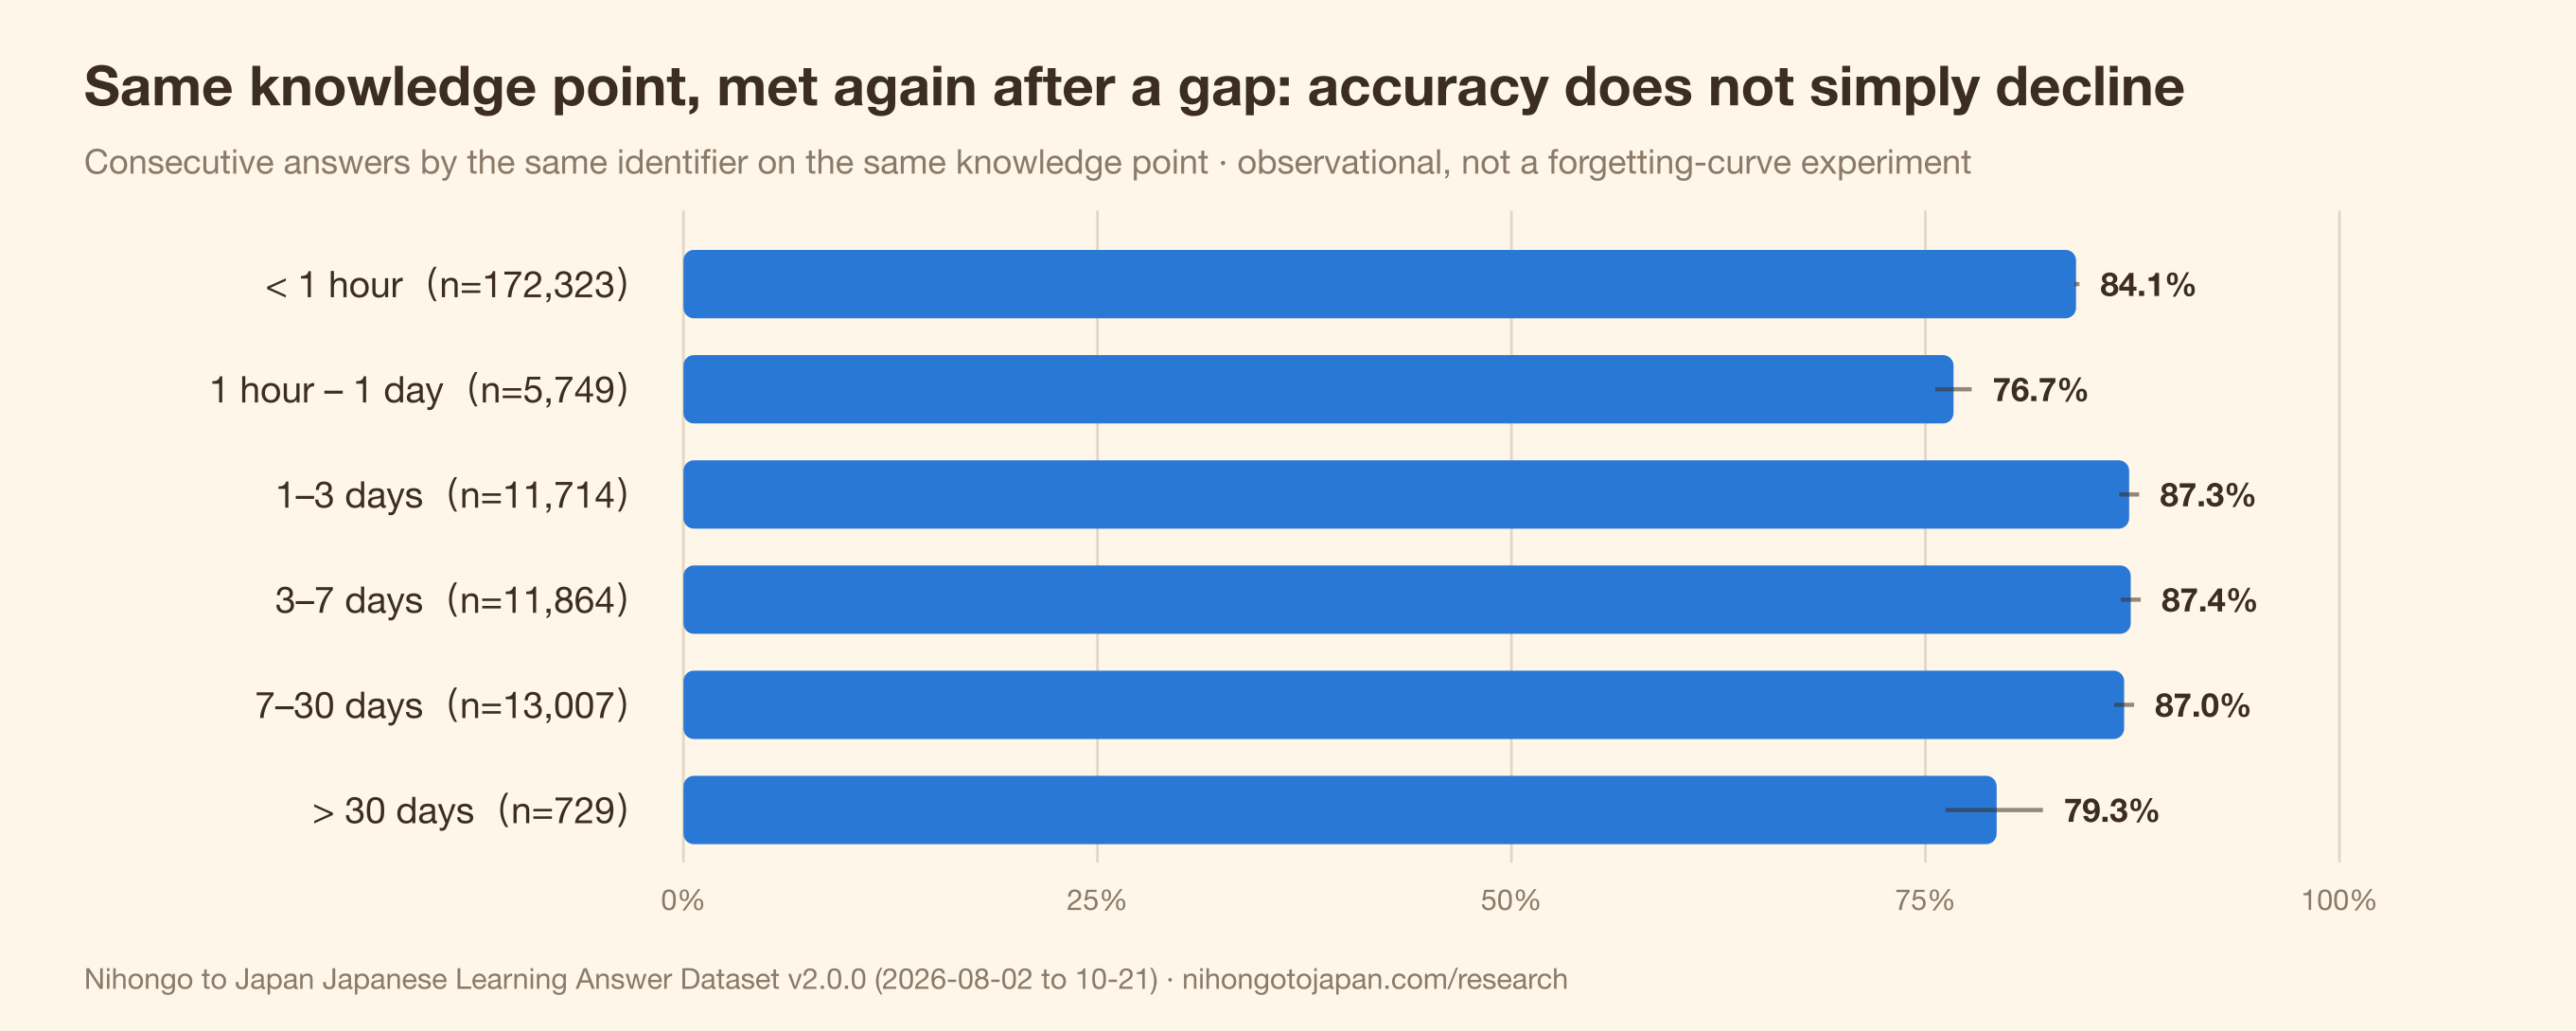
- Untuk jawaban berurutan dari pengenal yang sama pada poin pengetahuan yang sama, tingkat jawaban benar adalah 84,1% bila jedanya kurang dari satu jam, 76,7% pada jeda 1 jam – 1 hari, 87,0–87,4% pada jeda 1–3, 3–7, dan 7–30 hari, serta 79,3% bila lebih dari 30 hari (n=729). Tingkat jawaban benar tidak menurun secara monoton seiring panjangnya jeda.
Ini data observasional: siapa yang kembali setelah beberapa hari tidaklah acak. Data ini tidak menunjukkan bahwa mengulang setelah beberapa hari adalah cara terbaik. - Dari 7.057 soal dengan ≥20 kali tampil, 283 soal (4,0%) memiliki tingkat jawaban benar percobaan pertama di bawah 35% (menebak acak pada empat pilihan menghasilkan sekitar 25%). Penyebab yang umum adalah adanya pilihan kedua yang juga dapat dibenarkan; soal-soal ini sudah masuk antrean peninjauan manual.
- Model prediksi jawaban v2 milik situs ini memperoleh skor Brier 0,199 pada 257.010 jawaban, 51,4% lebih rendah daripada 0,409 milik v1 — tetapi masih lebih buruk daripada 0,161 dari garis dasar konstan yang selalu memprediksi tingkat jawaban benar keseluruhan sebesar 79,9%. Hanya versi yang menambahkan tingkat kesulitan per soal (0,130) yang mengalahkan garis dasar tersebut.
1. Lima temuan utama
1. "N1 lebih mudah daripada N3" adalah ilusi yang ditimbulkan oleh seleksi
Berdasarkan tingkat jawaban benar mentah dari semua jawaban, N1 (78,1%) mengungguli N3 (75,3%) dan N2 (74,8%). Hal ini tidak masuk akal, dan v1 pun melihat pola yang sama. Penjelasan yang paling mungkin adalah siapa yang menjawab: orang yang membuka soal N1 memang sudah lebih kuat.
v2 menghitung ulang dengan tingkat kesulitan yang disesuaikan dengan kemampuan: hasil yang teramati pada setiap soal dikoreksi menurut rata-rata kemampuan orang yang benar-benar menjawabnya, lalu dinyatakan sebagai peluang pelajar berkemampuan rata-rata menjawab dengan benar. Setelah penyesuaian, keunggulan N1 hilang (N3 75,3%, N1 73,3%, N2 71,2%).
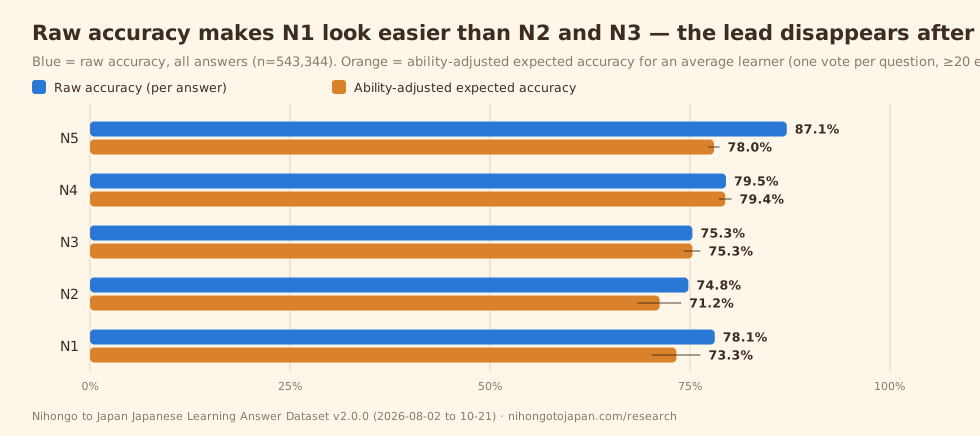
Ada dua catatan. Pertama, selang N1 dan N3 setelah penyesuaian masih tumpang tindih, sehingga kami tidak dapat mengatakan bahwa N1 lebih sulit daripada N3. Kedua, N5 setelah penyesuaian (78,0%) tidak berada di atas N4 (79,4%): penyesuaian ini menangani siapa yang menjawab, bukan soal apa yang dimuat setiap level — 53% soal N5 dalam analisis adalah pola tata bahasa, dibandingkan 33% pada N4, dan soal pola lebih sulit dijawab dengan benar daripada soal kosakata.
2. Kesenjangan partikel: で, が, dan に tertinggal sekitar 20 poin dari を dan の
で (62,6%), が (63,0%), dan に (64,7%) berada hampir 20 poin di bawah を (80,6%) dan の (85,2%). Kesamaan ketiga partikel terendah ini adalah satu partikel, banyak fungsi: で menandai tempat, sarana, sebab, dan cakupan; に menandai waktu, tujuan tempat, penerima, dan maksud.
Hal ini sejalan dengan v1 ("kesenjangan di antara partikel lebih besar daripada kesenjangan antarlevel"), dan sampel v2 yang lebih besar membuat arahnya lebih stabil.
3. Pola tersulit berkumpul di seputar dugaan serta tujuan/keadaan
Dari lima pola terendah, 〜らしい (46,5%) dan 〜はず (53,4%) sama-sama menyatakan dugaan atau ekspektasi dan mudah tertukar dengan 〜そう, 〜よう, dan 〜みたい; 〜ように (54,2%) mencakup tujuan, perubahan, dan permintaan; 〜ながら (58,0%) sering tercampur dengan 〜て dan 〜まま.
Bentuk kata kerja menunjukkan struktur serupa: bentuk potensial (64,5%) adalah yang terendah dari lima bentuk. Aturannya berbeda untuk kata kerja ichidan, godan, dan tak beraturan, dan pelajar juga menjumpai varian lisan yang menghilangkan ら.
4. Tingkat jawaban benar setelah jeda tidak sekadar menurun
Jawaban berurutan dari pengenal yang sama pada poin pengetahuan yang sama dipasangkan, lalu dikelompokkan menurut jedanya:
| Jeda | Jawaban | Pengenal | Tingkat jawaban benar |
|---|---|---|---|
| < 1 jam | 172.323 | 3.472 | 84,1% |
| 1 jam – 1 hari | 5.749 | 647 | 76,7% |
| 1–3 hari | 11.714 | 532 | 87,3% |
| 3–7 hari | 11.864 | 449 | 87,4% |
| 7–30 hari | 13.007 | 405 | 87,0% |
| > 30 hari | 729 | 126 | 79,3% |
Menurut kurva lupa di buku teks, makin panjang jedanya, makin banyak yang terlupa. Di sini, jeda 1 jam – 1 hari paling rendah dan jeda 1–30 hari paling tinggi. Kami tidak menafsirkannya sebagai "mengulang setelah beberapa hari adalah cara terbaik": siapa yang kembali setelah beberapa hari tidaklah acak — pelajar yang kembali lebih tekun dan mungkin juga lebih kuat. Kelompok 1 jam – 1 hari hanya terdiri dari 647 pengenal dan mungkin mencakup orang yang mengerjakan ulang satu set soal di perangkat kedua pada hari yang sama. Untuk menjawab pertanyaan tentang jarak pengulangan diperlukan eksperimen acak, dan dataset ini tidak dapat menyediakannya.
5. Model prediksi berhasil memangkas galatnya hingga separuh, tetapi belum mengalahkan garis dasar yang paling sederhana
Sistem rekomendasi soal di situs ini lebih dulu memprediksi peluang Anda menjawab dengan benar. Kami mengevaluasinya dengan skor Brier (rata-rata kuadrat selisih antara peluang yang diprediksi dan hasil sebenarnya; makin rendah makin baik):
- Model v1: 0,409
- Model v2: 0,199 (51,4% lebih rendah)
- v2 dengan tingkat kesulitan per soal: 0,130 (68,1% lebih rendah)
- Pembanding: garis dasar konstan yang selalu memprediksi angka keseluruhan 79,9%: 0,161
v2 memangkas galat v1 hingga separuh, tetapi secara keseluruhan masih kalah dari garis dasar konstan; hanya dengan menambahkan tingkat kesulitan per soal model ini dapat mengalahkannya. Kami menerbitkan hasil ini karena hasil ini secara langsung menunjukkan bahwa tingkat kesulitan soal lebih baik dalam memprediksi jawaban benar daripada level pelajar — dan itu pula sebabnya temuan 1 memerlukan penyesuaian kemampuan.
2. Gambaran umum dataset
| Butir | Nilai | Catatan |
|---|---|---|
| Jawaban valid | 543.344 | Snapshot agregat 2026-10-21 19:18 UTC, cakupan all_clean_events (aturan pembersihan data situs diterapkan) |
| Pengenal pembelajar (≥1 jawaban kelas A) | 5.410 | totalUsers pada endpoint agregat |
| Pengenal pembelajar (semua) | 8.073 | Endpoint komunitas; merupakan batas atas jumlah orang |
| Soal yang dijawab | 25.850 | 7.057 soal dengan ≥20 kali tampil masuk ke analisis tingkat soal |
| Soal dengan tingkat kesulitan yang disesuaikan | 18.139 | Estimasi Rasch satu langkah dengan penyusutan (shrinkage) Bayes empiris |
| Kelas bukti | A 59,8% · B 33,5% · C 6,7% | A = konteks kuis; B = latihan dalam pelajaran; C = lainnya (sama seperti v1) |
| Periode | 2026-08-02 sampai 10-21 | 81 hari |
Tentang penghitung langsung: angka di beranda, "Pelajar NTJ telah menyelesaikan 552.850 jawaban latihan", adalah angka langsung dari endpoint komunitas pada 2026-10-23, sekitar 9.500 lebih tinggi daripada dataset ini — yaitu jawaban yang masuk dalam dua hari setelah snapshot. Kutiplah angka 543.344.
3. Sumbu kemampuan (semua jawaban)
| Sumbu | Jawaban | Tingkat jawaban benar | Percobaan pertama tingkat soal (jumlah soal) |
|---|---|---|---|
| Kosakata | 267.127 | 90,1% | 89,1% (3.398) |
| Pola tata bahasa | 234.602 | 75,2% | 73,9% (3.252) |
| Bentuk kata kerja | 18.479 | 75,2% | 76,2% (154) |
| Partikel | 13.870 | 71,3% | 67,6% (189) |
| Ungkapan idiomatis | 7.413 | 88,1% | 92,4% (64) |
| Membaca | 1.103 | 78,7% | — |
| Menyimak | 605 | 69,8% | — |
| Berbicara | 118 | DISEMBUNYIKAN | — |
Membaca, menyimak, dan berbicara adalah jenis soal yang lebih baru dengan sampel kecil; berbicara berada di bawah ambang 300 jawaban, sehingga hanya jumlahnya yang dilaporkan.
4. Level JLPT
| Level | Tingkat jawaban benar semua jawaban (n) | Percobaan pertama tingkat soal (jumlah soal) | Tingkat jawaban benar yang diharapkan setelah disesuaikan dengan kemampuan (CI 95%) |
|---|---|---|---|
| N5 | 87,1% (297.809) | 82,6% (3.817) | 78,0% (77,3–78,7%) |
| N4 | 79,5% (93.609) | 84,5% (1.766) | 79,4% (78,6–80,2%) |
| N3 | 75,3% (82.010) | 75,7% (1.008) | 75,3% (74,2–76,3%) |
| N2 | 74,8% (36.837) | 66,9% (249) | 71,2% (68,4–73,9%) |
| N1 | 78,1% (33.082) | 74,2% (217) | 73,3% (70,2–76,3%) |
Ketiga kolom memakai himpunan analisis yang berbeda; bandingkan di dalam satu kolom, bukan antarkolom. Kolom 1 menghitung setiap jawaban, termasuk pengulangan, dan bergantung pada komposisi jenis soal di setiap level; kolom 2 memberi setiap soal satu suara; kolom 3 juga menghilangkan pengaruh kemampuan pelajar.
5. Kualitas soal: bank soal kami sendiri pun ikut diukur
| Tingkat jawaban benar percobaan pertama | Jumlah soal |
|---|---|
| < 35% | 283 |
| 35–50% | 377 |
| 50–70% | 971 |
| 70–85% | 1.347 |
| 85–95% | 1.937 |
| ≥ 95% | 2.142 |
283 soal (4,0%) di bawah 35% belum tentu soal yang buruk — sebagian memang sulit. Namun, peninjauan manual kami pada bulan Agustus menemukan bahwa rentang ini sering memuat pilihan kedua yang juga dapat dibenarkan (misalnya, が maupun を sama-sama bisa dipakai dalam 「ピアノ_弾けます」). Sistem juga menandai 415 soal untuk ditinjau berdasarkan kriteria seperti daya beda yang jelas negatif. Presisi penanda tersebut sekitar 0,19: ini antrean peninjauan, bukan daftar soal yang buruk.
6. Cara guru dan perancang materi dapat memanfaatkannya
- Partikel: で, が, dan に tertinggal sekitar 20 poin dari を dan の. Melatih satu fungsi sekaligus dengan contoh-contohnya sendiri lebih tepat sasaran daripada mengulang-ulang satu partikel secara keseluruhan.
- Ungkapan dugaan: 〜らしい dan 〜はず adalah pola yang paling sering salah dijawab di sini; kontraskan keduanya dengan 〜そう, 〜よう, dan 〜みたい.
- Bentuk potensial: terendah dari lima bentuk kata kerja; latihlah secara terpisah menurut golongan kata kerja.
- Membaca data Anda sendiri: jika platform Anda juga menunjukkan soal tingkat lanjut mendapat angka lebih tinggi daripada soal tingkat menengah, curigai efek seleksi terlebih dahulu sebelum mencurigai soalnya.
7. Metodologi
Sumber dan keterulangan
Setiap angka dalam v2 berasal dari enam endpoint publik, yang diambil dan dibekukan pada 2026-10-23: /api/aggregates?kind=summary, kind=items, kind=difficulty, kind=spacing, kind=brier, dan /api/community?kind=overview. Waktu snapshot setiap endpoint dan sha256 setiap berkas masukan tercantum dalam unduhan JSON pada dataset.source_snapshot_at_utc dan dataset.input_sha256. Skrip pembuatnya, scripts/build-research-dataset-2026-10.py, tidak memiliki akses ke data tingkat pelajar.
Lima himpunan analisis
- Semua jawaban (sumbu, level, poin pengetahuan): setiap jawaban valid dihitung, termasuk pengulangan oleh pengenal yang sama.
- Percobaan pertama tingkat soal: untuk setiap soal, tingkat jawaban benar pada percobaan pertama setiap pengenal, lalu dirata-ratakan antarsoal. Hanya soal dengan ≥20 kali tampil; CI 95% menggunakan soal sebagai unit.
- Tingkat kesulitan yang disesuaikan dengan kemampuan: estimasi Rasch satu langkah b̂ = θ̄ (rata-rata kemampuan para penjawab sebenarnya) − logit(p̂), disusutkan ke arah rata-rata sumbu dengan bobot n/(n+5), lalu dikonversi menjadi tingkat kesalahan yang diharapkan bagi pelajar berkemampuan rata-rata seluruh situs. Kami melaporkan 1 − kesalahan yang diharapkan.
- Pasangan jawaban berurutan (jarak pengulangan): jawaban berurutan dari pengenal yang sama pada poin pengetahuan yang sama, hanya kelas bukti A dan B.
- Akurasi prediksi: semua jawaban kelas A yang memuat prediksi v1 sekaligus v2 (kolom prediksi tersedia sejak 2026-08-20).
Ukuran sel minimum
Sel tingkat jawaban dengan n < 300 disembunyikan; poin pengetahuan hanya dicantumkan bila n ≥ 300; analisis tingkat soal hanya mencakup soal dengan ≥20 kali tampil.
Selang kepercayaan
CI Wilson 95% tingkat jawaban tidak disesuaikan untuk jawaban berulang dari pengenal yang sama (endpoint publik tidak menyediakan data tingkat pengenal), sehingga selangnya terlalu sempit dan hanya sebagai indikasi. CI tingkat soal memperlakukan soal sebagai unit sampel: CI ini menggambarkan bank soal ini, bukan populasi pelajar.
Anonimitas
Endpoint publik hanya mengembalikan agregat. Dataset ini tidak memuat data jawaban mentah, pengenal, maupun cap waktu tingkat jawaban.
8. Keterbatasan (mohon dikutip bersama angkanya)
- Sampel observasional yang memilih dirinya sendiri, yaitu orang-orang yang berlatih di NTJ; tidak mewakili populasi pelajar mana pun.
- Pengenal bukan orang: pengenal peramban anonim tidak dapat digabungkan lintas perangkat; 8.073 adalah batas atas.
- Kumpulan soal berbeda: level, sumbu, dan poin pengetahuan memakai soal yang berbeda, sehingga selisih tingkat jawaban benar bukanlah peringkat tingkat kesulitan.
- Angka semua jawaban terdongkrak oleh latihan berulang.
- Penyesuaian kemampuan memiliki asumsi: model Rasch mengasumsikan satu dimensi kemampuan; kemampuan hanya diestimasi untuk pengenal yang jumlah jawabannya cukup.
- CI tingkat jawaban terlalu sempit (lihat Metodologi).
- Daftar soal terpotong:
kind=itemsmengembalikan paling banyak 25.000 soal, diurutkan menurut jumlah tampil dari yang terbanyak (dari total 25.850); 850 soal yang tidak termuat adalah yang paling jarang tampil dan tidak memengaruhi analisis ≥20 kali tampil. - Hanya 100 poin pengetahuan teratas: endpoint agregat mengembalikan 100 poin pengetahuan yang paling banyak dijawab.
- Waktu menjawab tidak dapat dipakai: tab yang dibiarkan terbuka menggelembungkan rata-ratanya, sehingga waktu menjawab tidak dilaporkan.
- Tidak ada klaim sebab-akibat di bagian mana pun dalam laporan ini.
9. Cara mengutip
Anda dipersilakan mengutip dataset ini dalam makalah, laporan, materi ajar, dan pemberitaan. Mohon sebutkan sumbernya, cantumkan versinya, dan tautkan kembali ke halaman ini.
APA (edisi ke-7)
Nihongo to Japan. (2026). Japanese learning answer dataset — October 2026 (Version 2.0.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026-10MLA (edisi ke-9)
Nihongo to Japan. Japanese Learning Answer Dataset — October 2026. Version 2.0.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10.BibTeX
@misc{ntj_jlad_2026_10,

  title = {Japanese Learning Answer Dataset --- October 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {2.0.0},

  note = {Snapshot 2026-10-21; aggregate statistics from 543,344 anonymous answer events, 2 August -- 21 October 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026-10}

}
Lisensi: data berlisensi CC BY 4.0
Data dalam dataset ini dirilis dengan lisensi Creative Commons Attribution 4.0 International (CC BY 4.0). Anda boleh menyalin, menyebarluaskan ulang, mengadaptasi, dan mengembangkannya, termasuk untuk keperluan komersial, asalkan mencantumkan atribusi yang layak dan menyebutkan jika ada perubahan.
⚠️ Lisensi ini hanya mencakup data: angka agregat di halaman ini dan dua berkas unduhanjapanese-learning-2026-10.jsonsertajapanese-learning-2026-10.csv. Grafik kami (SVG/PNG) dan teks laporan tidak termasuk; seluruh hak dilindungi.
Atribusi
Nihongo to Japan, Japanese Learning Answer Dataset — October 2026, v2.0.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10Permintaan kami (bukan syarat lisensi)
- Sertakan keterbatasannya: memilih dirinya sendiri, observasional, tidak representatif.
- Sebutkan himpunan analisisnya: angka semua jawaban, percobaan pertama tingkat soal, dan angka yang disesuaikan dengan kemampuan sangat berbeda satu sama lain.
- Tulis "pengenal pembelajar", bukan "orang".
- Cantumkan versinya (v2.0.0, snapshot 2026-10-21).
⚠️ CC BY tidak dapat dicabut. Siapa pun yang memperoleh data berdasarkan ketentuan ini tetap memegang hak tersebut meskipun kami mengubah ketentuan kami di kemudian hari.
10. Unduhan
- japanese-learning-2026-10.json — metadata lengkap, sha256 masukan, ambang batas, dan setiap sel agregat.
- japanese-learning-2026-10.csv — satu baris per sel; kolom
table, key, n, value, ci95_low, ci95_high, unit, note. - japanese-learning-2026-10-LICENSE.txt — pernyataan lisensi.
Berkas grafik (PNG dengan resolusi 2×, SVG yang dapat diskalakan; grafik tidak berlisensi CC BY — mohon hubungi kami sebelum memuat ulang grafik):
- Tingkat jawaban benar mentah vs. disesuaikan dengan kemampuan: PNG · SVG
- Tingkat jawaban benar partikel: PNG · SVG
- 10 pola dengan tingkat jawaban benar terendah: PNG · SVG
- Tingkat jawaban benar menurut jeda pengulangan: PNG · SVG
Teks alternatif untuk setiap grafik tersedia di alt-text.json.
Kontak media dan data
Untuk rincian yang lebih mendetail, dugaan kesalahan, atau pertanyaan tentang angka mana yang sebaiknya dikutip, kirim email ke [email protected] dengan mencantumkan "Dataset v2.0.0" di baris subjek.
Versi
| Versi | Snapshot | Periode | Catatan |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 sampai 10-21 (81 hari) | Halaman ini. Dibuat dari endpoint agregat publik; menambahkan tingkat kesulitan yang disesuaikan dengan kemampuan, jarak pengulangan, kualitas soal, dan akurasi prediksi. |
| v1.1.0 | 2026-08-14 | 2026-08-02 sampai 08-13 (12 hari) | Rilis pertama; himpunan utama "percobaan pertama dalam konteks kuis". Angka-angkanya tidak berubah dan tetap dapat dikutip. |
Angka yang sudah diterbitkan tidak pernah ditulis ulang. ← Riset dan data | Untuk pendidik & perpustakaan