일본어 학습 응답 집계 데이터셋 — 2026년 8월: 익명 응답 56,613건의 정답률(12일 스냅샷)
📢 새 버전이 공개되었어요: 일본어 학습 응답 집계 데이터셋 — 2026년 10월 (v2.0.0, 응답 543,344건). v2는 분석 집합이 다르므로 그 수치를 이 페이지의 수치와 직접 빼서 비교할 수 없어요. 이 페이지의 v1.1.0 수치는 변경되지 않았으며 계속 인용할 수 있어요.
한 줄 요약: Nihongo to Japan에서 수집된 익명 응답 이벤트 56,613건의 집계 통계로, 익명 학습자 식별자 1,053개가 문제 11,987개에 응답한 결과예요.
⚠️ 이 자료는 2026년 8월의 스냅샷이며, 2026년 전체를 다룬 연구가 아니에요. 데이터 기간은 2026년 8월 2일~13일, 총 12일이에요(집계 파이프라인이 8월 2일에 가동되었으므로 첫날은 일부만 포함돼요). 이 데이터로는 어떠한 장기 추세도 읽어 낼 수 없어요. 버전 1.1.0, 스냅샷 동결일 2026-08-14.
'학습자 식별자'에 대하여: 학습자 식별자는 브라우저에서 무작위로 생성되는 익명 식별자로, 기기 간에 통합할 수 없어요. 한 사람이 휴대폰과 노트북을 함께 쓰면 식별자가 두 개 생기므로, 1,053은 검증된 실제 인원수가 아니라 인원수의 상한이에요. 이 페이지에서는 '사람' 대신 일관되게 '학습자 식별자'라고 써요.
이 자료가 아닌 것. 이 자료는 대만이나 그 밖의 어느 지역의 일본어 학습자를 대표하는 조사가 아니에요. 표본은 이 사이트에서 연습하기로 스스로 선택한 사람들로 구성된 자기선택 관찰 표본이에요. 모든 수치는 이 응답 집합 안에서 일어난 일을 기술할 뿐이며, 어떤 모집단으로도 일반화할 수 없어요. 한계를 참고하세요.
그대로 인용할 수 있는 10가지 결과
아래 각 항목은 그 자체로 완결된 문장이에요. 문장 안에 데이터셋 이름, 스냅샷 기간, 표본 크기, 신뢰구간이 모두 들어 있으므로, 기자나 연구자가 맥락을 다시 확인하지 않고도 어느 항목이든 하나만 복사해 쓸 수 있어요. 모든 수치는 이 데이터셋 안에서의 관측값이며(주 분석 집합은 테스트 맥락 첫 시도예요. 방법론 참고), 일본어 학습자 모집단에 대한 추론이 아니고 인과적 주장도 하지 않아요. 수치를 인용할 때는 한계도 함께 인용해 주세요.
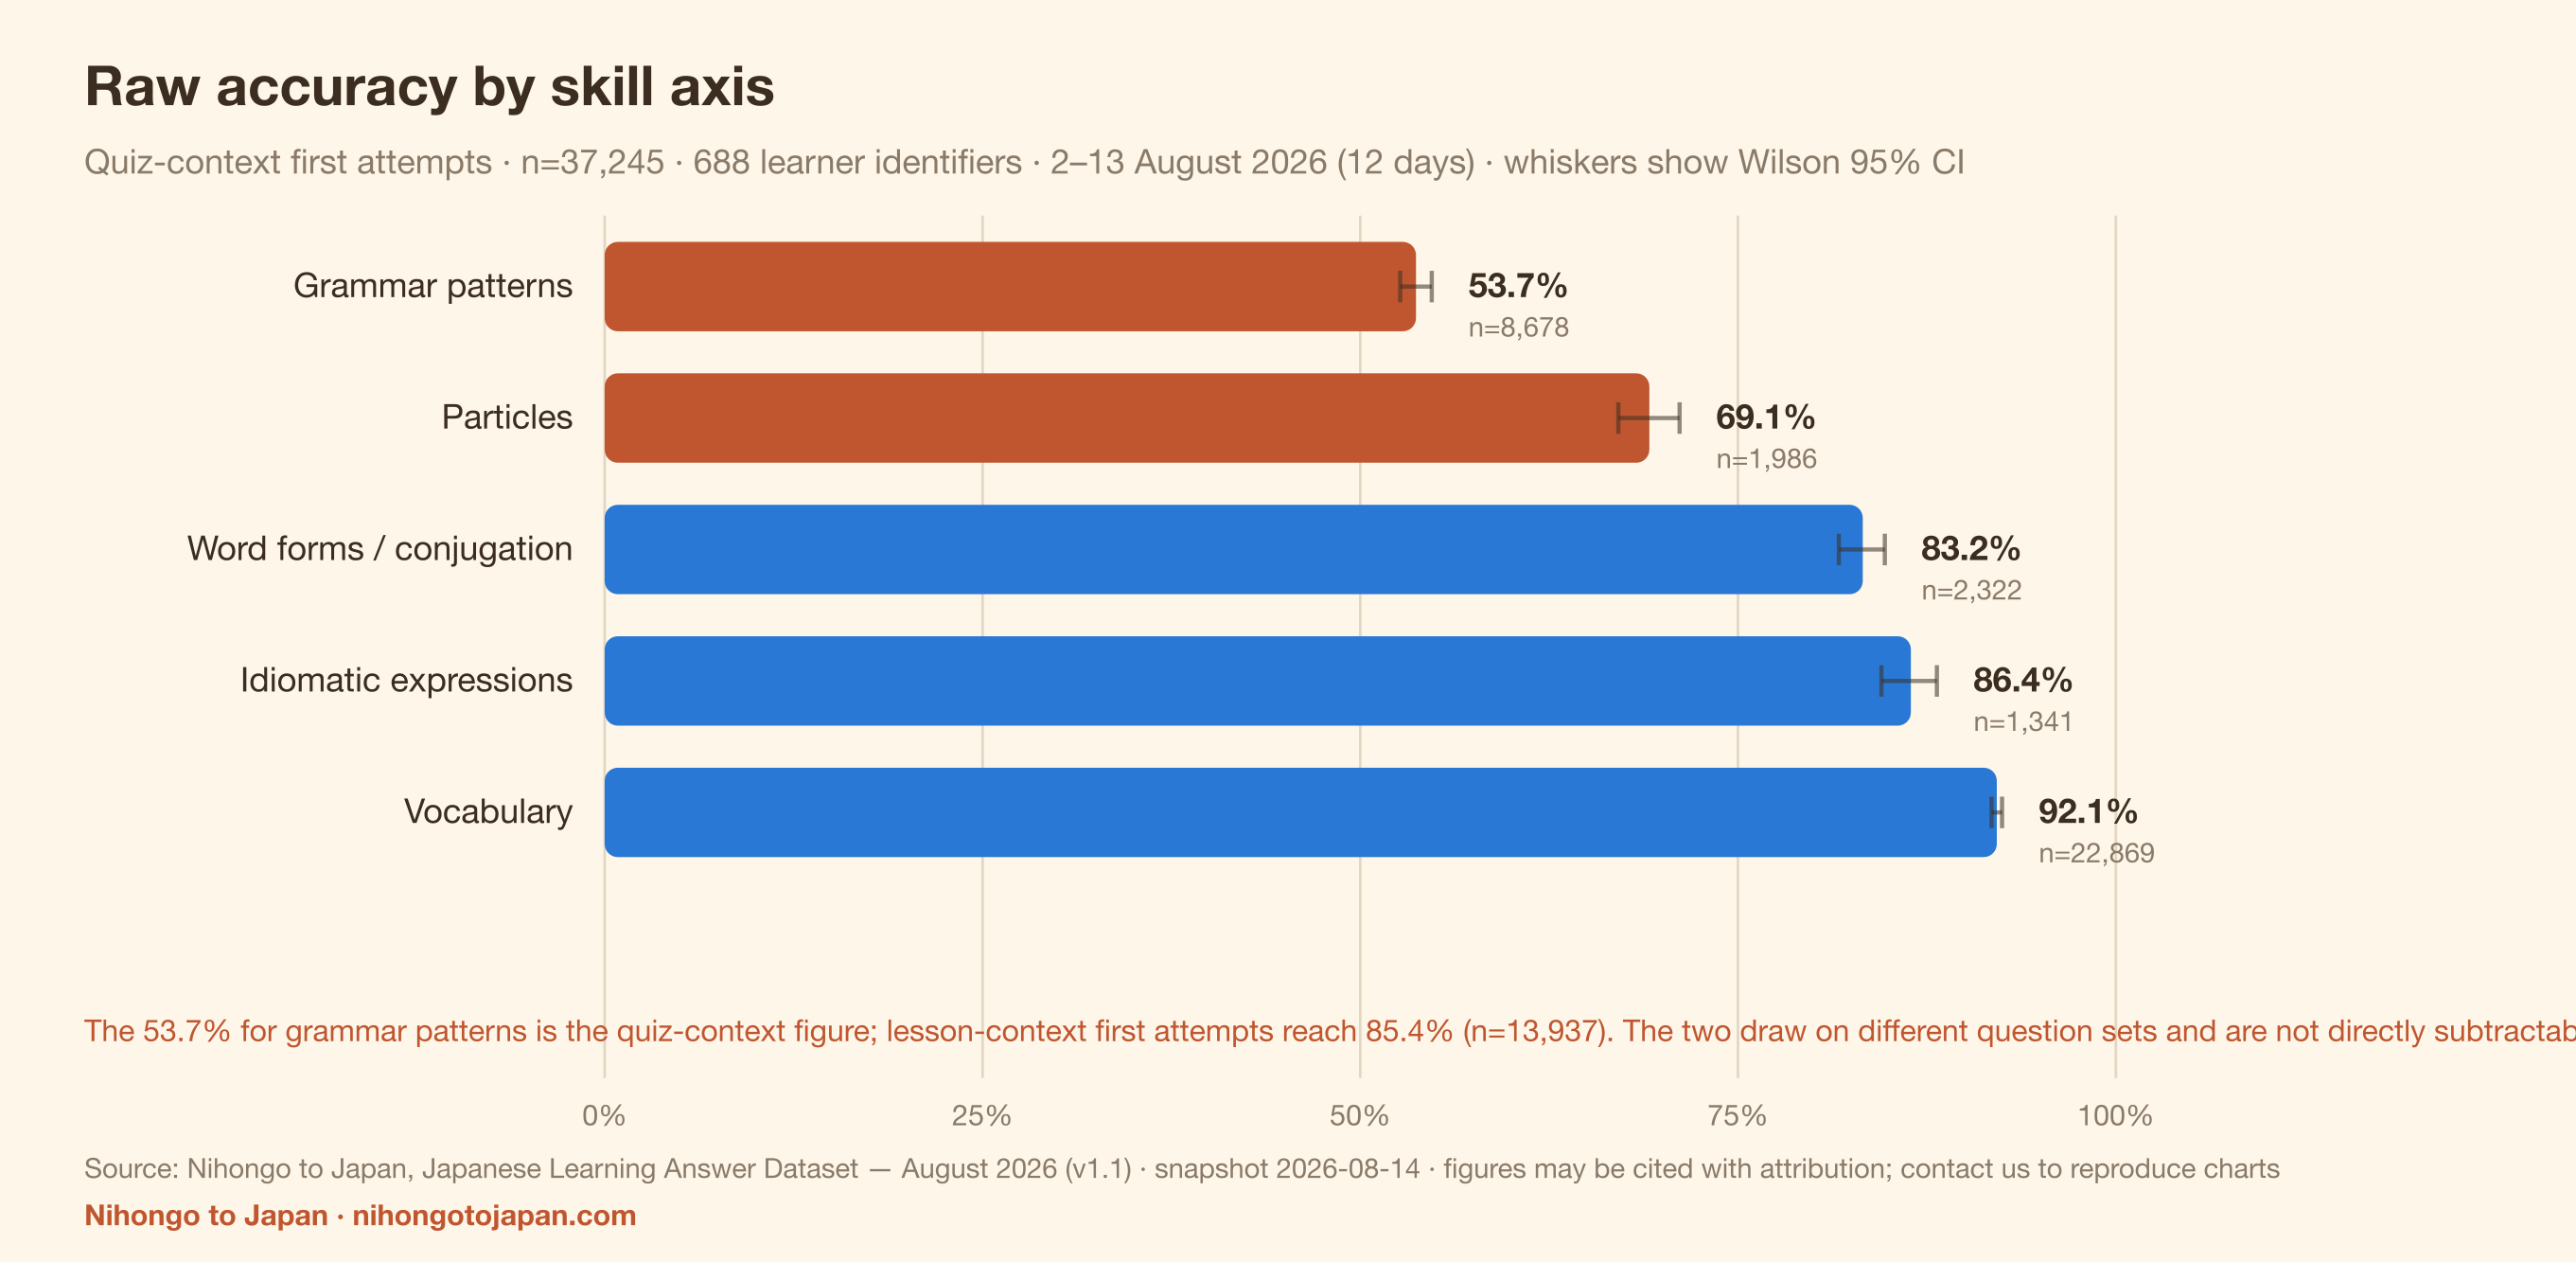
- NTJ 일본어 학습 답안 데이터셋(2026년 8월 스냅샷, 12일)의 테스트 맥락 첫 시도에서 문형 문제의 정답률은 53.7%(n=8,678, Wilson 95% 신뢰구간 52.6%–54.7%)로, 어휘 문제의 92.1%(n=22,869, 95% 신뢰구간 91.8%–92.5%)와 38%p 차이가 났어요.
두 구간이 겹치지 않으므로 이 차이는 표본 잡음이 아니에요. 단, 이 보고서는 원인에 대해서는 아무 주장도 하지 않아요. - 같은 데이터셋의 테스트 맥락 첫 시도에서 다섯 개 학습 축을 정답률이 낮은 순서대로 나열하면 다음과 같아요: 문형 53.7%(n=8,678), 조사 69.1%(n=1,986, 95% 신뢰구간 67.1%–71.1%), 어형·활용 83.2%(n=2,322, 95% 신뢰구간 81.7%–84.7%), 관용 표현 86.4%(n=1,341, 95% 신뢰구간 84.5%–88.2%), 어휘 92.1%(n=22,869).
축마다 서로 다른 문제 집합을 사용하므로, 이는 관측된 정답률의 순서일 뿐 난이도의 순서가 아니에요. - 같은 데이터셋에서 문형 축의 관측 정답률은 어떤 응답을 포함하느냐에 따라 53.7%에서 85.4%까지 달라져요: 테스트 맥락 첫 시도 53.7%(n=8,678), 교재 맥락 첫 시도 85.4%(n=13,937), 전체 응답 이벤트 74.1%(n=24,293).
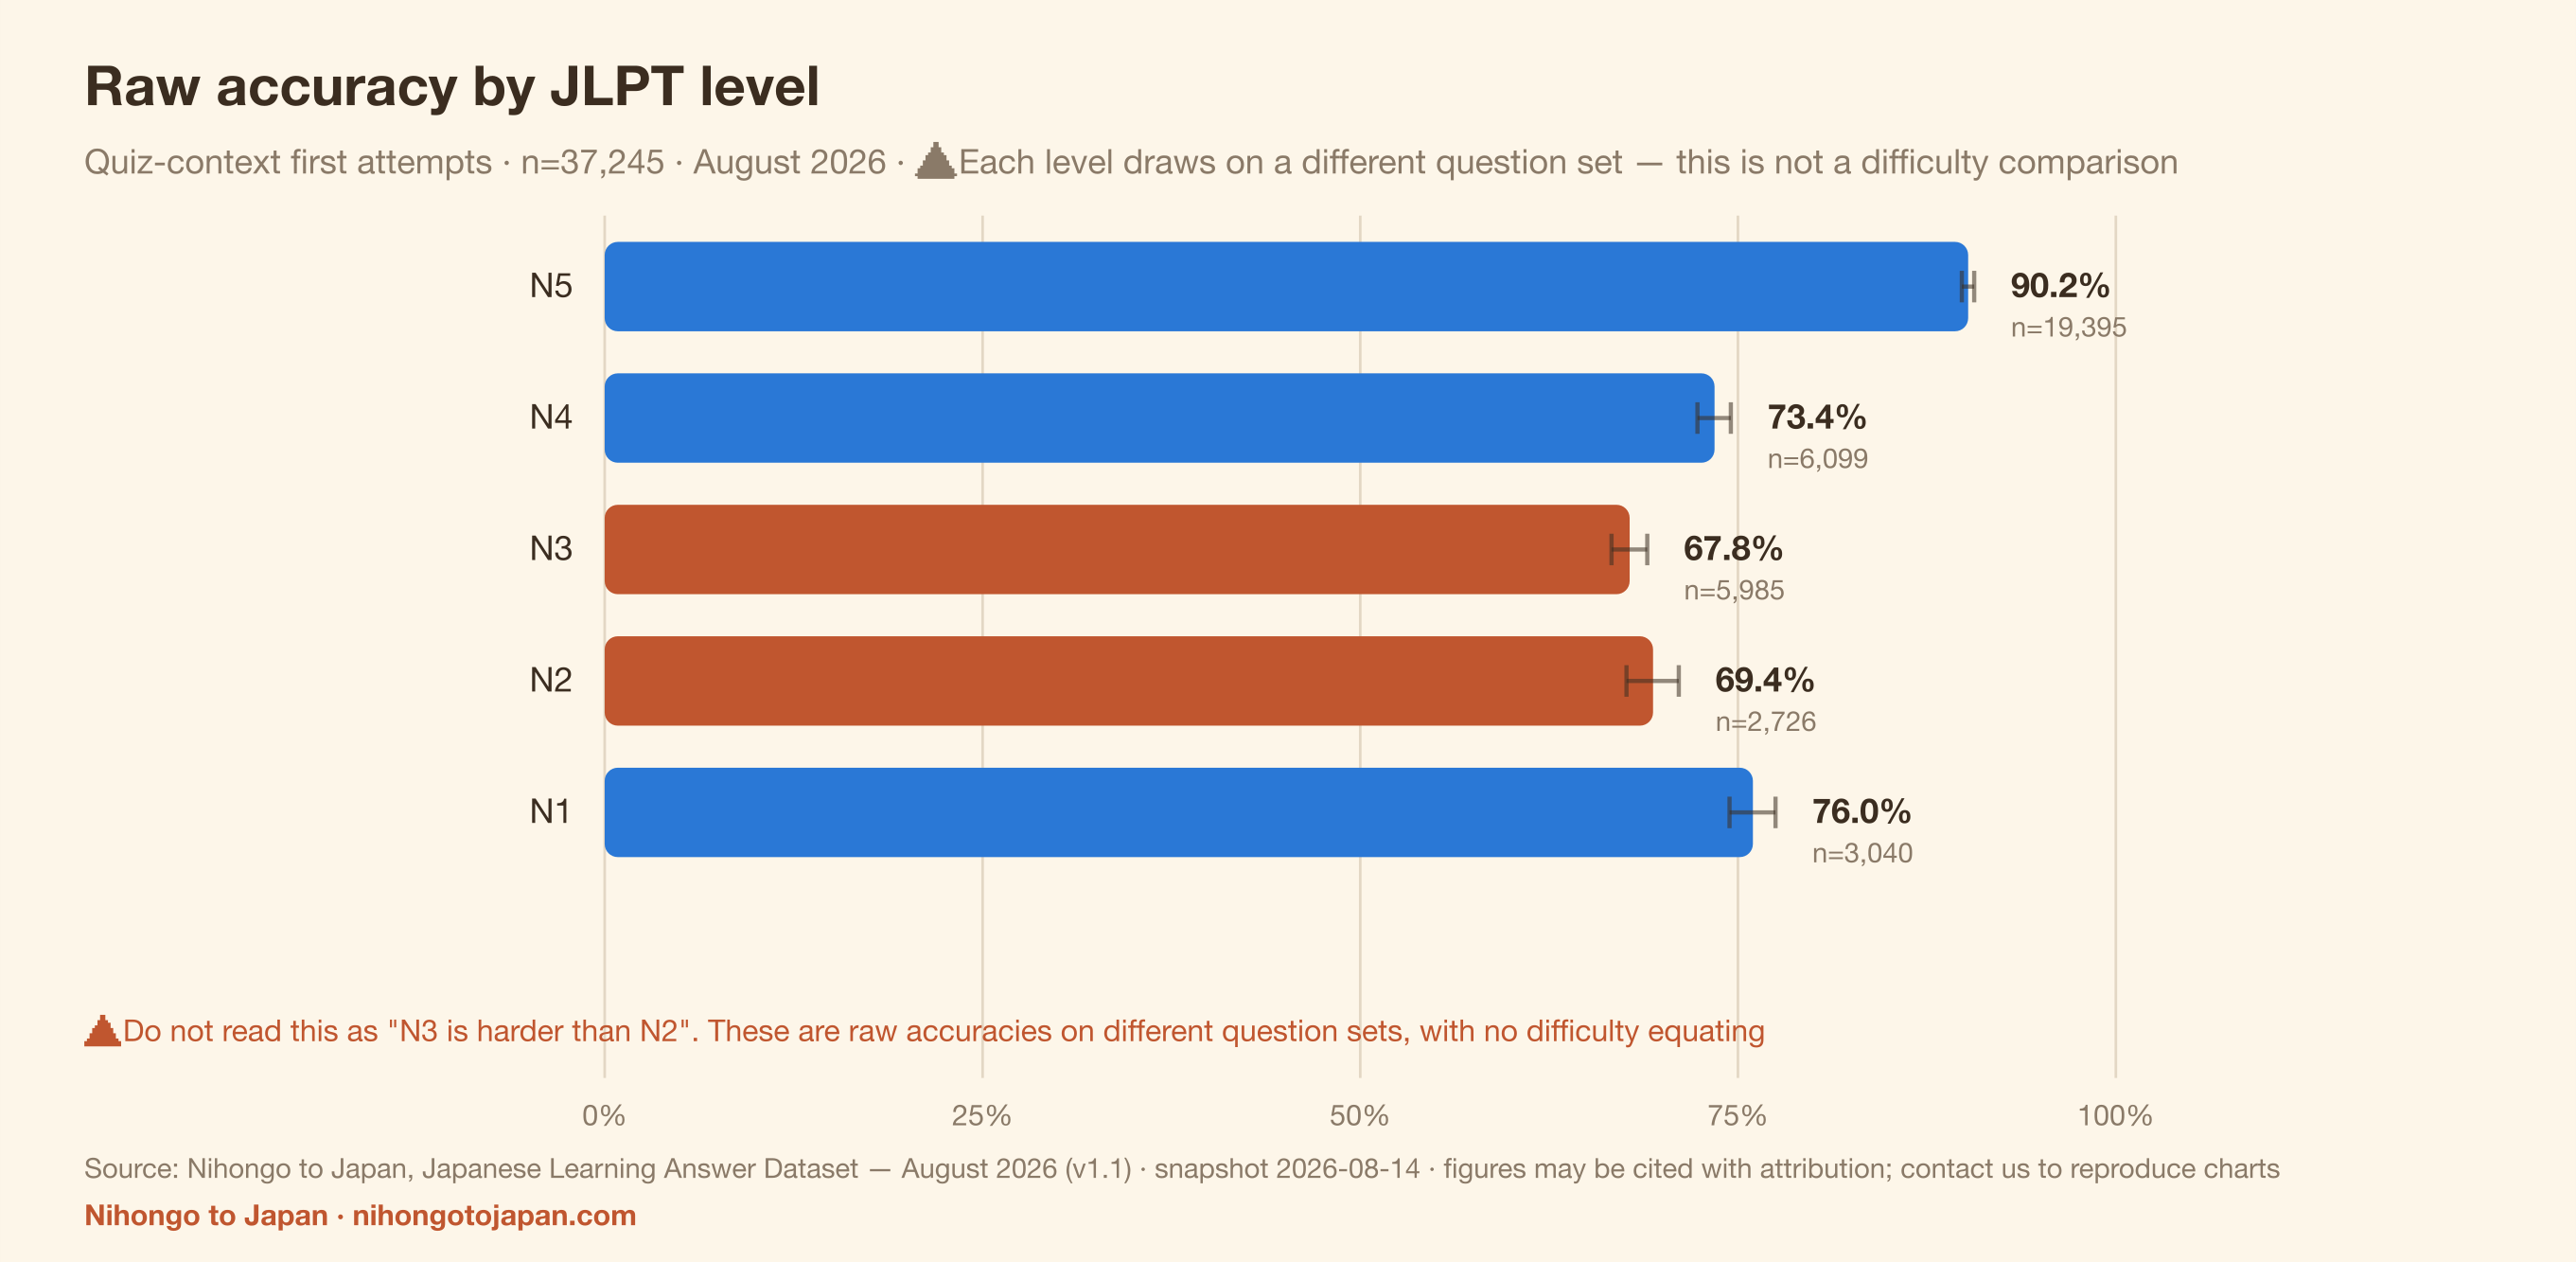
두 맥락은 거의 겹치지 않는 문제 집합을 사용해요. 서로 다른 문형 문제 5,772개 중 양쪽에 모두 나오는 문제는 6개뿐이므로, 맥락의 효과를 문제 난이도의 차이와 분리할 수 없어요. 이 결과가 말하려는 것은, 학습 플랫폼이 제시하는 정답률 수치는 반드시 어떤 응답을 포함했는지 밝혀야 한다는 점이에요. - 같은 데이터셋의 테스트 맥락 첫 시도에서 원 정답률은 N3가 67.8%(n=5,985, 95% 신뢰구간 66.6%–69.0%), N2가 69.4%(n=2,726, 95% 신뢰구간 67.6%–71.1%)였어요. 두 신뢰구간이 겹치므로 이 데이터셋으로는 N2와 N3를 구별할 수 없어요.
"N2가 N3보다 어렵다" 또는 그 반대로 보도하지 마세요. - 같은 데이터셋의 테스트 맥락 첫 시도에서 JLPT 레벨별 원 정답률은 N5 90.2%(n=19,395), N1 76.0%(n=3,040), N4 73.4%(n=6,099), N2 69.4%(n=2,726), N3 67.8%(n=5,985)로, N1의 원 정답률이 N2와 N3보다 모두 높았어요.
레벨마다 문제 집합이 다르고, IRT 동등화도 하지 않았으며, 표본이 자기선택적이에요(N1 문제에 도전하는 사람은 대체로 학습이 더 진행된 사람이에요). 따라서 이 순서를 JLPT 레벨의 객관적 난이도로 해석할 수 없어요. - 같은 데이터셋의 테스트 맥락 첫 시도에서 조사 안의 편차가 JLPT 레벨 사이의 편차보다 커요: 조사 が의 정답률은 60.9%(n=358, 95% 신뢰구간 55.8%–65.8%), を는 78.7%(n=385, 95% 신뢰구간 74.3%–82.5%)로 17.8%p 차이가 나는 반면, N3(67.8%)와 N4(73.4%)의 차이는 5.6%p예요.
교육적으로는, JLPT 레벨 단위로 연습량을 배분하는 것이 지식 포인트 단위로 배분하는 것보다 거칠 수 있다는 시사점이 있어요. - 같은 데이터셋의 테스트 맥락 첫 시도에서 문형은 모든 JLPT 레벨에서 정답률이 가장 낮은 축이에요: N5 64.0%(n=1,939), N4 48.0%(n=1,734), N3 49.2%(n=2,531), N2 51.1%(n=1,179), N1 57.0%(n=1,295).
같은 레벨의 어휘는 N5 94.4%, N4 89.0%, N3 84.0%, N2 85.0%, N1 89.2%예요. - 같은 데이터셋에서 완전히 동일한 학습자 식별자 372개와 동일한 응답 이벤트 34,392건을 대상으로 계산하면, 응답 1건당 1표(이벤트 가중)로는 82.53%, 식별자 1개당 1표로는 75.49%로, 7.04%p 차이가 나요.
두 수치는 동일한 모집단과 분석 집합을 사용하므로, 차이는 오로지 가중 방식의 선택에서 비롯돼요. 학습 플랫폼의 정답률 수치를 인용하는 보도는 어떤 가중 방식을 썼는지 밝혀야 해요. - 같은 데이터셋에서 응답량은 크게 편중되어 있어요: 가장 활발한 학습자 식별자 하나가 전체 응답 이벤트 56,613건의 3.73%를 차지하고, 상위 10개 식별자가 합쳐서 19.44%를 차지해요.
이 편중이 두 가중 방식의 결과가 7%p 차이 나는 직접적인 이유이며, 학습 플랫폼 데이터 전반에 공통되는 구조적 편향이에요. - 같은 데이터셋에서 두 맥락 모두에서 응답한(각 맥락에서 5건 이상) 학습자 식별자 75개로 한정한 대응 비교 결과, 교재 맥락은 86.57%(n=5,858), 테스트 맥락은 55.52%(n=2,055)로, 대응 평균 차이는 27.47%p(95% 신뢰구간 22.56–32.39)였어요.
이는 맥락 간 차이가 누가 어디에서 응답했는지에 따른 인위적 결과가 아님을 보여 줘요. 그러나 같은 문제로 비교하는 것이 불가능하므로(결과 3 참고), 맥락 효과는 여전히 문제 난이도와 분리할 수 없어요.
각 결과는 아래 섹션에서 표와 도표와 함께 자세히 설명해요. 수치만 필요하다면 데이터 다운로드로, 인용 방법은 인용 방법으로, 문의는 연락처 섹션으로 가세요.
1. 다섯 가지 주요 결과
1. 문형은 60%를 밑도는 유일한 축이며, 어휘보다 38%p 낮아요
테스트 맥락 첫 시도(집합의 정의는 방법론 참고)에서 어휘 문제의 정답률은 92.1%(n=22,869, 학습자 식별자 627개, 95% 신뢰구간 91.8%–92.5%)였던 반면, 문형 문제는 53.7%(n=8,678, 식별자 532개, 95% 신뢰구간 52.6%–54.7%)에 그쳤어요.
두 신뢰구간이 멀리 떨어져 있으므로 표본 잡음이 아니에요. 데이터는 두 축 사이에 큰 차이가 있음을 보여 줄 뿐, 그 이유에 대해서는 아무것도 말해 주지 않아요.
2. 문형 '정답률'은 어떤 응답을 포함하느냐에 따라 53.7%에서 74.1%까지 달라져요
분석 집합의 정의에 따라 문형 축의 관측 정답률은 53.7%(테스트 맥락 첫 시도, n=8,678)에서 74.1%(전체 응답 이벤트, n=24,293)까지 달라져요. 포함되는 이벤트와 학습자 식별자 구성이 모두 다르므로, 이 차이 전체를 하나의 집계 규칙에 따른 결과로 볼 수는 없어요.
단계별로 보면 다음과 같아요:
| 단계 | n | 원 정답률 | 이전 단계 대비 변화 |
|---|---|---|---|
| 전체 응답 이벤트 | 24,293 | 74.1% | — |
| → 첫 시도만 남김 | 22,638 | 73.2% | -0.87%p |
| → 테스트 맥락만 남김(교재·복습 제외) | 8,678 | 53.7% | -19.54%p |
| (비교) 교재 맥락 첫 시도 | 13,937 | 85.4% | — |
반복 시도를 제외해도 수치는 0.9%p밖에 변하지 않아요. 나머지 차이는 거의 전부 교재 맥락과 테스트 맥락 응답 사이의 차이에서 나와요.
동일 학습자 식별자에 대한 대응 비교: 각 맥락에서 문형 첫 시도가 5건 이상인 식별자는 75개예요. 이들의 정답률은 교재 맥락에서 86.6%(n=5,858), 테스트 맥락에서 55.5%(n=2,055)이며, 대응 평균 차이는 +27.5%p(95% 신뢰구간 22.6–32.4, 중앙값 +26.9)예요. 따라서 이 차이는 단순히 누가 응답했느냐의 문제가 아니에요.
⚠️ 같은 문제로 비교할 수 없으므로 결론을 내릴 수 없어요. 서로 다른 문형 문제 5,772개 중 양쪽 맥락에 모두 나오는 문제는 6개뿐이며, 양쪽에서 각각 3건 이상 응답된 문제는 1개뿐이에요. 두 맥락은 거의 겹치지 않는 문제 집합을 사용하므로, 맥락 효과를 문제 난이도의 차이와 분리할 수 없어요. 교재 맥락의 문제가 단순히 더 쉬웠을 가능성도 있어요.
정직하게 말할 수 있는 것은 이것이에요: 학습 플랫폼의 정답률 수치를 인용할 때는 그 수치가 어떤 분석 집합에서 나왔는지 반드시 확인해야 해요. 네 가지 집합 모두 다운로드 데이터에 들어 있어요.
3. N3와 N2의 원 정답률이 가장 낮지만, 이 데이터로는 둘을 구별할 수 없어요
테스트 맥락 첫 시도의 레벨별 원 정답률: N5 90.2%, N4 73.4%, N3 67.8%, N2 69.4%, N1 76.0%.
N3(95% 신뢰구간 66.6%–69.0%)와 N2(95% 신뢰구간 67.6%–71.1%)의 구간이 겹치므로 "N3가 N2보다 어렵다"고 말하는 것은 옳지 않아요. 말할 수 있는 것은, 이 표본에서 N2와 N3의 원 정답률이 모두 N4, N1, N5보다 낮다는 점이에요.
⚠️ 더 중요한 점은 레벨마다 완전히 다른 문제 집합을 사용한다는 것이에요. 이 순서는 난이도 비교가 아니며, 어느 JLPT 레벨이 객관적으로 더 어려운지에 대한 증거도 아니에요.
4. 조사 안의 편차가 레벨 사이의 편차보다 커요
테스트 맥락 첫 시도의 개별 조사 정답률: が 60.9%(n=358, 신뢰구간 55.8%–65.8%), に 62.4%(n=370), で 63.3%(n=330), 반면 を 78.7%(n=385, 신뢰구간 74.3%–82.5%), の 83.3%(n=120).
が와 を의 구간은 겹치지 않으며, 차이는 18%p예요.
5. 식별자 1개당 1표와 응답 1건당 1표는 7.04%p 차이가 나요
완전히 동일한 학습자 식별자 372개, 동일한 분석 집합, 동일한 적격 이벤트 34,392건을 대상으로 계산한 결과예요:
| 가중 방식 | 정답률 |
|---|---|
| 이벤트 가중(응답 1건당 1표) | 82.5% |
| 식별자 가중(식별자 1개당 1표) | 75.5%(중앙값 76.2%) |
| WEIGHTING_EFFECT_PP | 7.04%p |
코호트: 주 분석 집합에서 응답이 20건 이상인 학습자 식별자. 두 수치는 분자의 모집단과 분모가 같으므로, 차이는 가중 방식의 선택만을 반영하며 표본 구성의 차이가 섞이지 않아요.
원인은 반복 측정이에요: 가장 활발한 식별자 하나가 전체 응답의 3.7%를, 상위 10개가 19.4%를 차지해요. 플랫폼 데이터를 쓰는 연구라면 누구나 부딪히는 문제이므로, 두 수치를 모두 공개해요.
2. 데이터셋 개요
| 항목 | 값 |
|---|---|
| 유효 응답 이벤트 | 56,613 |
| 익명 학습자 식별자(인원수의 상한) | 1,053 |
| 서로 다른 문제 수 | 11,987 |
| 지식 포인트 | 39 |
| 대상 기간 | 2026년 8월 2일~13일(12일), 첫날은 일부만 포함 |
| 스냅샷 기준 시각 | 2026-08-14T00:00:00Z |
| 첫 시도 이벤트 | 52,934 |
| 테스트 맥락 첫 시도(주 분석 집합) | 37,245 |
| 주 분석 집합의 학습자 식별자 | 688 |
| 교재 맥락 첫 시도(비교 집합) | 15,741 |
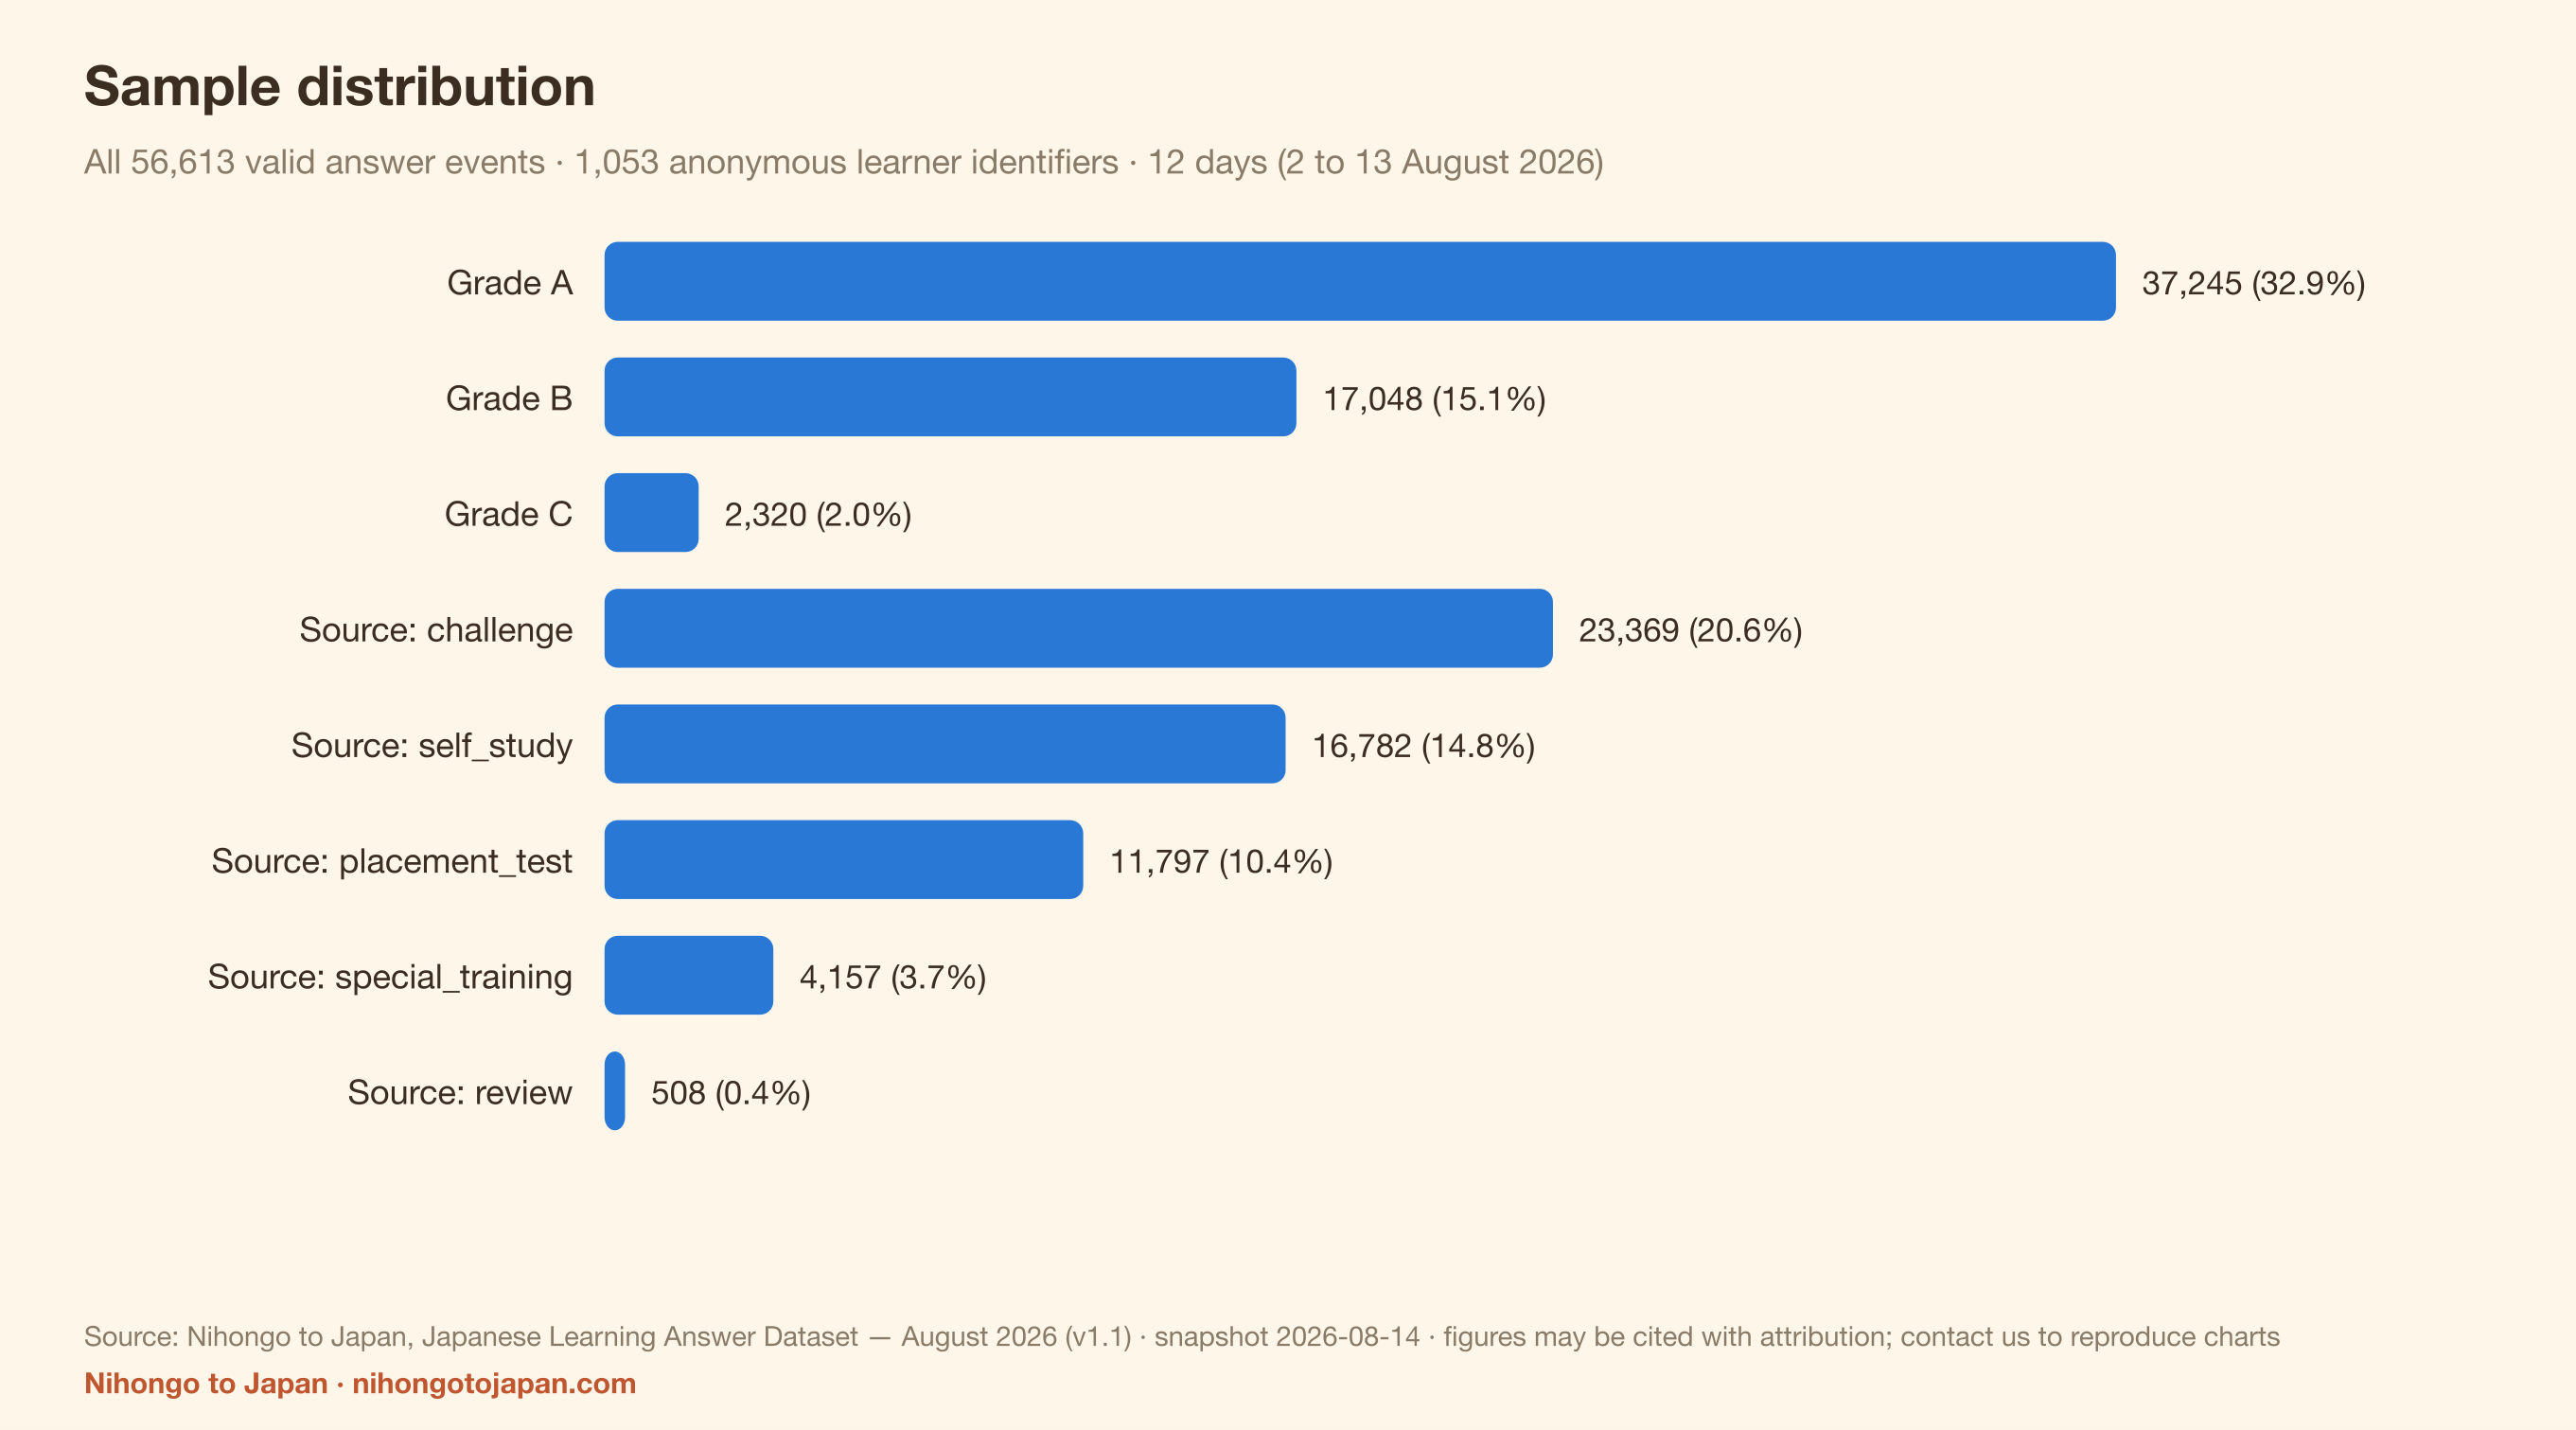
출처별 응답 수: challenge 23,369(41.3%), self_study 16,782(29.6%), placement_test 11,797(20.8%), special_training 4,157(7.3%), review 508(0.9%).
데이터베이스 evidence_class 열의 분포(원본 테이블의 필드이며, 이 보고서의 분석 집합 이름이 아니에요): A 37,245(65.8%), B 17,048(30.1%), C 2,320(4.1%). 주 분석 집합은 정확히 evidence_class = A에 해당해요.

3. 학습 축별 정답률

| 능력 축 | n | 식별자 | 원 정답률 | 95% 신뢰구간 | 플래그 |
|---|---|---|---|---|---|
| 문형 | 8,678 | 532 | 53.7% | 52.6%–54.7% | OK |
| 조사 | 1,986 | 137 | 69.1% | 67.1%–71.1% | OK |
| 어형·활용 | 2,322 | 386 | 83.2% | 81.7%–84.7% | OK |
| 관용 표현 | 1,341 | 261 | 86.4% | 84.5%–88.2% | OK |
| 어휘 | 22,869 | 627 | 92.1% | 91.8%–92.5% | OK |
다음 축은 최소 셀 크기(n<30 또는 학습자 식별자 5개 미만)에 미달하므로 정답률을 공개하지 않고 이벤트 수만 공개해요: 종합(n=27, 식별자 8개), 독해(n=22, 식별자 4개).
4. JLPT 레벨별 정답률
⚠️ 가장 오해받기 쉬운 섹션이에요. 레벨마다 완전히 다른 문제 집합을 사용하며, IRT 난이도 동등화도 하지 않았어요. 아래 수치는 해당 문제들에 정답을 맞힌 비율일 뿐, 어느 레벨이 더 어려운지를 나타내는 지표가 아니에요.

| JLPT 레벨 | n | 식별자 | 원 정답률 | 95% 신뢰구간 |
|---|---|---|---|---|
| N5 | 19,395 | 380 | 90.2% | 89.8%–90.6% |
| N4 | 6,099 | 313 | 73.4% | 72.3%–74.5% |
| N3 | 5,985 | 432 | 67.8% | 66.6%–69.0% |
| N2 | 2,726 | 212 | 69.4% | 67.6%–71.1% |
| N1 | 3,040 | 139 | 76.0% | 74.4%–77.5% |
네 가지 분석 집합에서 본 같은 레벨:
| 레벨 | 테스트 맥락 첫 시도(주) | 교재 맥락 첫 시도 | 첫 시도(전체) | 전체 이벤트 |
|---|---|---|---|---|
| N5 | 90.2% (n=19,395) | 83.7% (n=11,154) | 87.8% (n=30,495) | 88.2% (n=33,286) |
| N4 | 73.4% (n=6,099) | 83.1% (n=2,694) | 76.5% (n=8,758) | 76.6% (n=9,262) |
| N3 | 67.8% (n=5,985) | 82.1% (n=1,507) | 70.8% (n=7,522) | 71.1% (n=7,727) |
| N2 | 69.4% (n=2,726) | 79.2% (n=260) | 70.2% (n=2,985) | 70.5% (n=3,072) |
| N1 | 76.0% (n=3,040) | 86.5% (n=126) | 76.4% (n=3,174) | 76.5% (n=3,266) |
5. 정답률이 가장 낮은 지식 포인트
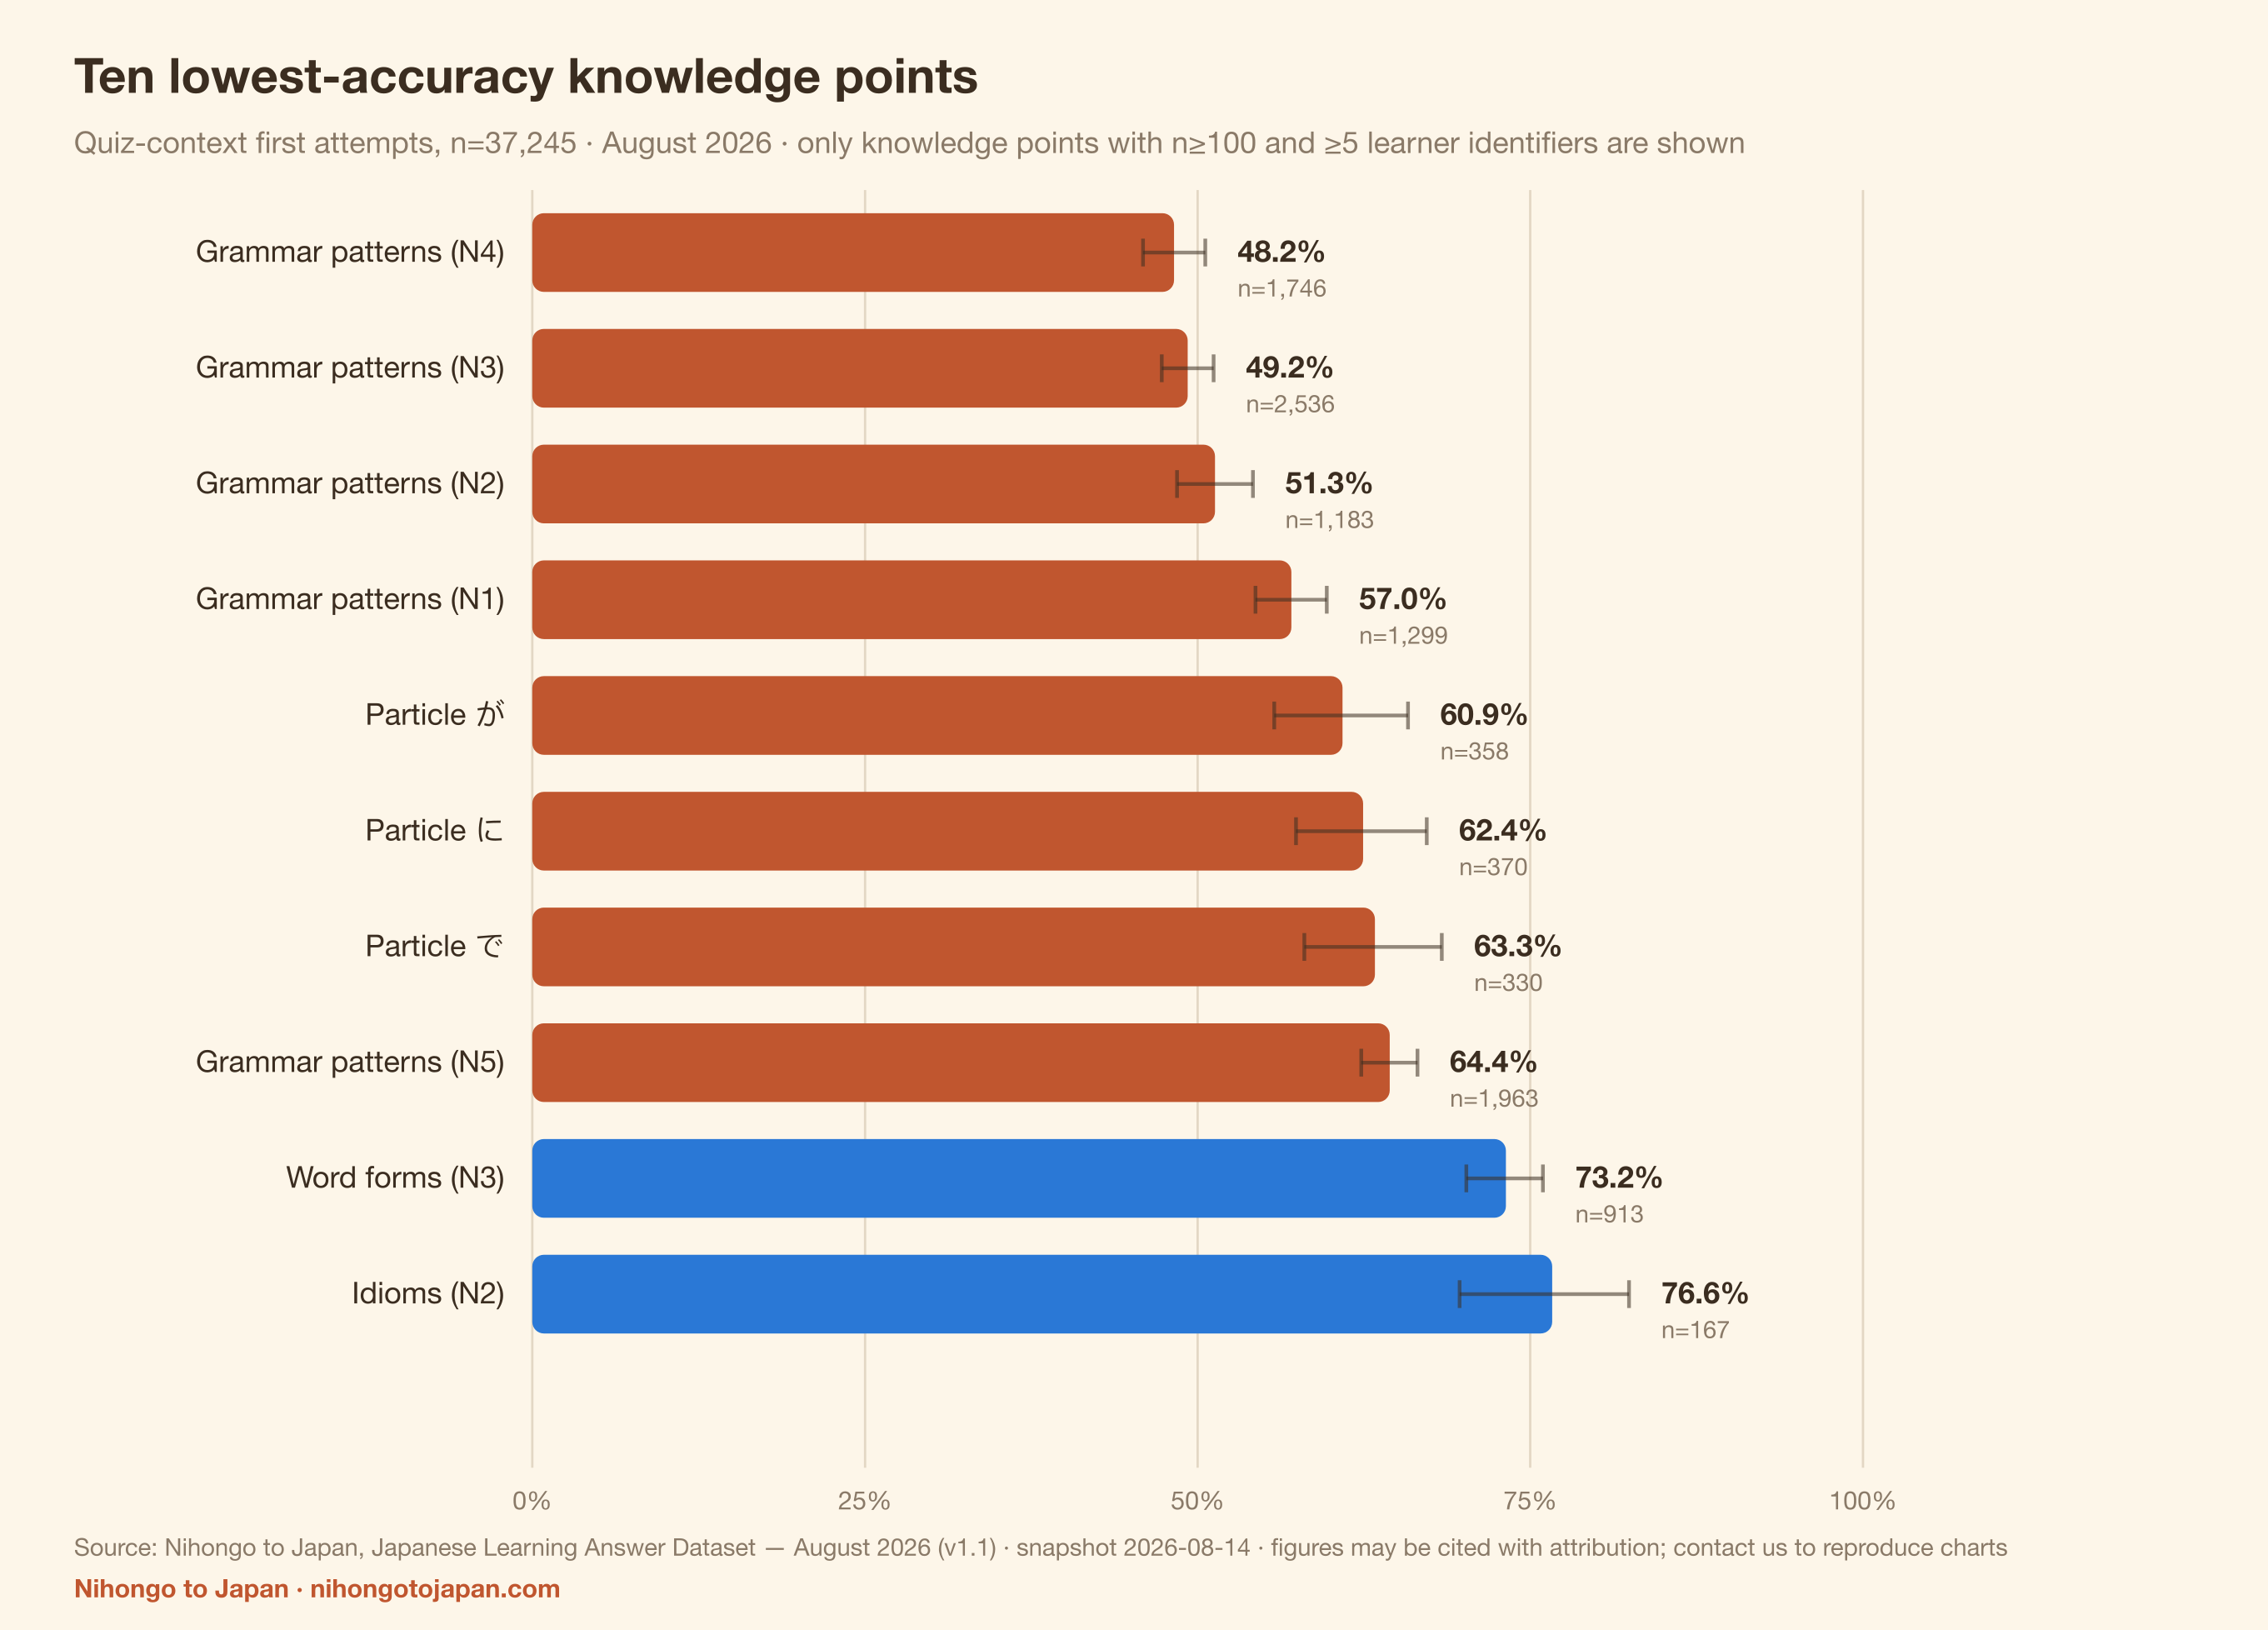
n≥100이고 학습자 식별자가 5개 이상인 지식 포인트만 실었어요(해당 23개). 백분율과 함께 n, 레벨, 범주를 표시했어요. 작은 셀은 대개 단순한 잡음 때문에 극단적으로 보이기 때문이에요.

| # | 지식 포인트 | 범주 | 레벨 | n | 식별자 | 원 정답률 | 95% 신뢰구간 |
|---|---|---|---|---|---|---|---|
| 1 | 문형(N4) | 문형 | N4 | 1,746 | 234 | 48.2% | 45.9%–50.6% |
| 2 | 문형(N3) | 문형 | N3 | 2,536 | 390 | 49.2% | 47.3%–51.2% |
| 3 | 문형(N2) | 문형 | N2 | 1,183 | 191 | 51.3% | 48.5%–54.1% |
| 4 | 문형(N1) | 문형 | N1 | 1,299 | 118 | 57.0% | 54.3%–59.7% |
| 5 | 조사 が | 조사 | — | 358 | 81 | 60.9% | 55.8%–65.8% |
| 6 | 조사 に | 조사 | — | 370 | 75 | 62.4% | 57.4%–67.2% |
| 7 | 조사 で | 조사 | — | 330 | 85 | 63.3% | 58.0%–68.3% |
| 8 | 문형(N5) | 문형 | N5 | 1,963 | 209 | 64.4% | 62.3%–66.5% |
| 9 | 어형(N3) | 어형 | N3 | 913 | 294 | 73.2% | 70.2%–75.9% |
| 10 | 관용구(N2) | 관용구 | N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| 11 | 조사 を | 조사 | — | 385 | 61 | 78.7% | 74.3%–82.5% |
| 12 | 어형(N2) | 어형 | N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
6. 가장 안정적인 강점
| # | 지식 포인트 | 범주 | 레벨 | n | 식별자 | 원 정답률 | 95% 신뢰구간 |
|---|---|---|---|---|---|---|---|
| 1 | 어형(N1) | 어형 | N1 | 296 | 79 | 95.6% | 92.6%–97.4% |
| 2 | 어휘(N5) | 어휘 | N5 | 16,029 | 311 | 94.4% | 94.0%–94.8% |
| 3 | 어휘(N1) | 어휘 | N1 | 703 | 94 | 89.2% | 86.7%–91.3% |
| 4 | 어휘(N4) | 어휘 | N4 | 2,828 | 243 | 89.0% | 87.8%–90.1% |
| 5 | 관용구(N1) | 관용구 | N1 | 742 | 111 | 88.8% | 86.3%–90.9% |
| 6 | 어형(N4) | 어형 | N4 | 461 | 149 | 87.0% | 83.6%–89.8% |
| 7 | 관용구(N4) | 관용구 | N4 | 140 | 91 | 86.4% | 79.8%–91.1% |
| 8 | 관용구(N3) | 관용구 | N3 | 290 | 142 | 85.9% | 81.4%–89.4% |
7. 주목할 만한 관측 패턴
관측 A: N1의 원 정답률이 N2와 N3보다 높아요
N1 76.0%(n=3,040, 식별자 139개)는 N2 69.4%, N3 67.8%보다 높아요.
이는 관측된 패턴일 뿐, N1이 더 쉽다는 증거가 아니에요. 이 데이터로는 최소 세 가지 설명을 배제할 수 없어요: N1 문제에 응답한 식별자는 139개로 N3의 432개보다 적어 집단 구성이 다르고, 문제 집합이 다르며, 능력 추정도 하지 않았어요. "어느 레벨이 실제로 더 어려운가"에 답하려면 IRT 동등화와 앵커 문항 설계가 필요한데, 이 데이터셋에는 둘 다 없어요.
관측 B: 문형 축은 모든 레벨에서 가장 낮아요
| 축 × 레벨 | n | 식별자 | 원 정답률 | 95% 신뢰구간 |
|---|---|---|---|---|
| 문형 × N4 | 1,734 | 233 | 48.0% | 45.6%–50.3% |
| 문형 × N3 | 2,531 | 389 | 49.2% | 47.2%–51.1% |
| 문형 × N2 | 1,179 | 191 | 51.1% | 48.3%–54.0% |
| 문형 × N1 | 1,295 | 118 | 57.0% | 54.3%–59.7% |
| 조사 × N4 | 766 | 92 | 58.5% | 55.0%–61.9% |
| 문형 × N5 | 1,939 | 208 | 64.0% | 61.8%–66.1% |
| 어형·활용 × N3 | 948 | 302 | 74.2% | 71.3%–76.8% |
| 조사 × N5 | 1,220 | 111 | 75.8% | 73.3%–78.1% |
| 관용 표현 × N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| 어형·활용 × N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
축과 레벨을 교차해 보면, 정답률이 가장 낮은 셀은 거의 모두 문형 셀이에요. 이는 레벨별 분석만 볼 때보다 더 많은 정보를 줘요.
8. 교사와 교재 설계자가 활용할 수 있는 점
이 섹션은 의도적으로 데이터와 해석을 구분해요. 데이터는 인용할 수 있지만, 해석은 저희의 판단이므로 동의하지 않으셔도 돼요.
| 데이터(인용 가능) | 해석(데이터가 아닌 저희의 판단) |
|---|---|
| 테스트 맥락 첫 시도: 문형 축 53.7% 대 어휘 92.1%(n=8,678 및 22,869) | 이 플랫폼에서는 단어를 알아보는 것과 문장을 조립하는 것 사이에 뚜렷한 차이가 있어요. 연습 시간을 배분해야 한다면 문형 쪽의 한계 효용이 더 클 수 있어요. |
| が 60.9%, に 62.4%, で 63.3%는 を 78.7%, の 83.3%보다 크게 낮아요 | を와 の는 기능이 비교적 좁은 반면, が, に, で는 다의성이 매우 커요. 조사를 하나씩 차례로 소개하기보다 한 조사의 서로 다른 기능을 따로따로 가르치는 편이 더 효과적일 수 있어요. |
| N2와 N3의 원 정답률(69.4% / 67.8%)이 N4, N1, N5보다 낮아요 | ⚠️ 이를 근거로 난이도 순위를 매기지 마세요. 문항 자체보다는 N2/N3에서 응답한 학습자의 구성이 다른 레벨과 다르기 때문이라고 보는 편이 더 그럴듯해요. |
| 문형: 교재 맥락 85.4%(n=13,937) 대 테스트 맥락 53.7%(n=8,678), 식별자 75개의 대응 차이 +27.5%p | 교재 학습 중의 응답과 테스트 응답은 결과가 크게 달라요. 플랫폼의 연습 점수로 학습 성과를 판단할 때 염두에 둘 만해요. ⚠️ 다만 두 맥락은 거의 겹치지 않는 문제 집합을 사용하므로, 이것이 맥락 때문인지 단순히 문제가 더 쉬웠기 때문인지는 알 수 없어요. |
9. 방법론
| 항목 | 내용 |
|---|---|
| 모집단 | Nihongo to Japan을 이용하는 학습자가 생성한 응답 기록. |
| 표집 | 자기선택 관찰 표본. 무작위 표집이 아니며, 모집단을 대표하지 않아요. |
| 분석 단위 | 응답 이벤트(학습자 식별자 하나가 문제 하나에 한 번 응답한 것). |
| 사용자 수 | 학습자 식별자 = 서로 다른 익명 식별자의 수. 기기 간에 통합할 수 없으므로, 검증된 인원수가 아니라 인원수의 상한이에요. |
| 지표 | 원 정답률 = 정답 수 ÷ 유효 응답 이벤트 수. 능력 추정치가 아니에요. |
| 신뢰구간 | Wilson 95% 신뢰구간. 표집 오차만 반영하며, 선택 편향은 보정하지 않아요. |
네 가지 분석 집합
| 집합 | 정의 | n |
|---|---|---|
| 테스트 맥락 첫 시도 (주 분석 집합) | challenge / placement_test / special_training에서 나온 응답 중, 해당 학습자 식별자가 그 문제에 처음 응답한 것이고, 24시간 이내의 반복이 아니며, 문제 메타데이터가 완전한 것. | 37,245 |
| 교재 맥락 첫 시도 (비교 집합) | self_study / review에서 나온 첫 시도. 즉 교재를 학습하는 과정에서 한 응답. | 15,741 |
| 첫 시도(모든 맥락) | 출처와 관계없이, 각 학습자 식별자가 각 문제에 처음 한 응답. | 52,934 |
| 전체 응답 이벤트 | 반복 응답을 포함한 모든 유효 응답 이벤트. | 56,613 |
⚠️ 주 분석 집합은 힌트나 해설 이용에 대해 아무것도 주장하지 않아요.used_hint/viewed_explanation/used_answer_key필드는 데이터베이스 전체에서 false이지만, 이는 이 필드를 기록하는 곳이 한 군데도 없기 때문이에요. 응답을 수집하는 어떤 호출 지점도 이 매개변수를 넘기지 않으며, 현재 제품에는 응답 전 힌트나 정답 공개 기능도 없어요. 값이 항상 false인 것은 계측 방식의 특성이지, 학습자 행동에 대한 증거가 아니에요. 따라서 이 필드들은 분석 조건으로 쓰지 않으며, 힌트 이용에 대해서는 어떤 주장도 하지 않아요.
주 분석 집합의 독립 검증: 서버에서 (식별자, 문제)별 가장 이른 이벤트를 다시 계산한 결과, 주 분석 집합 이벤트의 99.59%(37,245건 중 37,094건)가 첫 시도 검사를 통과했어요. 통과하지 못한 151건은 기기 간 중복일 가능성이 가장 커요. 즉 같은 사람이 두 기기에서 응답해 각 기기에 첫 시도가 기록된 경우예요. 집합 안의 모든 이벤트는 attempt_number = 1이에요.
제외한 데이터
- 알려진 결함 문제: 문제 ID 520개를 모든 집계에서 제외했어요. 원인은 두 가지예요. (1) 교재의 문법 외 빈칸 채우기 문제(가나 변환, 표기, 숫자 답)가 문형 축으로 잘못 태그된 경우, (2) 예전 '오늘의 문제' 빌드가 정답 토큰을 문제 식별자로 사용해 서로 다른 문제가 하나의 ID로 합쳐진 경우예요. 프런트엔드는 수정되었고, 과거 데이터는 거부 목록으로 제외해요. 원본 이벤트는 하나도 삭제하지 않았어요. 테이블은 추가 전용이에요.
- 스냅샷 기준 시각 이후의 이벤트: 이 보고서는 2026-08-14T00:00:00Z 시점으로 동결되었어요. 데이터는 계속 쌓이지만, 이 페이지와 다운로드 파일의 모든 수치는 동결된 그 한 시점에서 나온 것이에요.
최소 셀 크기
n<30이거나 학습자 식별자가 5개 미만인 셀은 SUPPRESSED로 처리해요. 이벤트 수는 공개하지만 정답률은 공개하지 않아요. n≥30이고 식별자가 5개 이상이지만 n<100인 셀은 LOW_SAMPLE로 표시하며, 인용할 때 반드시 n을 함께 적어야 해요. n≥100이고 식별자가 5개 이상인 셀은 OK로 표시해요.
이번 스냅샷에서 지식 포인트 23개가 OK, 12개가 LOW_SAMPLE, 3개가 SUPPRESSED예요.
익명화
- 각 이벤트에는 브라우저에서 생성한 익명 기기 UUID만 담겨요. 이름, 이메일, IP 주소, 기기 지문, 자유 입력 텍스트는 일절 포함되지 않아요.
- 데이터를 받는 Cloudflare Pages Function은 허용 목록에 있는 열만 기록하며, IP 주소는 명시적으로 기록하지 않아요.
- 공개 데이터셋에는 집계 통계만 들어 있으며, 원본 응답 이벤트는 한 건도 없어요.
- 학습자는 개인정보 처리방침 페이지에서 클릭 한 번으로 집계 수집을 거부할 수 있어요.
10. 한계(수치와 함께 인용해 주세요)
한 단락만 읽는다면 이 단락을 읽어 주세요. 이 데이터는 Nihongo to Japan에 연습하러 온 사람들이 Nihongo to Japan의 문제를 어떻게 풀었는지를 기술해요. 대만 일본어 학습자의 모습을 보여 주는 자료가 아니고, JLPT 난이도를 측정한 것도 아니며, 레벨 간 객관적 난이도를 비교하는 데 쓸 수도 없어요.
- 선택 편향: 표본은 이곳에서 연습하기로 스스로 선택한 사람들이에요. 일반 학습자보다 동기가 높을 가능성이 크고, 더 젊고 온라인 도구에 익숙할 수도 있어요.
- 반복 측정: 가장 활발한 식별자 하나가 전체 응답의 3.7%를, 상위 10개가 19.4%를 차지해요. 동일한 식별자 372개에서 이벤트 가중과 식별자 가중의 결과는 7.04%p 차이가 나요.
- 분석 집합끼리 직접 빼서 비교할 수 없음: 교재 맥락과 테스트 맥락은 거의 겹치지 않는 문제 집합을 사용하므로(문형 문제 5,772개 중 양쪽에 모두 나오는 것은 6개뿐), 둘 사이의 정답률 차이를 하나의 원인으로 돌릴 수 없어요.
- 힌트·해설 이용 행동은 관측할 수 없음: 관련 필드가 전혀 기록되지 않으므로, 이 데이터셋은 그에 대해 아무것도 주장하지 않아요.
- 문제 난이도가 균일하지 않음: 레벨과 축마다 다른 문제 집합을 사용하므로, 원 정답률은 표준화된 난이도 지표가 아니에요.
- IRT 동등화 없음: 문항반응이론에 따른 동등화도, 레벨 간 앵커 문항 설계도 없으므로, 이 데이터로는 어느 레벨이 더 어려운지 답할 수 없어요.
- 표본 크기가 균등하지 않음: N5 응답 수가 N1 응답 수의 6배가 넘어요.
- 짧은 기간: 12일뿐이에요(집계 파이프라인은 2026-08-02에 가동). 이 데이터로는 어떠한 장기 추세도 읽어 낼 수 없어요.
- 자동화된 트래픽을 식별할 수 없음: 사람과 스크립트를 구별하는 장치가 없어요. 이벤트의 94%는 응답 시간이 null이므로, "불가능할 만큼 빠른 응답"을 걸러 내는 기본적인 필터조차 쓸 수 없어요. 이는 알려진 데이터 품질상의 공백이에요.
- 모집단을 대표하지 않음: 대만이나 다른 어느 나라의 일본어 학습자 전체도 대표하지 않아요.
11. 인용 방법
논문, 연구 보고서, 교재, 언론 보도에서의 인용을 환영해요. 출처를 밝히고 이 페이지로 연결되는 링크를 달아 주세요.
APA (7th)
Nihongo to Japan. (2026). Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/en/research/japanese-learning-data-2026MLA (9th)
Nihongo to Japan. Japanese Learning Answer Dataset — August 2026. Version 1.1.0, 2026, https://www.nihongotojapan.com/en/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/en/research/japanese-learning-data-2026}

}
라이선스
데이터는 CC BY 4.0으로 공개돼요. 출처를 밝히면 상업적 이용을 포함해 자유롭게 사용할 수 있어요. 도표와 보고서 본문은 적용 대상이 아니에요. 전체 조건은 라이선스 섹션에 있어요.
권장 출처 표기 문구:
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026라이선스: 데이터는 CC BY 4.0
이 데이터셋의 데이터는 크리에이티브 커먼즈 저작자표시 4.0 국제(CC BY 4.0) 라이선스로 공개돼요. 적절한 출처를 표시하고 변경 여부를 밝히면, 상업적 목적을 포함해 복제, 재배포, 변형, 2차 활용을 할 수 있어요.
⚠️ 라이선스는 데이터에만 적용돼요. CC BY 4.0이 적용되는 범위: 이 페이지의 집계 수치와 두 다운로드 파일japanese-learning-2026.json,japanese-learning-2026.csv. Nihongo to Japan이 제작한 도표(SVG/PNG)와 보고서 본문은 적용 대상이 아니며, 모든 권리가 유보돼요.
문의 없이 할 수 있는 것
- 논문, 연구 보고서, 교재, 언론 보도에서 통계를 인용하는 것(상업 출판물 포함).
- 집계 수치를 재분석해 직접 도표를 만드는 것. 직접 그린 도표는 여러분의 것이에요.
- 어떤 형태로든 변형, 리믹스, 가공, 재배포하는 것(데이터 파일을 통째로 재배포하거나 자체 데이터 상품에 포함하는 것도 가능).
- 교실과 교육 현장에서 데이터를 사용하는 것.
출처 표기
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026부탁드리는 사항(라이선스 조건이 아니에요)
다음은 CC BY의 조건이 아니며, 따르지 않아도 라이선스 위반이 아니에요. 그래도 각각 이유를 붙여 부탁드려요:
- 표집상의 한계를 함께 적어 주세요(자기선택 관찰 표본, 12일뿐, 대표성 없음). 이를 빼고 수치만 인용하면 오해를 부르는 통계가 돼요.
- 이 페이지로 링크해 주세요. 독자가 방법론과 버전을 확인할 수 있어요.
- '사람'이 아니라 '학습자 식별자'라고 써 주세요. 식별자 수는 인원수의 상한일 뿐, 실제 인원수가 아니에요.
- 버전을 명시해 주세요(예: v1.1.0, 스냅샷 2026-08-14). 이후 업데이트가 있어도 인용한 수치를 식별할 수 있어요.
라이선스가 적용되지 않는 것
- 저희가 제작한 도표(
/images/research/*.svg및*.png): 복제하기 전에 연락해 주세요. 데이터로 직접 도표를 그리는 데에는 허가가 필요 없어요. - 보고서와 이 웹사이트의 본문: 모든 권리 유보.
- 사이트 이름, 로고, 브랜드 표장: 이 라이선스는 이를 사용할 권리를 부여하지 않아요.
⚠️ CC BY는 철회할 수 없어요. 이 조건으로 데이터를 받은 사람은 나중에 저희가 조건을 바꾸더라도 그 권리를 계속 유지해요. 데이터를 인용하는 사람에게는 자신이 받은 허락이 얼마나 안정적인지 알 권리가 있으므로 여기에 밝혀 둬요.
12. 데이터 다운로드
내용이 같은 두 가지 형식이며, 둘 다 집계 통계만 담고 있어요(원본 응답 이벤트는 없음):
- japanese-learning-2026.json — 전체 메타데이터, 정의, 방법론, 한계, 모든 집계 셀.
- japanese-learning-2026-LICENSE.txt — 라이선스 고지(CC BY 4.0, 적용 범위, 출처 표기 문구). CSV에는 이를 담을 자리가 없으므로 별도 파일로 함께 제공해요.
- japanese-learning-2026.csv — 셀 하나당 한 행. 열:
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag.
버전 1.1.0 · 스냅샷 2026-08-14 · 방법론 버전 1.1. 이후 업데이트에서는 버전 번호를 올리고, 이전 수치를 그 자리에서 덮어쓰지 않고 보존해요.
도표 파일: 이 페이지의 도표 네 개는 모두 PNG(2배 해상도, 슬라이드·인쇄용)와 SVG(벡터, 확대 가능)로 제공해요.
모든 도표에는 제목, n, 버전, 출처 표시가 들어 있어 도표만 따로 퍼져도 자신의 범위를 스스로 밝혀요. 네 도표의 대체 텍스트는 alt-text.json에 모아 두었어요. ⚠️ 도표에는 CC BY가 적용되지 않으므로 복제하기 전에 연락해 주세요(연락처 참고). 데이터 자체는 CC BY 4.0이므로 출처만 밝히면 자유롭게 쓸 수 있어요(라이선스 참고).
⚠️ 인용할 때는 주기적으로 갱신되는 집계 엔드포인트가 아니라, 버전이 붙은 동결 데이터셋을 사용해 주세요.
주기적으로 갱신되는 집계 엔드포인트 /api/aggregates도 있지만, 수치가 시간에 따라 바뀌어요(동결된 버전이 아님). 또한 정의가 달라요: 테스트 맥락 첫 시도가 아니라 전체 응답 이벤트를 기준으로 하며, totalUsers는 전체 1,053개가 아니라 주 분석 집합의 학습자 식별자(688개)만 세어요. 수치가 매일 바뀌므로 인용에는 적합하지 않아요.
기자를 위한 안내
- 표본: 익명 학습자 식별자 1,053개(검증된 인원수가 아님)에서 나온 익명 응답 56,613건, 기간은 2026년 8월 2일~13일, 12일.
- 한 줄 방법론: 자기선택 관찰 표본의 원 정답률. 대표 수치는 테스트 맥락 첫 시도 집합(챌린지, 레벨 테스트, 집중 연습 맥락의 첫 시도)을 사용해요.
- 한 줄 한계: 일본어 학습자를 대표하는 조사가 아니며, JLPT 레벨 간 객관적 난이도를 비교하는 데 쓸 수 없어요.
그대로 인용할 수 있는 수치 세 가지:
- 문형 정답률 53.7%(n=8,678) 대 어휘 92.1%(n=22,869), 38%p 차이.
- 조사 が의 정답률은 60.9%(n=358), を는 78.7%(n=385).
- 문형 정답률은 어떤 응답 맥락을 포함하느냐에 따라 53.7%에서 74.1%까지 달라져요(교재 맥락 85.4%, 테스트 맥락 53.7%). ⚠️ 두 맥락은 거의 겹치지 않는 문제 집합을 사용하므로 원인을 특정할 수 없어요. 하지만 그 자체가 학습 플랫폼 데이터가 어떻게 인용되는지에 관한 이야깃거리예요.
이 데이터 삽입하기(블로그 글이나 교재에 붙여 넣기)
아래 HTML을 글이나 수업 자료에 붙여 넣으세요. 표본 크기, 버전, 라이선스, '모집단을 대표하지 않음'이라는 단서가 이미 들어 있어요. 통계가 다른 곳에 옮겨 인용될 때 빠지기 쉬운 바로 그 부분이에요. 미리 알려 주실 필요는 없어요.
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">익명 응답 56,613건 가운데 테스트 맥락 첫 시도에서 문형 정답률은 <strong>53.7%</strong>(n=8,678)로, 어휘의 <strong>92.1%</strong>(n=22,869)와 대조를 보였습니다.</p><p style="margin:0;font-size:13px;color:#8a7a68">출처: <a href="https://www.nihongotojapan.com/en/research/japanese-learning-data-2026">Nihongo to Japan, Japanese Learning Answer Dataset — August 2026</a> v1.1.0 · CC BY 4.0 · 자기선택 관찰 표본이며 모집단을 대표하지 않음</p></blockquote>
왜 iframe이 아니라 붙여 넣는 블록인가요? 이유는 두 가지예요. 이 사이트는 다른 페이지 안에 프레임으로 삽입되는 것을 허용하지 않아요(사이트 전체에 frame-ancestors 'none' 적용, 유지하고 싶은 클릭재킹 방어 장치예요). 또 iframe 안의 콘텐츠는 저희 도메인에서 제공되므로 여러분의 페이지가 건 링크로 읽히지 않지만, 붙여 넣은 블록은 그렇게 읽혀요. 직접 레이아웃을 짜셔도 돼요. 데이터는 CC BY 4.0이므로 출처 표기만 부탁드려요.
이미지의 경우: 저희 도표에는 라이선스가 적용되지 않지만, CSV로 직접 도표를 그릴 수 있고 그 도표는 여러분의 것이에요. 저희 도표를 수업이나 언론에 사용하려면 보도 자료 키트를 참고하세요.
보도 자료 키트
이 섹션의 모든 내용은 미리 문의하지 않고 복사해 사용할 수 있어요(도표는 제외, 아래 참고). 핵심 정보와 그대로 인용할 수 있는 수치 세 가지는 기자를 위한 안내에, 전체 목록은 그대로 인용할 수 있는 10가지 결과에 있어요.
소개 문구
긴 버전:
Nihongo to Japan은 1인 개발자가 독립적으로 운영하는 일본어 학습 웹사이트예요. 회원 가입이 필요 없고, 전체 과정은 앞으로도 계속 무료이며, 문법 해설, 독학 교재, 연습 문제를 통해 JLPT N5부터 N1까지 다뤄요. 이 데이터셋은 사이트에서 학습자가 남긴 익명 응답 기록에서 추출한 것으로, 동결된 스냅샷을 집계하여 전체 방법론과 한계와 함께 공개해요.
짧은 버전:
독립적으로 운영되며 전체 과정을 언제까지나 무료로 제공하는 일본어 학습 사이트 Nihongo to Japan이 학습자들의 익명 응답을 집계한 데이터셋을 공개해요.
게재용 이미지
저희가 제작한 도표에는 CC BY 4.0이 적용되지 않아요(라이선스는 데이터에만 적용돼요. 라이선스 참고). 이것이 걸림돌이 되지 않도록 두 가지 방법을 마련했어요:
- 요청하시면 24시간 이내에 게재용 이미지 파일을 보내 드려요(PNG 및 SVG). 정확한 캡션, 표본 크기, 버전 표시가 포함돼요. 일반 문의(영업일 기준 2–3일)보다 빠른 이미지 전용 우선 창구예요.
- 기다리지 않고 직접 그리셔도 돼요. 데이터 자체는 CC BY 4.0이므로 JSON이나 CSV로 바로 도표를 만들 수 있어요. 직접 그린 도표는 여러분의 것이에요. 허가도, 알려 주실 필요도 없어요.
책임 있는 보도를 위한 네 가지 참고 사항
조건이 아니에요. 나중에 정정 보도를 낼 일이 없도록 적어 둔 것이에요:
- ✅ '이 응답 집합에서는' 또는 '테스트 문제의 첫 시도에서는'이라고 써 주세요. 이 페이지의 모든 수치는 이 데이터셋 안에서의 관측값이에요.
- ❌ '대만 학습자는 ~하다'로 바꾸지 마세요. 표본은 이 사이트에서 연습하기로 스스로 선택한 사람들이며, 더 넓은 어떤 모집단도 대표하지 않아요.
- ❌ JLPT 레벨의 난이도를 비교하지 마세요. 레벨마다 문제 집합이 다르고, IRT 동등화도 없으며, N3와 N2의 신뢰구간이 겹쳐요. 이 데이터로는 둘을 구별할 수 없어요.
- ❌ 인과적으로 표현하지 마세요. 데이터가 말할 수 있는 것은 '함께 관측되었다'이지 '때문에'가 아니에요.
어떤 표현이 타당한지 확신이 서지 않으면 언제든 문의해 주세요. 게재 후 정정하는 것보다 훨씬 비용이 적게 들어요.
인용 가능한 발언
아래 두 발언은 문의 없이 그대로 사용할 수 있어요.
"테스트 문제의 첫 시도에서 어휘는 92.1%, 문형은 53.7%였어요. 이 수치는 저희 사이트에서 연습하기로 선택한 사람들만을 기술할 뿐, 학습자 전반으로 일반화할 수는 없어요. 하지만 '단어는 아는데 문장을 못 만들겠다'는 단계에서 막혀 있다면, 그런 사람이 당신만은 아니에요."
— Nihongo to Japan 설립자
"같은 데이터에서 어떤 응답을 세느냐만 바꿔도 문형 정답률은 53.7%에서 85.4%까지 움직여요. 대표 수치 하나만으로는 독자가 그것이 어떤 정의에 따른 수치인지 알 길이 없기 때문에, 저희는 네 가지 정의를 나란히 공개해요."
— Nihongo to Japan 설립자
연구팀도, 홍보 담당자도 없어요. 위 발언은 이 데이터셋을 실제로 만든 사람의 발언이에요. 특정 질문에 대한 답변이 필요하면 연락처 섹션을 이용해 주세요.
연구자와 교육자를 위한 안내
구조: 집계 셀 하나당 한 행이며, dimension(axis / jlpt / knowledge_point / axis_x_jlpt) × analysis_set(quiz_first_attempt / lesson_first_attempt / first_attempt / all_events)으로 색인돼요. 각 셀에는 n, learners, accuracy, Wilson ci95_low/ci95_high, flag가 들어 있어요. JSON에는 이에 더해 분석 집합 분해, 대응 비교, 가중 효과가 담겨 있어요.
표집: 자기선택 관찰 표본이며, 분석 단위는 응답 이벤트예요. 학습자 식별자는 익명 UUID이므로 식별자 수는 인원수의 상한이에요(같은 사람이 두 기기를 쓰면 식별자가 두 개 생기며, 식별자끼리 연결할 수 없어요).
알려진 방법론상의 공백 — 숨기기보다 밝혀 둘 가치가 있다고 판단했어요:
- IRT 난이도 동등화와 레벨 간 앵커 문항이 없으므로, 레벨 간 비교는 성립하지 않아요.
- 교재 맥락과 테스트 맥락은 거의 겹치지 않는 문제 집합을 사용하므로(문형 문제 5,772개 중 겹치는 것은 6개뿐), 맥락 효과와 문제 난이도를 분리할 수 없어요.
- 힌트 / 해설 / 정답 확인 필드가 전혀 기록되지 않으므로, 이러한 행동은 관측할 수 없어요. 분석 조건으로 쓸 수 없으며, 값이 없다고 해서 '그런 행동이 없었다'고 해석할 수도 없어요.
- 이벤트의 94%는 응답 시간이 null이므로, 속도–정확도 상충 분석도, 비정상적으로 빠른 응답의 필터링도 할 수 없어요.
- 인구통계 변수(나이, 모어, 학습 기간, 국가)가 없으므로 층화 분석을 할 수 없어요. 데이터셋에는 모어 필드도 지역 필드도 없으므로, 이 보고서는 학습자의 모어나 거주지에 대해 어떤 추론도 하지 않아요.
- 기간이 12일이므로 학습 곡선 분석도, 기억 유지 분석도 할 수 없어요.
- 학습자 단위 데이터는 공개하지 않으므로(집계만 공개), 외부에서 다층 모형을 다시 적합할 수 없어요. 연구에 이것이 중요하다면 연락해 주세요.
JSON 다운로드 · CSV 다운로드 · 인용 형식 · 전체 방법론
언론 및 데이터 문의
Nihongo to Japan 설립자 · 이메일: [email protected]
다음과 같은 문의에 기꺼이 답해요: 방법론의 세부 사항, 집계 수치의 재확인, 도표 복제 요청, 이 데이터로 뒷받침할 수 있는 범위, 데이터셋이 특정 질문에 답할 수 있는지 여부. 답변은 보통 영업일 기준 2–3일 이내에 드려요. 언론의 게재용 이미지 요청은 우선 창구로 24시간 이내에 답해요(보도 자료 키트 참고).
이 사이트는 1인 개발자가 독립적으로 운영해요. 연구팀도, 홍보 담당자도 없어요. 위 주소로 연락하면 접수 창구가 아니라 이 데이터셋을 실제로 만든 사람에게 닿아요. 데이터를 인용하는 사람에게는 그 뒤에 누가 있는지 알 권리가 있으므로 여기에 밝혀 둬요.
버전 및 변경 이력
이 URL은 항상 가장 최근 스냅샷을 가리켜요. 모든 릴리스에는 버전 번호와 동결일이 붙으므로, 인용할 때 버전을 함께 적어 주세요(예: v1.1.0, 스냅샷 2026-08-14). 나중에 수치가 업데이트되어도 인용한 버전을 식별할 수 있어요. JSON과 CSV 다운로드에도 같은 버전 필드가 들어 있어요.
| 버전 | 스냅샷 동결일 | 대상 기간 | 비고 |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02~10-21(81일) | 별도 URL로 공개된 새 버전(분석 집합이 다름). |
| v1.1.0 | 2026-08-14 | 2026년 8월 2일~13일(12일) | 첫 공개 버전. 주 분석 집합: 테스트 맥락 첫 시도. 네 가지 분석 집합을 모두 나란히 공개. |
다음 릴리스는 약 3개월분의 데이터가 더 쌓인 뒤로 예정되어 있으며, 그때가 비로소 추세를 논할 수 있는 가장 이른 시점이에요. 데이터를 업데이트해도 이미 공개된 버전의 수치를 고쳐 쓰지 않아요. 새 릴리스에는 새 버전 번호와 새 동결일이 붙고, 이전 수치는 버전으로 계속 식별할 수 있어요. 이미 인용한 버전의 수치가 바뀌었다면 연락해 주세요. 무엇이 달라졌는지 정확히 알려 드릴게요.