일본어 학습 응답 집계 데이터셋 — 2026년 10월: 응답 543,344건, 능력 보정 난이도와 복습 간격
한 문장 요약: Nihongo to Japan에서 2026년 8월 2일~10월 21일(81일) 동안 문제 25,850개에 대해 기록된 익명 응답 543,344건의 집계 통계예요. 8월판(v1.1.0)의 9.6배 규모예요.
⚠️ v2와 v1은 분석 집합이 달라요. 두 판의 정답률을 서로 빼서 비교하지 마세요. v1은 데이터베이스에서 직접 계산했으며, 주 분석 집합은 "퀴즈 맥락의 첫 시도"였어요. v2는 누구나 조회할 수 있는 공개 집계 엔드포인트만(/api/aggregates,/api/community) 의도적으로 사용했기 때문에, 주요 지표는 "전체 응답"과 "문항 단위 첫 시도(문제당 1표)"예요. 그 대신 재현성이 높아졌어요. 모든 입력 파일의 sha256이 다운로드 파일에 기록되어 있어, 외부 연구자가 저희가 어떤 데이터를 사용했는지 정확히 검증할 수 있어요. 방법론을 참고하세요.
이 데이터셋이 아닌 것. 이 데이터셋은 일본어 학습자를 대표하는 조사가 아니에요. 표본은 이 웹사이트에서 연습하기로 스스로 선택한 사람들로 이루어진 자기선택 관찰 표본이에요. 모든 수치는 NTJ 응답 기록 안에서 일어난 일만을 설명하며, 어떤 모집단으로도 일반화되지 않고, 어떤 수치도 인과관계를 주장하지 않아요. 한계를 참고하세요.
인용 가능한 핵심 결과 10가지
각 항목은 그 자체로 완결되어 있어요. 데이터셋, 기간, 표본 크기, 분석 집합을 모두 밝히고 있으므로 따로 떼어 인용할 수 있어요. 인용하실 때는 한계도 함께 밝혀 주세요.
- NTJ 일본어 학습 응답 집계 데이터셋(2026년 10월, v2.0.0)에는 2026년 8월 2일부터 10월 21일까지 문제 25,850개에 대해 기록된 익명 응답 543,344건이 담겨 있어요. 이는 같은 사이트의 2026년 8월판 56,613건의 9.6배예요.
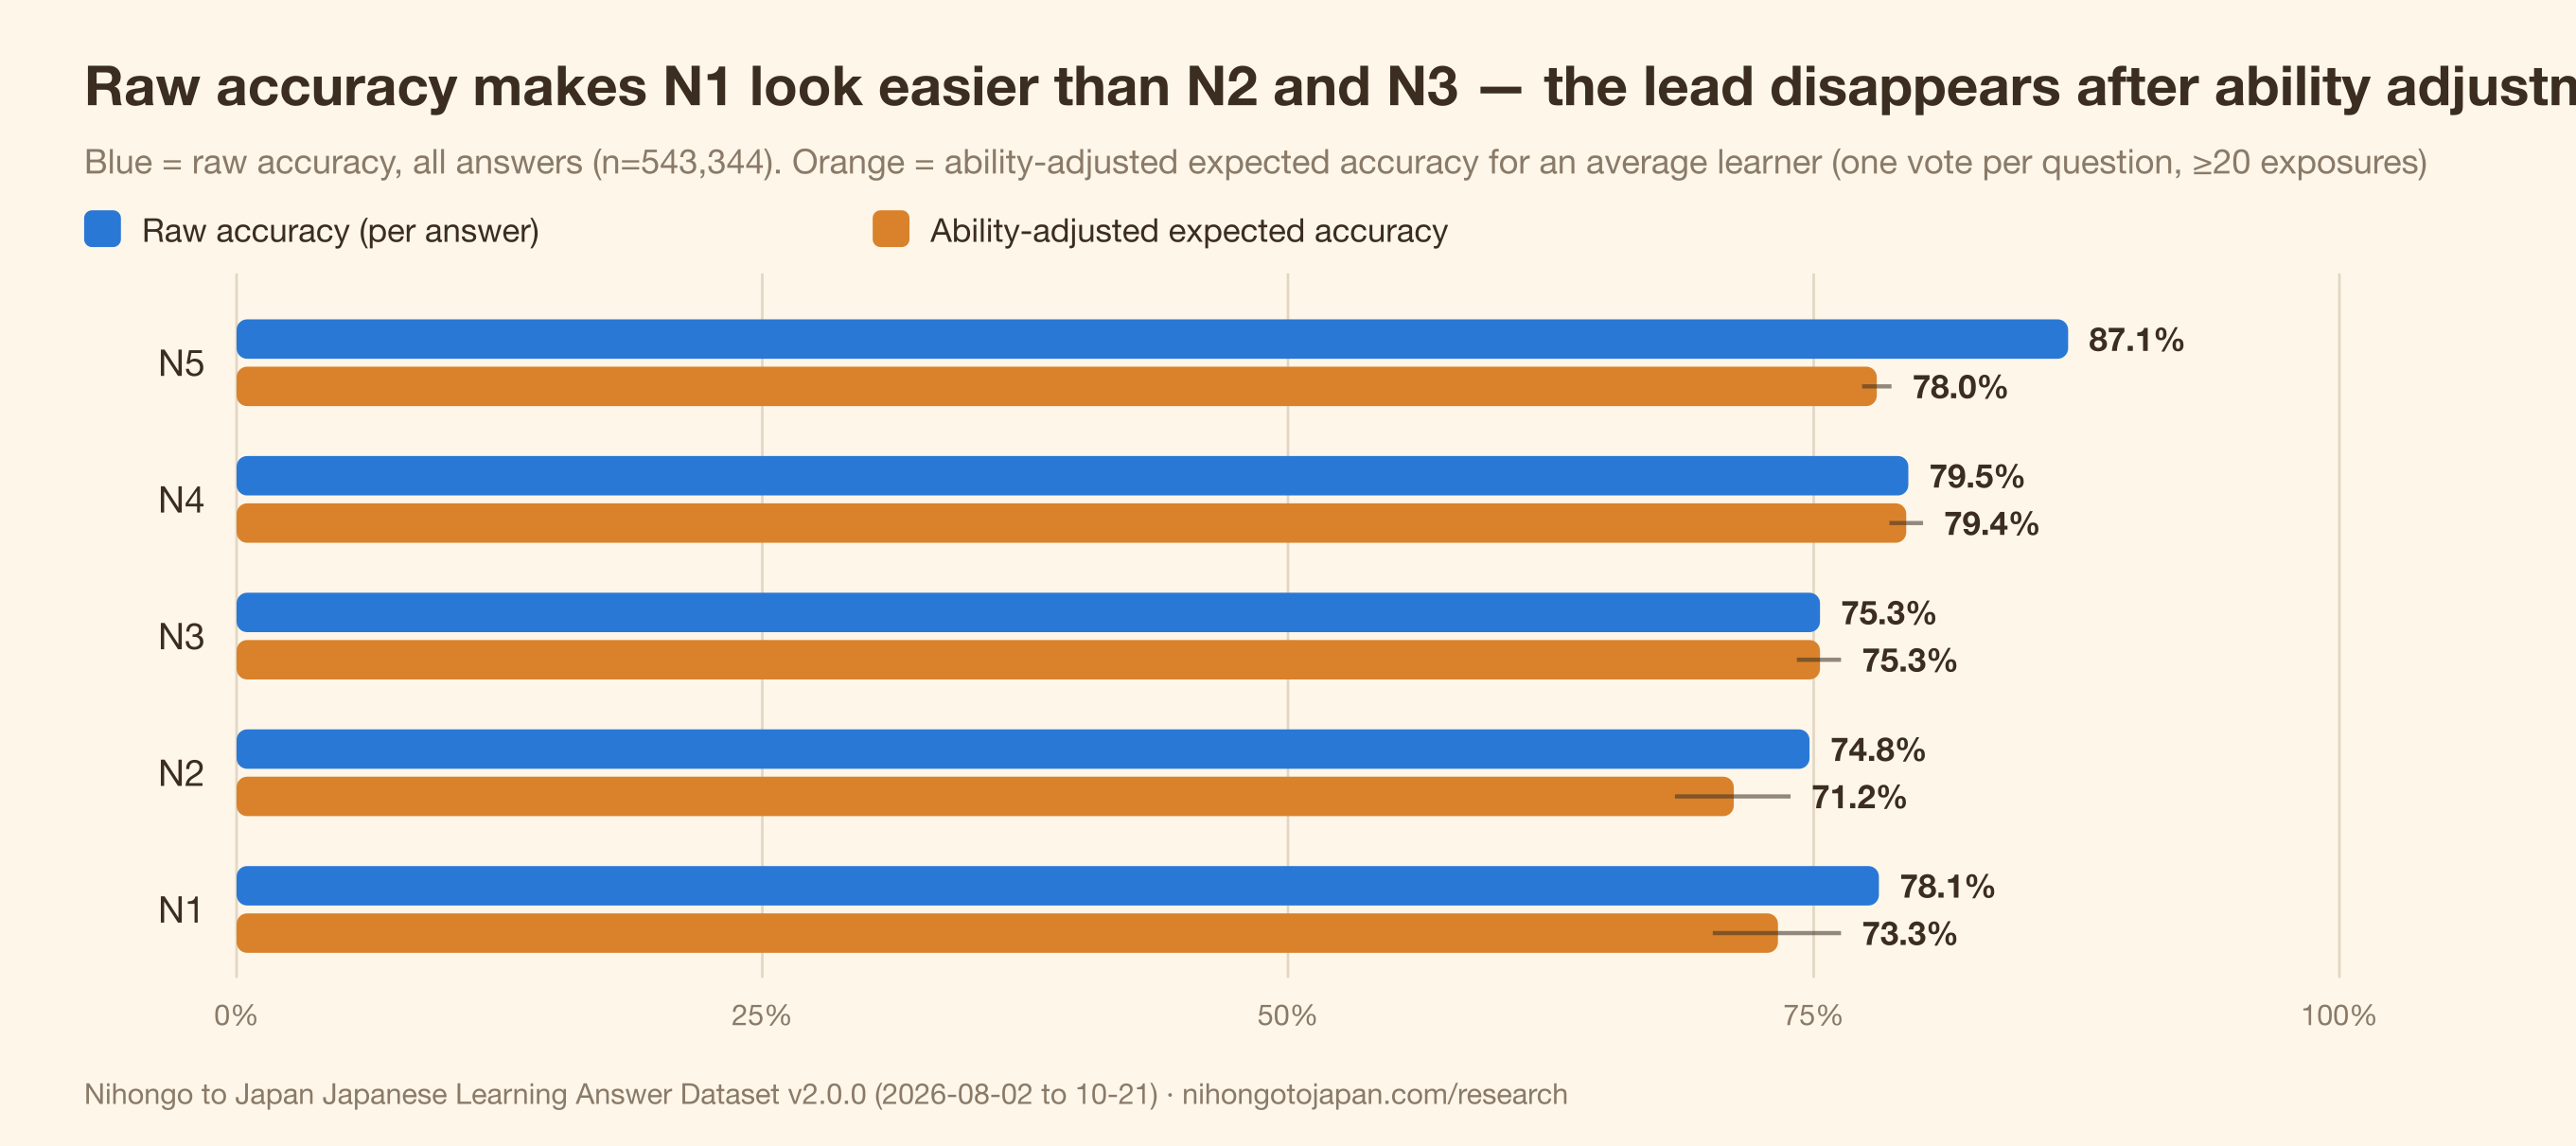
- 같은 데이터셋의 전체 응답 기준 JLPT 레벨별 원 정답률은 N5 87.1%, N4 79.5%, N3 75.3%, N2 74.8%, N1 78.1%(n=33,082)로, N1이 N2와 N3보다 모두 높아요.
- 1단계 Rasch 추정(문제당 1표, 노출 ≥20회)으로 학습자 능력의 영향을 제거하면, 평균적인 학습자의 기대 정답률은 N3 75.3%(95% CI 74.2–76.3%, 847문제), N1 73.3%(70.2–76.3%, 210문제), N2 71.2%(68.4–73.9%, 204문제)예요. N1의 N3 대비 우위는 사라지며, 이는 실력이 더 좋은 학습자가 N1 문제에 도전한다는 선택 효과와 부합해요.
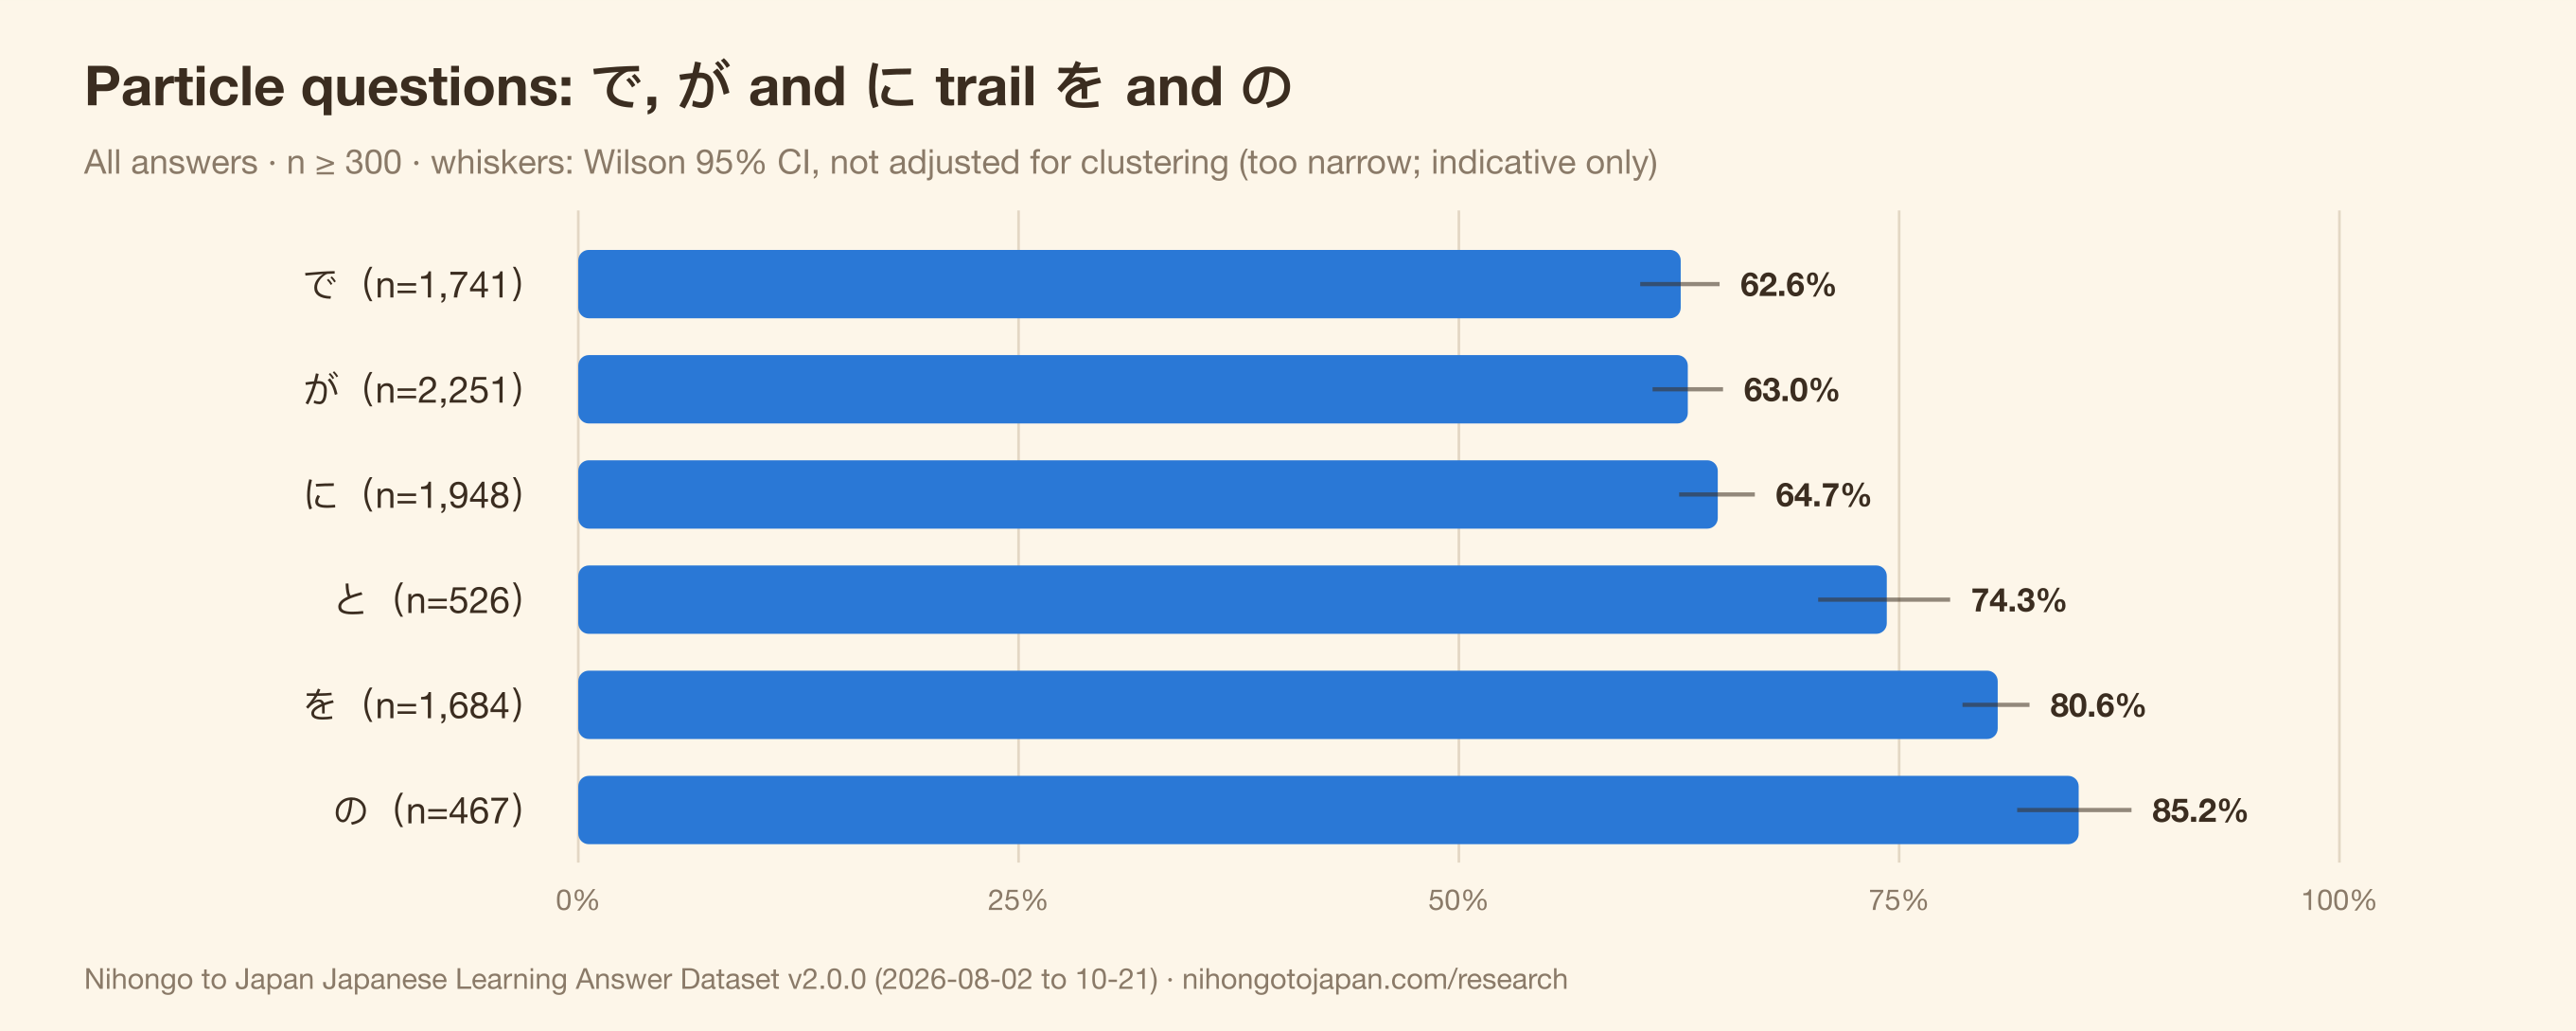
보정 후 N1과 N3의 구간이 겹치므로, N1이 N3보다 어렵다는 뜻은 아니에요. 원래의 순위를 그대로 믿을 수 없다는 것만 보여 줘요. - 전체 응답 기준으로 정답률이 가장 낮은 조사는 で 62.6%(n=1,741), が 63.0%(n=2,251), に 64.7%(n=1,948)이고, 가장 높은 조사는 を 80.6%(n=1,684)와 の 85.2%(n=467)예요. で와 の의 차이는 22.6%포인트예요.
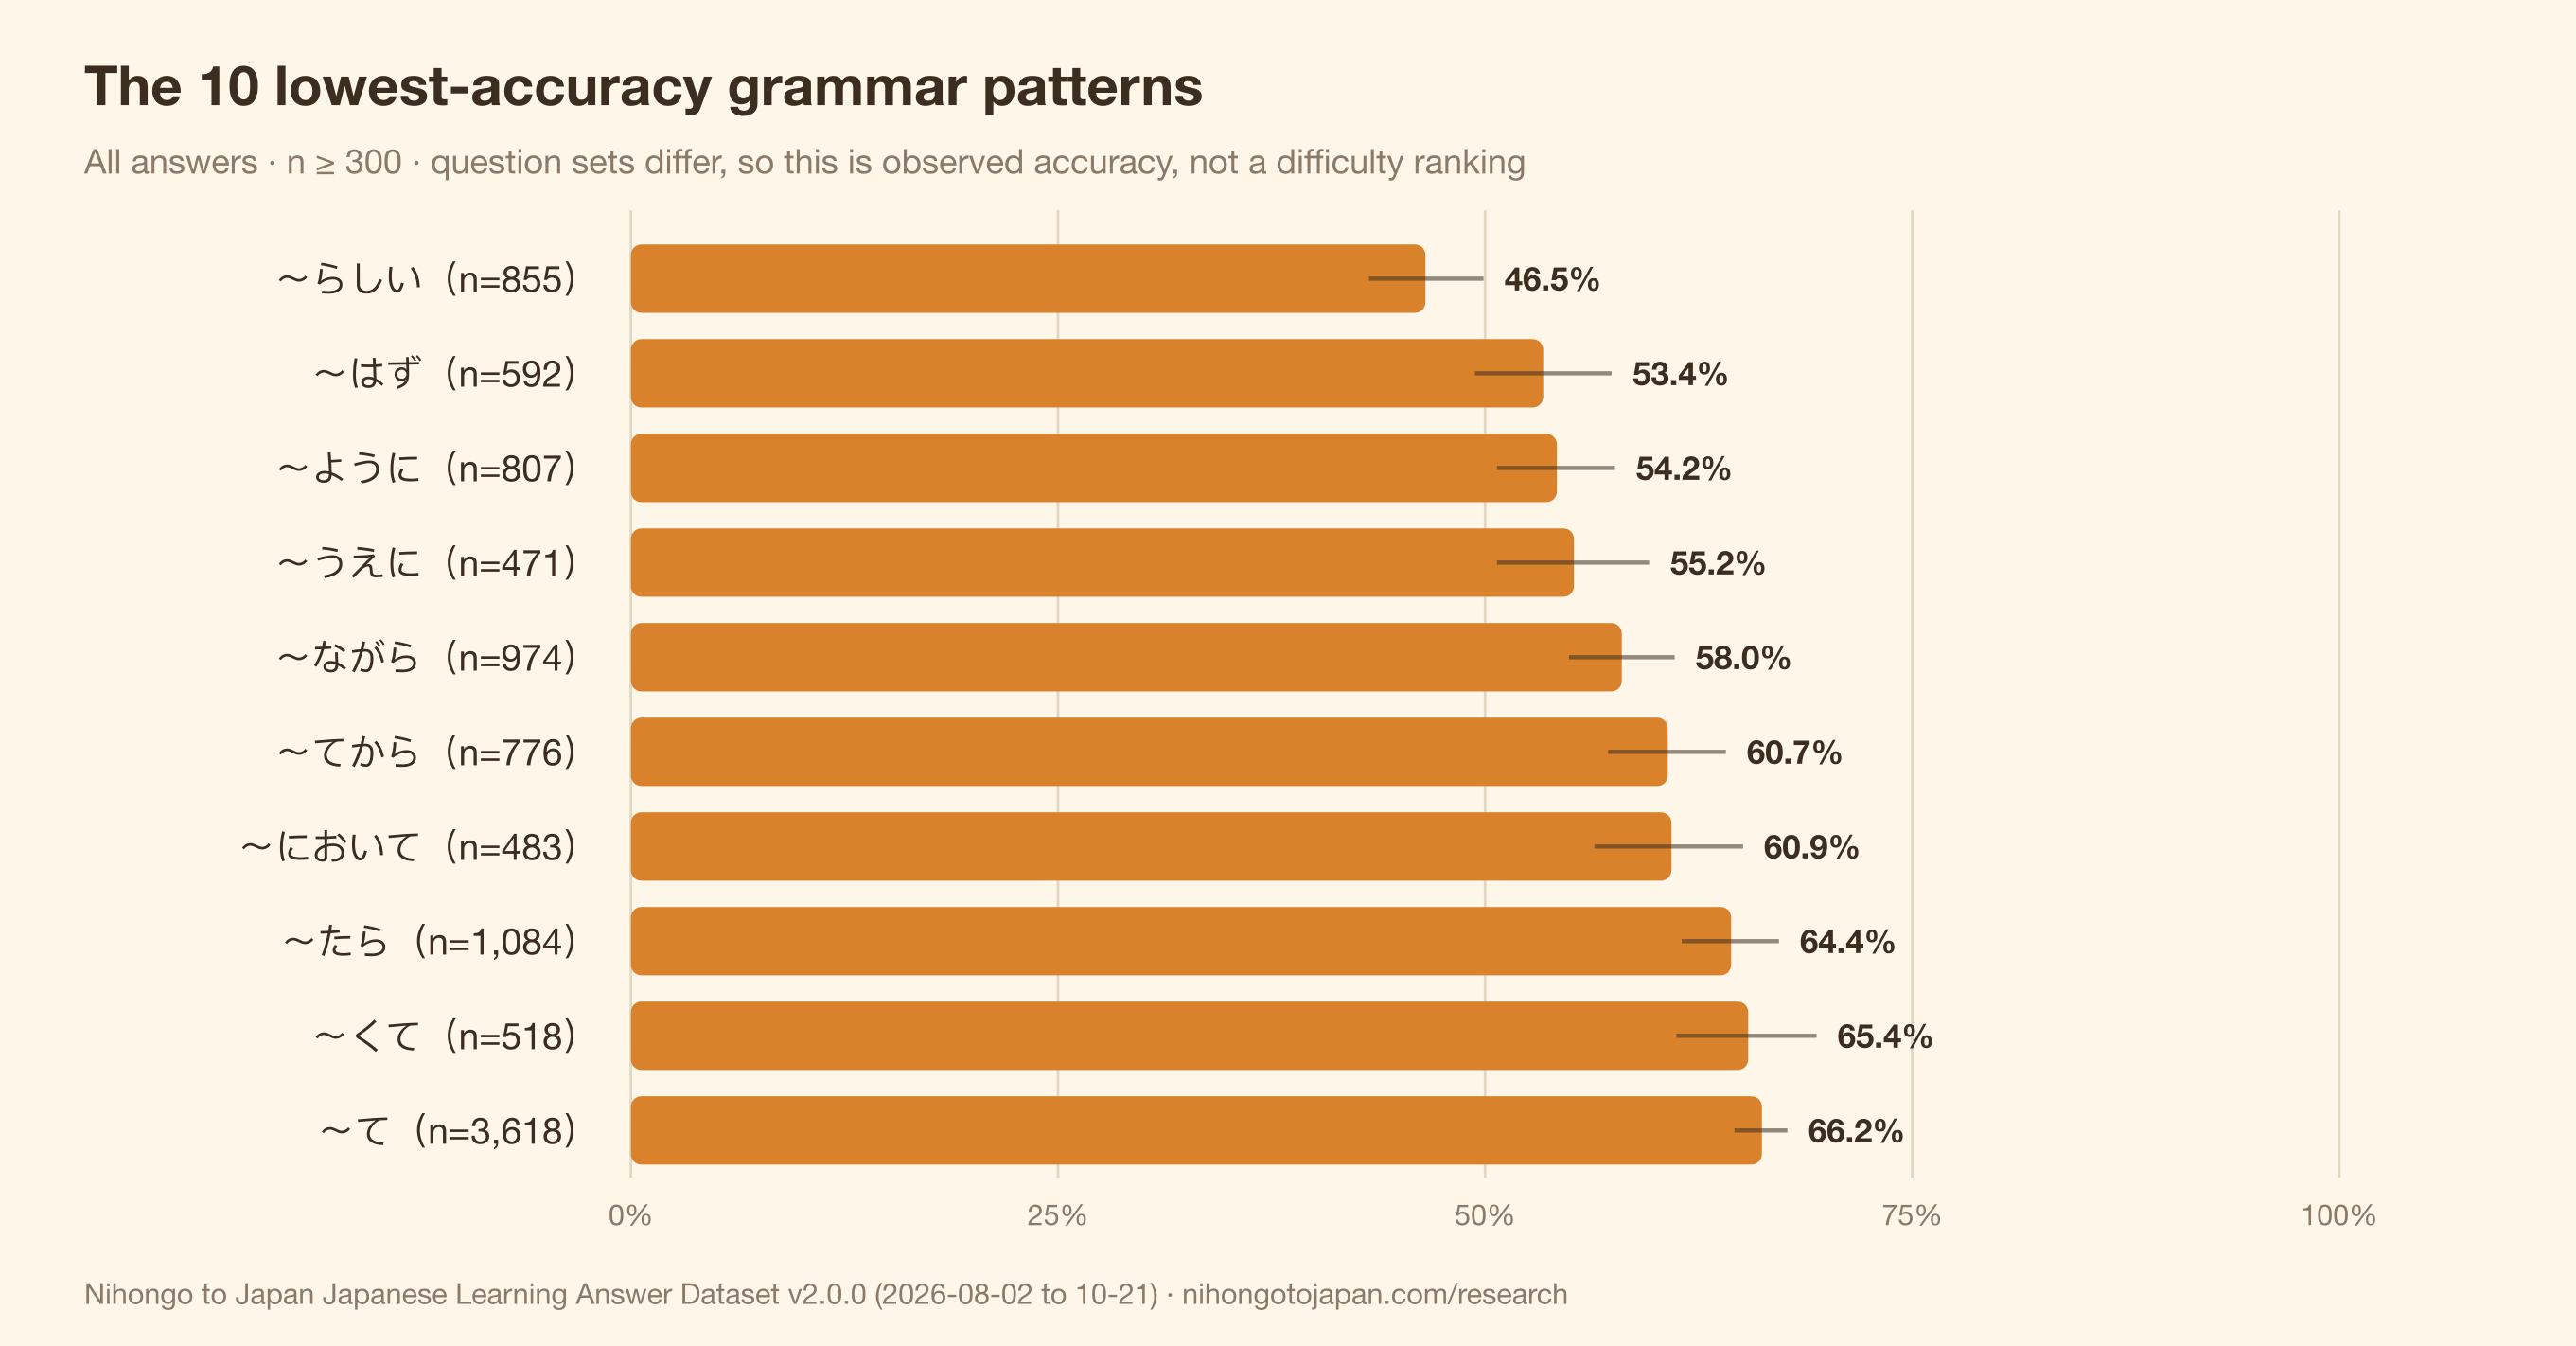
- n ≥ 300인 문형 가운데 전체 응답 정답률이 가장 낮은 것은 〜らしい 46.5%(n=855)이며, 그다음은 〜はず 53.4%(n=592), 〜ように 54.2%(n=807), 〜うえに 55.2%(n=471), 〜ながら 58.0%(n=974) 순이에요.
- 동사 활용형 문제 중에서는 가능형이 64.5%로 가장 낮고(n=1,923), ます형이 84.0%로 가장 높으며(n=2,270), た형 70.7%, て형 74.1%, ない형 75.0%가 그 사이에 있어요.
- 문제당 1표로 계산하면(노출 ≥20회인 7,057문제), 첫 시도 평균 정답률은 어휘 89.1%(95% CI 88.7–89.5%), 문형 73.9%(73.1–74.7%), 조사 67.6%(64.9–70.4%)예요.
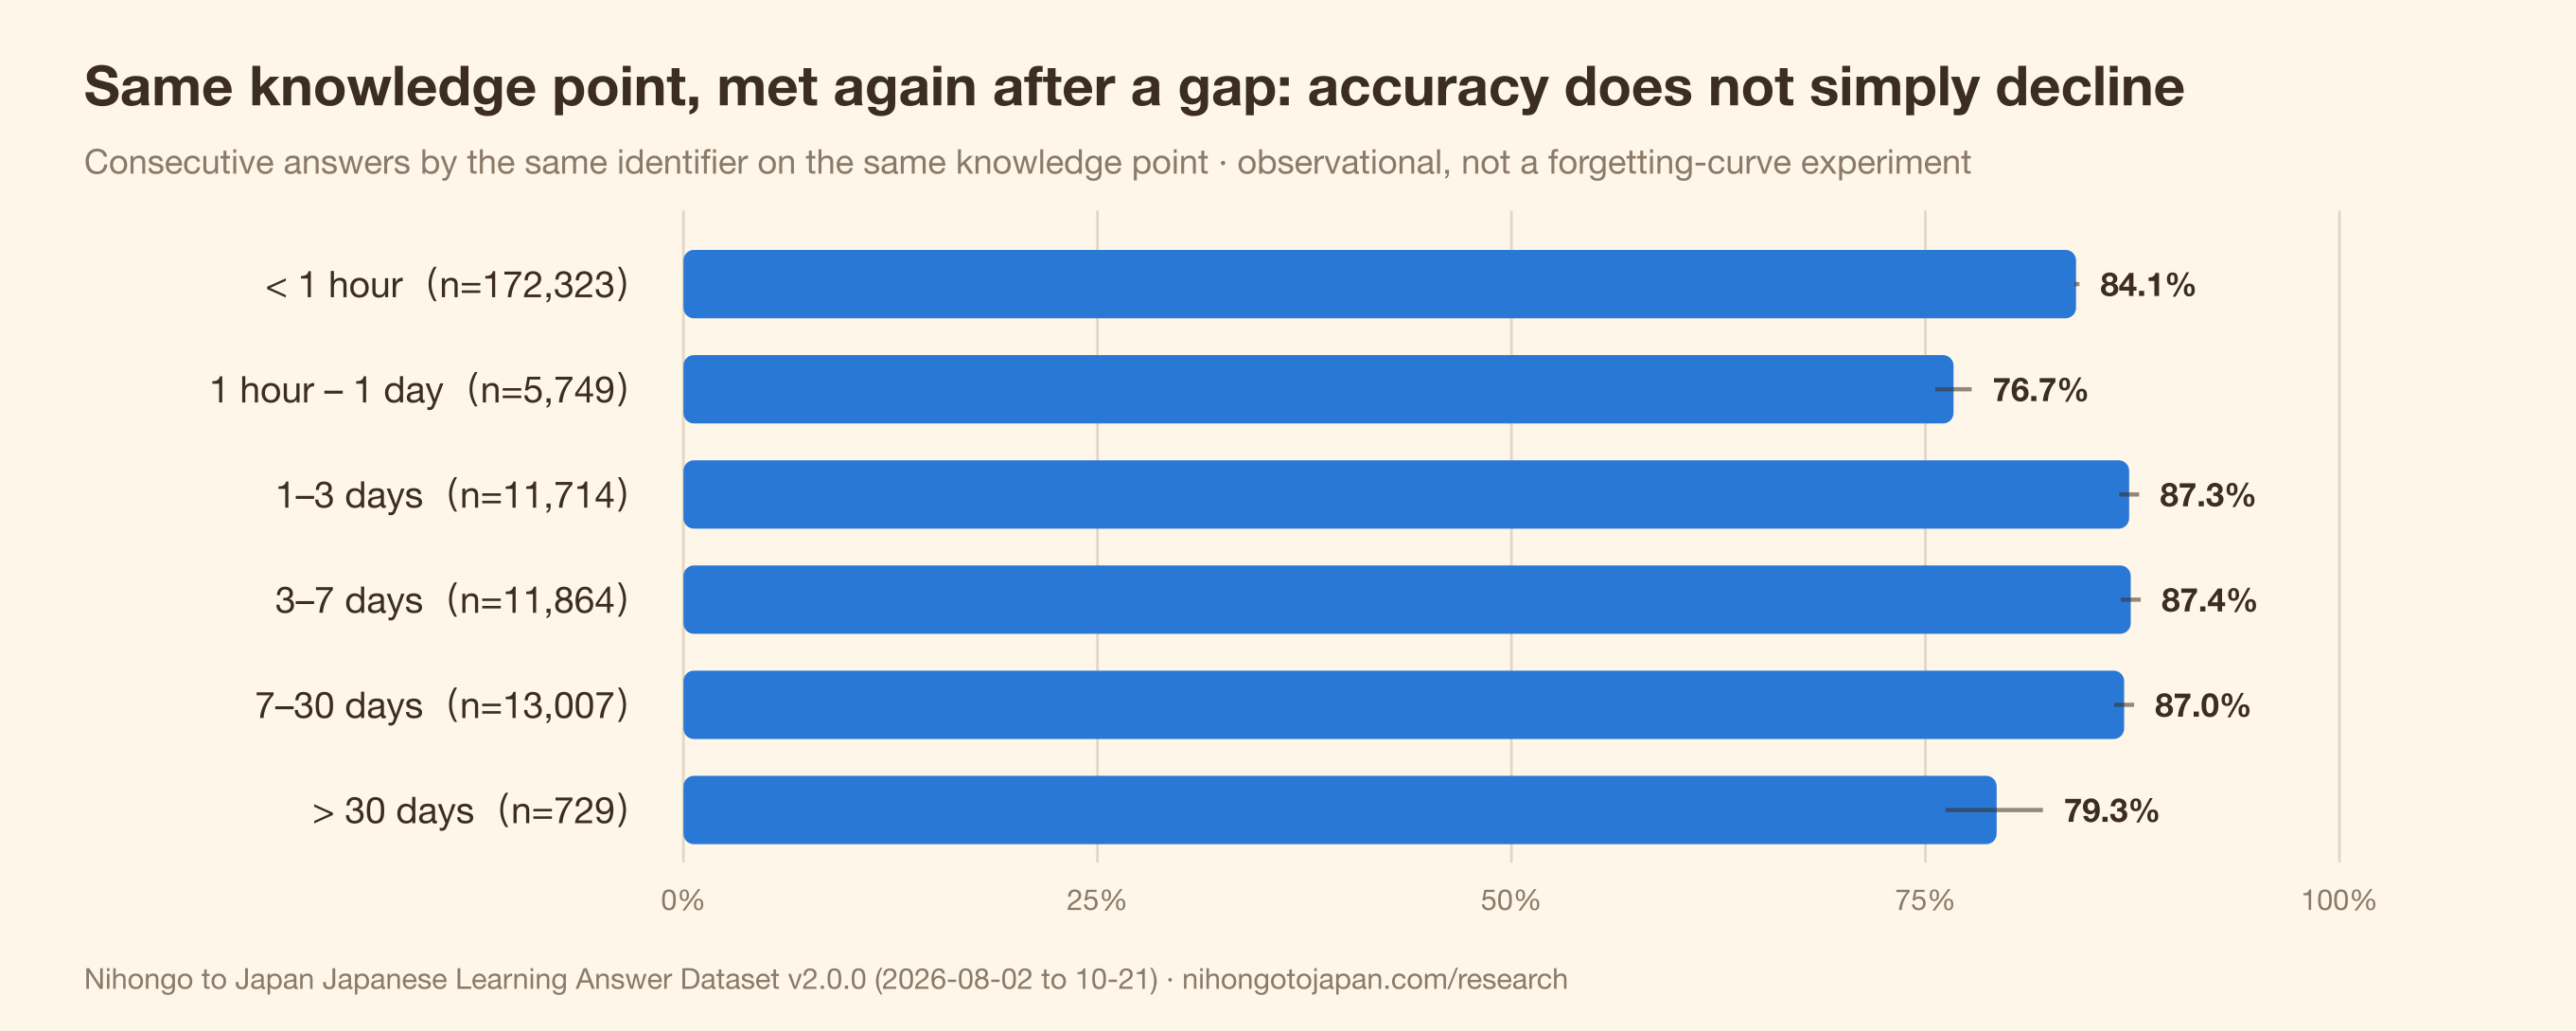
- 같은 식별자가 같은 지식 포인트에 연속으로 응답한 경우, 간격이 1시간 미만이면 정답률 84.1%, 1시간~1일이면 76.7%, 1–3일·3–7일·7–30일이면 87.0–87.4%, 30일 초과면 79.3%(n=729)예요. 정답률은 간격이 길어질수록 단조롭게 떨어지지 않아요.
이는 관찰 결과예요. 며칠 뒤에 돌아오는 사람은 무작위로 정해지지 않아요. 며칠 뒤에 복습하는 것이 가장 효과적이라는 뜻이 아니에요. - 노출 ≥20회인 7,057문제 가운데 283문제(4.0%)는 첫 시도 정답률이 35% 미만이에요(4지선다에서 무작위로 찍으면 약 25%). 흔한 원인은 정답으로 볼 여지가 있는 선택지가 하나 더 있는 경우이며, 이 문제들은 수동 검토 대기열에 올라 있어요.
- 사이트의 정답 예측 모델 v2는 응답 257,010건에서 Brier 점수 0.199를 기록해 v1의 0.409보다 51.4% 낮아졌어요. 하지만 항상 전체 정답률 79.9%를 예측하는 상수 기준선의 0.161보다는 여전히 나빠요. 문항 단위 난이도를 더한 버전(0.130)만이 기준선을 넘어서요.
1. 다섯 가지 주요 결과
1. "N1이 N3보다 쉽다"는 선택 효과가 만든 착시
전체 응답 기준 원 정답률만 보면 N1(78.1%)이 N3(75.3%)과 N2(74.8%)보다 높아요. 이는 상식적으로 말이 되지 않으며, v1에서도 같은 현상이 나타났어요. 가장 그럴듯한 설명은 누가 답하느냐예요. N1 문제를 눌러 들어오는 사람은 이미 실력이 더 좋은 사람들이에요.
v2에서는 능력 보정 난이도로 다시 계산했어요. 각 문제의 관측 결과를 실제로 그 문제에 답한 사람들의 평균 능력으로 보정한 뒤, 평균적인 학습자가 맞힐 확률로 나타낸 것이에요. 보정 후에는 N1의 우위가 사라져요(N3 75.3%, N1 73.3%, N2 71.2%).
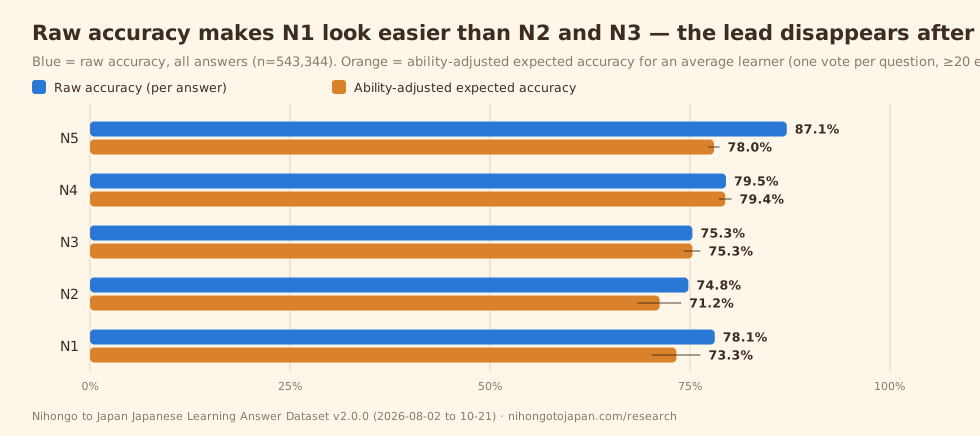
두 가지 단서가 있어요. 첫째, 보정 후에도 N1과 N3의 구간은 여전히 겹치므로 N1이 N3보다 어렵다고 말할 수는 없어요. 둘째, 보정 후 N5(78.0%)는 N4(79.4%)보다 높지 않아요. 보정은 누가 답하는지를 다룰 뿐, 각 레벨에 어떤 문제가 들어 있는지는 다루지 않기 때문이에요. 분석에 포함된 N5 문제의 53%가 문형 문제인 반면 N4는 33%이며, 문형 문제는 어휘 문제보다 맞히기 어려워요.
2. 조사 간 격차: で, が, に는 を, の보다 약 20%포인트 낮다
で(62.6%), が(63.0%), に(64.7%)는 を(80.6%), の(85.2%)보다 20%포인트 가까이 낮아요. 낮은 세 조사의 공통점은 조사 하나에 용법이 여러 개라는 것이에요. で는 장소·수단·원인·범위를, に는 시간·도착점·대상·목적을 나타내요.
이는 v1의 결과("조사 안에서의 격차가 레벨 간 격차보다 크다")와 일치하며, v2는 표본이 커서 그 방향이 더 안정적이에요.
3. 가장 어려운 문형은 추측, 그리고 목적·상태 표현에 몰려 있다
정답률이 가장 낮은 다섯 문형 중 〜らしい(46.5%)와 〜はず(53.4%)는 모두 추측이나 예상을 나타내며 〜そう, 〜よう, 〜みたい와 혼동하기 쉬워요. 〜ように(54.2%)는 목적, 변화, 요청을 아우르고, 〜ながら(58.0%)는 〜て, 〜まま와 자주 헷갈려요.
동사 활용형에서도 비슷한 구조가 보여요. 가능형(64.5%)이 다섯 가지 중 가장 낮아요. 가능형은 1단 동사, 5단 동사, 불규칙 동사마다 규칙이 다르고, 학습자는 구어에서 ら가 빠진 형태(ら抜き)도 접하게 돼요.
4. 간격을 둔 뒤의 정답률은 단순히 떨어지지 않는다
같은 식별자가 같은 지식 포인트에 연속으로 응답한 쌍을 간격별로 묶은 결과예요.
| 간격 | 응답 수 | 식별자 수 | 정답률 |
|---|---|---|---|
| < 1시간 | 172,323 | 3,472 | 84.1% |
| 1시간 – 1일 | 5,749 | 647 | 76.7% |
| 1–3일 | 11,714 | 532 | 87.3% |
| 3–7일 | 11,864 | 449 | 87.4% |
| 7–30일 | 13,007 | 405 | 87.0% |
| > 30일 | 729 | 126 | 79.3% |
교과서적인 망각 곡선에 따르면 간격이 길수록 더 많이 잊어요. 그러나 여기서는 1시간~1일 구간이 가장 낮고 1~30일 구간이 가장 높아요. 저희는 이를 "며칠 뒤에 복습하는 것이 가장 효과적"이라고 해석하지 않아요. 며칠 뒤에 돌아오는 사람은 무작위가 아니며, 다시 돌아오는 학습자는 더 열심이고 실력도 더 좋을 수 있어요. 1시간~1일 구간은 식별자가 647개뿐이며, 같은 날 두 번째 기기로 같은 세트를 다시 푼 사람이 섞여 있을 수 있어요. 복습 간격에 관한 질문에 답하려면 무작위 실험이 필요하며, 이 데이터셋으로는 불가능해요.
5. 예측 모델은 오차를 절반으로 줄였지만, 가장 단순한 기준선은 아직 넘지 못했다
사이트의 문제 추천 기능은 먼저 사용자가 정답을 맞힐 확률을 예측해요. 저희는 이를 Brier 점수(예측 확률과 실제 결과의 차이를 제곱해 평균한 값, 낮을수록 좋음)로 평가해요.
- v1 모델: 0.409
- v2 모델: 0.199(51.4% 감소)
- 문항 단위 난이도를 더한 v2: 0.130(68.1% 감소)
- 참고: 항상 전체 정답률 79.9%를 예측하는 상수 기준선: 0.161
v2는 v1의 오차를 절반으로 줄였지만 전체적으로는 여전히 상수 기준선에 뒤져요. 문항 단위 난이도를 더해야만 기준선을 넘어서요. 저희가 이 결과를 공개하는 이유는, 학습자의 레벨보다 문제 자체의 난이도가 정답 여부를 더 잘 예측한다는 점을 직접 보여 주기 때문이에요. 결과 1에서 능력 보정이 필요한 이유도 바로 이것이에요.
2. 데이터셋 개요
| 항목 | 값 | 비고 |
|---|---|---|
| 유효 응답 | 543,344 | 집계 스냅샷 2026-10-21 19:18 UTC, all_clean_events 범위(사이트 정제 규칙 적용) |
| 학습자 식별자(A등급 응답 ≥1건) | 5,410 | 집계 엔드포인트의 totalUsers |
| 학습자 식별자(전체) | 8,073 | 커뮤니티 엔드포인트. 실제 인원의 상한값 |
| 응답이 있는 문제 | 25,850 | 그중 노출 ≥20회인 7,057문제가 문항 단위 분석에 포함됨 |
| 보정 난이도가 산출된 문제 | 18,139 | 경험적 베이즈 수축을 적용한 1단계 Rasch 추정 |
| 증거 등급 | A 59.8% · B 33.5% · C 6.7% | A = 퀴즈 맥락, B = 교재 연습, C = 기타(v1과 동일) |
| 대상 기간 | 2026-08-02 ~ 10-21 | 81일 |
실시간 카운터에 관하여: 홈페이지의 "NTJ 학습자들이 완료한 연습 응답 552,850건"은 2026-10-23 시점 커뮤니티 엔드포인트의 실시간 수치로, 이 데이터셋보다 약 9,500건 많아요. 스냅샷 이후 이틀 동안 늘어난 응답이에요. 인용하실 때는 543,344건을 사용해 주세요.
3. 능력 축(전체 응답)
| 축 | 응답 수 | 정답률 | 문항 단위 첫 시도(문제 수) |
|---|---|---|---|
| 어휘 | 267,127 | 90.1% | 89.1% (3,398) |
| 문형 | 234,602 | 75.2% | 73.9% (3,252) |
| 동사 활용형 | 18,479 | 75.2% | 76.2% (154) |
| 조사 | 13,870 | 71.3% | 67.6% (189) |
| 관용구 | 7,413 | 88.1% | 92.4% (64) |
| 독해 | 1,103 | 78.7% | — |
| 청해 | 605 | 69.8% | — |
| 말하기 | 118 | SUPPRESSED | — |
독해, 청해, 말하기는 새로 추가된 문제 유형이라 표본이 작아요. 말하기는 응답 300건 기준에 못 미쳐 응답 수만 보고해요(SUPPRESSED = 비공개).
4. JLPT 레벨
| 레벨 | 전체 응답 정답률(n) | 문항 단위 첫 시도(문제 수) | 능력 보정 기대 정답률(95% CI) |
|---|---|---|---|
| N5 | 87.1% (297,809) | 82.6% (3,817) | 78.0% (77.3–78.7%) |
| N4 | 79.5% (93,609) | 84.5% (1,766) | 79.4% (78.6–80.2%) |
| N3 | 75.3% (82,010) | 75.7% (1,008) | 75.3% (74.2–76.3%) |
| N2 | 74.8% (36,837) | 66.9% (249) | 71.2% (68.4–73.9%) |
| N1 | 78.1% (33,082) | 74.2% (217) | 73.3% (70.2–76.3%) |
세 열은 서로 다른 분석 집합을 사용하므로, 열 안에서만 비교하고 열끼리는 비교하지 마세요. 1열은 반복 응답을 포함한 모든 응답을 세며 레벨별 문제 유형 구성에 영향을 받아요. 2열은 문제마다 1표를 부여해요. 3열은 여기에 더해 학습자 능력의 영향을 제거해요.
5. 문항 품질: 저희 문제은행도 측정 대상이에요
| 첫 시도 정답률 | 문제 수 |
|---|---|
| < 35% | 283 |
| 35–50% | 377 |
| 50–70% | 971 |
| 70–85% | 1,347 |
| 85–95% | 1,937 |
| ≥ 95% | 2,142 |
35% 미만인 283문제(4.0%)가 반드시 나쁜 문제인 것은 아니에요. 단순히 어려운 문제도 있어요. 다만 8월에 실시한 수동 검토에서, 이 구간에는 정답으로 볼 여지가 있는 선택지가 하나 더 있는 경우가 많았어요(예: 「ピアノ_弾けます」에서는 が와 を 모두 성립). 시스템은 변별도가 뚜렷하게 음수인 경우 등의 기준으로 415문제에 검토 표시를 달아 두었어요. 이 표시의 정밀도는 약 0.19로, 나쁜 문제 목록이 아니라 검토 대기열이에요.
6. 교사와 교재 개발자를 위한 활용법
- 조사: で, が, に는 を, の보다 약 20%포인트 낮아요. 조사를 통째로 반복 연습하기보다, 용법 하나하나를 각각의 예문으로 연습하는 편이 더 효과적으로 겨냥할 수 있어요.
- 추측 표현: 이 데이터에서 〜らしい와 〜はず는 가장 자주 틀리는 문형이에요. 〜そう, 〜よう, 〜みたい와 대조해 가르쳐 보세요.
- 가능형: 다섯 가지 동사 활용형 중 가장 낮아요. 동사 그룹별로 나누어 따로 연습하세요.
- 자체 데이터를 읽을 때: 여러분의 플랫폼에서도 상급 문제가 중급 문제보다 정답률이 높게 나온다면, 문제를 의심하기 전에 먼저 선택 효과를 의심해 보세요.
7. 방법론
출처와 재현성
v2의 모든 수치는 2026-10-23에 조회해 고정한 공개 엔드포인트 6개에서 나왔어요: /api/aggregates?kind=summary, kind=items, kind=difficulty, kind=spacing, kind=brier, /api/community?kind=overview. 각 엔드포인트의 스냅샷 시각과 각 입력 파일의 sha256은 JSON 다운로드 파일의 dataset.source_snapshot_at_utc와 dataset.input_sha256에 기록되어 있어요. 빌드 스크립트 scripts/build-research-dataset-2026-10.py는 학습자 단위 데이터에 접근하지 않아요.
다섯 가지 분석 집합
- 전체 응답(능력 축, 레벨, 지식 포인트): 같은 식별자의 반복 응답을 포함해 모든 유효 응답을 세어요.
- 문항 단위 첫 시도: 문제마다 각 식별자의 첫 시도 정답률을 구한 뒤, 문제 간에 평균해요. 노출 ≥20회인 문제만 포함하며, 95% CI는 문제를 단위로 계산해요.
- 능력 보정 난이도: 1단계 Rasch 추정 b̂ = θ̄(실제 응답자의 평균 능력) − logit(p̂)를 가중치 n/(n+5)로 축 평균 쪽으로 수축시킨 뒤, 사이트 전체 평균 능력을 가진 학습자의 기대 오답률로 변환해요. 보고하는 값은 1 − 기대 오답률이에요.
- 연속 응답 쌍(복습 간격): 같은 식별자가 같은 지식 포인트에 연속으로 한 응답이며, 증거 등급 A와 B만 포함해요.
- 예측 정확도: v1과 v2 예측값이 모두 기록된 A등급 응답 전체(예측 필드는 2026-08-20부터 존재).
최소 셀 크기
이벤트 단위 셀은 n < 300이면 공개하지 않아요. 지식 포인트는 n ≥ 300인 것만 표시하고, 문항 단위 분석에는 노출 ≥20회인 문제만 포함해요.
신뢰구간
이벤트 단위 Wilson 95% CI는 같은 식별자의 반복 응답을 보정하지 않았어요(공개 엔드포인트가 식별자 단위 데이터를 제공하지 않기 때문). 따라서 실제보다 좁으며 참고용이에요. 문항 단위 CI는 문제를 표집 단위로 보므로, 학습자 모집단이 아니라 이 문제은행을 설명해요.
익명성
공개 엔드포인트는 집계값만 반환해요. 이 데이터셋에는 원시 응답 이벤트, 식별자, 이벤트 단위 타임스탬프가 전혀 포함되어 있지 않아요.
8. 한계(수치와 함께 인용해 주세요)
- NTJ에서 연습하는 사람들로 이루어진 자기선택 관찰 표본이며, 어떤 학습자 모집단도 대표하지 않아요.
- 식별자는 사람이 아니에요: 익명 브라우저 식별자는 기기 간에 통합할 수 없으므로, 8,073은 상한값이에요.
- 문제 구성이 달라요: 레벨, 능력 축, 지식 포인트마다 서로 다른 문제를 사용하므로, 정답률 차이는 난이도 순위가 아니에요.
- 전체 응답 기준 수치는 반복 연습으로 인해 부풀려져 있어요.
- 능력 보정에는 가정이 있어요: Rasch 모델은 능력이 단일 차원이라고 가정하며, 능력은 응답이 충분한 식별자에 대해서만 추정돼요.
- 이벤트 단위 CI는 실제보다 좁아요(방법론 참고).
- 문제 목록 절단:
kind=items는 노출 수 내림차순으로 최대 25,000문제(전체 25,850문제 중)까지만 반환해요. 빠진 850문제는 노출이 가장 적은 문제들로, 노출 ≥20회 분석에는 영향을 주지 않아요. - 상위 100개 지식 포인트만 포함: 집계 엔드포인트는 응답이 가장 많은 지식 포인트 100개만 반환해요.
- 응답 시간은 사용할 수 없어요: 열어 둔 채 방치된 탭 때문에 평균이 부풀려지므로, 응답 시간은 보고하지 않아요.
- 이 리포트의 어디에서도 인과관계를 주장하지 않아요.
9. 인용 방법
논문, 보고서, 교재, 보도에서 이 데이터셋을 자유롭게 인용하실 수 있어요. 출처를 밝히고, 버전을 명시하고, 이 페이지로 링크해 주세요.
APA (제7판)
Nihongo to Japan. (2026). Japanese learning answer dataset — October 2026 (Version 2.0.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026-10MLA (제9판)
Nihongo to Japan. Japanese Learning Answer Dataset — October 2026. Version 2.0.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10.BibTeX
@misc{ntj_jlad_2026_10,

  title = {Japanese Learning Answer Dataset --- October 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {2.0.0},

  note = {Snapshot 2026-10-21; aggregate statistics from 543,344 anonymous answer events, 2 August -- 21 October 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026-10}

}
라이선스: 데이터는 CC BY 4.0
이 데이터셋의 데이터는 크리에이티브 커먼즈 저작자표시 4.0 국제 라이선스(CC BY 4.0)로 공개해요. 적절한 출처를 표시하고 변경 여부를 밝히기만 하면, 상업적 이용을 포함해 복제, 재배포, 변형, 2차 활용을 할 수 있어요.
⚠️ 라이선스는 데이터에만 적용돼요: 이 페이지의 집계 수치와 다운로드 파일 2개japanese-learning-2026-10.json,japanese-learning-2026-10.csv가 대상이에요. 저희가 만든 도표(SVG/PNG)와 리포트 본문은 포함되지 않으며, 모든 권리를 보유해요.
출처 표시
Nihongo to Japan, Japanese Learning Answer Dataset — October 2026, v2.0.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10저희의 부탁(라이선스 조건은 아니에요)
- 한계를 함께 밝혀 주세요: 자기선택 표본이며, 관찰 데이터이고, 대표성이 없어요.
- 분석 집합을 명시해 주세요: 전체 응답, 문항 단위 첫 시도, 능력 보정 수치는 서로 크게 달라요.
- "사람"이 아니라 "학습자 식별자"라고 써 주세요.
- 버전을 밝혀 주세요(v2.0.0, 스냅샷 2026-10-21).
⚠️ CC BY는 철회할 수 없어요. 이 조건으로 데이터를 받은 사람은, 나중에 저희가 조건을 바꾸더라도 그 권리를 계속 유지해요.
10. 다운로드
- japanese-learning-2026-10.json — 전체 메타데이터, 입력 sha256, 기준값, 모든 집계 셀.
- japanese-learning-2026-10.csv — 셀 하나당 한 행. 열:
table, key, n, value, ci95_low, ci95_high, unit, note. - japanese-learning-2026-10-LICENSE.txt — 라이선스 고지.
도표 파일(2배 해상도 PNG, 확대 가능한 SVG. 도표는 CC BY 대상이 아니므로 전재하시려면 먼저 연락해 주세요):
모든 도표의 대체 텍스트는 alt-text.json에 있어요.
언론 및 데이터 문의
더 세분화된 분석, 오류로 의심되는 부분, 어떤 수치를 인용해야 할지에 대한 문의는 제목에 "Dataset v2.0.0"을 넣어 [email protected]으로 이메일을 보내 주세요.
버전 기록
| 버전 | 스냅샷 | 대상 기간 | 비고 |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 ~ 10-21(81일) | 이 페이지. 공개 집계 엔드포인트로 산출했으며, 능력 보정 난이도, 복습 간격, 문항 품질, 예측 정확도를 추가했어요. |
| v1.1.0 | 2026-08-14 | 2026-08-02 ~ 08-13(12일) | 첫 공개판. 주 분석 집합은 "퀴즈 맥락의 첫 시도". 수치는 변경되지 않았으며 지금도 인용할 수 있어요. |
공개된 수치는 절대 고쳐 쓰지 않아요. ← 연구와 데이터 | 교육자·도서관을 위한 안내