Conjunto de datos de respuestas de aprendizaje de japonés — agosto de 2026: porcentaje de acierto en 56.613 respuestas anónimas (instantánea de 12 días)
📢 Hay una versión más reciente: Conjunto de datos de respuestas de aprendizaje de japonés — octubre de 2026 (v2.0.0, 543.344 respuestas). La v2 usa conjuntos de análisis distintos, así que sus cifras no se pueden restar de las de esta página; las cifras de la v1.1.0 que aparecen aquí no han cambiado y siguen siendo citables.
En una frase: estadísticas agregadas de 56.613 eventos de respuesta anónimos en Nihongo to Japan, aportados por 1.053 identificadores anónimos de estudiante sobre 11.987 preguntas.
⚠️ Esto es una instantánea de agosto de 2026, no un estudio de todo el año 2026. Los datos abarcan del 2 al 13 de agosto de 2026, doce días en total (el proceso de agregación entró en funcionamiento el 2 de agosto; el primer día está incompleto). De estos datos no se puede extraer ninguna tendencia longitudinal. Versión 1.1.0, instantánea congelada el 2026-08-14.
Sobre los «identificadores de estudiante»: son identificadores anónimos generados al azar en el navegador y no se pueden unificar entre dispositivos. Una persona que use un móvil y un portátil genera dos identificadores, de modo que 1.053 no es un recuento verificado de personas distintas, sino un límite superior. Por eso esta página habla siempre de «identificadores de estudiante» y no de «personas».
Lo que esto no es. No es una encuesta representativa de quienes estudian japonés en Taiwán ni en ningún otro lugar. La muestra está formada por personas que eligieron practicar en este sitio: una muestra observacional y autoseleccionada. Cada cifra describe lo que ocurrió en este conjunto de respuestas y no puede extrapolarse a ninguna población. Consulta las limitaciones.
Diez hallazgos que se pueden citar directamente
Cada punto de la lista es autónomo: la propia frase incluye el nombre del conjunto de datos, el periodo de la instantánea, el tamaño de la muestra y el intervalo de confianza, de modo que periodistas e investigadores pueden copiar cualquier punto suelto sin tener que volver a buscar el contexto. Todas las cifras son valores observados dentro de este conjunto de datos (el conjunto de análisis principal son los primeros intentos en contexto de cuestionario; consulta la metodología), no inferencias sobre la población de estudiantes de japonés, y no se afirma ninguna relación causal. Cita las limitaciones junto con las cifras.
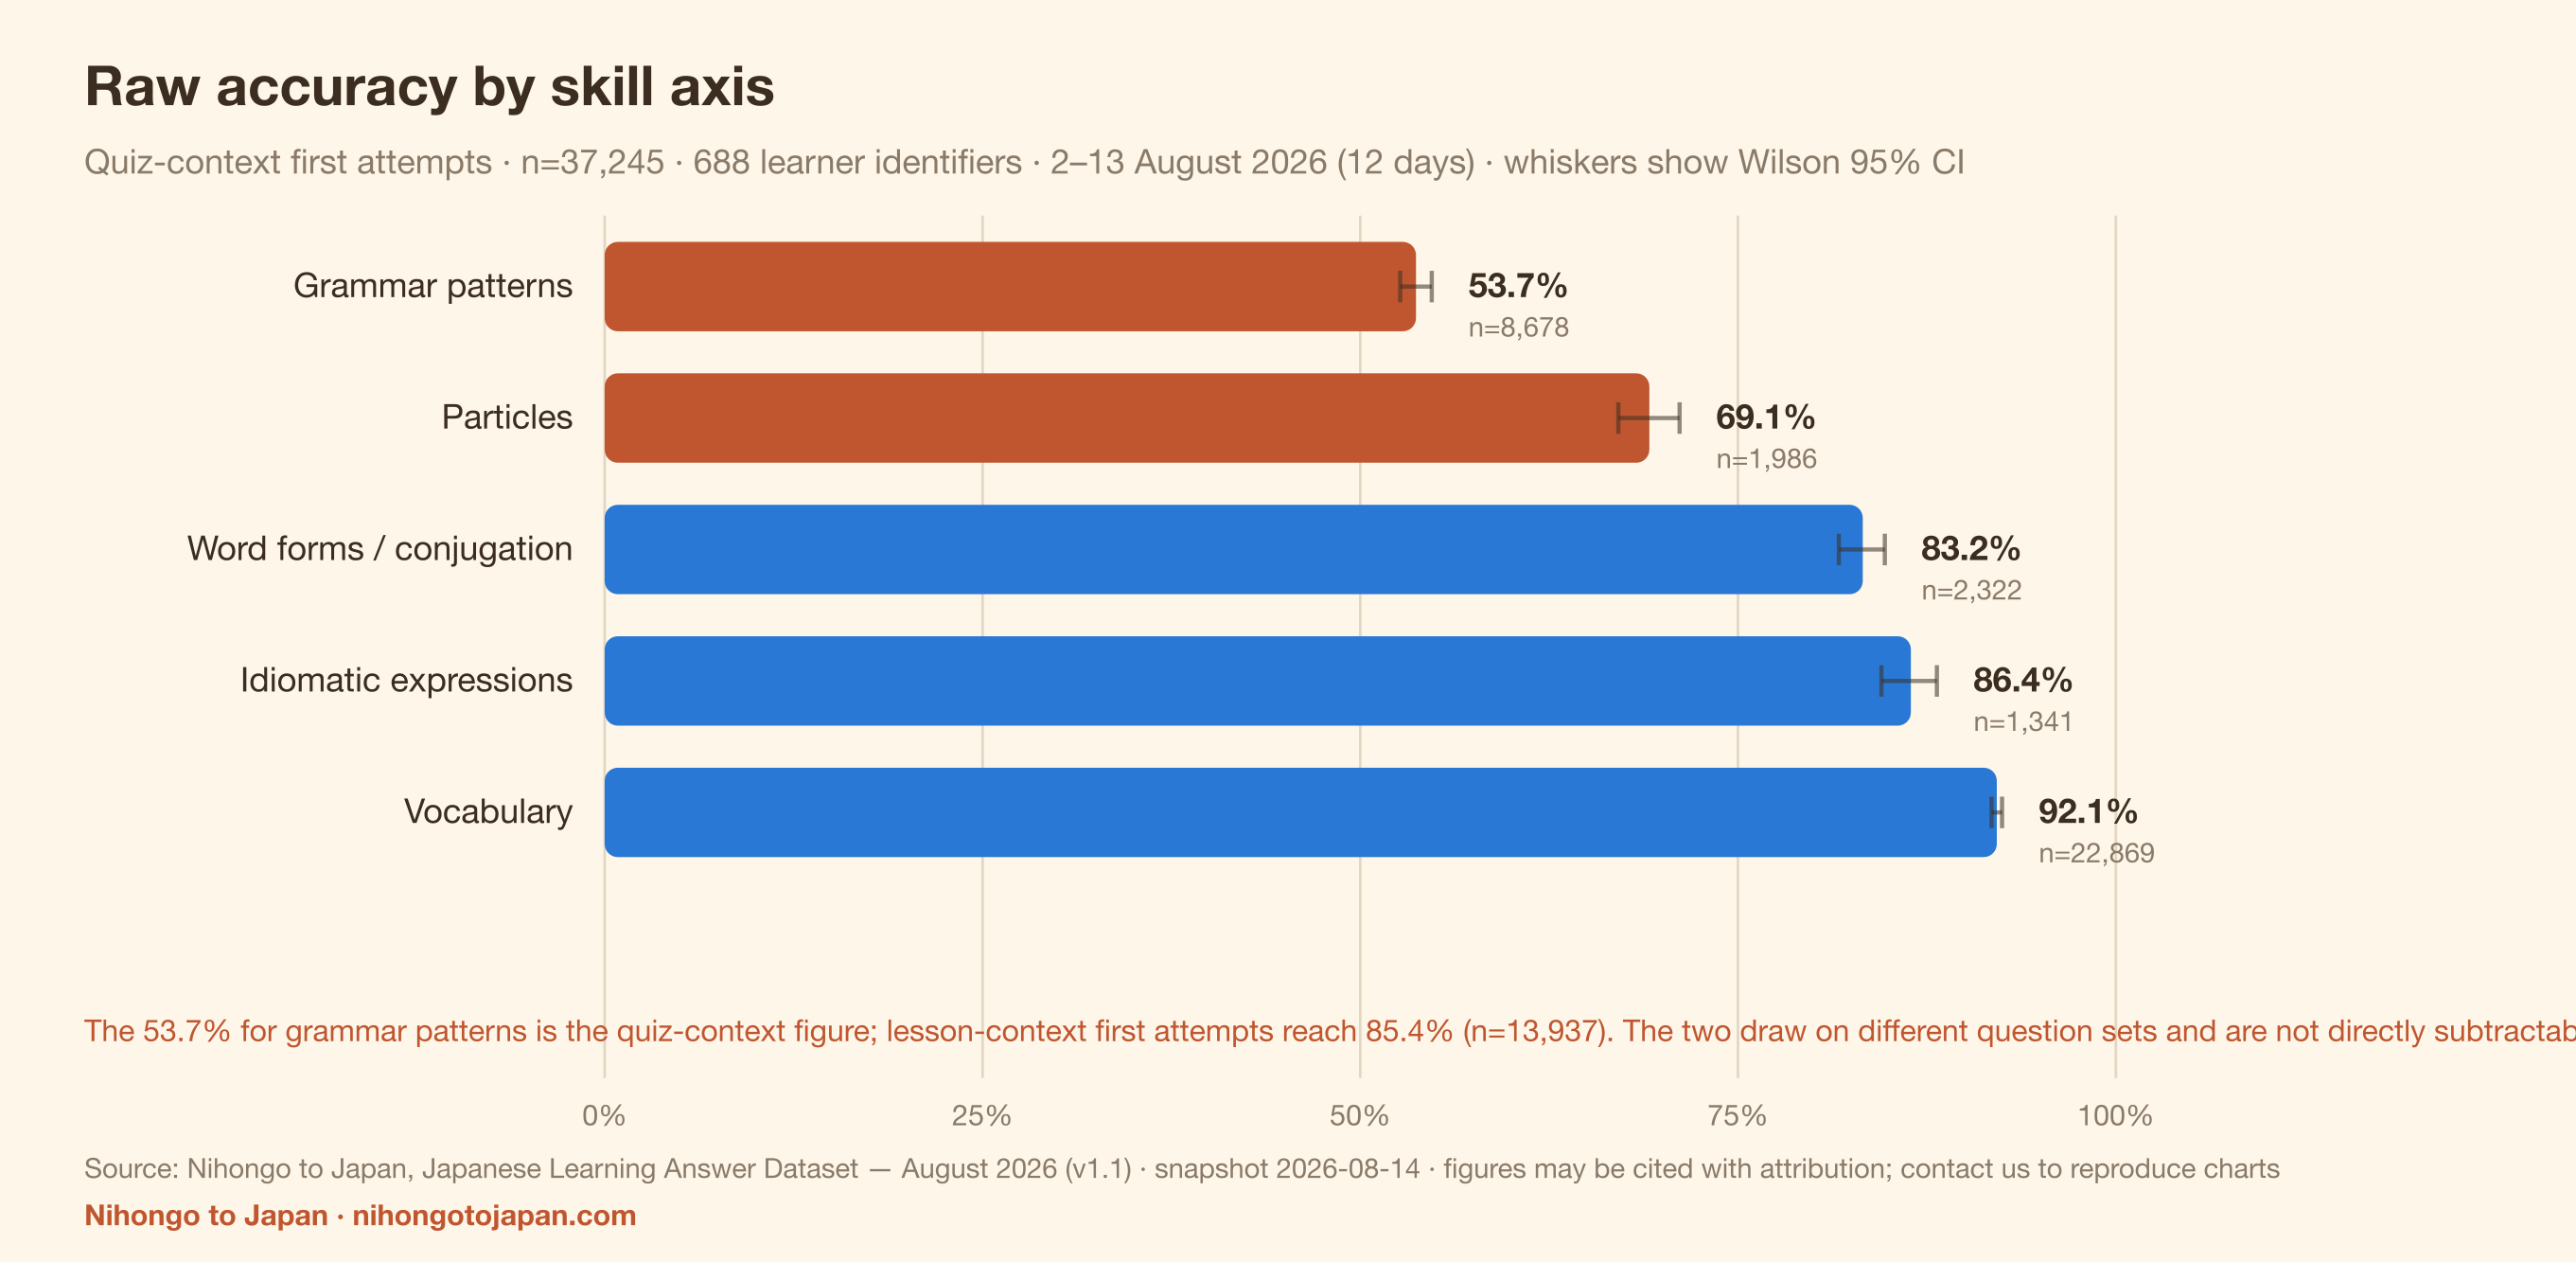
- En los primeros intentos en contexto de cuestionario del Conjunto de datos de respuestas de aprendizaje de japonés de NTJ (instantánea de agosto de 2026, 12 días), las preguntas de estructuras gramaticales se respondieron correctamente el 53,7% de las veces (n=8.678; IC de Wilson al 95%: 52,6%–54,7%), frente al 92,1% en vocabulario (n=22.869; IC 95%: 91,8%–92,5%): una diferencia de 38 puntos porcentuales.
Los dos intervalos no se solapan, así que la diferencia no es ruido de muestreo; este informe no afirma nada sobre su causa. - En los primeros intentos en contexto de cuestionario del mismo conjunto de datos, los cinco ejes de aprendizaje se ordenan de menor a mayor así: estructuras gramaticales 53,7% (n=8.678), partículas 69,1% (n=1.986; IC 95%: 67,1%–71,1%), formas y conjugación 83,2% (n=2.322; IC 95%: 81,7%–84,7%), expresiones idiomáticas 86,4% (n=1.341; IC 95%: 84,5%–88,2%) y vocabulario 92,1% (n=22.869).
Cada eje se basa en un conjunto de preguntas distinto, así que esto es una ordenación del porcentaje de acierto observado, no una ordenación por dificultad. - En el mismo conjunto de datos, el porcentaje de acierto observado en el eje de estructuras gramaticales va del 53,7% al 85,4% según qué respuestas se incluyan: 53,7% en los primeros intentos en contexto de cuestionario (n=8.678), 85,4% en los primeros intentos en contexto de lección (n=13.937) y 74,1% sobre todos los eventos de respuesta (n=24.293).
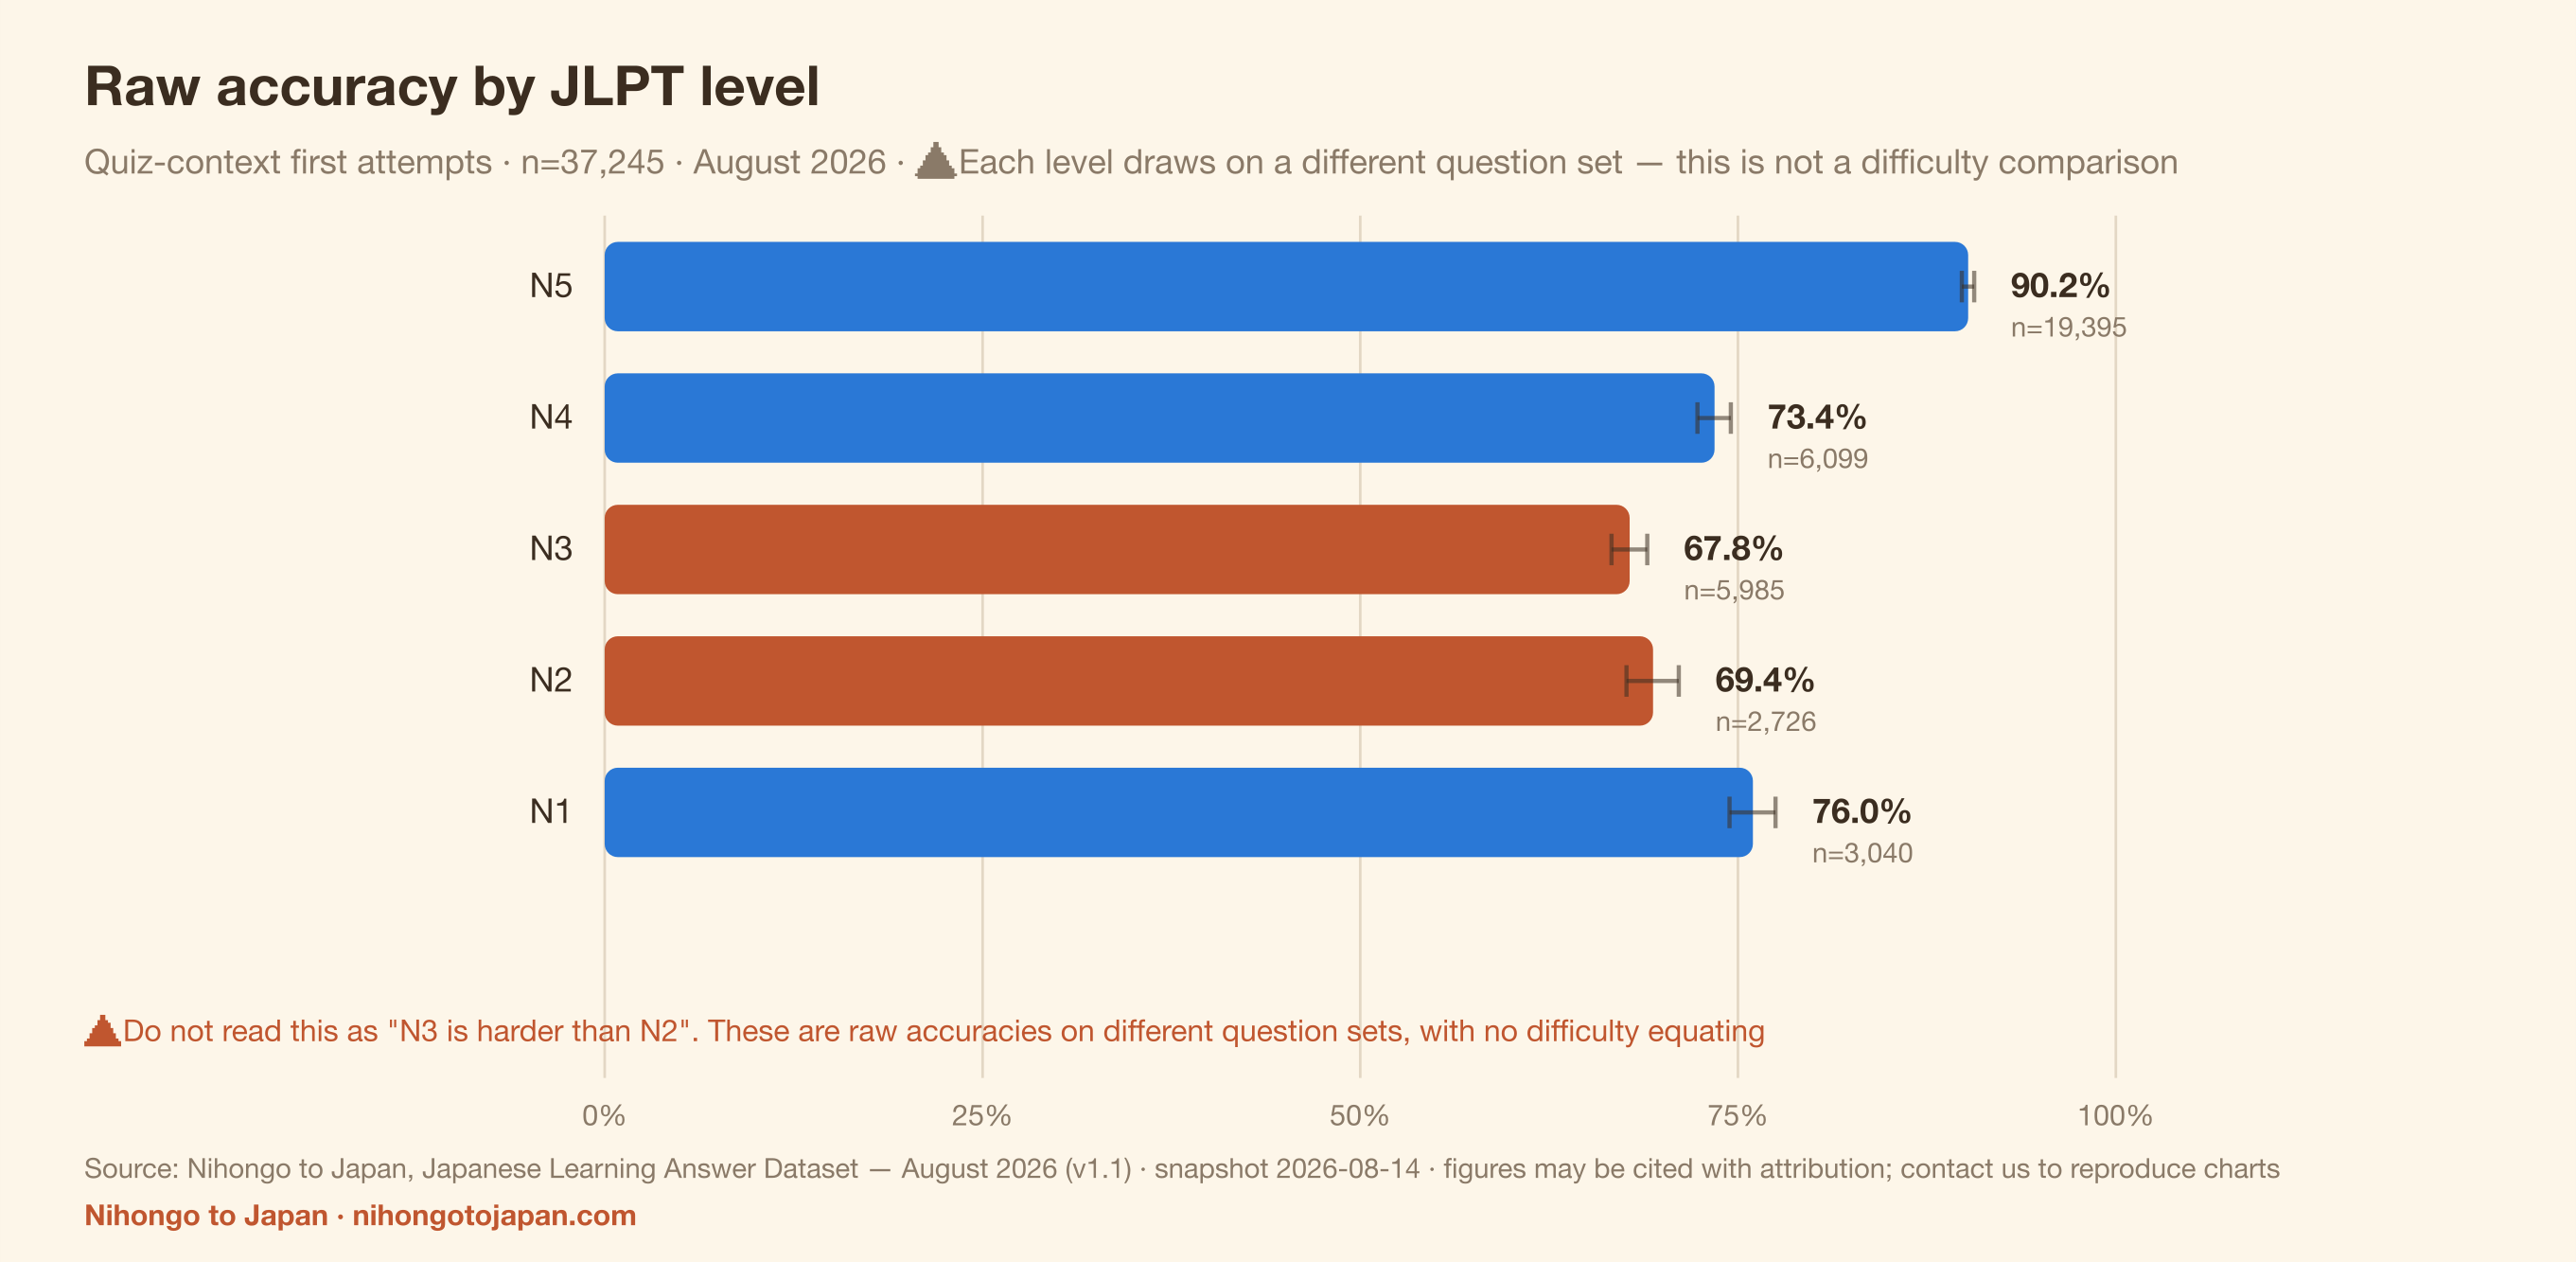
Los dos contextos se basan en conjuntos de preguntas casi disjuntos —solo 6 de las 5.772 preguntas distintas de estructuras gramaticales aparecen en ambos—, por lo que el efecto del contexto no puede separarse de las diferencias de dificultad entre preguntas. Lo que importa de este hallazgo es que cualquier porcentaje de acierto que se cite de una plataforma de aprendizaje tiene que indicar qué respuestas incluye. - En los primeros intentos en contexto de cuestionario del mismo conjunto de datos, el porcentaje de acierto bruto fue del 67,8% en N3 (n=5.985; IC 95%: 66,6%–69,0%) y del 69,4% en N2 (n=2.726; IC 95%: 67,6%–71,1%); los intervalos de confianza se solapan, así que este conjunto de datos no permite distinguir N2 de N3.
No lo presentes como «el N2 es más difícil que el N3» ni al revés. - En los primeros intentos en contexto de cuestionario del mismo conjunto de datos, el porcentaje de acierto bruto por nivel del JLPT fue: N5 90,2% (n=19.395), N1 76,0% (n=3.040), N4 73,4% (n=6.099), N2 69,4% (n=2.726) y N3 67,8% (n=5.985); el acierto bruto del N1 queda por encima tanto del N2 como del N3.
Los niveles usan conjuntos de preguntas distintos, no hay equiparación mediante TRI y la muestra es autoseleccionada (quien intenta preguntas de N1 suele estar más avanzado), así que esta ordenación no puede leerse como la dificultad objetiva de los niveles del JLPT. - En los primeros intentos en contexto de cuestionario del mismo conjunto de datos, la dispersión dentro de las partículas es mayor que la dispersión entre niveles del JLPT: la partícula が se respondió correctamente el 60,9% de las veces (n=358; IC 95%: 55,8%–65,8%) y を el 78,7% (n=385; IC 95%: 74,3%–82,5%), con 17,8 puntos de diferencia, frente a 5,6 puntos entre el N3 (67,8%) y el N4 (73,4%).
La implicación didáctica es que repartir la práctica por nivel del JLPT puede ser más tosco que repartirla por punto de conocimiento. - En los primeros intentos en contexto de cuestionario del mismo conjunto de datos, las estructuras gramaticales son el eje con menor puntuación en todos los niveles del JLPT: 64,0% en N5 (n=1.939), 48,0% en N4 (n=1.734), 49,2% en N3 (n=2.531), 51,1% en N2 (n=1.179) y 57,0% en N1 (n=1.295).
Vocabulario en esos mismos niveles: 94,4% en N5, 89,0% en N4, 84,0% en N3, 85,0% en N2 y 89,2% en N1. - En el mismo conjunto de datos, calculado exactamente sobre los mismos 372 identificadores de estudiante y los mismos 34.392 eventos de respuesta, la ponderación de un voto por respuesta (ponderación por evento) da un 82,53%, mientras que la de un voto por identificador da un 75,49%: una diferencia de 7,04 puntos porcentuales.
Las dos cifras usan exactamente la misma población y el mismo conjunto de análisis; la diferencia se debe únicamente a la elección de la ponderación. Cualquier informe que cite un porcentaje de acierto de una plataforma de aprendizaje debería indicar qué ponderación utiliza. - En el mismo conjunto de datos, el volumen de respuestas está muy concentrado: el identificador de estudiante más activo acumula por sí solo el 3,73% de los 56.613 eventos de respuesta, y los 10 identificadores más activos suman en conjunto el 19,44%.
Esta concentración es la razón directa de que las dos ponderaciones difieran en 7 puntos, y es un sesgo estructural que comparten en general los datos de las plataformas de aprendizaje. - En el mismo conjunto de datos, una comparación pareada restringida a los 75 identificadores de estudiante que respondieron en ambos contextos (al menos 5 respuestas en cada uno) da un 86,57% en el contexto de lección (n=5.858) frente a un 55,52% en el contexto de cuestionario (n=2.055), con una diferencia media pareada de 27,47 puntos porcentuales (IC 95%: 22,56–32,39).
Esto muestra que la diferencia entre contextos no es un artefacto de quién respondió dónde; pero como no es posible comparar las mismas preguntas (véase el hallazgo 3), el efecto del contexto sigue sin poder separarse de la dificultad de los ítems.
Cada hallazgo se desarrolla, se tabula y se representa en gráficos en las secciones siguientes. Si solo quieres las cifras, ve a Descargar los datos; para citar, consulta Cómo citar; si tienes preguntas, consulta la sección de contacto.
1. Cinco hallazgos principales
1. Las estructuras gramaticales son el único eje por debajo del 60%, 38 puntos por detrás del vocabulario
En los primeros intentos en contexto de cuestionario (la definición del conjunto está en la metodología), las preguntas de vocabulario se respondieron correctamente el 92,1% de las veces (n=22.869, 627 identificadores de estudiante, IC 95%: 91,8%–92,5%), mientras que las de estructuras gramaticales solo llegaron al 53,7% (n=8.678, 532 identificadores, IC 95%: 52,6%–54,7%).
Los intervalos de confianza están muy separados, así que no se trata de ruido de muestreo. Los datos muestran una gran diferencia entre los dos ejes; no dicen nada sobre el porqué.
2. El «porcentaje de acierto» en estructuras gramaticales va del 53,7% al 74,1% según qué respuestas se incluyan
Con distintas definiciones del conjunto de análisis, el porcentaje de acierto observado en el eje de estructuras gramaticales va del 53,7% (primeros intentos en contexto de cuestionario, n=8.678) al 74,1% (todos los eventos de respuesta, n=24.293). Como cambian tanto los eventos incluidos como la composición de los identificadores de estudiante, la diferencia completa no puede interpretarse como producto de una única regla de recuento.
Paso a paso:
| Paso | n | Acierto bruto | Cambio respecto al paso anterior |
|---|---|---|---|
| Todos los eventos de respuesta | 24.293 | 74,1% | — |
| → solo primeros intentos | 22.638 | 73,2% | -0,87 p. p. |
| → solo contextos de cuestionario (se excluyen lección/repaso) | 8.678 | 53,7% | -19,54 p. p. |
| (comparación) primeros intentos en contexto de lección | 13.937 | 85,4% | — |
Eliminar los intentos repetidos mueve la cifra solo 0,9 puntos porcentuales. Casi todo el resto procede de la diferencia entre las respuestas en contexto de lección y en contexto de cuestionario.
Comparación pareada sobre los mismos identificadores de estudiante: 75 identificadores tienen al menos 5 primeros intentos de estructuras gramaticales en cada contexto. Alcanzan un 86,6% en el contexto de lección (n=5.858) y un 55,5% en el contexto de cuestionario (n=2.055), con una diferencia media pareada de +27,5 p. p. (IC 95%: 22,6–32,4; mediana +26,9). Así pues, la diferencia no es simplemente una cuestión de quién responde.
⚠️ No es posible comparar las mismas preguntas, así que no se puede sacar ninguna conclusión. De las 5.772 preguntas distintas de estructuras gramaticales, solo 6 aparecen en ambos contextos, y solo 1 tiene al menos 3 respuestas en cada uno. Los dos contextos se basan en conjuntos de preguntas casi disjuntos, por lo que el efecto del contexto no puede separarse de las diferencias de dificultad entre preguntas. Puede que las preguntas del contexto de lección sean simplemente más fáciles.
Lo que sí se puede decir con honestidad es esto: cuando cites un porcentaje de acierto de una plataforma de aprendizaje, pregunta siempre de qué conjunto de análisis procede. Los cuatro conjuntos están en los datos descargables.
3. N3 y N2 tienen el acierto bruto más bajo, pero estos datos no permiten distinguirlos
Acierto bruto en primeros intentos en contexto de cuestionario por nivel: N5 90,2%, N4 73,4%, N3 67,8%, N2 69,4%, N1 76,0%.
Los intervalos del N3 (IC 95%: 66,6%–69,0%) y del N2 (IC 95%: 67,6%–71,1%) se solapan, así que no es correcto decir que «el N3 es más difícil que el N2». Lo que sí puede decirse es que, en esta muestra, el N2 y el N3 quedan ambos por debajo del N4, el N1 y el N5 en acierto bruto.
⚠️ Y, sobre todo, cada nivel se basa en un conjunto de preguntas completamente distinto. Esta ordenación no es una comparación de dificultad ni prueba qué nivel del JLPT es objetivamente más difícil.
4. La dispersión dentro de las partículas es mayor que la dispersión entre niveles
Acierto en primeros intentos en contexto de cuestionario para partículas concretas: が 60,9% (n=358, IC 55,8%–65,8%), に 62,4% (n=370), で 63,3% (n=330), frente a を 78,7% (n=385, IC 74,3%–82,5%) y の 83,3% (n=120).
Los intervalos de が y を no se solapan; la diferencia es de 18 puntos porcentuales.
5. Un voto por identificador y un voto por respuesta difieren en 7,04 puntos
Calculado sobre exactamente los mismos 372 identificadores de estudiante, el mismo conjunto de análisis y los mismos 34.392 eventos elegibles:
| Ponderación | Acierto |
|---|---|
| Ponderada por evento (un voto por respuesta) | 82,5% |
| Ponderada por identificador (un voto por identificador) | 75,5% (mediana 76,2%) |
| WEIGHTING_EFFECT_PP | 7,04 p. p. |
Cohorte: identificadores de estudiante con al menos 20 respuestas en el conjunto de análisis principal. Las dos cifras comparten la misma población en el numerador y el mismo denominador, así que la diferencia refleja únicamente la elección de la ponderación y no está contaminada por diferencias en la composición de la muestra.
La causa son las medidas repetidas: el identificador más activo acumula por sí solo el 3,7% de todas las respuestas y los diez más activos, el 19,4%. Cualquier estudio con datos de una plataforma se topa con esto, por eso publicamos las dos cifras.
2. Panorama del conjunto de datos
| Elemento | Valor |
|---|---|
| Eventos de respuesta válidos | 56.613 |
| Identificadores anónimos de estudiante (límite superior del número de personas) | 1.053 |
| Preguntas distintas | 11.987 |
| Puntos de conocimiento | 39 |
| Cobertura temporal | Del 2 al 13 de agosto de 2026 (12 días); el primer día está incompleto |
| Corte de la instantánea | 2026-08-14T00:00:00Z |
| Eventos de primer intento | 52.934 |
| Primeros intentos en contexto de cuestionario (conjunto principal) | 37.245 |
| Identificadores de estudiante en el conjunto principal | 688 |
| Primeros intentos en contexto de lección (conjunto de comparación) | 15.741 |
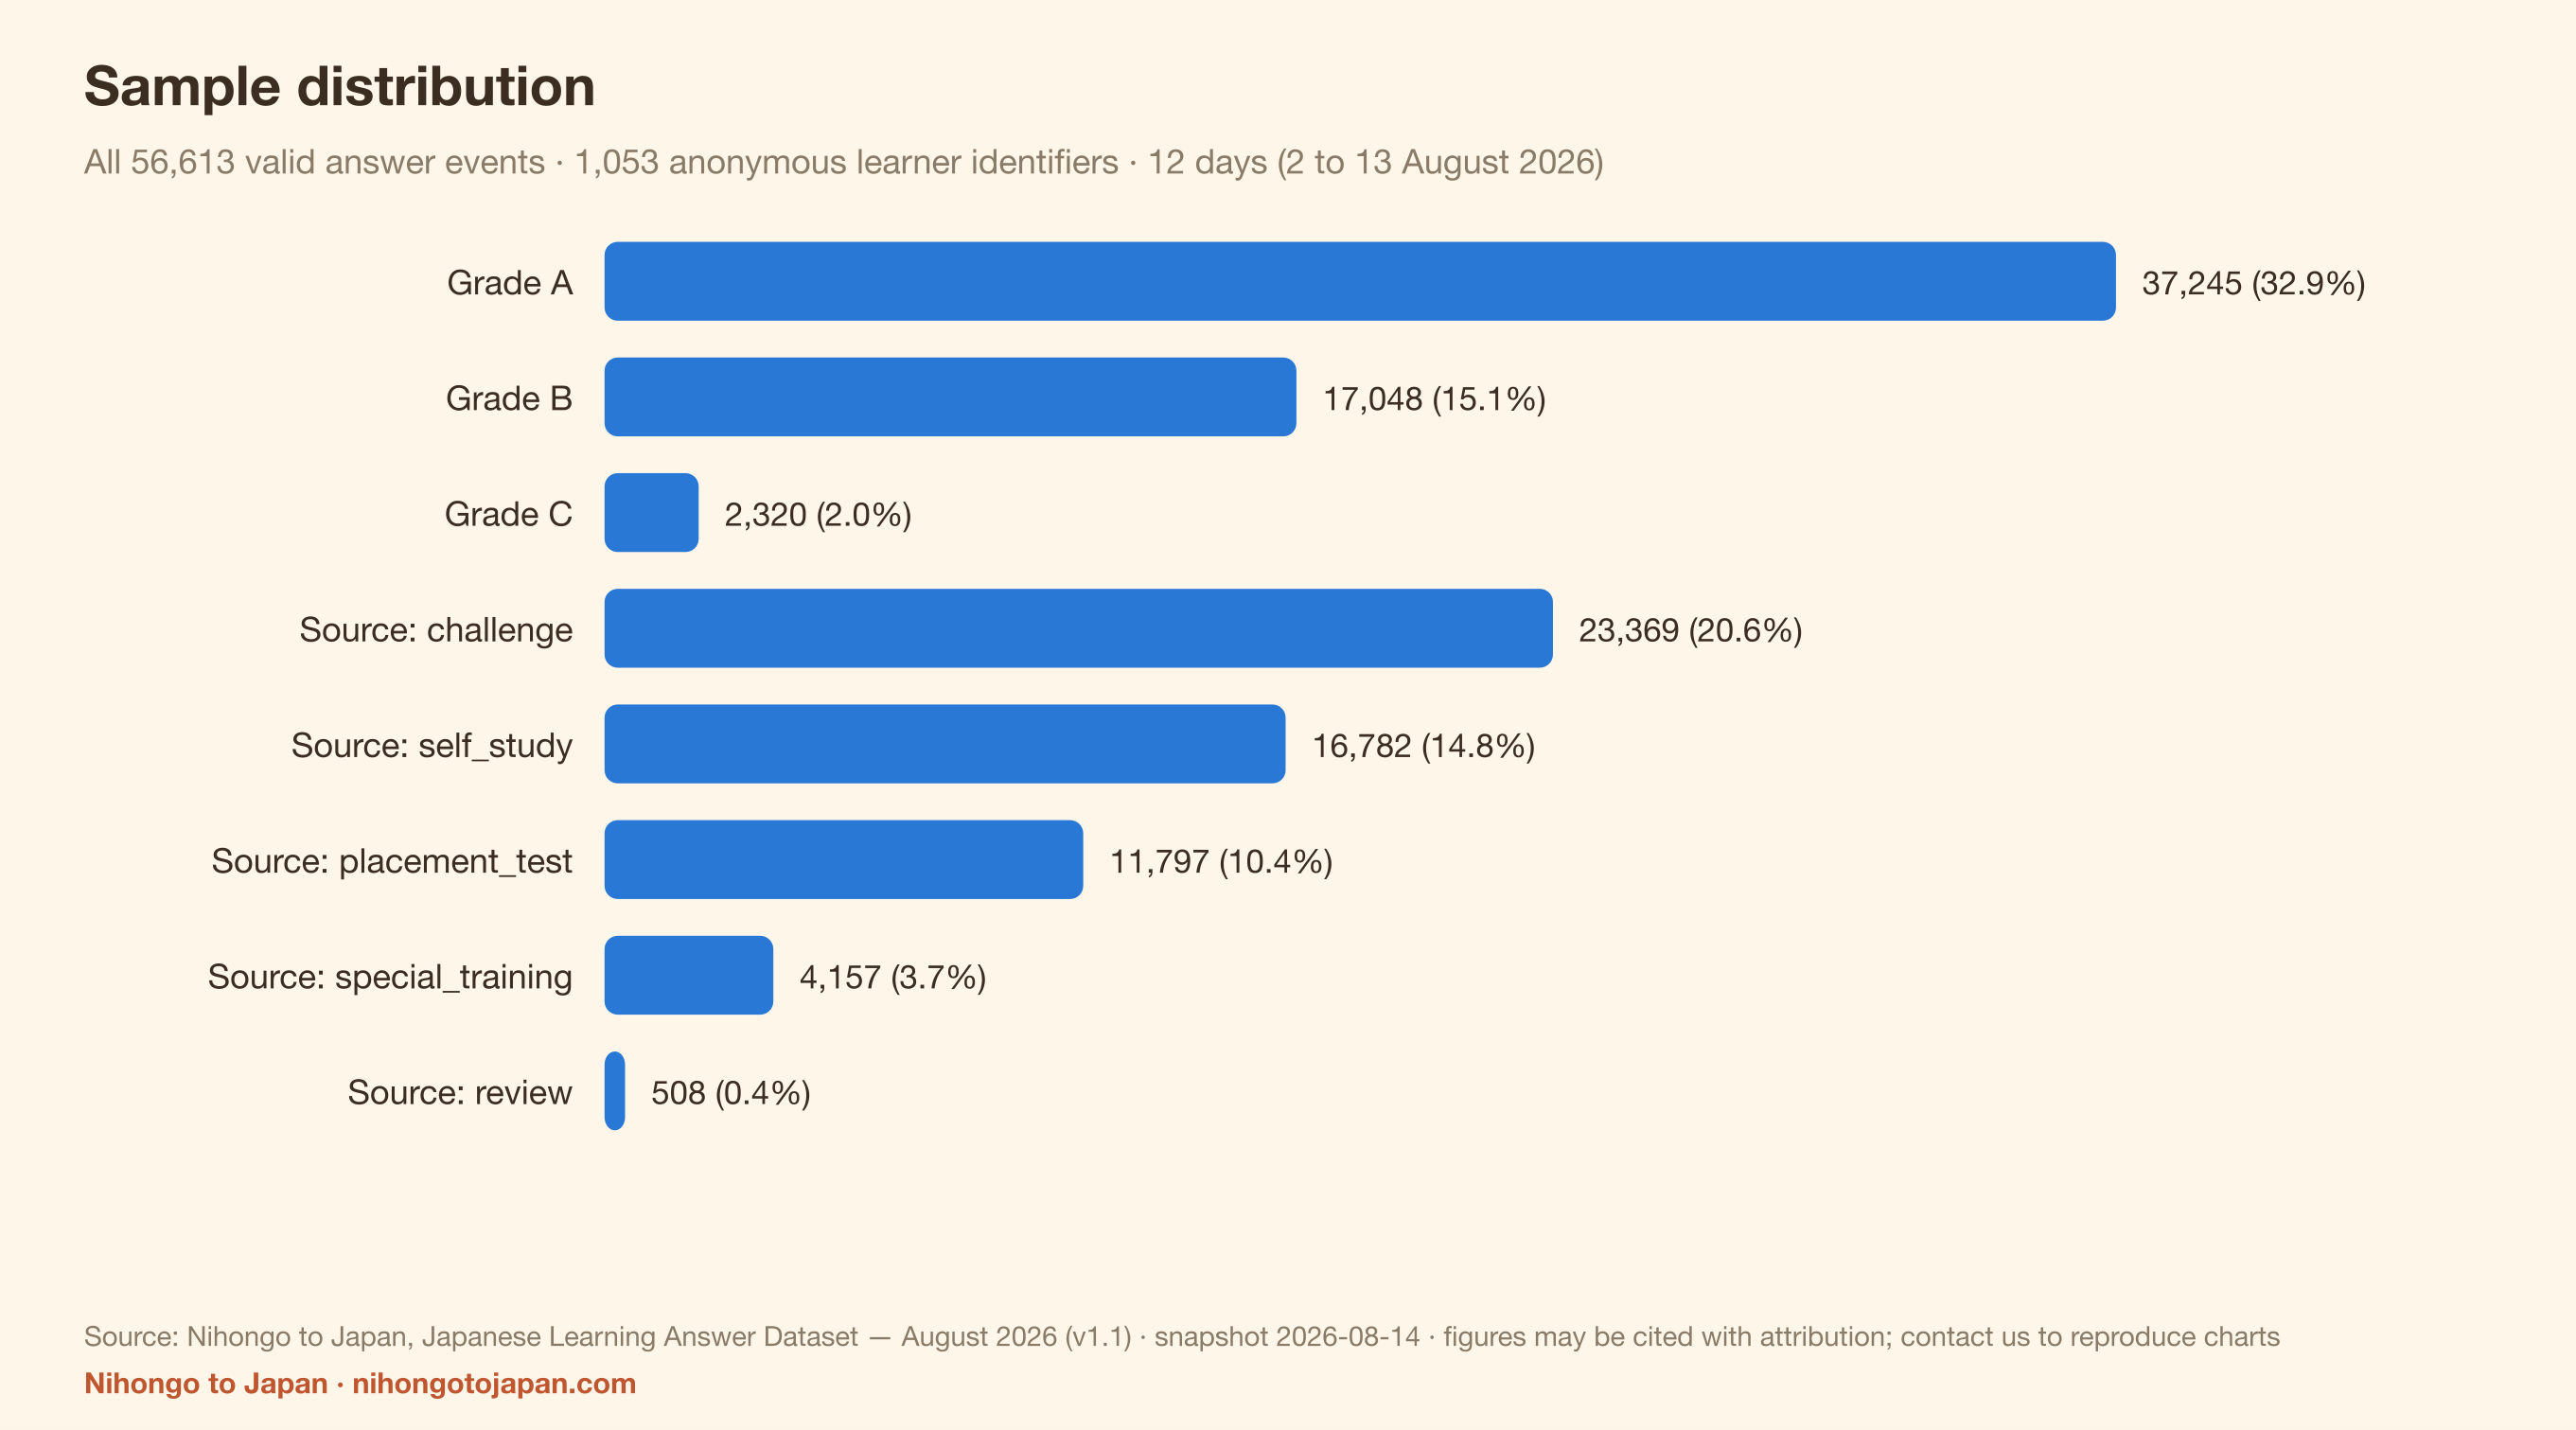
Respuestas por origen: challenge 23.369 (41,3%), self_study 16.782 (29,6%), placement_test 11.797 (20,8%), special_training 4.157 (7,3%), review 508 (0,9%).
Distribución de la columna evidence_class de la base de datos (un campo bruto de la tabla, no el nombre de un conjunto de análisis de este informe): A 37.245 (65,8%), B 17.048 (30,1%), C 2.320 (4,1%). El conjunto de análisis principal es exactamente evidence_class = A.

3. Acierto por eje de aprendizaje

| Eje de competencia | n | Identificadores | Acierto bruto | IC 95% | Indicador |
|---|---|---|---|---|---|
| Estructuras gramaticales | 8.678 | 532 | 53,7% | 52,6%–54,7% | OK |
| Partículas | 1.986 | 137 | 69,1% | 67,1%–71,1% | OK |
| Formas / conjugación | 2.322 | 386 | 83,2% | 81,7%–84,7% | OK |
| Expresiones idiomáticas | 1.341 | 261 | 86,4% | 84,5%–88,2% | OK |
| Vocabulario | 22.869 | 627 | 92,1% | 91,8%–92,5% | OK |
Los siguientes ejes no alcanzan el tamaño mínimo de celda (n<30 o menos de 5 identificadores de estudiante), así que no se publica ningún porcentaje de acierto, solo el número de eventos: Mixto / general (n=27, 8 identificadores), Comprensión lectora (n=22, 4 identificadores).
4. Acierto por nivel del JLPT
⚠️ Esta es la sección que más fácilmente se malinterpreta. Cada nivel se basa en un conjunto de preguntas completamente distinto y no se ha realizado ninguna equiparación de dificultad mediante TRI. Las cifras siguientes son la proporción de estas preguntas concretas que se respondieron correctamente, no una medida de qué nivel es más difícil.

| Nivel del JLPT | n | Identificadores | Acierto bruto | IC 95% |
|---|---|---|---|---|
| N5 | 19.395 | 380 | 90,2% | 89,8%–90,6% |
| N4 | 6.099 | 313 | 73,4% | 72,3%–74,5% |
| N3 | 5.985 | 432 | 67,8% | 66,6%–69,0% |
| N2 | 2.726 | 212 | 69,4% | 67,6%–71,1% |
| N1 | 3.040 | 139 | 76,0% | 74,4%–77,5% |
Los mismos niveles en los cuatro conjuntos de análisis:
| Nivel | Primer intento en cuestionario (principal) | Primer intento en lección | Primeros intentos (todos) | Todos los eventos |
|---|---|---|---|---|
| N5 | 90,2% (n=19.395) | 83,7% (n=11.154) | 87,8% (n=30.495) | 88,2% (n=33.286) |
| N4 | 73,4% (n=6.099) | 83,1% (n=2.694) | 76,5% (n=8.758) | 76,6% (n=9.262) |
| N3 | 67,8% (n=5.985) | 82,1% (n=1.507) | 70,8% (n=7.522) | 71,1% (n=7.727) |
| N2 | 69,4% (n=2.726) | 79,2% (n=260) | 70,2% (n=2.985) | 70,5% (n=3.072) |
| N1 | 76,0% (n=3.040) | 86,5% (n=126) | 76,4% (n=3.174) | 76,5% (n=3.266) |
5. Puntos de conocimiento con menor acierto
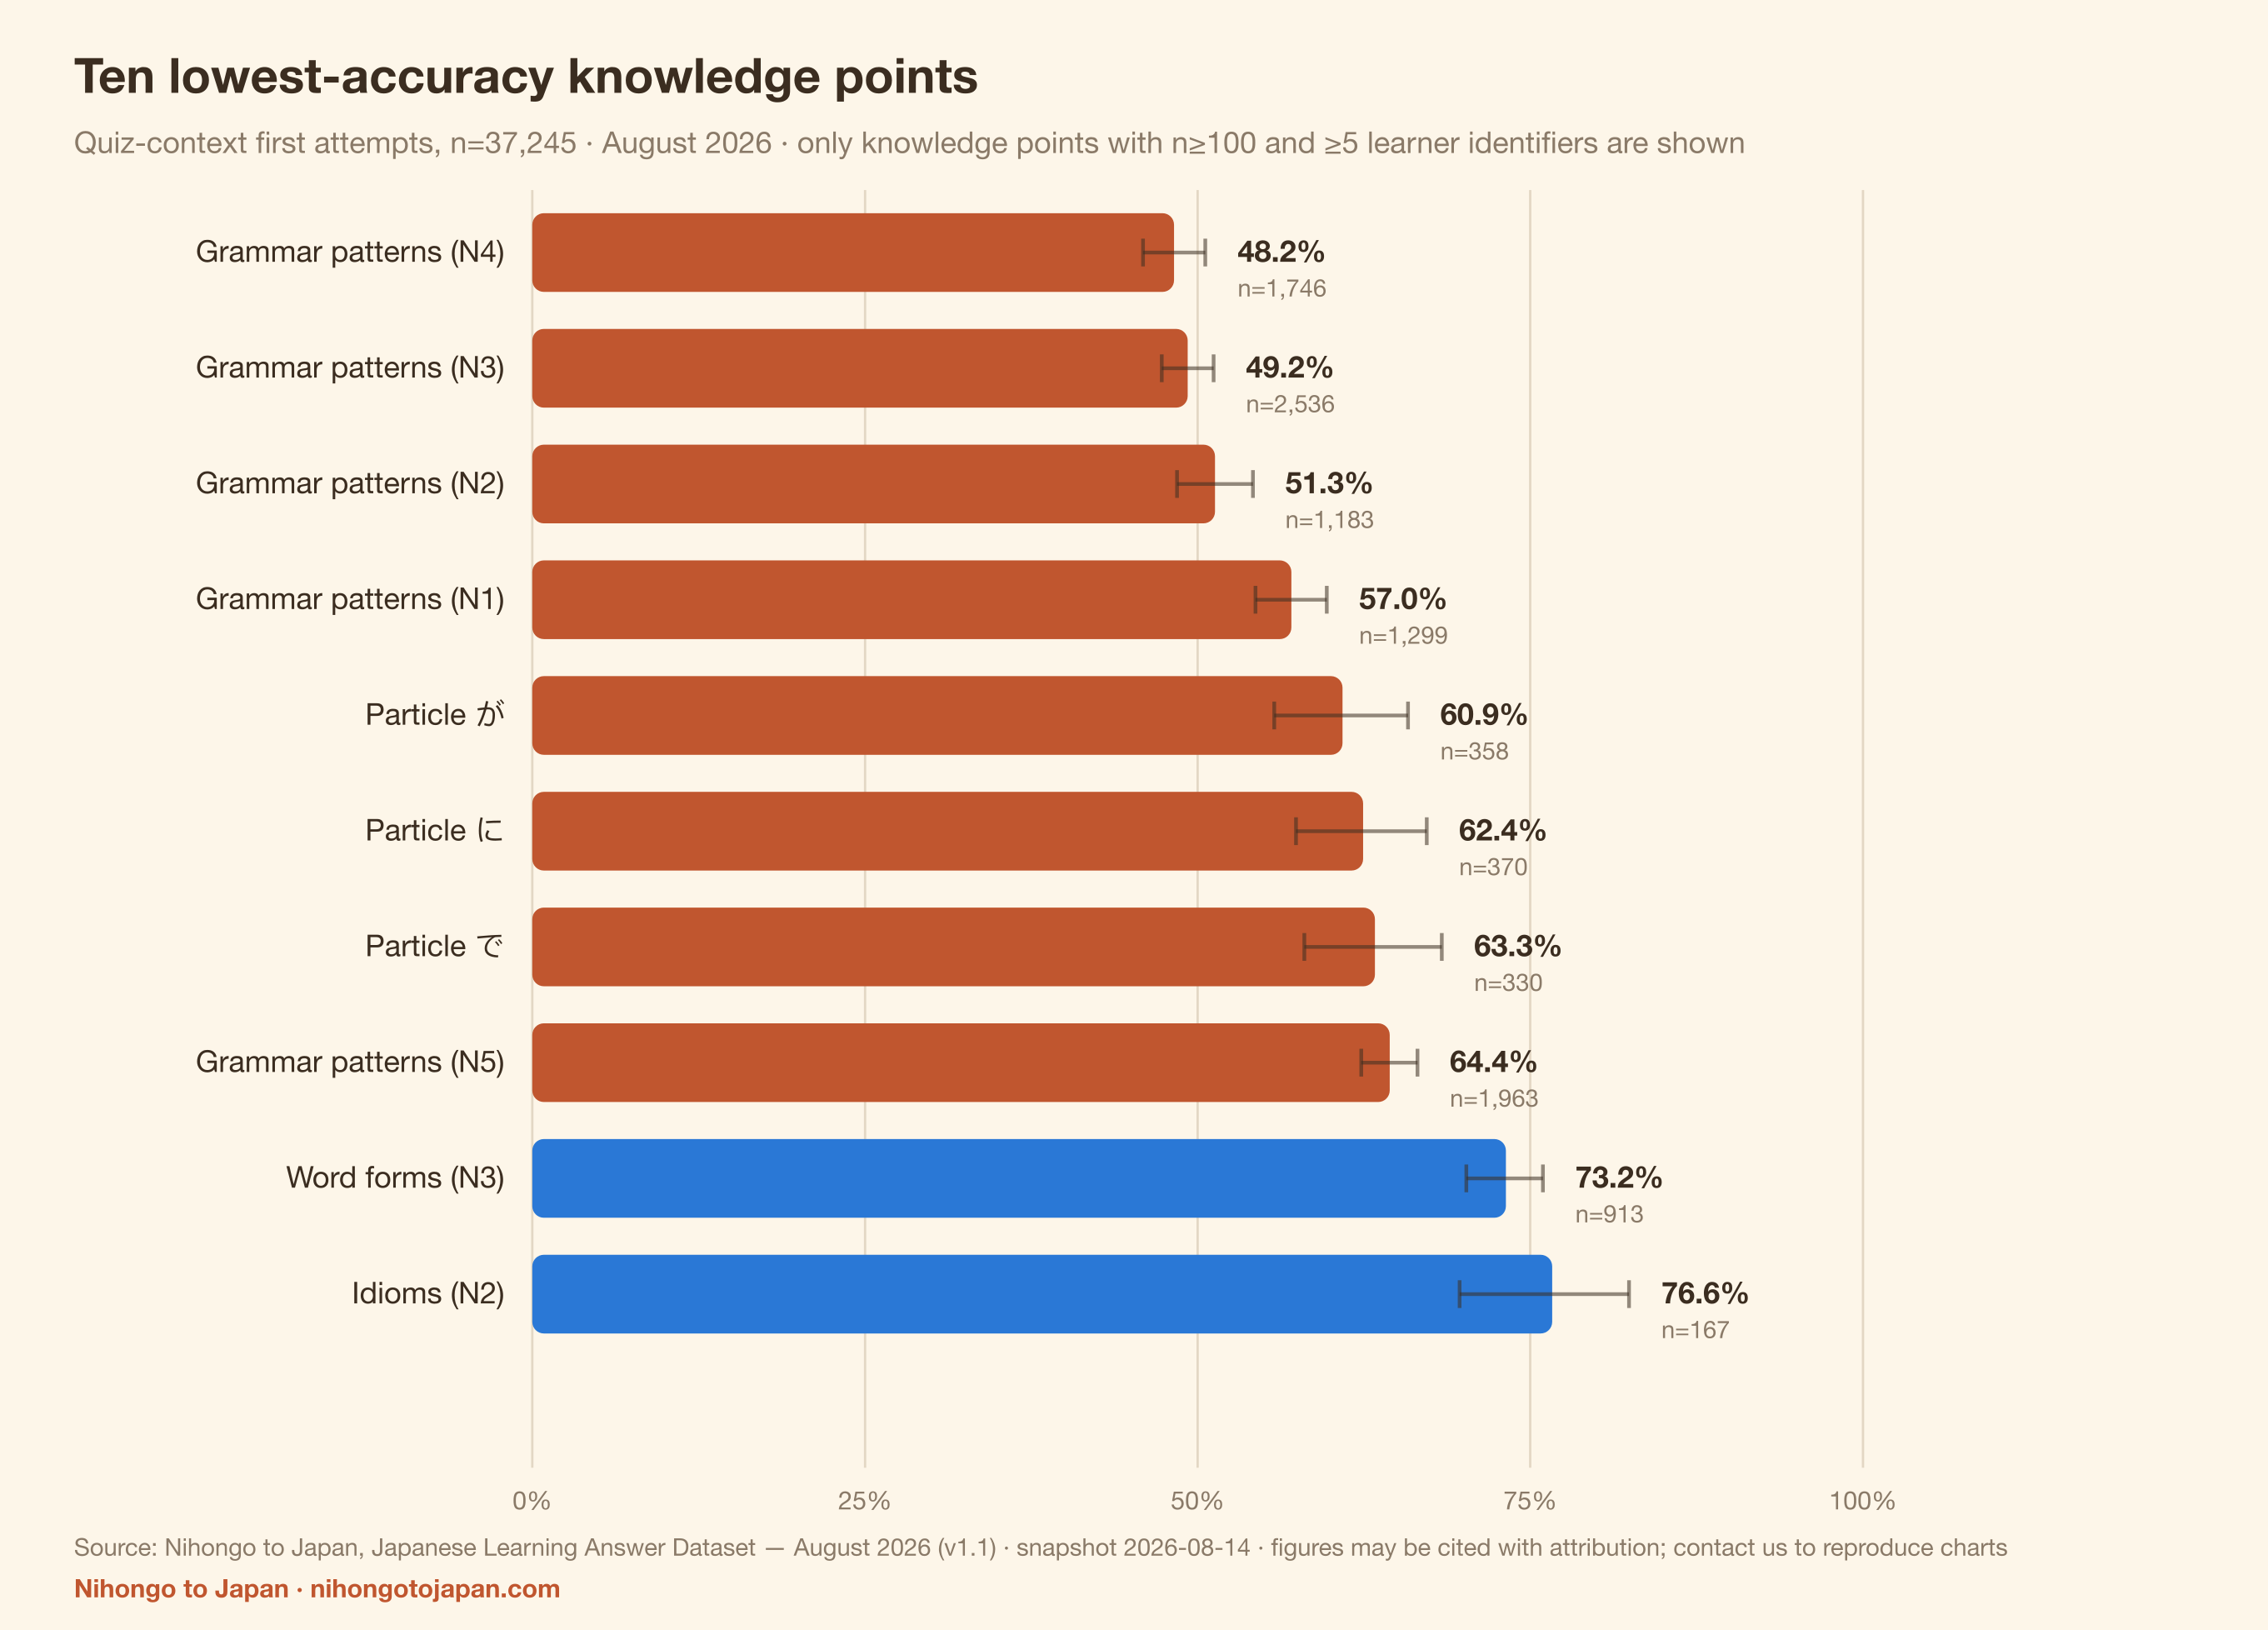
Solo se incluyen los puntos de conocimiento con n≥100 y al menos 5 identificadores de estudiante (23 cumplen la condición). Junto al porcentaje se muestran n, nivel y categoría: las celdas pequeñas parecen extremas por motivos que normalmente no son más que ruido.

| # | Punto de conocimiento | Categoría | Nivel | n | Identificadores | Acierto bruto | IC 95% |
|---|---|---|---|---|---|---|---|
| 1 | Estructuras gramaticales (N4) | Estructuras gramaticales | N4 | 1.746 | 234 | 48,2% | 45,9%–50,6% |
| 2 | Estructuras gramaticales (N3) | Estructuras gramaticales | N3 | 2.536 | 390 | 49,2% | 47,3%–51,2% |
| 3 | Estructuras gramaticales (N2) | Estructuras gramaticales | N2 | 1.183 | 191 | 51,3% | 48,5%–54,1% |
| 4 | Estructuras gramaticales (N1) | Estructuras gramaticales | N1 | 1.299 | 118 | 57,0% | 54,3%–59,7% |
| 5 | Partícula が | Partículas | — | 358 | 81 | 60,9% | 55,8%–65,8% |
| 6 | Partícula に | Partículas | — | 370 | 75 | 62,4% | 57,4%–67,2% |
| 7 | Partícula で | Partículas | — | 330 | 85 | 63,3% | 58,0%–68,3% |
| 8 | Estructuras gramaticales (N5) | Estructuras gramaticales | N5 | 1.963 | 209 | 64,4% | 62,3%–66,5% |
| 9 | Formas (N3) | Formas | N3 | 913 | 294 | 73,2% | 70,2%–75,9% |
| 10 | Expresiones idiomáticas (N2) | Expresiones idiomáticas | N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| 11 | Partícula を | Partículas | — | 385 | 61 | 78,7% | 74,3%–82,5% |
| 12 | Formas (N2) | Formas | N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
6. Puntos fuertes más consistentes
| # | Punto de conocimiento | Categoría | Nivel | n | Identificadores | Acierto bruto | IC 95% |
|---|---|---|---|---|---|---|---|
| 1 | Formas (N1) | Formas | N1 | 296 | 79 | 95,6% | 92,6%–97,4% |
| 2 | Vocabulario (N5) | Vocabulario | N5 | 16.029 | 311 | 94,4% | 94,0%–94,8% |
| 3 | Vocabulario (N1) | Vocabulario | N1 | 703 | 94 | 89,2% | 86,7%–91,3% |
| 4 | Vocabulario (N4) | Vocabulario | N4 | 2.828 | 243 | 89,0% | 87,8%–90,1% |
| 5 | Expresiones idiomáticas (N1) | Expresiones idiomáticas | N1 | 742 | 111 | 88,8% | 86,3%–90,9% |
| 6 | Formas (N4) | Formas | N4 | 461 | 149 | 87,0% | 83,6%–89,8% |
| 7 | Expresiones idiomáticas (N4) | Expresiones idiomáticas | N4 | 140 | 91 | 86,4% | 79,8%–91,1% |
| 8 | Expresiones idiomáticas (N3) | Expresiones idiomáticas | N3 | 290 | 142 | 85,9% | 81,4%–89,4% |
7. Patrones observados que vale la pena señalar
Observación A: el acierto bruto del N1 queda por encima del N2 y del N3
N1, 76,0% (n=3.040, 139 identificadores), está por encima del N2 (69,4%) y del N3 (67,8%).
Es un patrón observado, no una prueba de que el N1 sea más fácil. Hay al menos tres explicaciones que estos datos no permiten descartar: solo 139 identificadores respondieron preguntas de N1, frente a 432 en N3, así que los grupos tienen una composición distinta; los conjuntos de preguntas son diferentes; y no se ha realizado ninguna estimación de habilidad. Para responder «qué nivel es realmente más difícil» hacen falta una equiparación mediante TRI y un diseño con ítems de anclaje, y este conjunto de datos no tiene ni lo uno ni lo otro.
Observación B: el eje de estructuras gramaticales es el más bajo en todos los niveles
| Eje × nivel | n | Identificadores | Acierto bruto | IC 95% |
|---|---|---|---|---|
| Estructuras gramaticales × N4 | 1.734 | 233 | 48,0% | 45,6%–50,3% |
| Estructuras gramaticales × N3 | 2.531 | 389 | 49,2% | 47,2%–51,1% |
| Estructuras gramaticales × N2 | 1.179 | 191 | 51,1% | 48,3%–54,0% |
| Estructuras gramaticales × N1 | 1.295 | 118 | 57,0% | 54,3%–59,7% |
| Partículas × N4 | 766 | 92 | 58,5% | 55,0%–61,9% |
| Estructuras gramaticales × N5 | 1.939 | 208 | 64,0% | 61,8%–66,1% |
| Formas / conjugación × N3 | 948 | 302 | 74,2% | 71,3%–76,8% |
| Partículas × N5 | 1.220 | 111 | 75,8% | 73,3%–78,1% |
| Expresiones idiomáticas × N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| Formas / conjugación × N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
Al cruzar eje y nivel, casi todas las celdas más bajas son de estructuras gramaticales. Eso aporta más información que el desglose por nivel por sí solo.
8. Para qué pueden usar esto docentes y diseñadores de materiales
Esta sección separa deliberadamente los datos de la interpretación. Los datos son citables; la interpretación es nuestro criterio, y puedes no estar de acuerdo con ella.
| Datos (citables) | Interpretación (nuestro criterio, no datos) |
|---|---|
| Primeros intentos en contexto de cuestionario: eje de estructuras gramaticales 53,7% frente a vocabulario 92,1% (n=8.678 y 22.869) | En esta plataforma hay una brecha clara entre reconocer palabras y construir frases. Si hay que repartir el tiempo de práctica, las estructuras gramaticales pueden ofrecer un rendimiento marginal mayor. |
| が 60,9%, に 62,4% y で 63,3% quedan muy por debajo de を 78,7% y の 83,3% | を y の tienen funciones relativamente acotadas, mientras que が, に y で son muy polisémicas. Enseñar por separado las distintas funciones de una misma partícula puede funcionar mejor que presentar las partículas una a una. |
| El acierto bruto del N2 y el N3 (69,4% / 67,8%) queda por debajo del N4, el N1 y el N5 | ⚠️ No lo uses para ordenar por dificultad. Una lectura más plausible es que quienes responden en N2/N3 tienen una composición distinta de los de otros niveles, más que algo relacionado con las preguntas. |
| Estructuras gramaticales: 85,4% en el contexto de lección (n=13.937) frente a 53,7% en el contexto de cuestionario (n=8.678); diferencia pareada de +27,5 p. p. sobre 75 identificadores | Responder dentro de una lección y responder en un cuestionario dan resultados muy distintos; conviene tenerlo presente cuando se usan las puntuaciones de práctica de una plataforma para valorar resultados de aprendizaje. ⚠️ Pero los dos contextos usan conjuntos de preguntas casi disjuntos, así que no podemos decir si se debe al contexto o simplemente a preguntas más fáciles. |
9. Metodología
| Elemento | Detalle |
|---|---|
| Población | Registros de respuestas generados por estudiantes que usan Nihongo to Japan. |
| Muestreo | Muestra observacional y autoseleccionada. No es un muestreo aleatorio ni es representativa de la población. |
| Unidad de análisis | evento de respuesta (un identificador de estudiante que responde una pregunta una vez). |
| Recuento de usuarios | identificadores de estudiante = identificadores anónimos distintos. No se pueden unificar entre dispositivos, así que es un límite superior del número de personas, no un recuento verificado. |
| Métrica | acierto bruto = respuestas correctas ÷ eventos de respuesta válidos. No es una estimación de habilidad. |
| Intervalos de confianza | IC de Wilson al 95%. Solo refleja el error de muestreo; no corrige el sesgo de selección. |
Cuatro conjuntos de análisis
| Conjunto | Definición | n |
|---|---|---|
| Primeros intentos en contexto de cuestionario (conjunto de análisis principal) | Respuestas de challenge / placement_test / special_training en las que se trata del primer intento de ese identificador de estudiante con esa pregunta, no una repetición en un plazo de 24 horas, y con los metadatos de la pregunta completos. | 37.245 |
| Primeros intentos en contexto de lección (conjunto de comparación) | Primeros intentos de self_study / review: respuestas dadas mientras se trabaja con el material de las lecciones. | 15.741 |
| Primeros intentos (todos los contextos) | La primera respuesta de cada identificador de estudiante a cada pregunta, sea cual sea su origen. | 52.934 |
| Todos los eventos de respuesta | Todos los eventos de respuesta válidos, incluidas las repeticiones. | 56.613 |
⚠️ El conjunto principal no afirma nada sobre pistas ni explicaciones. Los camposused_hint/viewed_explanation/used_answer_keyvalen false en toda la base de datos, pero solo porque ningún componente llega a escribirlos: ninguno de los puntos del código que registran respuestas pasa estos parámetros, y el producto no tiene actualmente ninguna función de pistas antes de responder ni de mostrar la respuesta. Que siempre valgan false es una propiedad de la instrumentación, no una prueba sobre el comportamiento de los estudiantes. Por eso estos campos no se usan como condiciones de análisis y no se afirma nada sobre el uso de pistas.
Verificación independiente del conjunto principal: al recalcular en el servidor el evento más temprano por (identificador, pregunta), el 99,59% de los eventos del conjunto principal (37.094 de 37.245) superan la prueba de primer intento. Los 151 que no la superan son, con toda probabilidad, casos entre dispositivos: la misma persona respondiendo en dos dispositivos, cada uno de los cuales registra un primer intento. Todos los eventos del conjunto tienen attempt_number = 1.
Qué se excluye
- Preguntas defectuosas conocidas: se excluyen 520 identificadores de pregunta de todos los agregados. Hay dos causas: (1) preguntas de completar huecos de los materiales de las lecciones que no son de gramática (conversión de kana, ortografía, respuestas numéricas) y que se etiquetaron por error en el eje de estructuras gramaticales; (2) una versión antigua de la «pregunta del día» que usaba el texto de la respuesta como identificador de la pregunta, con lo que preguntas distintas acababan bajo un mismo identificador. El front-end ya está corregido; los datos históricos se excluyen mediante una lista de exclusión. No se ha borrado ningún evento bruto: la tabla es de solo inserción (append-only).
- Eventos posteriores al corte de la instantánea: este informe está congelado a 2026-08-14T00:00:00Z. Los datos siguen acumulándose, pero todas las cifras de esta página y de los archivos descargables proceden de ese único punto congelado.
Tamaño mínimo de celda
Las celdas con n<30 o con menos de 5 identificadores de estudiante se marcan como SUPPRESSED (suprimidas): se publica el número de eventos, pero no el porcentaje de acierto. Las celdas con n≥30 y ≥5 identificadores pero con n<100 se marcan como LOW_SAMPLE (muestra pequeña) y deben citarse siempre junto con n. Las celdas con n≥100 y ≥5 identificadores se marcan como OK.
En esta instantánea, 23 puntos de conocimiento están en OK, 12 en LOW_SAMPLE y 3 en SUPPRESSED.
Anonimización
- Cada evento lleva únicamente un UUID anónimo de dispositivo generado en el navegador. Ningún nombre, correo electrónico, dirección IP, huella digital del dispositivo ni texto libre de ningún tipo.
- La Cloudflare Pages Function que recibe los datos escribe solo columnas de una lista permitida y nunca escribe direcciones IP, de forma explícita.
- El conjunto de datos público contiene solo estadísticas agregadas: ni un solo evento de respuesta bruto.
- Los estudiantes pueden excluirse de la recopilación agregada con un solo clic en la página de la política de privacidad.
10. Limitaciones (cítalas junto con las cifras)
Si solo vas a leer un párrafo, que sea este. Estos datos describen cómo les fue, en las preguntas de Nihongo to Japan, a las personas que acudieron a Nihongo to Japan a practicar. No son un retrato de quienes estudian japonés en Taiwán, no son una medida de la dificultad del JLPT y no sirven para comparar la dificultad objetiva de los distintos niveles.
- Sesgo de selección: la muestra la forman personas que eligieron practicar aquí. Es probable que estén más motivadas que el conjunto de estudiantes y, posiblemente, que sean más jóvenes y se manejen mejor con las herramientas en línea.
- Medidas repetidas: el identificador más activo acumula por sí solo el 3,7% de todas las respuestas y los diez más activos, el 19,4%. Sobre los mismos 372 identificadores, la ponderación por evento y la ponderación por identificador difieren en 7,04 puntos porcentuales.
- Los conjuntos de análisis no se pueden restar directamente: los contextos de lección y de prueba se basan en conjuntos de preguntas casi disjuntos (de 5.772 preguntas de estructuras gramaticales, solo 6 aparecen en ambos), así que la diferencia de acierto entre ellos no puede atribuirse a una única causa.
- El uso de pistas y explicaciones no es observable: los campos correspondientes nunca se escriben, así que este conjunto de datos no afirma absolutamente nada al respecto.
- Dificultad desigual de las preguntas: cada nivel y cada eje se basan en un conjunto de preguntas distinto, así que el acierto bruto no es una medida normalizada de dificultad.
- Sin equiparación mediante TRI: no hay equiparación según la teoría de respuesta al ítem ni un diseño con ítems de anclaje entre niveles, así que estos datos no pueden responder qué nivel es más difícil.
- Tamaños de muestra desiguales: hay más de seis veces más respuestas de N5 que de N1.
- Ventana temporal corta: solo 12 días (el proceso de agregación entró en funcionamiento el 2026-08-02). De estos datos no se puede extraer ninguna tendencia longitudinal.
- No se puede identificar el tráfico automatizado: no hay ningún mecanismo para distinguir personas de scripts. El tiempo de respuesta es nulo en el 94% de los eventos, así que ni siquiera se puede aplicar un filtro básico de «respuestas imposiblemente rápidas». Es una carencia conocida en la calidad de los datos.
- No representativo de la población: no representa al conjunto de quienes estudian japonés en Taiwán ni en ningún otro país.
11. Cómo citar
Se pueden citar en artículos académicos, informes de investigación, materiales didácticos y periodismo. Indica la fuente con un enlace a esta página.
APA (7.ª ed.)
Nihongo to Japan. (2026). Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/en/research/japanese-learning-data-2026MLA (9.ª ed.)
Nihongo to Japan. Japanese Learning Answer Dataset — August 2026. Version 1.1.0, 2026, https://www.nihongotojapan.com/en/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/en/research/japanese-learning-data-2026}

}
Licencia
Los datos se publican con licencia CC BY 4.0: puedes usarlos libremente, también con fines comerciales, siempre que cites la fuente. Los gráficos y el texto del informe no están cubiertos. Las condiciones completas están en la sección Licencia.
Texto de atribución sugerido:
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Licencia: los datos son CC BY 4.0
Los datos de este conjunto se publican con licencia Creative Commons Atribución 4,0 Internacional (CC BY 4.0). Puedes copiarlos, redistribuirlos, adaptarlos y crear a partir de ellos, también con fines comerciales, siempre que des el crédito adecuado e indiques si has hecho cambios.
⚠️ La licencia cubre solo los datos. Lo que cubre CC BY 4.0: las cifras agregadas de esta página y los dos archivos descargables,japanese-learning-2026.jsonyjapanese-learning-2026.csv. Los gráficos elaborados por Nihongo to Japan (SVG/PNG) y el texto del informe no están cubiertos y conservan todos los derechos reservados.
Lo que puedes hacer sin pedirnos permiso
- Citar las estadísticas en artículos académicos, informes de investigación, materiales didácticos y periodismo, incluidas las publicaciones comerciales.
- Volver a analizar las cifras agregadas y elaborar tus propios gráficos: los gráficos que hagas tú son tuyos.
- Adaptar, remezclar, transformar y redistribuir en cualquier formato, incluido redistribuir los archivos de datos completos o integrarlos en tu propio producto de datos.
- Usar los datos en el aula y en contextos educativos.
Atribución
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Lo que te pedimos (no son condiciones de la licencia)
Lo siguiente no son condiciones de CC BY, y no cumplirlo no supone ninguna infracción. Aun así te lo pedimos, y explicamos el motivo de cada punto:
- Incluye las limitaciones del muestreo (muestra observacional autoseleccionada, solo 12 días, no representativa): citar las cifras sin ellas equivale a publicar una estadística engañosa.
- Enlaza a esta página: así tus lectores pueden ver la metodología y la versión.
- Escribe «identificadores de estudiante», no «personas»: el número de identificadores es un límite superior del número de personas, no un recuento de personas.
- Indica la versión (por ejemplo, v1.1.0, instantánea del 2026-08-14): así las cifras que citaste siguen siendo identificables tras actualizaciones posteriores.
Lo que no cubre la licencia
- Los gráficos que hemos elaborado (
/images/research/*.svgy*.png): contacta con nosotros antes de reproducirlos. Para dibujar tus propios gráficos a partir de los datos no necesitas permiso. - El texto del informe y de este sitio web: derechos reservados.
- El nombre del sitio, el logotipo y los elementos de marca: esta licencia no concede ningún derecho para usarlos.
⚠️ CC BY es irrevocable. Quien recibe los datos con estas condiciones conserva esos derechos aunque cambiemos las condiciones más adelante. Lo indicamos aquí porque quien cita los datos tiene derecho a saber hasta qué punto es estable su permiso.
12. Descargar los datos
Dos formatos con idéntico contenido, ambos solo con estadísticas agregadas (sin eventos de respuesta brutos):
- japanese-learning-2026.json: metadatos completos, definiciones, metodología, limitaciones y todas las celdas agregadas.
- japanese-learning-2026-LICENSE.txt: el aviso de licencia (CC BY 4.0, alcance, texto de atribución). Un CSV no tiene dónde incluirlo, así que se distribuye aparte.
- japanese-learning-2026.csv: una fila por celda. Columnas:
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag.
Versión 1.1.0 · instantánea del 2026-08-14 · versión de la metodología 1.1. Las actualizaciones futuras incrementarán el número de versión y conservarán las cifras anteriores en lugar de sobrescribirlas.
Archivos de los gráficos: los cuatro gráficos de esta página están disponibles en PNG (resolución 2×, para diapositivas y maquetación impresa) y en SVG (vectorial, escalable).
- Acierto bruto por eje de aprendizaje: PNG・SVG
- Acierto bruto por nivel del JLPT: PNG・SVG
- Puntos de conocimiento con menor acierto: PNG・SVG
- Distribución de la muestra: PNG・SVG
Cada gráfico lleva su propio título, n, versión y etiqueta de fuente, de modo que sigue indicando su propio alcance aunque circule por separado; el texto alternativo de los cuatro está recogido en alt-text.json. ⚠️ Los gráficos no están cubiertos por CC BY, así que contacta con nosotros antes de reproducirlos (consulta contacto); los datos en sí son CC BY 4.0 y se pueden usar libremente citando la fuente (consulta Licencia).
⚠️ Para citar, usa el conjunto de datos congelado y versionado, no el endpoint de agregados que se actualiza periódicamente.
También existe un endpoint de agregados que se actualiza periódicamente en /api/aggregates; sus cifras cambian con el tiempo (no es una versión congelada). Usa definiciones distintas: se basa en todos los eventos de respuesta, no en los primeros intentos en contexto de cuestionario, y su totalUsers cuenta solo los identificadores de estudiante del conjunto principal (688), no los 1.053. Sus cifras cambian cada día y no son adecuadas para citar.
Para periodistas
- Muestra: 56.613 respuestas anónimas de 1.053 identificadores anónimos de estudiante (no es un recuento verificado de personas) durante 12 días, del 2 al 13 de agosto de 2026.
- El método en una frase: acierto bruto sobre una muestra observacional autoseleccionada; las cifras principales usan el conjunto de primeros intentos en contexto de cuestionario (primeros intentos en los contextos de reto, prueba de nivel y entrenamiento).
- La limitación en una frase: no es una encuesta representativa de quienes estudian japonés y no sirve para comparar la dificultad objetiva de los niveles del JLPT.
Tres cifras que se pueden citar directamente:
- Acierto en estructuras gramaticales del 53,7% (n=8.678) frente al 92,1% en vocabulario (n=22.869): una diferencia de 38 puntos.
- La partícula が se responde correctamente el 60,9% de las veces (n=358); を llega al 78,7% (n=385).
- El acierto en estructuras gramaticales va del 53,7% al 74,1% según qué contextos de respuesta se incluyan (contexto de lección 85,4%, contexto de cuestionario 53,7%). ⚠️ Los dos contextos usan conjuntos de preguntas casi disjuntos, así que no se puede determinar la causa; pero eso, en sí mismo, ya es una noticia sobre cómo se citan los datos de las plataformas de aprendizaje.
Formatos de cita · Descargar los datos · Contacto
Inserta estos datos (pégalos en una entrada de blog o en material didáctico)
Pega el HTML siguiente en tu artículo o en tu material de clase. Ya incluye el tamaño de la muestra, la versión, la licencia y la advertencia de «no representativo de la población»: justo las partes que se pierden cuando las estadísticas se citan de segunda mano. No hace falta avisarnos antes.
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">Sobre 56,613 respuestas anónimas, el acierto en estructuras gramaticales en los primeros intentos en contexto de cuestionario fue del <strong>53.7%</strong> (n=8,678), frente al <strong>92.1%</strong> en vocabulario (n=22,869).</p><p style="margin:0;font-size:13px;color:#8a7a68">Fuente: <a href="https://www.nihongotojapan.com/en/research/japanese-learning-data-2026">Nihongo to Japan, Japanese Learning Answer Dataset — August 2026</a> v1.1.0 · CC BY 4.0 · muestra observacional autoseleccionada, no representativa de la población</p></blockquote>
¿Por qué un bloque para pegar y no un iframe? Por dos motivos: este sitio no permite que se le inserte en marcos (frame-ancestors 'none' en todo el sitio, una protección contra el clickjacking que preferimos mantener); y el contenido dentro de un iframe se sirve desde nuestro dominio, así que no cuenta como un enlace que da tu página, mientras que un bloque pegado sí. También eres libre de maquetarlo a tu manera: los datos son CC BY 4.0, así que solo pedimos la atribución.
Sobre las imágenes: nuestros gráficos no están cubiertos por la licencia, pero puedes dibujar los tuyos a partir del CSV, y ese gráfico es tuyo. Para el uso docente o en medios de nuestros propios gráficos, consulta el kit de prensa.
Kit de prensa
Todo lo que hay en esta sección se puede copiar y usar sin pedirnos permiso antes (salvo los gráficos; ver más abajo). Los datos básicos y las tres cifras directamente citables están en Para periodistas; la lista completa está en los diez hallazgos citables.
Texto institucional
Versión larga:
Nihongo to Japan es un sitio web para aprender japonés que gestiona de forma independiente un desarrollador en solitario. No requiere registro, su curso completo es gratis para siempre y cubre del JLPT N5 al N1 con explicaciones gramaticales, lecciones autodidactas y preguntas de práctica. Este conjunto de datos procede de los registros anónimos de respuestas generados por los estudiantes del sitio, agregados a partir de una instantánea congelada y publicados con su metodología y sus limitaciones completas.
Versión corta:
Nihongo to Japan, un sitio para aprender japonés gestionado de forma independiente y con el curso completo gratis para siempre, publica un conjunto de datos agregados de las respuestas anónimas de sus estudiantes.
Imágenes para publicación
Los gráficos que elaboramos no están cubiertos por CC BY 4.0 (la licencia cubre solo los datos; consulta Licencia). Preferimos que eso no se convierta en un obstáculo, así que hay dos vías:
- Pídenoslas: te enviamos archivos de imagen listos para publicar en un plazo de 24 horas (PNG y SVG), con el pie, el tamaño de la muestra y la etiqueta de versión correctos. Es una vía rápida para imágenes, más ágil que las consultas generales (2–3 días hábiles).
- O no esperes: dibuja los tuyos. Los datos en sí son CC BY 4.0, así que puedes elaborar tus propios gráficos directamente a partir del JSON o del CSV. Los gráficos que dibujes son tuyos: no necesitas permiso ni tienes que avisarnos.
Cuatro notas para informar con responsabilidad
No son condiciones: están aquí para que no tengas que publicar una corrección más adelante.
- ✅ Escribe «en este conjunto de respuestas» o «en los primeros intentos en preguntas de cuestionario». Todas las cifras de esta página son valores observados dentro de este conjunto de datos.
- ❌ No lo conviertas en «los estudiantes taiwaneses hacen X». La muestra la forman personas que eligieron practicar en este sitio; no representa a ninguna población más amplia.
- ❌ No compares la dificultad de los niveles del JLPT. Los niveles se basan en conjuntos de preguntas distintos, no hay equiparación mediante TRI y los intervalos de confianza del N3 y el N2 se solapan: estos datos no permiten distinguirlos.
- ❌ No lo formules en términos causales. Los datos pueden decir «se observan juntos»; no pueden decir «porque».
Si no tienes claro si una formulación concreta se sostiene, pregúntanos sin más: sale mucho más barato que una corrección después de publicar.
Citas atribuibles
Las dos citas siguientes se pueden usar directamente, sin pedir permiso.
«En los primeros intentos en preguntas de cuestionario, un 92,1% en vocabulario frente a un 53,7% en estructuras gramaticales. Esto solo describe a las personas que eligieron practicar en nuestro sitio; no se puede generalizar al conjunto de estudiantes. Pero si estás atascado en "conozco las palabras, pero no consigo construir la frase", no eres el único».
— Fundador de Nihongo to Japan
«Con los mismos datos, solo con cambiar qué respuestas se cuentan, el acierto en estructuras gramaticales pasa del 53,7% al 85,4%. Publicamos las cuatro definiciones una al lado de otra, porque una única cifra de titular no le permite al lector saber cuál está viendo».
— Fundador de Nihongo to Japan
No hay equipo de investigación ni responsable de prensa. Las citas anteriores se atribuyen a la persona que construyó de verdad este conjunto de datos; para obtener respuesta a una pregunta concreta, usa la sección de contacto.
Para investigadores y docentes
Estructura: una fila por celda agregada, indexada por dimension (axis / jlpt / knowledge_point / axis_x_jlpt) × analysis_set (quiz_first_attempt / lesson_first_attempt / first_attempt / all_events). Cada celda indica n, learners, accuracy, los límites de Wilson ci95_low/ci95_high y un flag. El JSON incluye además la descomposición por conjunto de análisis, la comparación pareada y el efecto de la ponderación.
Muestreo: autoseleccionado y observacional; la unidad de análisis es el evento de respuesta; un identificador de estudiante es un UUID anónimo, así que el número de identificadores es un límite superior del número de personas (la misma persona en dos dispositivos genera dos identificadores, y los identificadores no se pueden vincular entre sí).
Carencias metodológicas conocidas: creemos que vale más la pena exponerlas que ocultarlas.
- No hay equiparación de dificultad mediante TRI ni ítems de anclaje entre niveles, así que las comparaciones entre niveles no se sostienen.
- Los contextos de lección y de prueba se basan en conjuntos de preguntas casi disjuntos (solo 6 de las 5.772 preguntas de estructuras gramaticales coinciden), así que los efectos del contexto y la dificultad de los ítems no se pueden separar.
- Los campos de pista, explicación y clave de respuestas nunca se escriben, así que esos comportamientos no son observables. No pueden usarse como condiciones de análisis, y su ausencia no puede leerse como «no ocurrió».
- El tiempo de respuesta es nulo en el 94% de los eventos, así que no hay análisis de la relación velocidad–precisión ni filtrado de respuestas inverosímilmente rápidas.
- No hay variables demográficas (edad, lengua materna, años de estudio, país), así que no es posible un análisis estratificado. El conjunto de datos no tiene campo de lengua materna ni campo geográfico, así que este informe no hace ninguna inferencia sobre la lengua materna ni la ubicación de los estudiantes.
- Una ventana de 12 días, así que no hay curvas de aprendizaje ni análisis de retención.
- No se publican datos a nivel de estudiante (solo agregados), así que no se pueden reajustar externamente modelos multinivel. Si eso es importante para tu investigación, ponte en contacto con nosotros.
Descargar JSON · Descargar CSV · Formatos de cita · Metodología completa
Contacto para medios y datos
Fundador de Nihongo to Japan · Correo electrónico: [email protected]
Respondemos con gusto sobre: detalles de la metodología, nuevas comprobaciones de cualquier cifra agregada, solicitudes para reproducir los gráficos, los límites de lo que estos datos permiten afirmar y si el conjunto de datos puede responder a una pregunta concreta. Solemos responder en 2–3 días hábiles; las solicitudes de imágenes listas para publicar por parte de medios tienen vía rápida y se responden en un plazo de 24 horas (consulta el kit de prensa).
El sitio lo gestiona de forma independiente un desarrollador en solitario. No hay equipo de investigación ni responsable de prensa: la dirección anterior llega a la persona que construyó de verdad este conjunto de datos, no a una recepción. Lo indicamos aquí porque quien cita los datos tiene derecho a saber quién está detrás.
Versiones y registro de cambios
Esta URL apunta siempre a la instantánea más reciente. Cada publicación lleva un número de versión y una fecha de congelación, así que incluye la versión al citar (por ejemplo: v1.1.0, instantánea del 2026-08-14): cuando más adelante se actualicen las cifras, la versión que citaste seguirá siendo identificable. Las descargas en JSON y CSV llevan los mismos campos de versión.
| Versión | Instantánea congelada | Cobertura | Notas |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | Del 2026-08-02 al 10-21 (81 días) | Versión más reciente, en su propia URL (conjuntos de análisis distintos). |
| v1.1.0 | 2026-08-14 | Del 2 al 13 de agosto de 2026 (12 días) | Primera publicación. Conjunto de análisis principal: primeros intentos en contexto de cuestionario; se publican los cuatro conjuntos de análisis uno al lado de otro. |
Se prevé que la próxima publicación llegue tras unos tres meses más de datos, que es el primer momento en el que podría hablarse de alguna tendencia. Actualizar los datos no reescribirá las cifras de una versión ya publicada: una nueva publicación recibe un nuevo número de versión y una nueva fecha de congelación, y las cifras anteriores siguen siendo identificables por su versión. Si ya has citado una versión y sus cifras cambian, escríbenos y te diremos exactamente qué ha cambiado.
← Volver a Investigación y datos | Cómo aprende japonés Taiwán en 2026 | Para docentes y bibliotecas