Conjunto de datos de respuestas de aprendizaje de japonés — octubre de 2026: 543.344 respuestas, dificultad ajustada por habilidad y espaciado de los repasos
En una frase: estadísticas agregadas de 543.344 respuestas anónimas en Nihongo to Japan, que abarcan del 2 de agosto al 21 de octubre de 2026 (81 días) y 25.850 preguntas: 9,6 veces el volumen de la edición de agosto (v1.1.0).
⚠️ La v2 y la v1 usan conjuntos de análisis distintos. No restes el porcentaje de acierto de una edición al de la otra. La v1 se calculó directamente a partir de la base de datos, con los «primeros intentos en contexto de cuestionario» como conjunto principal. La v2 utiliza deliberadamente solo endpoints públicos de datos agregados que cualquiera puede consultar (/api/aggregates,/api/community), así que sus medidas principales son «todas las respuestas» y «primeros intentos a nivel de pregunta, un voto por pregunta». La ventaja es la reproducibilidad: el sha256 de cada archivo de entrada queda registrado en la descarga, de modo que cualquier investigador externo puede verificar exactamente qué datos usamos. Consulta la Metodología.
Lo que este conjunto de datos no es. No es una encuesta representativa de estudiantes de japonés. La muestra está formada por personas que eligieron practicar en este sitio web: una muestra autoseleccionada y observacional. Cada cifra describe únicamente lo que ocurrió en el registro de respuestas de NTJ; ninguna es generalizable a una población y ninguna constituye una afirmación causal. Consulta las Limitaciones.
Diez hallazgos citables
Cada punto es autónomo: menciona el conjunto de datos, el periodo, el tamaño de la muestra y el conjunto de análisis, de modo que puede citarse por separado. Te pedimos que cites también las limitaciones.
- El Conjunto de datos de respuestas de aprendizaje de japonés de NTJ (octubre de 2026, v2.0.0) contiene 543.344 respuestas anónimas a 25.850 preguntas registradas entre el 2 de agosto y el 21 de octubre de 2026: 9,6 veces las 56.613 respuestas de la edición de agosto de 2026 del sitio.
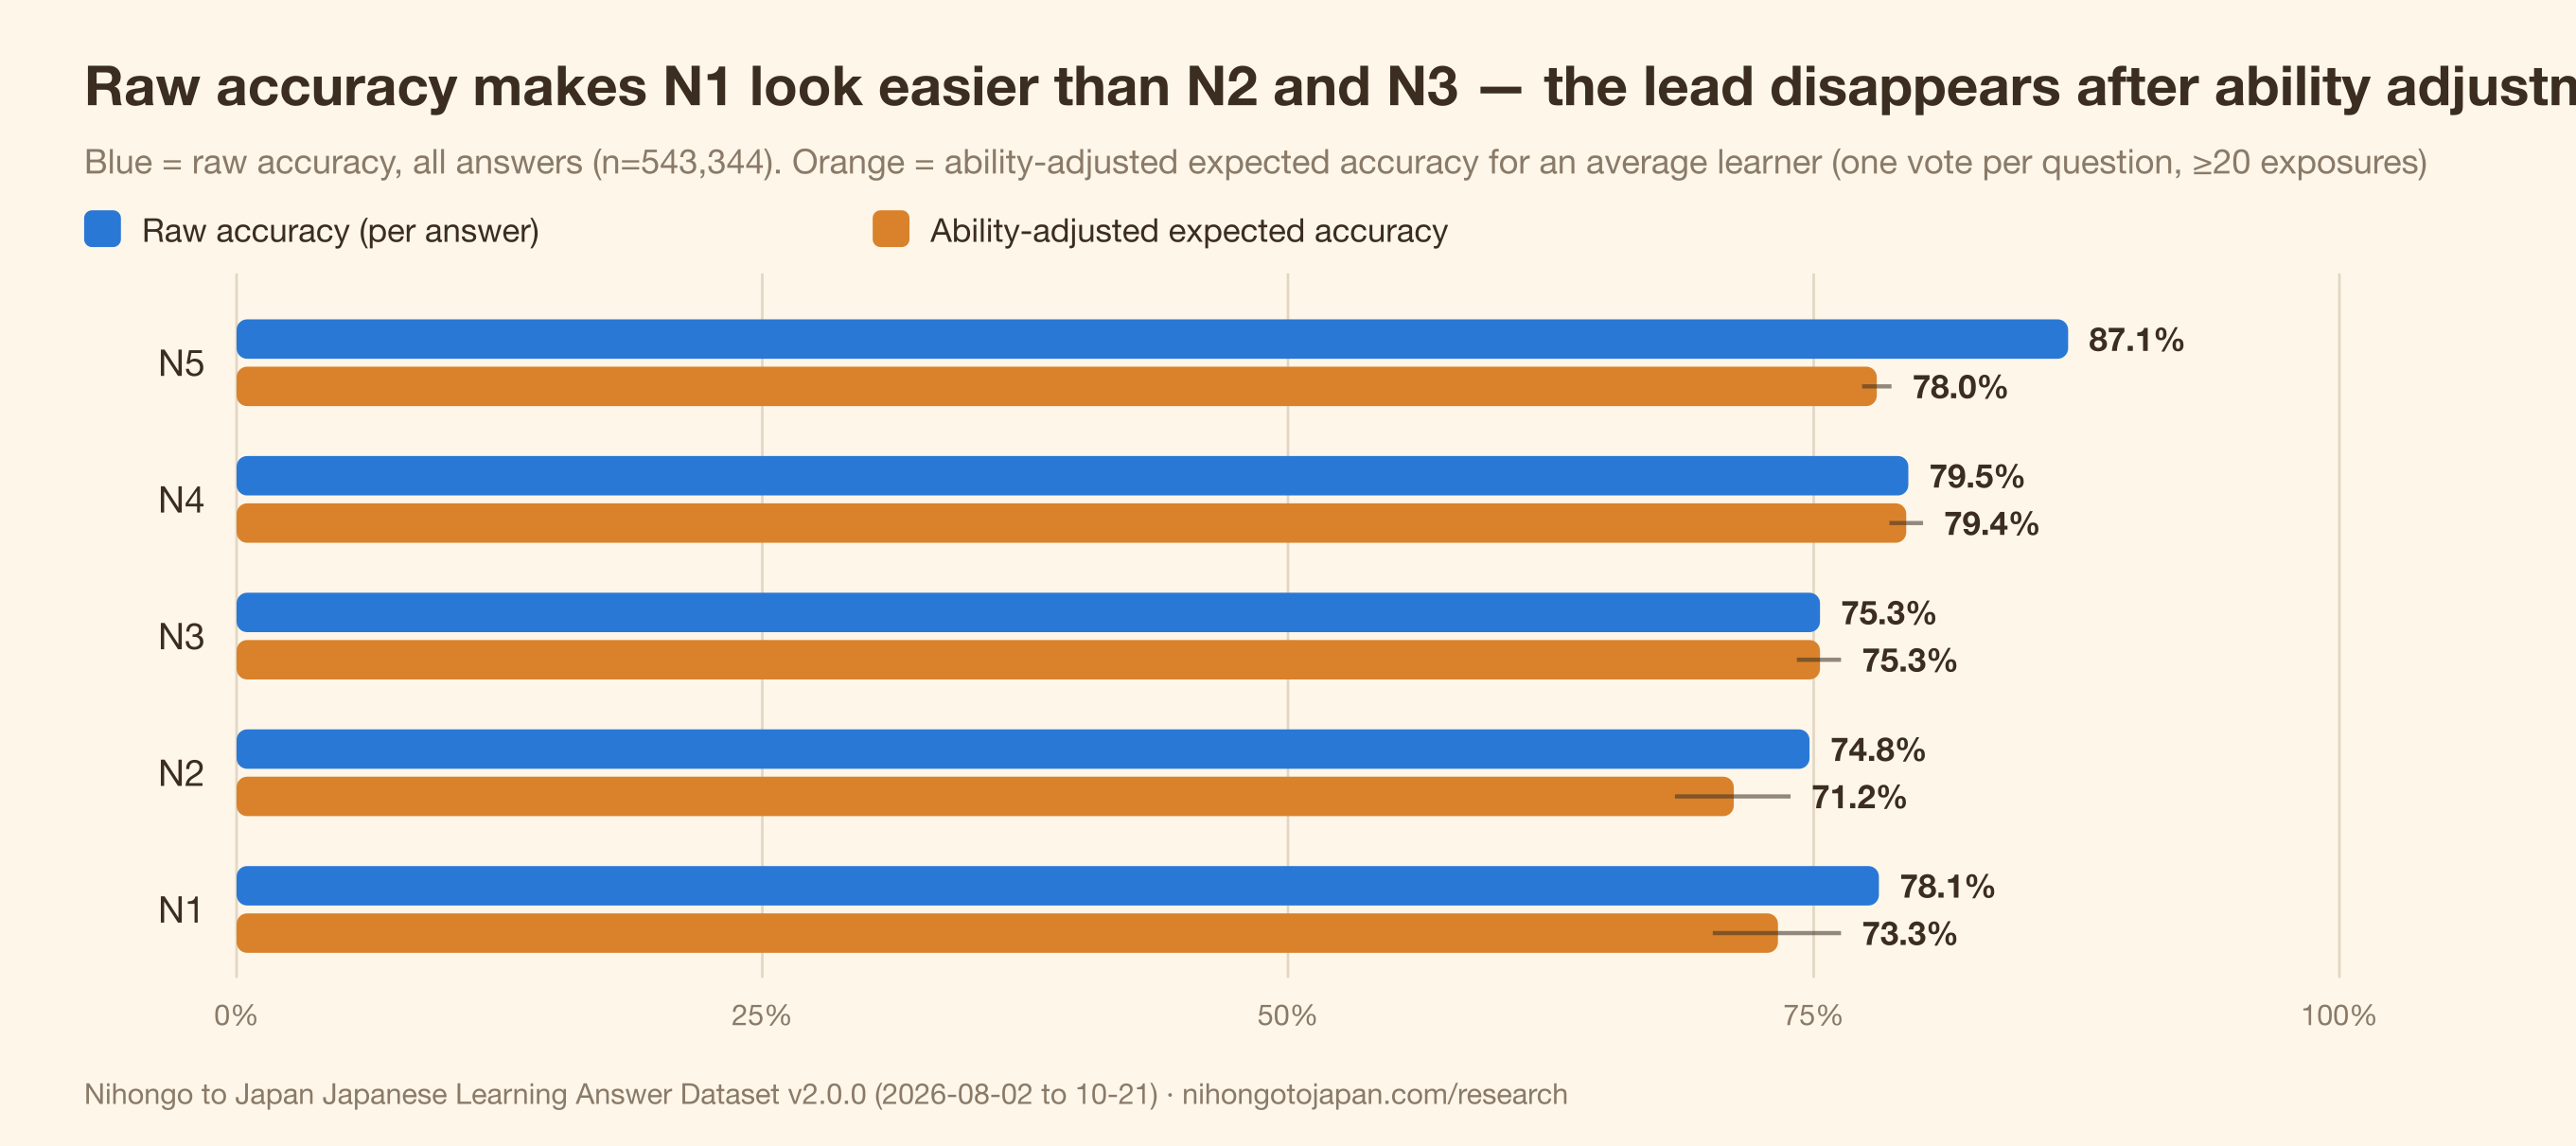
- Sobre todas las respuestas del mismo conjunto de datos, el porcentaje de acierto bruto por nivel del JLPT es N5 87,1%, N4 79,5%, N3 75,3%, N2 74,8% y N1 78,1% (n=33.082): N1 obtiene un resultado más alto que N2 y que N3.
- Tras eliminar el efecto de la habilidad del estudiante con una estimación de Rasch en un solo paso (un voto por pregunta, ≥20 exposiciones), el porcentaje de acierto esperado para un estudiante medio es N3 75,3% (IC 95% 74,2–76,3%, 847 preguntas), N1 73,3% (70,2–76,3%, 210 preguntas) y N2 71,2% (68,4–73,9%, 204 preguntas). La ventaja de N1 sobre N3 desaparece, lo que concuerda con un efecto de selección en el que son los estudiantes más fuertes quienes intentan las preguntas de N1.
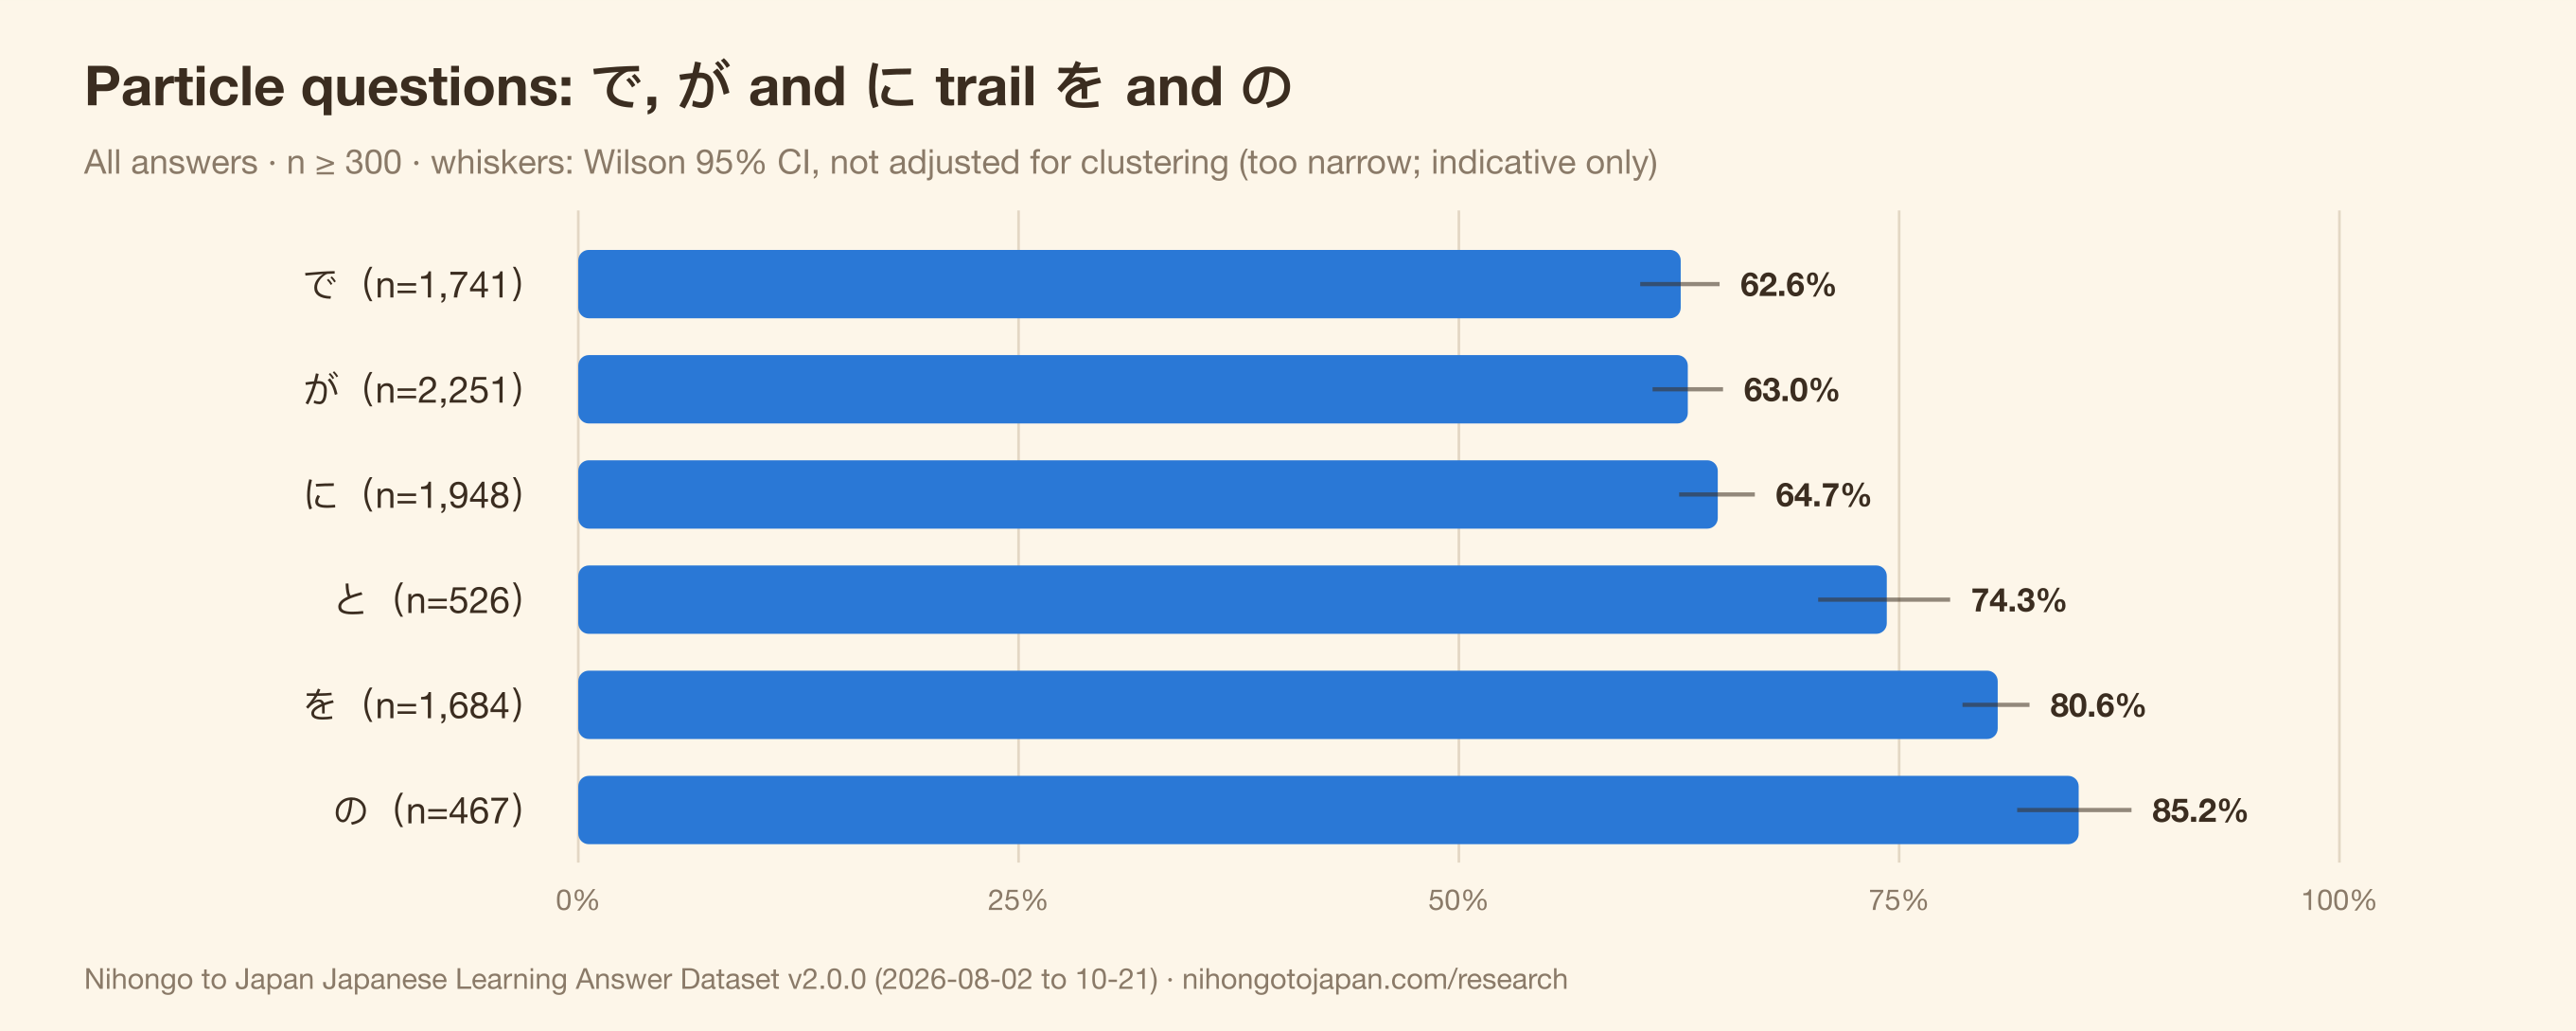
Los intervalos ajustados de N1 y N3 se solapan, así que esto no demuestra que N1 sea más difícil que N3; solo que no se puede confiar en el orden bruto. - Sobre todas las respuestas, las partículas con menor acierto son で 62,6% (n=1.741), が 63,0% (n=2.251) y に 64,7% (n=1.948); las de mayor acierto son を 80,6% (n=1.684) y の 85,2% (n=467): una diferencia de 22,6 puntos entre で y の.
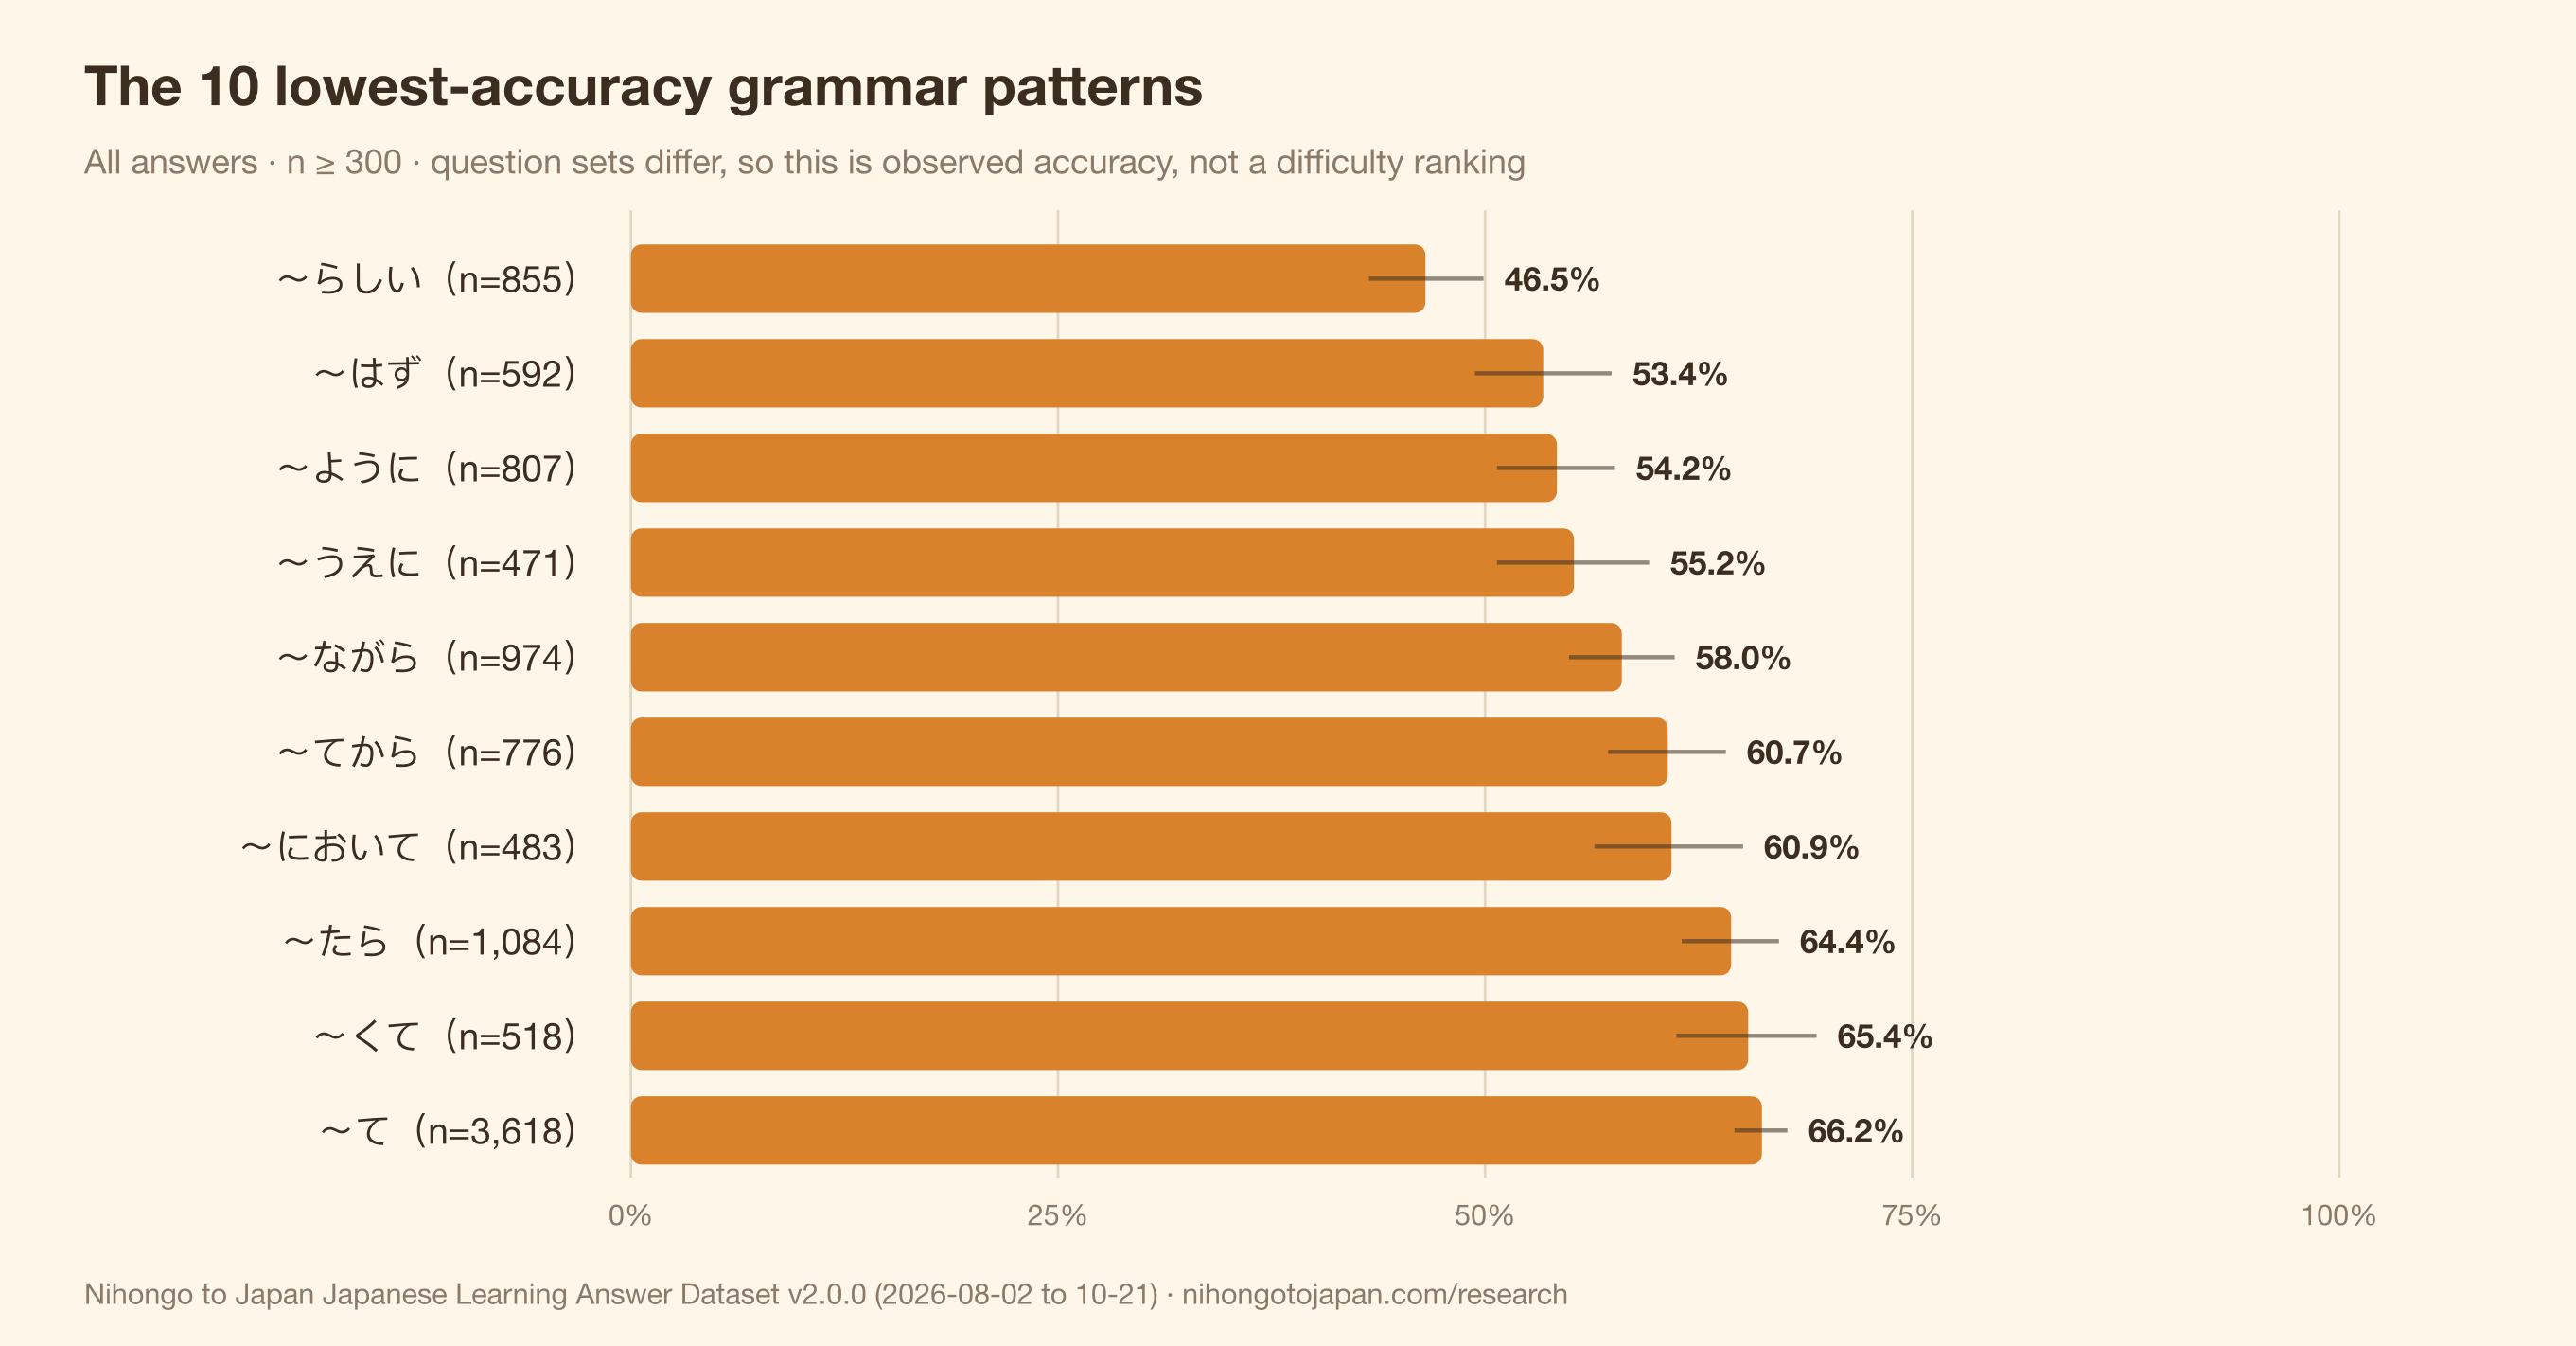
- Entre las estructuras gramaticales con n ≥ 300, el menor acierto sobre todas las respuestas corresponde a 〜らしい 46,5% (n=855), seguida de 〜はず 53,4% (n=592), 〜ように 54,2% (n=807), 〜うえに 55,2% (n=471) y 〜ながら 58,0% (n=974).
- Entre las preguntas de formas verbales, la forma potencial obtiene el resultado más bajo, 64,5% (n=1.923), y la forma ます el más alto, 84,0% (n=2.270), con la forma た en 70,7%, la forma て en 74,1% y la forma ない en 75,0% entre ambas.
- Contando un voto por pregunta (7.057 preguntas con ≥20 exposiciones), el porcentaje medio de acierto en el primer intento es 89,1% en vocabulario (IC 95% 88,7–89,5%), 73,9% en estructuras gramaticales (73,1–74,7%) y 67,6% en partículas (64,9–70,4%).
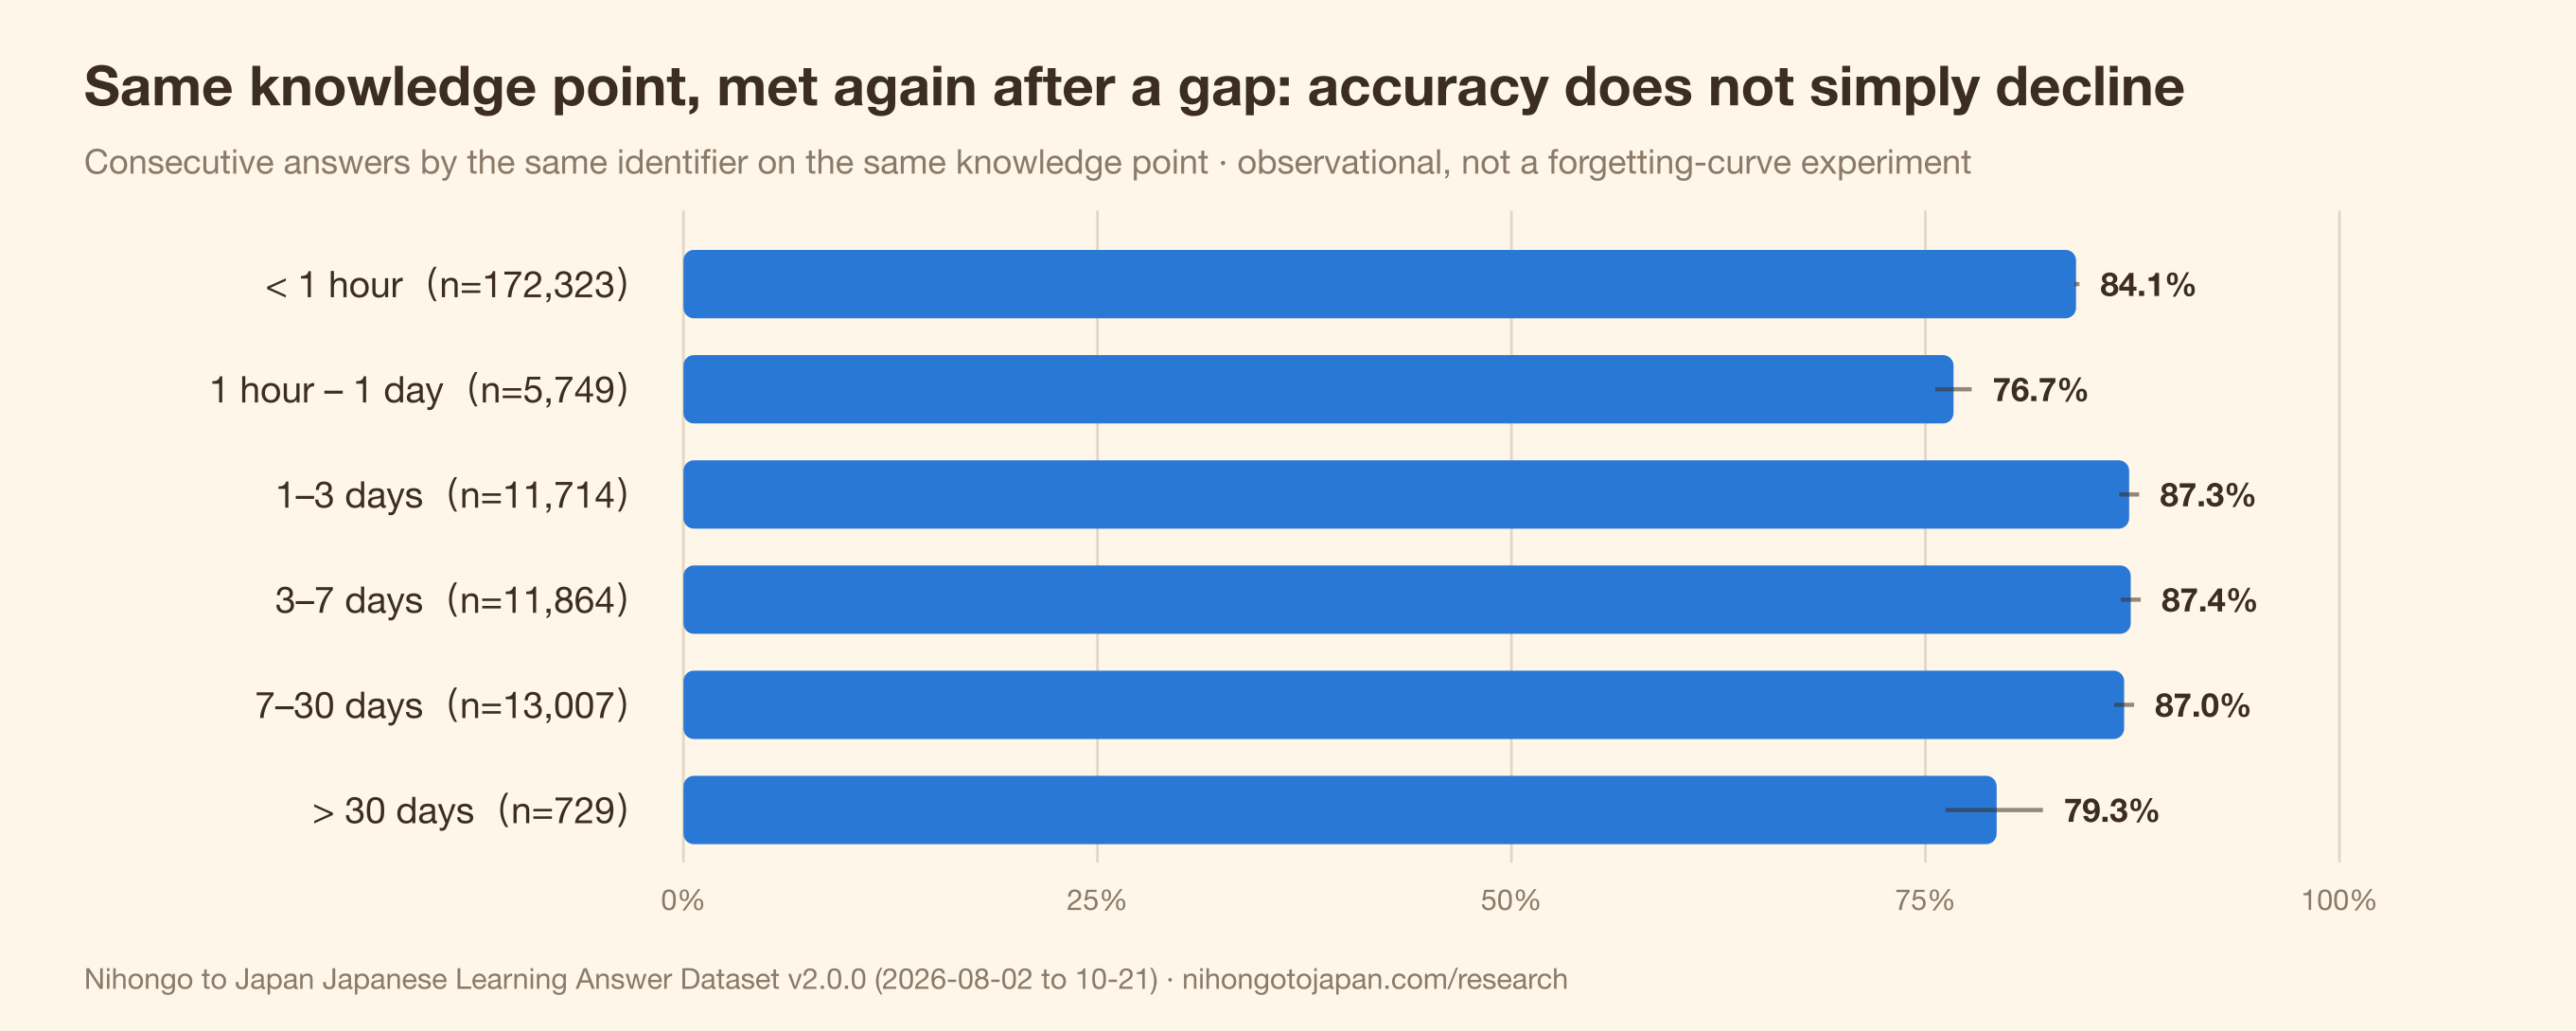
- En respuestas consecutivas del mismo identificador sobre el mismo punto de conocimiento, el acierto es del 84,1% cuando el intervalo es inferior a una hora, del 76,7% entre 1 hora y 1 día, del 87,0–87,4% en los tramos de 1–3, 3–7 y 7–30 días, y del 79,3% a partir de 30 días (n=729). El acierto no disminuye de forma monótona con el intervalo.
Es un dato observacional: quién vuelve al cabo de unos días no es aleatorio. No demuestra que repasar al cabo de unos días sea lo más eficaz. - De las 7.057 preguntas con ≥20 exposiciones, 283 (4,0%) tienen un acierto en el primer intento inferior al 35% (responder al azar con cuatro opciones da aproximadamente un 25%). Una causa habitual es que exista una segunda opción defendible; estas preguntas están en una cola de revisión manual.
- El modelo de predicción de respuestas v2 del sitio obtiene una puntuación de Brier de 0,199 sobre 257.010 respuestas, un 51,4% menos que el 0,409 de la v1, pero sigue siendo peor que el 0,161 de una línea base constante que siempre predice el acierto global del 79,9%. Solo la versión que añade la dificultad a nivel de pregunta (0,130) supera la línea base.
1. Cinco hallazgos principales
1. «N1 es más fácil que N3» es una ilusión creada por la selección
Según el acierto bruto sobre todas las respuestas, N1 (78,1%) supera a N3 (75,3%) y a N2 (74,8%). Eso tiene poco sentido, y la v1 observó lo mismo. La explicación más probable es quién responde: quienes entran en las preguntas de N1 ya tienen un nivel más alto.
La v2 recalcula los resultados con la dificultad ajustada por habilidad: el resultado observado de cada pregunta se corrige según la habilidad media de las personas que realmente la respondieron y luego se expresa como la probabilidad de que un estudiante medio la acierte. Tras el ajuste, la ventaja de N1 desaparece (N3 75,3%, N1 73,3%, N2 71,2%).
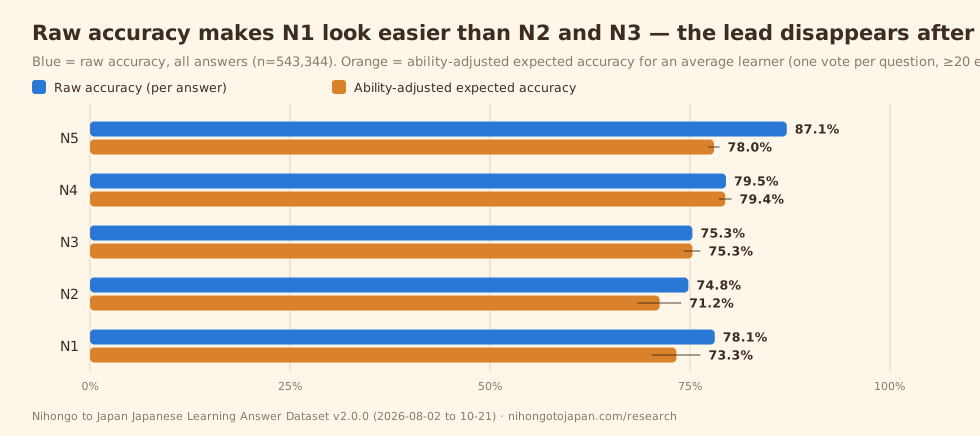
Dos salvedades. Primera: los intervalos ajustados de N1 y N3 siguen solapándose, así que no podemos afirmar que N1 sea más difícil que N3. Segunda: el N5 ajustado (78,0%) no queda por encima del N4 (79,4%): el ajuste corrige quién responde, no qué preguntas contiene cada nivel; el 53% de las preguntas de N5 del análisis son de estructuras gramaticales, frente al 33% en N4, y las preguntas de estructuras son más difíciles de acertar que las de vocabulario.
2. La brecha de las partículas: で, が y に quedan unos 20 puntos por detrás de を y の
で (62,6%), が (63,0%) y に (64,7%) se sitúan casi 20 puntos por debajo de を (80,6%) y の (85,2%). Lo que tienen en común las tres más bajas es una sola partícula con muchos usos: で marca el lugar, el medio, la causa y el ámbito; に marca el momento, el destino, el destinatario y la finalidad.
Esto coincide con la v1 («la diferencia dentro de las partículas es mayor que la diferencia entre niveles»), y la muestra más amplia de la v2 hace más estable la dirección del resultado.
3. Las estructuras más difíciles se concentran en la inferencia y en la finalidad o el estado
De las cinco estructuras con menor acierto, 〜らしい (46,5%) y 〜はず (53,4%) expresan ambas inferencia o expectativa y se confunden fácilmente con 〜そう, 〜よう y 〜みたい; 〜ように (54,2%) abarca finalidad, cambio y peticiones; 〜ながら (58,0%) se confunde a menudo con 〜て y 〜まま.
Las formas verbales muestran una estructura parecida: la forma potencial (64,5%) es la más baja de las cinco. Sus reglas difieren entre verbos ichidan, godan e irregulares, y además los estudiantes se encuentran con variantes coloquiales sin ら.
4. El acierto tras un intervalo no disminuye sin más
Emparejando respuestas consecutivas del mismo identificador sobre el mismo punto de conocimiento, agrupadas por intervalo:
| Intervalo | Respuestas | Identificadores | Acierto |
|---|---|---|---|
| < 1 hora | 172.323 | 3.472 | 84,1% |
| 1 hora – 1 día | 5.749 | 647 | 76,7% |
| 1–3 días | 11.714 | 532 | 87,3% |
| 3–7 días | 11.864 | 449 | 87,4% |
| 7–30 días | 13.007 | 405 | 87,0% |
| > 30 días | 729 | 126 | 79,3% |
La curva del olvido de los manuales dice que, cuanto más largo es el intervalo, más se olvida. Aquí, el tramo de 1 hora a 1 día es el más bajo y el de 1 a 30 días el más alto. No lo interpretamos como «repasar al cabo de unos días es lo más eficaz»: quién vuelve al cabo de unos días no es aleatorio; los estudiantes que regresan están más implicados y posiblemente tienen más nivel. El grupo de 1 hora a 1 día tiene solo 647 identificadores y puede incluir a personas que repiten una serie en un segundo dispositivo el mismo día. Responder a la cuestión del espaciado requiere un experimento aleatorizado, algo que este conjunto de datos no puede ofrecer.
5. El modelo de predicción redujo su error a la mitad, pero aún no supera la línea base más simple
El recomendador de preguntas del sitio predice primero la probabilidad de que respondas correctamente. Lo evaluamos con la puntuación de Brier (diferencia cuadrática media entre la probabilidad predicha y el resultado; cuanto más baja, mejor):
- Modelo v1: 0,409
- Modelo v2: 0,199 (un 51,4% menos)
- v2 con dificultad a nivel de pregunta: 0,130 (un 68,1% menos)
- Referencia: una línea base constante que siempre predice el 79,9% global: 0,161
La v2 reduce a la mitad el error de la v1, pero en conjunto sigue perdiendo frente a la línea base constante; solo al añadir la dificultad a nivel de pregunta la supera. Lo publicamos porque muestra directamente que la dificultad de la pregunta predice el acierto mejor que el nivel del estudiante, y esa es también la razón por la que el hallazgo 1 necesita el ajuste por habilidad.
2. Visión general del conjunto de datos
| Elemento | Valor | Notas |
|---|---|---|
| Respuestas válidas | 543.344 | Instantánea agregada del 2026-10-21 a las 19:18 UTC, ámbito all_clean_events (con las reglas de depuración del sitio aplicadas) |
| Identificadores de estudiante (≥1 respuesta de grado A) | 5.410 | totalUsers en el endpoint de datos agregados |
| Identificadores de estudiante (todos) | 8.073 | Endpoint de la comunidad; es un límite superior del número de personas |
| Preguntas respondidas | 25.850 | 7.057 con ≥20 exposiciones entran en el análisis a nivel de pregunta |
| Preguntas con dificultad ajustada | 18.139 | Estimación de Rasch en un solo paso con contracción bayesiana empírica |
| Grado de evidencia | A 59,8% · B 33,5% · C 6,7% | A = contexto de cuestionario; B = práctica de lección; C = otros (igual que en la v1) |
| Cobertura | 2026-08-02 a 10-21 | 81 días |
Sobre el contador en directo: la cifra de la página de inicio «Los estudiantes de NTJ han completado 552.850 respuestas de práctica» es el valor en directo del endpoint de la comunidad el 2026-10-23, unas 9.500 más que en este conjunto de datos: son las respuestas añadidas en los dos días posteriores a la instantánea. Cita 543.344.
3. Ejes de competencia (todas las respuestas)
| Eje | Respuestas | Acierto | Primer intento a nivel de pregunta (preguntas) |
|---|---|---|---|
| Vocabulario | 267.127 | 90,1% | 89,1% (3.398) |
| Estructuras gramaticales | 234.602 | 75,2% | 73,9% (3.252) |
| Formas verbales | 18.479 | 75,2% | 76,2% (154) |
| Partículas | 13.870 | 71,3% | 67,6% (189) |
| Expresiones idiomáticas | 7.413 | 88,1% | 92,4% (64) |
| Lectura | 1.103 | 78,7% | — |
| Comprensión auditiva | 605 | 69,8% | — |
| Expresión oral | 118 | SUPRIMIDO | — |
Lectura, comprensión auditiva y expresión oral son tipos de pregunta más recientes con muestras pequeñas; la expresión oral está por debajo del umbral de 300 respuestas, por lo que solo se indica su recuento.
4. Niveles del JLPT
| Nivel | Acierto sobre todas las respuestas (n) | Primer intento a nivel de pregunta (preguntas) | Acierto esperado ajustado por habilidad (IC 95%) |
|---|---|---|---|
| N5 | 87,1% (297.809) | 82,6% (3.817) | 78,0% (77,3–78,7%) |
| N4 | 79,5% (93.609) | 84,5% (1.766) | 79,4% (78,6–80,2%) |
| N3 | 75,3% (82.010) | 75,7% (1.008) | 75,3% (74,2–76,3%) |
| N2 | 74,8% (36.837) | 66,9% (249) | 71,2% (68,4–73,9%) |
| N1 | 78,1% (33.082) | 74,2% (217) | 73,3% (70,2–76,3%) |
Las tres columnas usan conjuntos de análisis distintos; compara dentro de cada columna, no entre columnas. La columna 1 cuenta todas las respuestas, incluidas las repetidas, y depende de la combinación de tipos de pregunta de cada nivel; la columna 2 da un voto a cada pregunta; la columna 3, además, elimina el efecto de la habilidad del estudiante.
5. Calidad de las preguntas: también medimos nuestro propio banco de preguntas
| Acierto en el primer intento | Preguntas |
|---|---|
| < 35% | 283 |
| 35–50% | 377 |
| 50–70% | 971 |
| 70–85% | 1.347 |
| 85–95% | 1.937 |
| ≥ 95% | 2.142 |
Las 283 preguntas (4,0%) por debajo del 35% no son necesariamente malas: algunas simplemente son difíciles. Pero nuestra revisión manual de agosto detectó que en esta franja suele haber una segunda opción defendible (por ejemplo, tanto が como を funcionan en 「ピアノ_弾けます」). Además, el sistema marca 415 preguntas para revisión según criterios como una discriminación claramente negativa. La precisión de esa marca es de aproximadamente 0,19: es una cola de revisión, no una lista de preguntas defectuosas.
6. Cómo pueden usar esto docentes y diseñadores de materiales
- Partículas: で, が y に quedan unos 20 puntos por detrás de を y の. Practicar un uso cada vez, con sus propios ejemplos, es más preciso que ejercitar la partícula en bloque.
- Expresiones de inferencia: 〜らしい y 〜はず son las estructuras que más se fallan aquí; contrástalas con 〜そう, 〜よう y 〜みたい.
- Forma potencial: la más baja de las cinco formas verbales; practícala por separado según el grupo verbal.
- Al leer tus propios datos: si tu plataforma también muestra que las preguntas avanzadas obtienen mejores resultados que las intermedias, sospecha de la selección antes que de las preguntas.
7. Metodología
Fuentes y reproducibilidad
Todas las cifras de la v2 proceden de seis endpoints públicos, consultados y congelados el 2026-10-23: /api/aggregates?kind=summary, kind=items, kind=difficulty, kind=spacing, kind=brier y /api/community?kind=overview. La hora de la instantánea de cada endpoint y el sha256 de cada archivo de entrada figuran en la descarga JSON, en dataset.source_snapshot_at_utc y dataset.input_sha256. El script de construcción, scripts/build-research-dataset-2026-10.py, no tiene acceso a datos a nivel de estudiante.
Cinco conjuntos de análisis
- Todas las respuestas (ejes, niveles, puntos de conocimiento): cuenta cada respuesta válida, incluidas las repeticiones del mismo identificador.
- Primeros intentos a nivel de pregunta: para cada pregunta, el acierto del primer intento de cada identificador, promediado después entre preguntas. Solo preguntas con ≥20 exposiciones; los IC 95% toman la pregunta como unidad.
- Dificultad ajustada por habilidad: estimación de Rasch en un solo paso b̂ = θ̄ (habilidad media de quienes realmente respondieron) − logit(p̂), contraída hacia la media del eje con un peso n/(n+5) y convertida en la tasa de error esperada para un estudiante con la habilidad media del sitio. Indicamos 1 − error esperado.
- Pares de respuestas consecutivas (espaciado): respuestas consecutivas del mismo identificador sobre el mismo punto de conocimiento, solo con grados de evidencia A y B.
- Precisión de las predicciones: todas las respuestas de grado A que llevan predicciones tanto de la v1 como de la v2 (los campos de predicción existen desde el 2026-08-20).
Tamaños mínimos de celda
Se suprimen las celdas a nivel de respuesta con n < 300; los puntos de conocimiento solo se incluyen con n ≥ 300; los análisis a nivel de pregunta incluyen solo preguntas con ≥20 exposiciones.
Intervalos de confianza
Los IC de Wilson al 95% a nivel de respuesta no están ajustados por las respuestas repetidas del mismo identificador (los endpoints públicos no exponen datos a nivel de identificador), por lo que son demasiado estrechos y solo orientativos. Los IC a nivel de pregunta toman la pregunta como unidad de muestreo: describen este banco de preguntas, no una población de estudiantes.
Anonimato
Los endpoints públicos devuelven solo datos agregados. Este conjunto de datos no contiene respuestas individuales en bruto, ni identificadores, ni marcas de tiempo a nivel de respuesta.
8. Limitaciones (cítalas junto con las cifras)
- Muestra observacional autoseleccionada de personas que practican en NTJ; no es representativa de ninguna población de estudiantes.
- Los identificadores no son personas: los identificadores anónimos de navegador no se pueden unificar entre dispositivos; 8.073 es un límite superior.
- Conjuntos de preguntas distintos: niveles, ejes y puntos de conocimiento usan preguntas diferentes, así que las diferencias de acierto no son clasificaciones por dificultad.
- Las cifras sobre todas las respuestas están infladas por la práctica repetida.
- El ajuste por habilidad tiene supuestos: el modelo de Rasch supone una única dimensión de habilidad; la habilidad solo se estima para los identificadores con suficientes respuestas.
- Los IC a nivel de respuesta son demasiado estrechos (consulta la Metodología).
- Truncamiento de la lista de preguntas:
kind=itemsdevuelve como máximo 25.000 preguntas, ordenadas de mayor a menor exposición (de 25.850); las 850 que faltan son las de menor exposición y no afectan al análisis con ≥20 exposiciones. - Solo los 100 puntos de conocimiento principales: el endpoint de datos agregados devuelve los 100 puntos de conocimiento con más respuestas.
- El tiempo de respuesta no es utilizable: las pestañas abiertas e inactivas inflan la media, por lo que no se informa del tiempo de respuesta.
- Ninguna afirmación causal en todo este informe.
9. Cómo citar
Puedes citar este conjunto de datos en artículos académicos, informes, materiales didácticos y noticias. Indica la fuente, la versión e incluye un enlace a esta página.
APA (7.ª edición)
Nihongo to Japan. (2026). Japanese learning answer dataset — October 2026 (Version 2.0.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026-10MLA (9.ª edición)
Nihongo to Japan. Japanese Learning Answer Dataset — October 2026. Version 2.0.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10.BibTeX
@misc{ntj_jlad_2026_10,

  title = {Japanese Learning Answer Dataset --- October 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {2.0.0},

  note = {Snapshot 2026-10-21; aggregate statistics from 543,344 anonymous answer events, 2 August -- 21 October 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026-10}

}
Licencia: los datos se publican bajo CC BY 4.0
Los datos de este conjunto se publican bajo la licencia Creative Commons Atribución 4,0 Internacional (CC BY 4.0). Puedes copiarlos, redistribuirlos, adaptarlos y basarte en ellos, también con fines comerciales, siempre que reconozcas adecuadamente la autoría e indiques si has realizado cambios.
⚠️ La licencia cubre solo los datos: las cifras agregadas de esta página y las dos descargasjapanese-learning-2026-10.jsonyjapanese-learning-2026-10.csv. Nuestros gráficos (SVG/PNG) y el texto del informe no están cubiertos; todos los derechos reservados.
Atribución
Nihongo to Japan, Japanese Learning Answer Dataset — October 2026, v2.0.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10Nuestras peticiones (no son condiciones de la licencia)
- Menciona las limitaciones: muestra autoseleccionada, observacional, no representativa.
- Indica el conjunto de análisis: las cifras sobre todas las respuestas, de primeros intentos a nivel de pregunta y ajustadas por habilidad difieren mucho.
- Escribe «identificadores de estudiante», no «personas».
- Indica la versión (v2.0.0, instantánea del 2026-10-21).
⚠️ La licencia CC BY es irrevocable. Quien obtenga los datos en estas condiciones conserva esos derechos aunque más adelante cambiemos nuestras condiciones.
10. Descargas
- japanese-learning-2026-10.json: metadatos completos, sha256 de las entradas, umbrales y todas las celdas agregadas.
- japanese-learning-2026-10.csv: una fila por celda; columnas
table, key, n, value, ci95_low, ci95_high, unit, note. - japanese-learning-2026-10-LICENSE.txt: declaración de licencia.
Archivos de los gráficos (PNG a resolución 2×, SVG escalable; los gráficos no están bajo CC BY: ponte en contacto con nosotros antes de reproducir uno):
- Acierto bruto frente a ajustado por habilidad: PNG · SVG
- Acierto en partículas: PNG · SVG
- Las 10 estructuras con menor acierto: PNG · SVG
- Acierto según el intervalo de repaso: PNG · SVG
El texto alternativo de todos los gráficos está en alt-text.json.
Contacto para medios y consultas sobre los datos
Para desgloses más detallados, posibles errores o dudas sobre qué cifra citar, escribe a [email protected] indicando «Dataset v2.0.0» en el asunto.
Versiones
| Versión | Instantánea | Cobertura | Notas |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 a 10-21 (81 días) | Esta página. Construida a partir de endpoints públicos de datos agregados; añade dificultad ajustada por habilidad, espaciado, calidad de las preguntas y precisión de las predicciones. |
| v1.1.0 | 2026-08-14 | 2026-08-02 a 08-13 (12 días) | Primera edición; conjunto principal «primeros intentos en contexto de cuestionario». Sus cifras no han cambiado y siguen siendo citables. |
Las cifras publicadas nunca se reescriben. ← Investigación y datos | Para docentes y bibliotecas