日語學習作答彙總資料集:2026 年 8 月
一句話:這是 Nihongo to Japan 站上 56,613 筆匿名作答紀錄的彙總統計,來自 1,053 個匿名 learner identifiers、11,987 道題目。
⚠️ 這是 2026 年 8 月的 snapshot,不是 2026 全年研究。 資料只涵蓋 2026 年 8 月 2 日至 13 日,共 12 天(彙總管線 8 月 2 日才上線,第一天為部分日)。 這份資料裡沒有任何長期趨勢可讀。版本 1.1.0,snapshot 凍結於 2026-08-14。
關於「learner identifiers」:這是瀏覽器端隨機產生的匿名識別碼,跨裝置無法合併。同一個人使用手機與電腦會產生兩個 identifier,因此 1,053 不是經驗證的不重複自然人數,只是人數的上界。本頁全文一律用「learner identifiers」而不是「人」。
先講清楚這份資料不是什麼。這不是台灣日語學習者的代表性調查。樣本是「會主動來這個網站刷題的人」,是自選的觀察性樣本。所有數字只描述「在 NTJ 的這批作答裡發生了什麼」,不能外推到任何母體。詳見限制。
可直接引用的十條發現
以下每一條都是自足的:句子本身已帶資料集名稱、snapshot 時間、樣本數與信賴區間,記者或研究者可以單獨複製任何一條使用,不必再回頭找上下文。所有數字都是本資料集內的觀察值(主要分析集合為「測驗情境首答」,定義見方法),不是對日語學習者母體的推論,也不含任何因果宣稱。引用時請一併帶上限制。
- 在 NTJ 日語學習作答彙總資料集(2026 年 8 月 snapshot,12 天)的測驗情境首答中,句型/文法題的正確率為 53.7%(n=8,678,Wilson 95% CI 52.6%–54.7%),詞彙題為 92.1%(n=22,869,95% CI 91.8%–92.5%),兩者相差 38 個百分點。
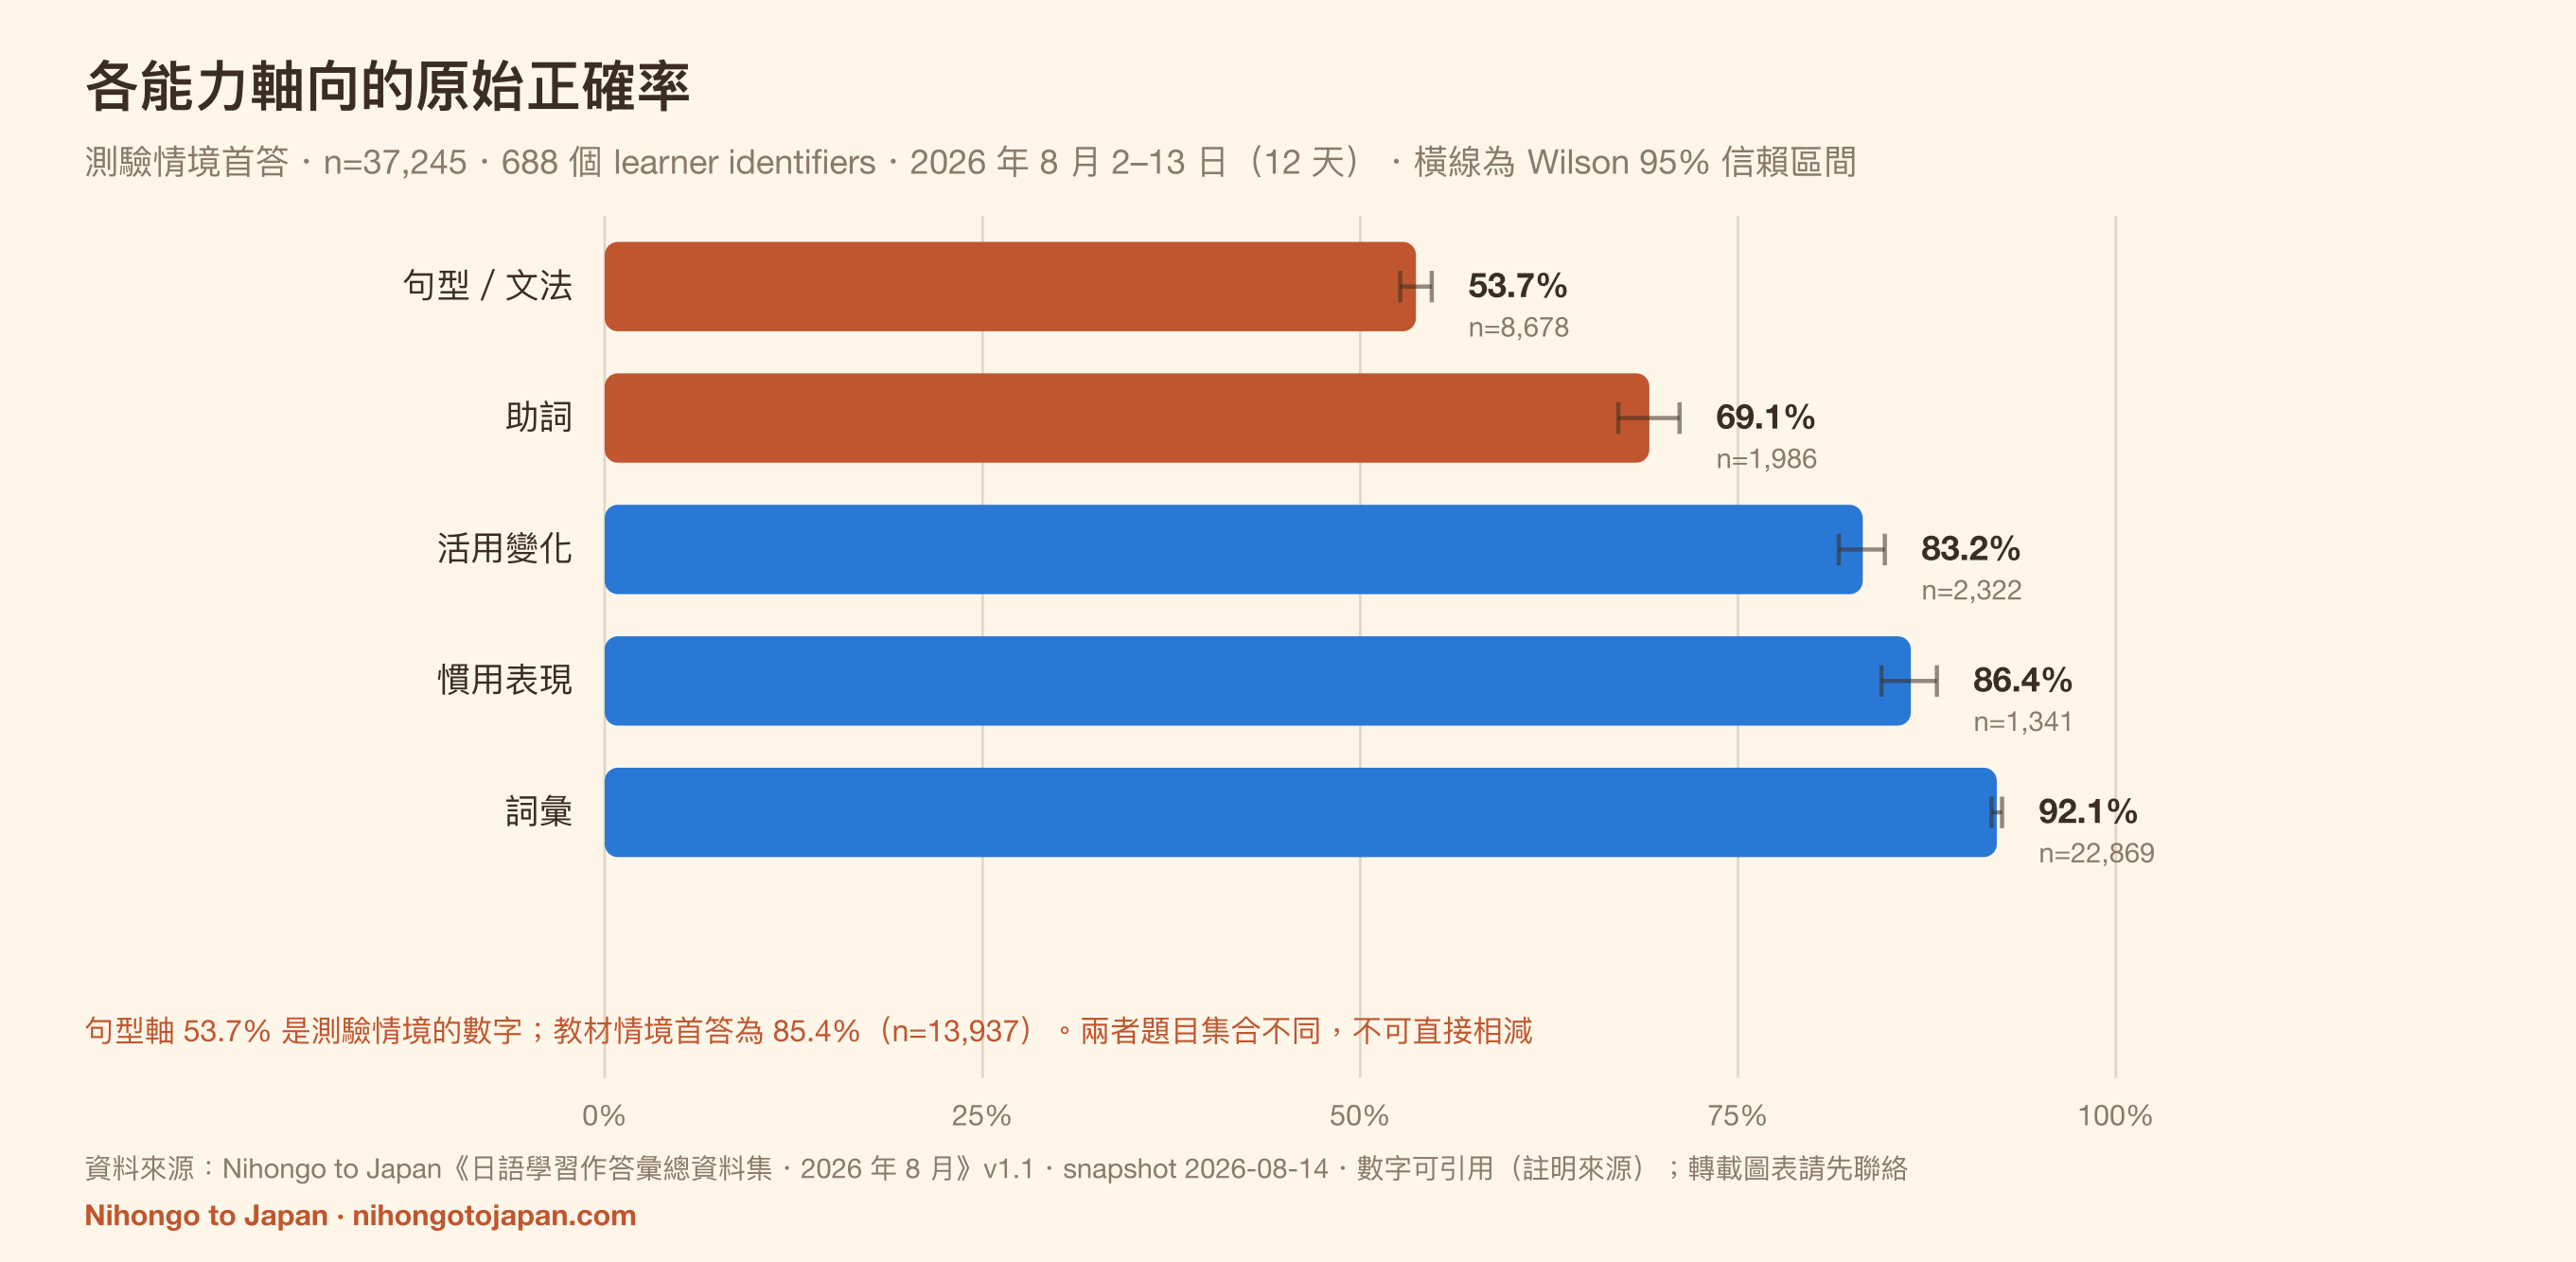
兩個區間完全不重疊,差距不是抽樣雜訊;成因本報告不做宣稱。 - 在同一份資料集的測驗情境首答中,五個能力軸向由低到高依序為:句型/文法 53.7%(n=8,678)、助詞 69.1%(n=1,986,95% CI 67.1%–71.1%)、活用變化 83.2%(n=2,322,95% CI 81.7%–84.7%)、慣用表現 86.4%(n=1,341,95% CI 84.5%–88.2%)、詞彙 92.1%(n=22,869)。
各軸向的題目集合不同,這是觀察到的正確率排序,不是難度排序。 - 在同一份資料集中,句型/文法軸觀察到的正確率會因為納入哪些作答而落在 53.7% 到 85.4% 之間:測驗情境首答 53.7%(n=8,678)、教材情境首答 85.4%(n=13,937)、全部作答 74.1%(n=24,293)。
兩種情境幾乎使用互不重疊的題目集合(5,772 道句型題中只有 6 道兩邊都出現過),因此無法把情境效果與題目難度差異分開。這條的重點是:引用學習平台的正確率時,必須問清楚納入了哪些作答。 - 在同一份資料集的測驗情境首答中,N3 的原始正確率為 67.8%(n=5,985,95% CI 66.6%–69.0%),N2 為 69.4%(n=2,726,95% CI 67.6%–71.1%);兩者的信賴區間重疊,這份資料無法區分 N2 與 N3。
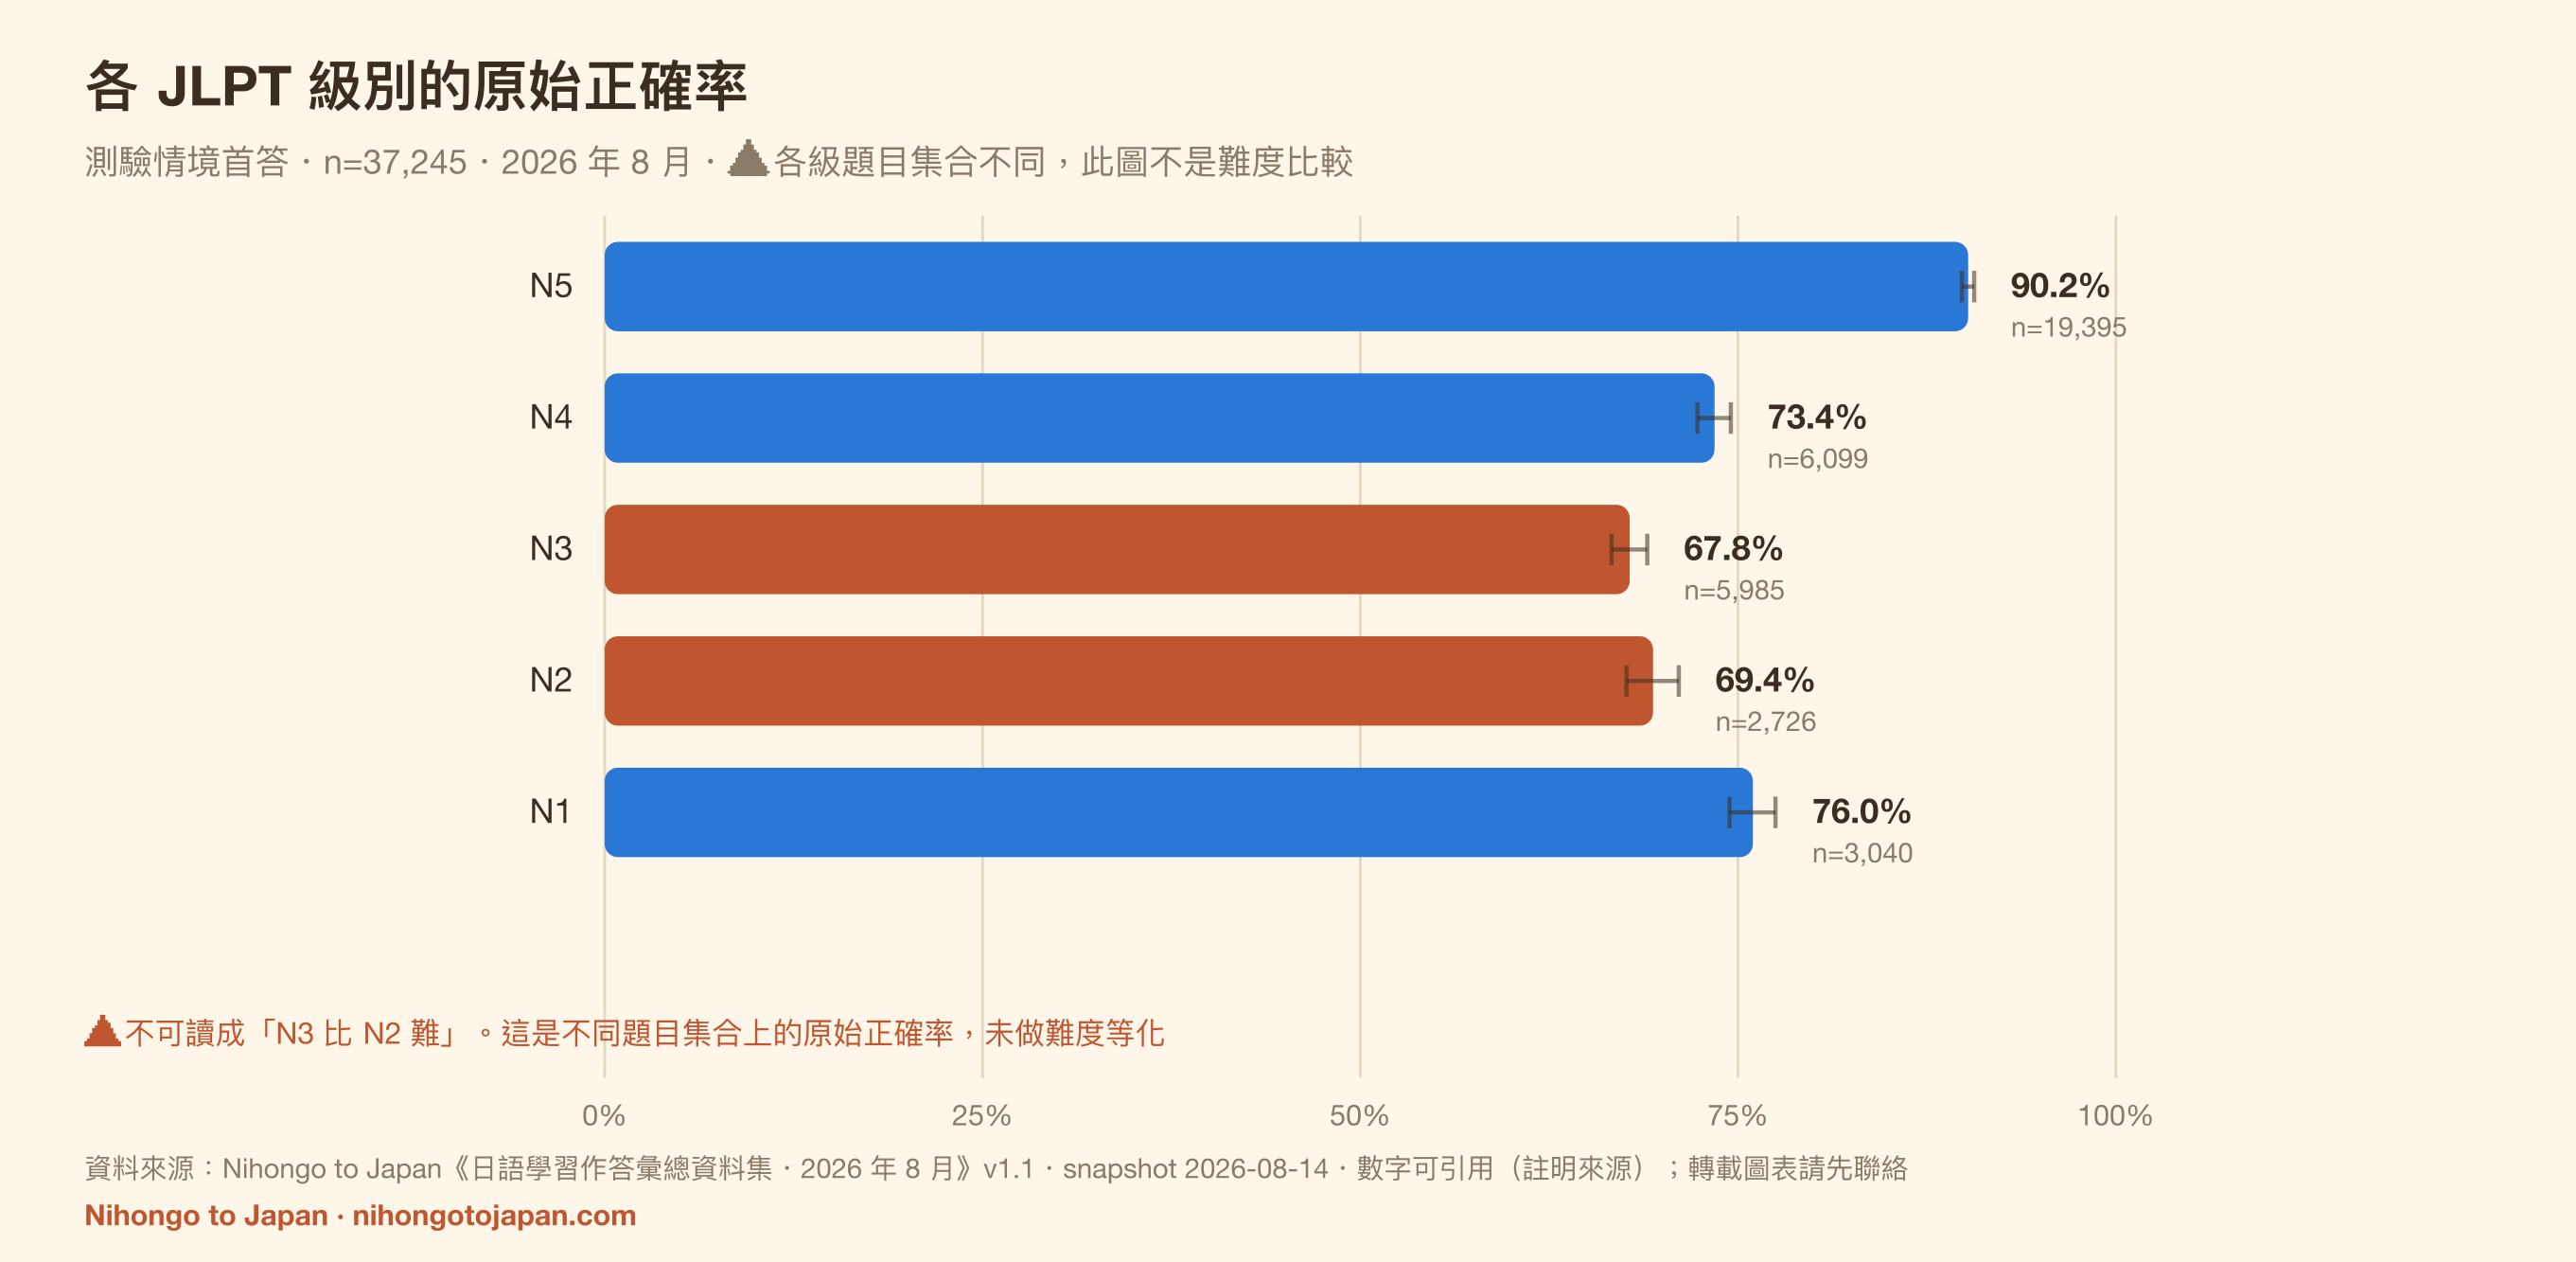
不可寫成「N2 比 N3 難」或「N3 比 N2 難」。 - 在同一份資料集的測驗情境首答中,各 JLPT 級別的原始正確率為 N5 90.2%(n=19,395)、N1 76.0%(n=3,040)、N4 73.4%(n=6,099)、N2 69.4%(n=2,726)、N3 67.8%(n=5,985)——N1 的原始正確率高於 N2 與 N3。
各級題目集合不同、沒有 IRT 難度等化、作答者為自選樣本(會挑戰 N1 題的多半已有較高程度),因此這串數字不能當成 JLPT 級別的客觀難度。 - 在同一份資料集的測驗情境首答中,助詞內部的落差比級別之間更大:助詞「が」正確率 60.9%(n=358,95% CI 55.8%–65.8%)、助詞「を」78.7%(n=385,95% CI 74.3%–82.5%),相差 17.8 個百分點,而 N3(67.8%)與 N4(73.4%)之間只差 5.6 個百分點。
對教學設計的意涵是:以「級別」為單位分配練習量,可能比以「知識點」為單位粗糙。 - 在同一份資料集的測驗情境首答中,句型/文法軸在每一個 JLPT 級別都是最低的能力軸向:N5 64.0%(n=1,939)、N4 48.0%(n=1,734)、N3 49.2%(n=2,531)、N2 51.1%(n=1,179)、N1 57.0%(n=1,295)。
同一批作答者在同一級別的詞彙題正確率為 N5 94.4%、N4 89.0%、N3 84.0%、N2 85.0%、N1 89.2%。 - 在同一份資料集中,用同一批 372 個 learner identifiers、同一批 34,392 筆作答計算:以「每題一票」(事件加權)得到 82.53%,以「每人一票」(identifier 等權)得到 75.49%,相差 7.04 個百分點。
兩個數字用完全相同的母體與集合,差異純粹來自加權方式。任何引用學習平台正確率的報導都應標明用的是哪一種。 - 在同一份資料集中,作答量高度集中:單一 learner identifier 最多佔全部 56,613 筆作答的 3.73%,前 10 個 identifiers 合計佔 19.44%。
這是「每題一票」與「每人一票」會差 7 個百分點的直接原因,也是所有學習平台資料共有的結構性偏誤。 - 在同一份資料集中,針對在兩種情境都有作答的 75 個 learner identifiers(每邊至少 5 筆)做配對比較:教材情境 86.57%(n=5,858)、測驗情境 55.52%(n=2,055),配對平均差 27.47 個百分點(95% CI 22.56–32.39)。
這說明情境之間的差距不是由 learner 組成不同造成的;但同題比較做不到(見第 3 條),所以仍無法把情境效果與題目難度分開。
以上每一條的展開、完整表格與圖表,見以下各節。想直接拿數字的人請看下載資料;要引用請看引用方式;有問題請看聯絡窗口。
一、五個主要發現
1. 句型是唯一低於六成的能力軸向,和詞彙差了 38 個百分點
在測驗情境首答中(見方法的集合定義),詞彙題正確率 92.1%(n=22,869,627 個 learner identifiers,95% CI 91.8%–92.5%),句型題只有 53.7%(n=8,678,532 個 identifiers,95% CI 52.6%–54.7%)。
兩者的信賴區間相距極遠,這不是抽樣雜訊。資料只說明兩個軸向的正確率差距很大;至於為什麼,本報告不做因果宣稱。
2. 句型軸的「正確率」在 53.7% 到 74.1% 之間,取決於納入哪些作答
在不同 analysis-set 定義下,句型軸觀察到的正確率從 53.7%(測驗情境首答,n=8,678)到 74.1%(全部作答,n=24,293)。由於納入的事件與 learner identifier 組成不同,不能把全部差異解讀為單一計算規則造成。
逐級拆解:
| 步驟 | n | 原始正確率 | 相對前一步 |
|---|---|---|---|
| 全部作答 | 24,293 | 74.1% | — |
| → 只留每題首答 | 22,638 | 73.2% | -0.87 pp |
| → 只留測驗情境(排除教材/複習) | 8,678 | 53.7% | -19.54 pp |
| (對照)教材情境首答 | 13,937 | 85.4% | — |
去掉重複作答只移動 0.9 個百分點;其餘幾乎全部來自「教材情境」與「測驗情境」的差異。
同一批 learner identifier 的成對比較:75 個 identifier 在兩種情境各有 ≥5 筆句型首答。他們在教材情境 86.6%(n=5,858)、在測驗情境 55.5%(n=2,055),成對平均差 +27.5 pp(95% CI 22.6–32.4,中位數 +26.9)。所以差異不是單純由「哪些人在答」造成。
⚠️ 同題比較做不到,所以無法下定論。5,772 道句型題裡,只有 6 道在兩種情境都出現過,其中只有 1 道兩邊各達 3 筆。兩種情境使用幾乎互不重疊的題目集合,因此無法把「情境效果」與「題目本身難易」分開。教材情境的題目可能就是比較簡單。
能誠實說的只有:引用學習平台的「正確率」時,一定要問是哪一個 analysis set。四個集合的數字都在可下載資料裡。
3. N3 與 N2 的原始正確率最低,但兩者無法被這份資料區分
測驗情境首答的各級別原始正確率:N5 90.2%、N4 73.4%、N3 67.8%、N2 69.4%、N1 76.0%。
N3(95% CI 66.6%–69.0%)與 N2(95% CI 67.6%–71.1%)的信賴區間重疊,所以不能說「N3 比 N2 難」。能說的是:在這批資料裡,N2 與 N3 的原始正確率都低於 N4、N1 與 N5。
⚠️ 更重要的是:各級別的題目集合完全不同,這個排序不是難度比較,也不是「哪一級比較難」的證據。
4. 助詞內部的落差比級別之間更大
單一助詞在測驗情境首答的正確率:が 60.9%(n=358,CI 55.8%–65.8%)、に 62.4%(n=370)、で 63.3%(n=330),而 を 78.7%(n=385,CI 74.3%–82.5%)、の 83.3%(n=120)。
が 與 を 的信賴區間不重疊,落差 18 個百分點。
5. 「每人一票」和「每題一票」差 7.04 個百分點
在完全相同的 372 個 learner identifiers、相同分析集合、相同 34,392 筆 eligible events 上計算:
| 加權方式 | 正確率 |
|---|---|
| 事件加權(每一題一票) | 82.5% |
| identifier 加權(每個 identifier 一票) | 75.5%(中位數 76.2%) |
| WEIGHTING_EFFECT_PP | 7.04 pp |
cohort 定義:主要分析集合中作答數 ≥20 的 learner identifiers。兩個數字的分子分母來自同一群 identifier,所以這個差值真的只反映加權方式,不摻雜樣本組成差異。
原因是重複測量:最活躍的單一 identifier 就佔了全部作答的 3.7%,前 10 名合計 19.4%。任何用學習平台資料談「學習者表現」的研究都會碰到這件事,所以我們把兩個數字都給出來。
二、資料集概觀
| 項目 | 數值 |
|---|---|
| 有效作答事件 | 56,613 |
| 匿名 learner identifiers(人數上界) | 1,053 |
| 不重複題目 | 11,987 |
| 知識點數 | 39 |
| 資料期間 | 2026-08-02 ~ 2026-08-13(12 天),第一天為部分日 |
| Snapshot 凍結時間 | 2026-08-14T00:00:00Z |
| 首次作答事件(First attempt) | 52,934 |
| 測驗情境首答(主要分析集合) | 37,245 |
| 主要集合的 learner identifiers | 688 |
| 教材情境首答(對照集合) | 15,741 |
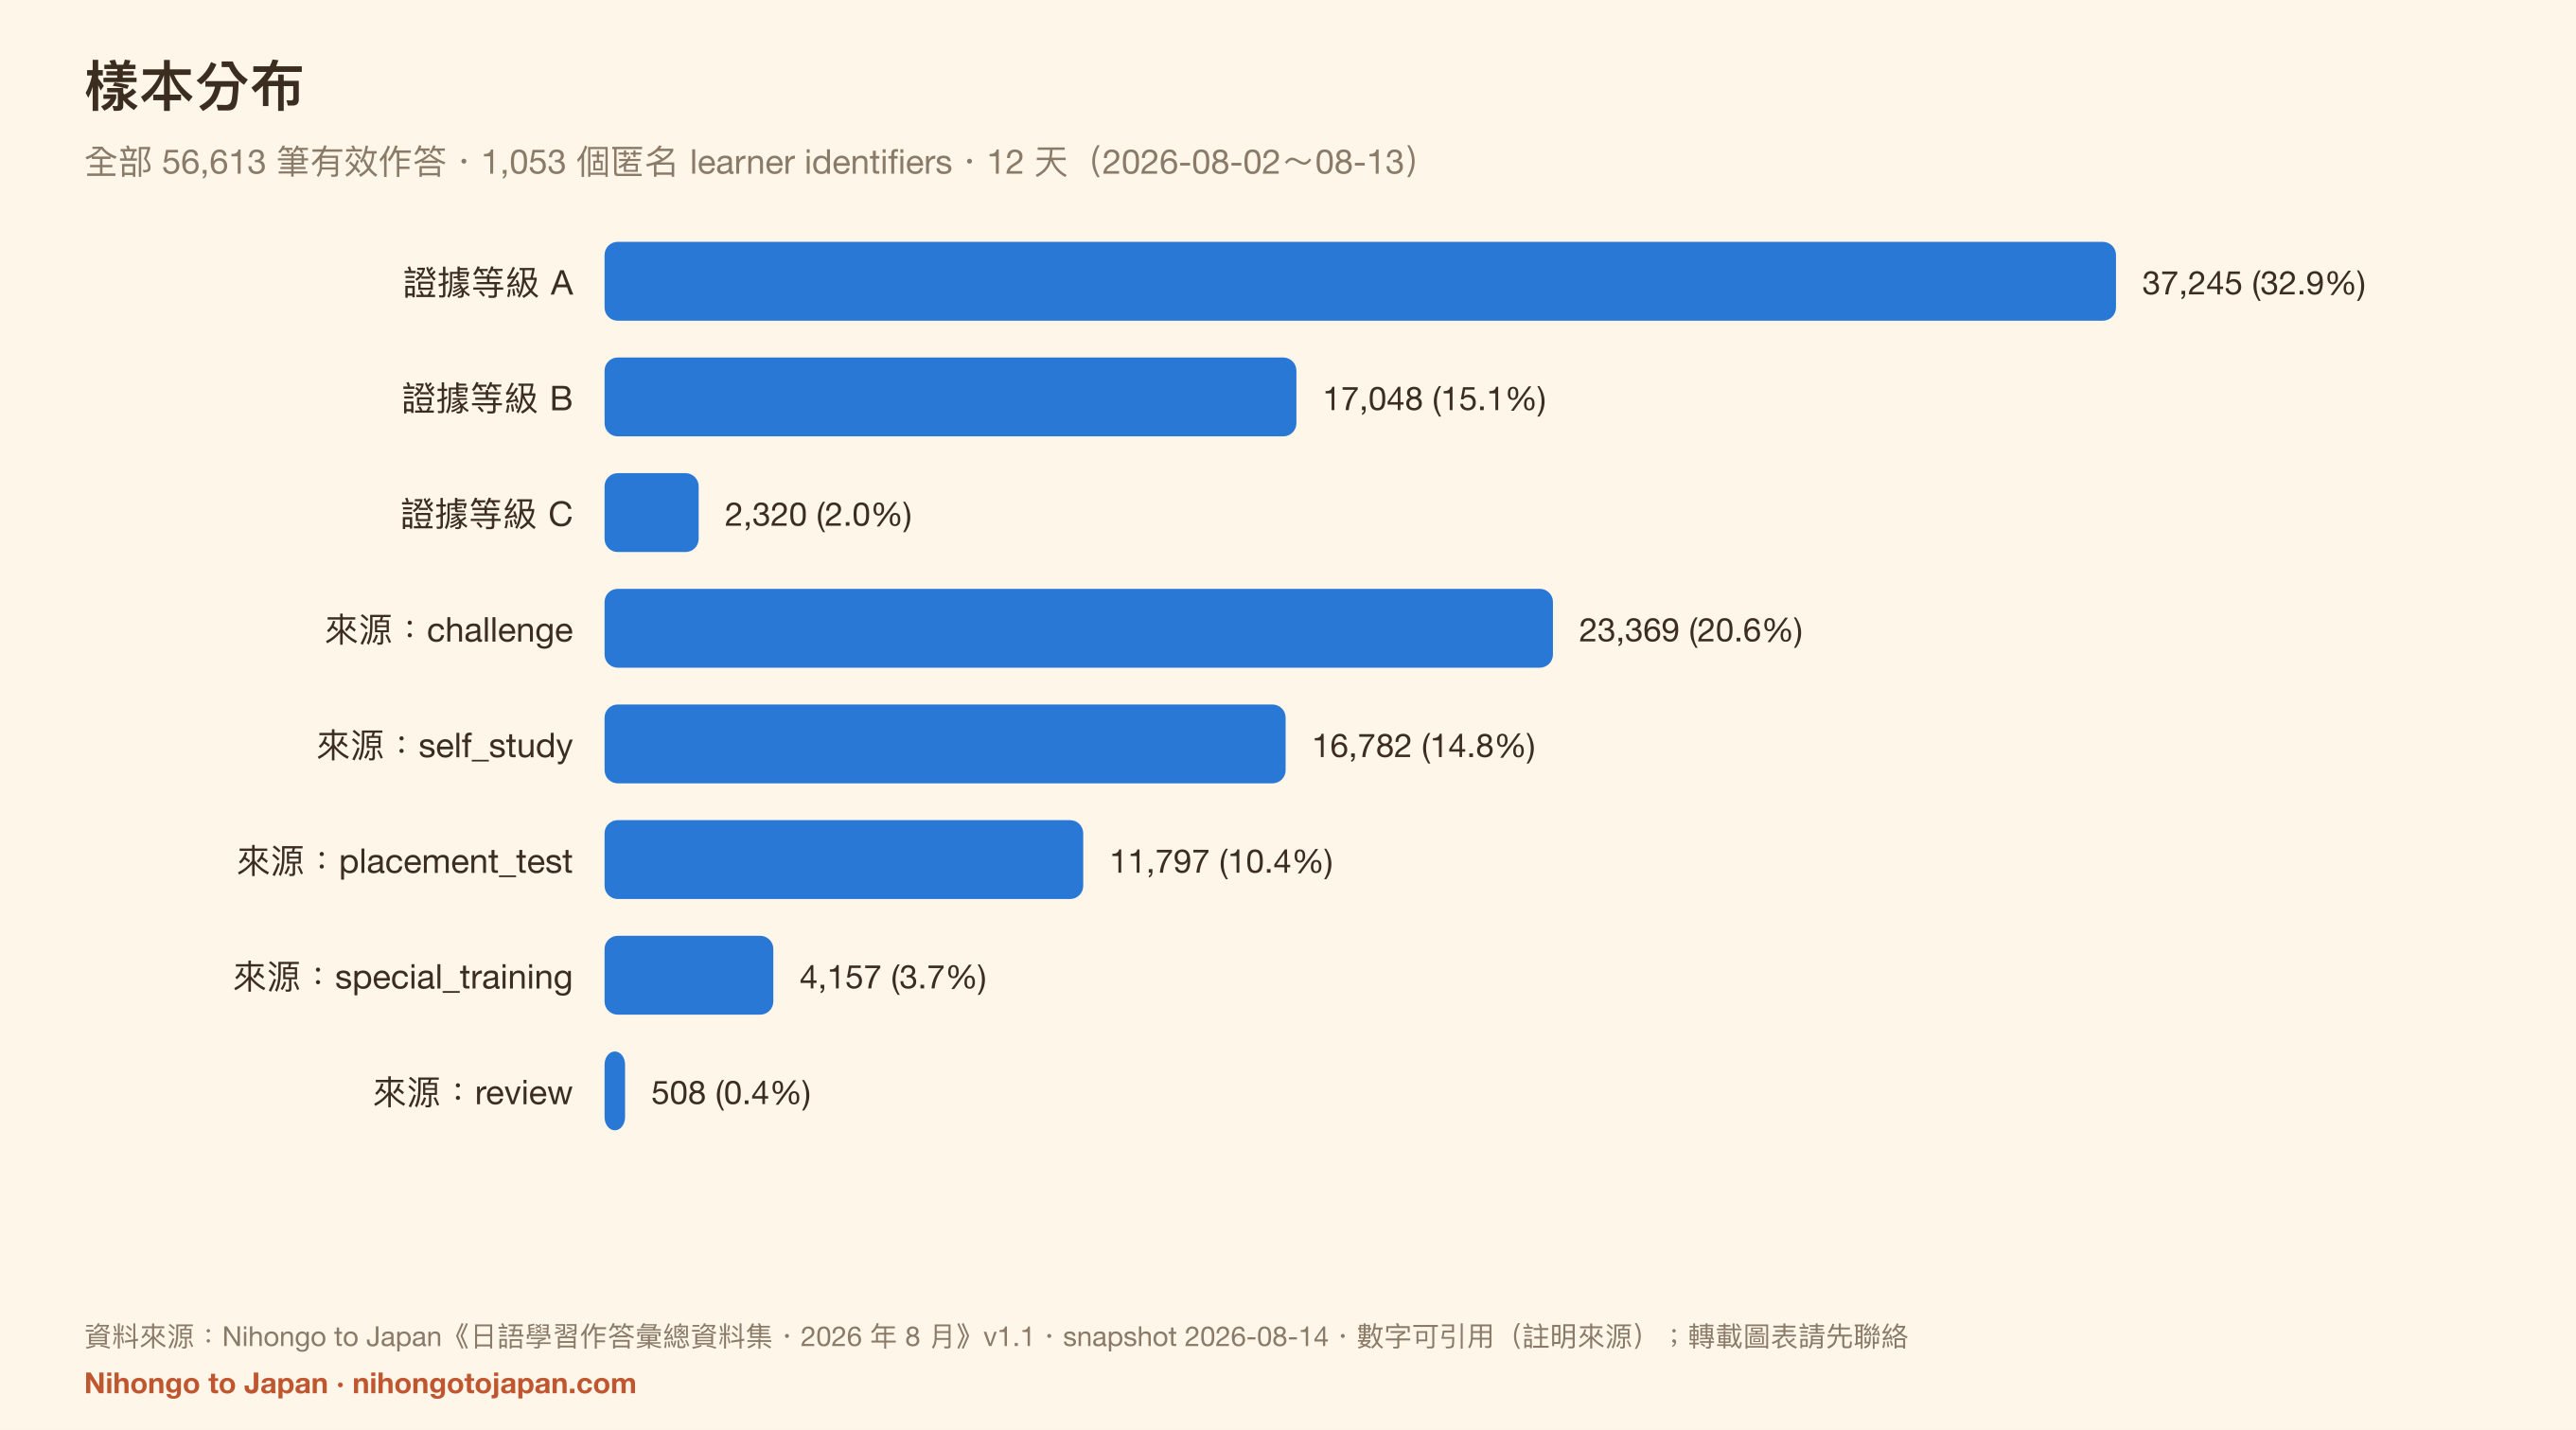
作答來源分布:challenge 23,369(41.3%)、self_study 16,782(29.6%)、placement_test 11,797(20.8%)、special_training 4,157(7.3%)、review 508(0.9%)。
資料庫 evidence_class 欄位分布(這是資料表的原始欄位,不是本報告的分析集合名稱):A 37,245(65.8%)、B 17,048(30.1%)、C 2,320(4.1%)。主要分析集合等同 evidence_class = A。

三、各能力軸向的正確率

| 能力軸向 | n | identifiers | 原始正確率 | 95% CI | 標記 |
|---|---|---|---|---|---|
| 句型/文法 | 8,678 | 532 | 53.7% | 52.6%–54.7% | OK |
| 助詞 | 1,986 | 137 | 69.1% | 67.1%–71.1% | OK |
| 活用變化 | 2,322 | 386 | 83.2% | 81.7%–84.7% | OK |
| 慣用表現 | 1,341 | 261 | 86.4% | 84.5%–88.2% | OK |
| 詞彙 | 22,869 | 627 | 92.1% | 91.8%–92.5% | OK |
以下軸向樣本過小,依最小格數規則(n<30 或學習者<5)不公開正確率,只公開事件數:綜合(n=27,8 個 identifiers)、讀解(n=22,4 個 identifiers)。
四、各 JLPT 級別的正確率
⚠️ 這一節最容易被誤讀。各級別的題目集合完全不同,而且沒有做 IRT 難度等化。下面的數字是「在這批題目上答對的比例」,不是「哪一級比較難」的度量。

| JLPT 級別 | n | identifiers | 原始正確率 | 95% CI |
|---|---|---|---|---|
| N5 | 19,395 | 380 | 90.2% | 89.8%–90.6% |
| N4 | 6,099 | 313 | 73.4% | 72.3%–74.5% |
| N3 | 5,985 | 432 | 67.8% | 66.6%–69.0% |
| N2 | 2,726 | 212 | 69.4% | 67.6%–71.1% |
| N1 | 3,040 | 139 | 76.0% | 74.4%–77.5% |
四種分析集合的對照(原始正確率):
| 級別 | 測驗情境首答(主要) | 教材情境首答 | 全情境首答 | 全部作答 |
|---|---|---|---|---|
| N5 | 90.2%(n=19,395) | 83.7%(n=11,154) | 87.8%(n=30,495) | 88.2%(n=33,286) |
| N4 | 73.4%(n=6,099) | 83.1%(n=2,694) | 76.5%(n=8,758) | 76.6%(n=9,262) |
| N3 | 67.8%(n=5,985) | 82.1%(n=1,507) | 70.8%(n=7,522) | 71.1%(n=7,727) |
| N2 | 69.4%(n=2,726) | 79.2%(n=260) | 70.2%(n=2,985) | 70.5%(n=3,072) |
| N1 | 76.0%(n=3,040) | 86.5%(n=126) | 76.4%(n=3,174) | 76.5%(n=3,266) |
五、正確率最低的知識點
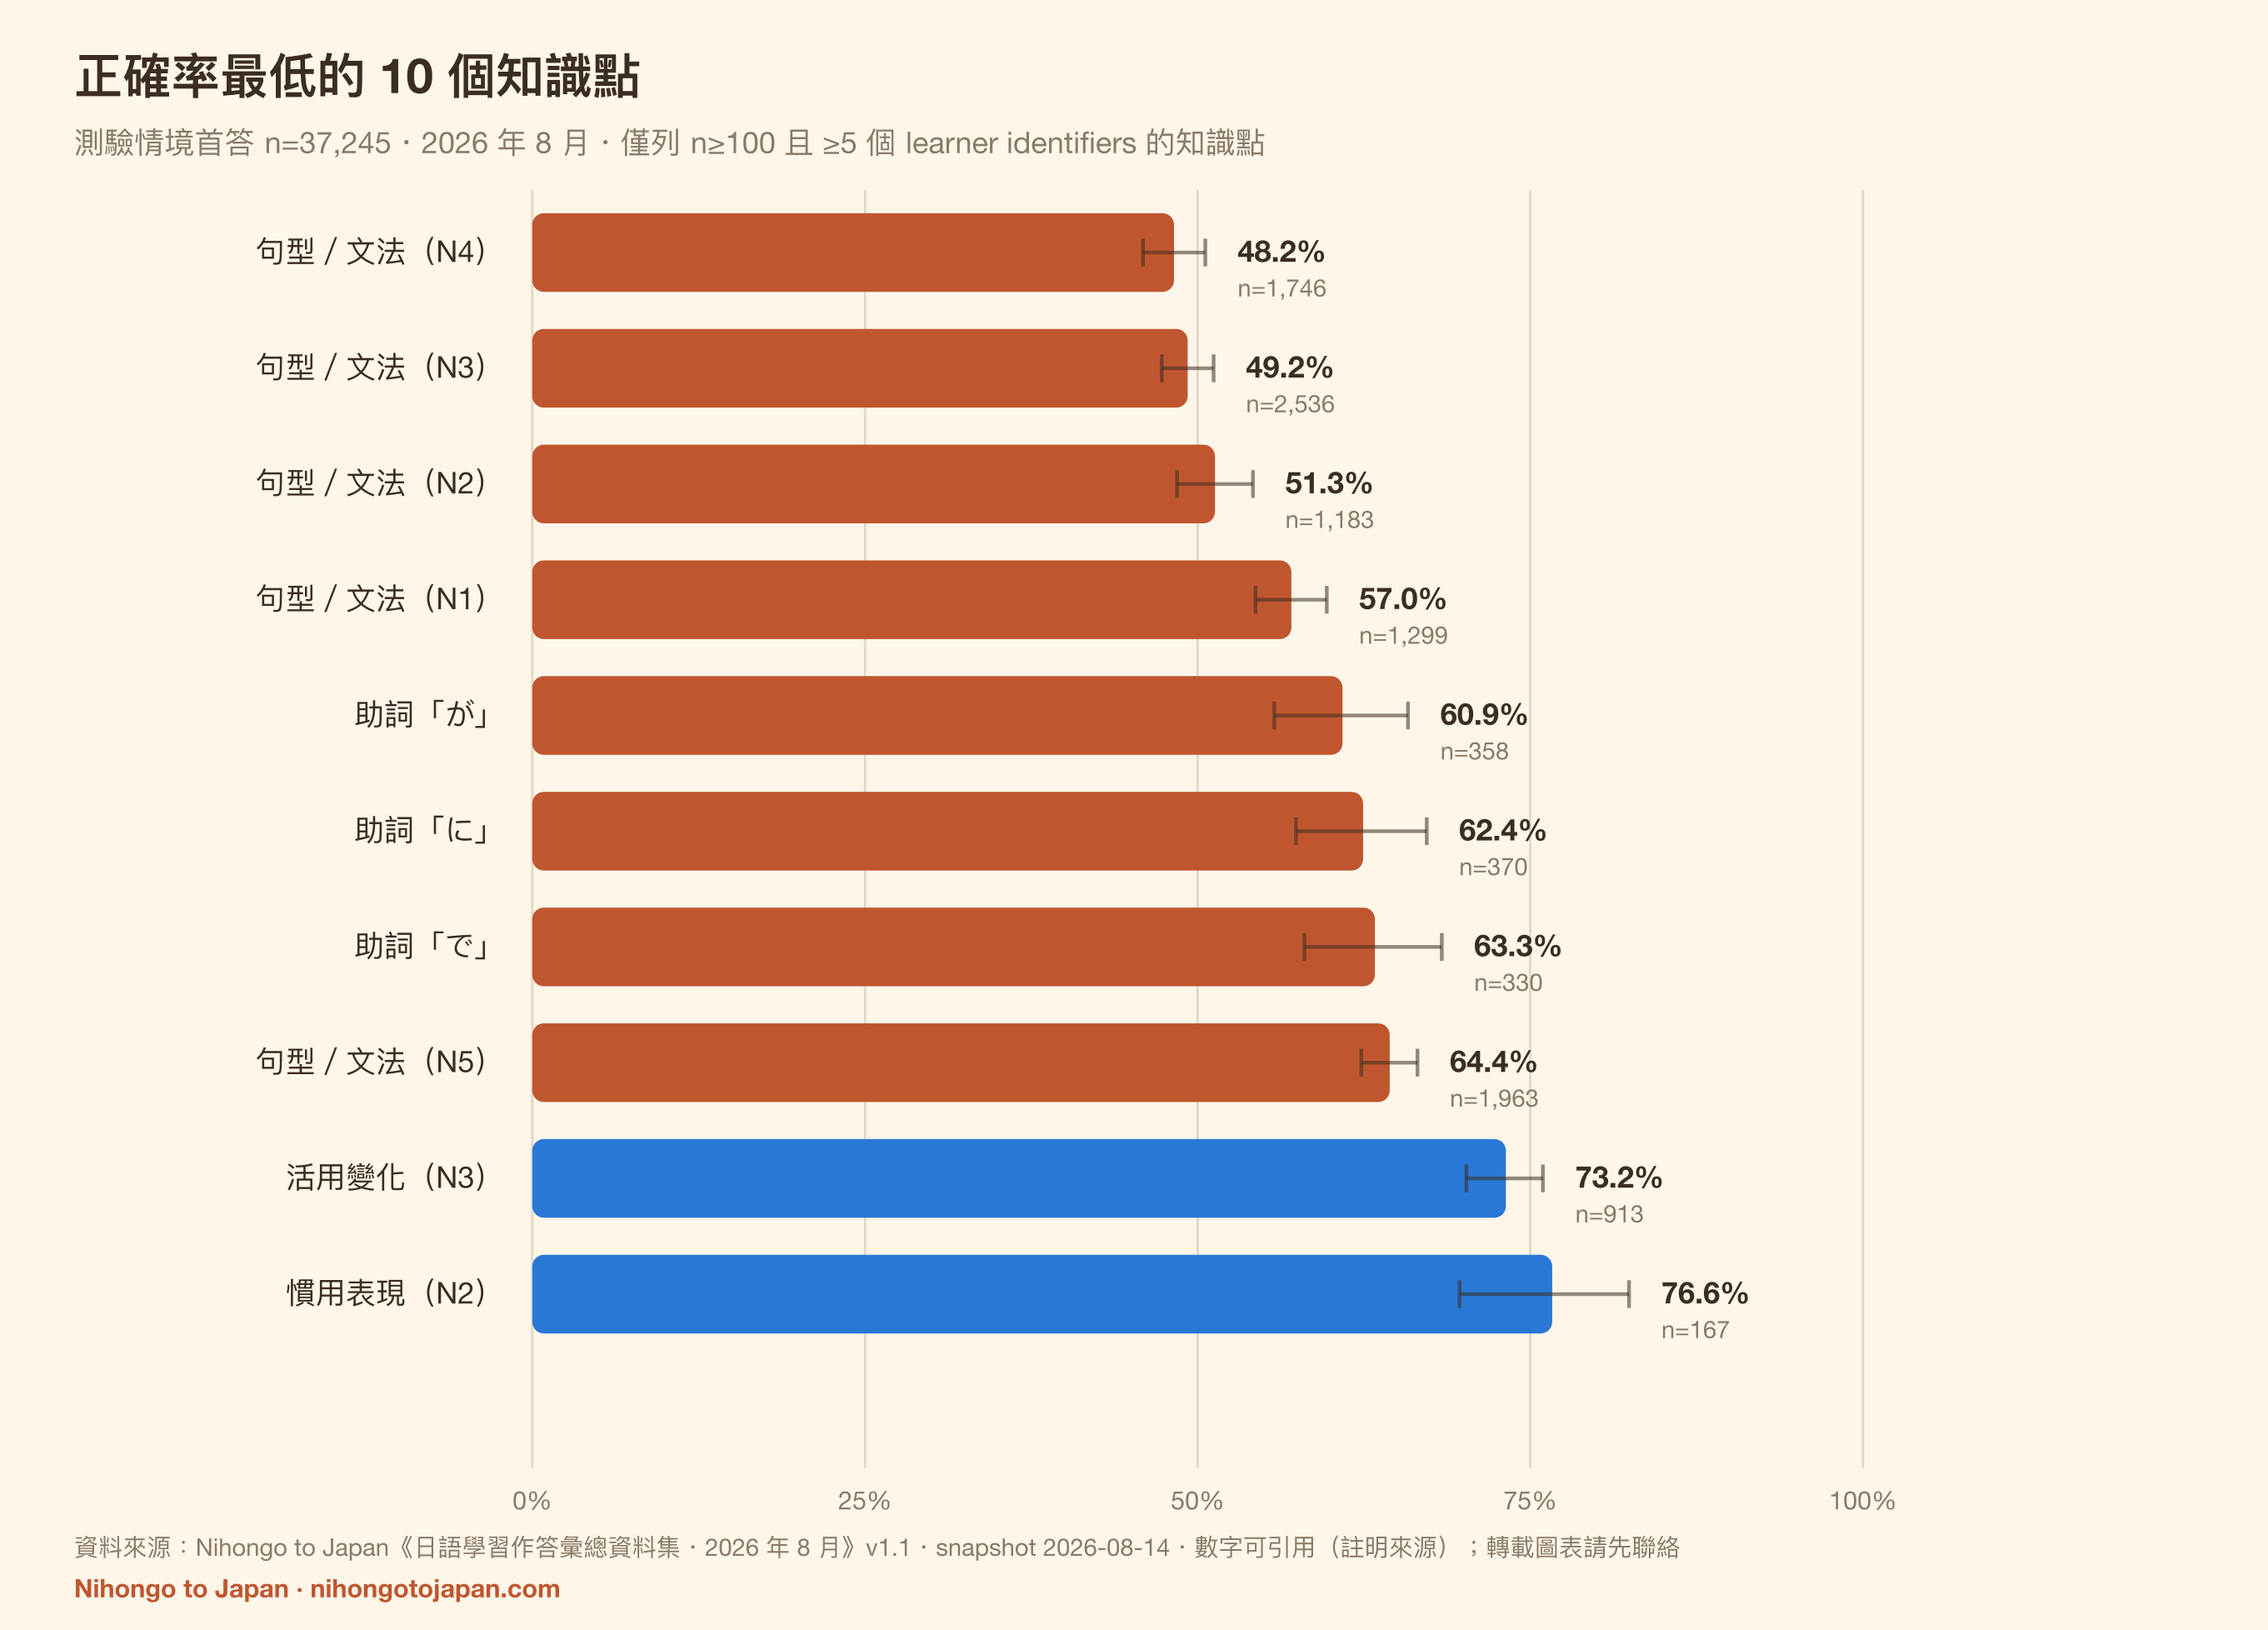
只列入 n≥100 且學習者≥5 的知識點(共 23 個符合)。排序附上 n、級別與類別,不只看百分比——樣本小的格子看起來極端,往往只是雜訊。

| # | 知識點 | 類別 | 級別 | n | identifiers | 原始正確率 | 95% CI |
|---|---|---|---|---|---|---|---|
| 1 | 句型/文法(N4) | 句型/文法 | N4 | 1,746 | 234 | 48.2% | 45.9%–50.6% |
| 2 | 句型/文法(N3) | 句型/文法 | N3 | 2,536 | 390 | 49.2% | 47.3%–51.2% |
| 3 | 句型/文法(N2) | 句型/文法 | N2 | 1,183 | 191 | 51.3% | 48.5%–54.1% |
| 4 | 句型/文法(N1) | 句型/文法 | N1 | 1,299 | 118 | 57.0% | 54.3%–59.7% |
| 5 | 助詞「が」 | 助詞 | — | 358 | 81 | 60.9% | 55.8%–65.8% |
| 6 | 助詞「に」 | 助詞 | — | 370 | 75 | 62.4% | 57.4%–67.2% |
| 7 | 助詞「で」 | 助詞 | — | 330 | 85 | 63.3% | 58.0%–68.3% |
| 8 | 句型/文法(N5) | 句型/文法 | N5 | 1,963 | 209 | 64.4% | 62.3%–66.5% |
| 9 | 活用變化(N3) | 活用變化 | N3 | 913 | 294 | 73.2% | 70.2%–75.9% |
| 10 | 慣用表現(N2) | 慣用表現 | N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| 11 | 助詞「を」 | 助詞 | — | 385 | 61 | 78.7% | 74.3%–82.5% |
| 12 | 活用變化(N2) | 活用變化 | N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
六、最穩定的強項
| # | 知識點 | 類別 | 級別 | n | identifiers | 原始正確率 | 95% CI |
|---|---|---|---|---|---|---|---|
| 1 | 活用變化(N1) | 活用變化 | N1 | 296 | 79 | 95.6% | 92.6%–97.4% |
| 2 | 詞彙(N5) | 詞彙 | N5 | 16,029 | 311 | 94.4% | 94.0%–94.8% |
| 3 | 詞彙(N1) | 詞彙 | N1 | 703 | 94 | 89.2% | 86.7%–91.3% |
| 4 | 詞彙(N4) | 詞彙 | N4 | 2,828 | 243 | 89.0% | 87.8%–90.1% |
| 5 | 慣用表現(N1) | 慣用表現 | N1 | 742 | 111 | 88.8% | 86.3%–90.9% |
| 6 | 活用變化(N4) | 活用變化 | N4 | 461 | 149 | 87.0% | 83.6%–89.8% |
| 7 | 慣用表現(N4) | 慣用表現 | N4 | 140 | 91 | 86.4% | 79.8%–91.1% |
| 8 | 慣用表現(N3) | 慣用表現 | N3 | 290 | 142 | 85.9% | 81.4%–89.4% |
七、值得注意的觀察
觀察 A:N1 的原始正確率高於 N2 與 N3
N1 76.0%(n=3,040,139 個 identifiers)高於 N2 69.4% 與 N3 67.8%。
這是一個 observed pattern,不是「N1 比較簡單」。至少有三個無法用這份資料排除的解釋:作答 N1 題目的只有 139 個 identifiers、與作答 N3 的 432 個不是同一群(組成不同);各級題目集合不同;沒有做能力值估計。要回答「哪一級真的比較難」需要 IRT 等化與共同題設計,這份資料兩者都沒有。
觀察 B:句型軸在每一個級別都是最低的
| 軸向 × 級別 | n | identifiers | 原始正確率 | 95% CI |
|---|---|---|---|---|
| 句型/文法 × N4 | 1,734 | 233 | 48.0% | 45.6%–50.3% |
| 句型/文法 × N3 | 2,531 | 389 | 49.2% | 47.2%–51.1% |
| 句型/文法 × N2 | 1,179 | 191 | 51.1% | 48.3%–54.0% |
| 句型/文法 × N1 | 1,295 | 118 | 57.0% | 54.3%–59.7% |
| 助詞 × N4 | 766 | 92 | 58.5% | 55.0%–61.9% |
| 句型/文法 × N5 | 1,939 | 208 | 64.0% | 61.8%–66.1% |
| 活用變化 × N3 | 948 | 302 | 74.2% | 71.3%–76.8% |
| 助詞 × N5 | 1,220 | 111 | 75.8% | 73.3%–78.1% |
| 慣用表現 × N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| 活用變化 × N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
把軸向與級別交叉之後,正確率最低的格子幾乎全部是句型。這比單看級別更有資訊量。
八、老師與教材設計者可以怎麼用
這一節刻意把「資料」與「詮釋」分開。資料是可以直接引用的;詮釋是我們的判斷,你可以不同意。
| 資料(可直接引用) | 詮釋(我們的判斷,非資料) |
|---|---|
| 測驗情境首答:句型軸 53.7%,詞彙軸 92.1%(n 分別為 8,678、22,869) | 在這個平台上,認得字與組得出句子之間有明顯落差。若要分配練習時間,句型的邊際效益可能高於再背單字。 |
| が 60.9%、に 62.4%、で 63.3% 明顯低於 を 78.7%、の 83.3% | を 與 の 的用法相對單一,が/に/で 一詞多用。教學上把「同一個助詞的不同功能」拆開處理,可能比逐一介紹助詞有效。 |
| N2 與 N3 的原始正確率(69.4%/67.8%)低於 N4、N1、N5 | ⚠️ 不要用這個排難度。比較可能的解讀是「在 N2/N3 階段作答的學習者組成與其他級別不同」,而不是題目本身。 |
| 句型軸:教材情境首答 85.4%(n=13,937)vs 測驗情境首答 53.7%(n=8,678);同一批 75 個 identifier 的成對差 +27.5 pp | 課內作答與測驗作答的成績差很多,用平台內建練習成績評估學習成效時要注意。⚠️ 但兩者題目集合幾乎不重疊,無法斷定是「情境」還是「題目較簡單」造成。 |
九、方法
| 項目 | 說明 |
|---|---|
| Population(母體) | 使用 Nihongo to Japan 的學習者所產生的作答紀錄。 |
| Sampling(抽樣) | 自選、觀察性樣本(self-selected, observational)。非隨機抽樣,非人口代表性樣本。 |
| Unit of analysis(分析單位) | answer event(一個 learner identifier 對一道題目的一次作答)。 |
| User count(使用者計數) | learner identifiers=不重複的匿名識別碼數。跨裝置無法合併,是自然人數的上界,不是經驗證的人數。 |
| Metric(指標) | raw accuracy = 答對數 ÷ 有效作答數。不是能力值估計。 |
| 信賴區間 | Wilson 95% CI。只反映抽樣誤差,不修正選樣偏差。 |
四種分析集合
| 集合 | 定義 | n |
|---|---|---|
| 測驗情境首答 (主要分析集合) | 來源為 challenge/placement_test/special_training,且為該 learner identifier 對該題的首次作答、非 24 小時內重複、題目後設資料完整。 | 37,245 |
| 教材情境首答 (對照集合) | 來源為 self_study/review 的首次作答,也就是「讀教材的過程中作答」。 | 15,741 |
| 全情境首答 | 每個 learner identifier 對每題的第一次作答,不分來源。 | 52,934 |
| 全部作答 | 所有有效作答事件,含重複作答。 | 56,613 |
⚠️ 主要分析集合不宣稱「未使用提示」或「未先看解析」。 資料庫裡used_hint/viewed_explanation/used_answer_key三個欄位全部為 false,但那是因為沒有任何前端呼叫點寫入它們——全站作答捕捉點都沒有傳這些參數,而產品目前也沒有「作答前提示」或「作答前看答案」的功能。 全 false 是儀器的性質,不是學習者行為的證據,因此本報告不拿它們當任何分析條件,也不對提示行為做任何宣稱。
主要集合的獨立驗證:用伺服器端重算「每個 (identifier, 題目) 的最早一筆」,99.59% 的主要集合事件(37,094/37,245)通過首答檢定;不符的 151 筆推測為跨裝置(同一人在兩台裝置各答一次,每台都判定為首答)。集合內 attempt_number 全部為 1。
排除了什麼
- 已知退化題目:520 個 question_id 被排除在所有彙總之外。兩個來源:(1) 教材填空的非文法題(假名轉換、書寫常識、數字答案)被誤標到句型軸;(2) 舊版「今日一題」用答案 token 當題目識別,把不同題合併成同一個 id。前端已修,歷史資料以 denylist 從彙總排除。原始事件一筆未刪(append-only)。
- Snapshot 截止後的事件:本報告凍結於 2026-08-14T00:00:00Z。資料每天還在增加,但本頁與可下載檔案的每一個數字都來自同一個凍結點。
最小格數規則
n<30 或學習者<5 的細格 SUPPRESSED:只公開事件數,不公開正確率。 n≥30 且學習者≥5 但 n<100 標為 LOW_SAMPLE,引用時務必附 n。 n≥100 且學習者≥5 標為 OK。
本次共有 23 個知識點為 OK、12 個 LOW_SAMPLE、3 個 SUPPRESSED。
匿名化
- 每筆事件只帶一個瀏覽器隨機產生的匿名裝置 UUID。沒有姓名、email、IP、裝置指紋,也沒有任何自由輸入的文字。
- 接收端(Cloudflare Pages Function)只寫入白名單欄位,程式明確不寫入 IP。
- 公開資料集只有彙總統計,沒有任何一筆原始作答事件。
- 學習者可在隱私政策頁一鍵退出彙總收集。
十、限制(請務必一起引用)
如果你只讀一段,讀這段。這份資料描述的是「來 NTJ 刷題的人在 NTJ 的題目上表現如何」。它不是台灣日語學習者的樣貌,不是 JLPT 難度的度量,也不能用來比較不同級別的客觀難度。
- 選樣偏差:樣本是主動來刷題的人。這群人比一般學習者更投入,可能也更年輕、更習慣線上工具。
- 重複測量:單一 identifier 最多佔全部作答的 3.7%,前 10 名佔 19.4%。在同一批 372 個 identifier 上,事件加權與 identifier 加權相差 7.04 個百分點。
- analysis set 之間不可直接相減:教材情境與測驗情境使用幾乎互不重疊的題目集合(5,772 道句型題中只有 6 道兩邊都出現),因此兩者的正確率差距無法歸因於單一原因。
- 提示/看解析行為不可觀測:相關欄位從未被寫入,本資料集對這些行為不做任何宣稱。
- 題目難度不一:各級別、各軸向的題目集合不同,raw accuracy 不是標準化的難度度量。
- 未做 IRT 等化:沒有項目反應理論的難度等化,也沒有跨級別共同題設計,因此不能回答「哪一級比較難」。
- 樣本量不均:N5 的作答數是 N1 的六倍以上。
- 時間窗很短:只有 12 天(彙總管線 2026-08-02 才上線)。沒有任何長期趨勢可以從這份資料讀出來。
- 無法辨識自動化流量:沒有機制可以區分真人與腳本。作答回應時間有 94% 為空值,因此連「答太快」這種基本篩選都做不到。這是已知的資料品質缺口。
- 非母體代表:不代表台灣,也不代表任何國家的日語學習者全體。
十一、引用方式
歡迎在論文、研究報告、教學材料與新聞報導中引用。請註明來源並連結回本頁。
APA(7th)
Nihongo to Japan. (2026). 日語學習作答彙總資料集・2026 年 8 月 / Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026MLA(9th)
Nihongo to Japan. 日語學習作答彙總資料集・2026 年 8 月. Version 1.1.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026}

}
授權狀態
資料採 CC BY 4.0:可自由使用(含商業用途),唯一條件是標示出處。 本站製作的圖表與報告文字不在授權範圍內。完整條款見授權。
建議的標示方式:
Nihongo to Japan,《日語學習作答彙總資料集・2026 年 8 月》v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026授權:資料採 CC BY 4.0
本資料集的資料採用 Creative Commons 姓名標示 4.0 國際(CC BY 4.0)。你可以自由重製、散布、改作與再發布,包含商業用途,唯一條件是適當標示出處並註明是否修改過。
⚠️ 授權範圍只到資料。受 CC BY 4.0 涵蓋的是:本頁的彙總統計數字,以及japanese-learning-2026.json與japanese-learning-2026.csv兩個下載檔。本站製作的圖表(SVG/PNG)與報告全文不在授權範圍內,仍保留權利。
可以做的事(不必先問我們)
- 在論文、研究報告、教學材料、新聞報導中引用統計數字,包含商業出版品。
- 重新分析彙總數字,自行製作新的圖表——你畫的新圖是你的。
- 改作、混合、轉換,並以任何形式再發布,包含整批再散布資料檔或放進自己的資料產品。
- 課堂與教育場合使用。
標示方式
Nihongo to Japan,《日語學習作答彙總資料集・2026 年 8 月》v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026我們的請求(不是授權條件)
下面這些不是 CC BY 的條件,不照做也不構成侵權。我們仍然請你照做,理由寫在每一條後面:
- 一併帶上樣本限制(自選觀察性樣本、只有 12 天、非代表性)——拿掉限制轉述數字,等於發布一則誤導性的統計。
- 連結回本頁——讓你的讀者看得到方法與版本。
- 寫「learner identifiers」而不是「人數」——identifier 是自然人數的上界,不是人數。
- 寫出版本號(例:v1.1.0,snapshot 2026-08-14)——日後數字更新時,你引用的那一版仍然可以被指認。
不在授權範圍內的東西
- 本站製作的圖表(
/images/research/*.svg與*.png):轉載請先來信取得同意。用資料自己畫新圖不需要同意。 - 報告全文與網頁文字:保留權利。
- 站台名稱、標誌與品牌識別:本授權不授予使用權。
⚠️ CC BY 是不可撤回的授權。任何依此條款取得資料的人,其權利不會因為本站日後變更條款而失效。我們寫在這裡,是因為引用者有權知道自己拿到的授權有多穩定。
十二、下載資料
兩種格式,內容相同,都是彙總統計(沒有任何一筆原始作答事件):
- japanese-learning-2026.json — 含完整後設資料、定義、方法、限制與全部彙總格。
- japanese-learning-2026-LICENSE.txt — 授權聲明(CC BY 4.0、範圍、標示字串)。CSV 本身沒有欄位放授權資訊,所以另附一份。
- japanese-learning-2026.csv — 攤平成一列一格,欄位:
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag。
版本 1.1.0・snapshot 2026-08-14・方法版本 1.1。之後更新會提高版本號並保留舊版數字,不會就地改寫。
圖表檔案:本頁四張圖都提供 PNG(2 倍解析度,適合投影片與排版)與 SVG(向量,可縮放)。
每張圖都內建標題、n、版本與來源標註,單獨轉出去也看得懂口徑;四張圖的替代文字集中在 alt-text.json。⚠️ 圖表不在 CC BY 範圍,轉載請先來信(見聯絡窗口);資料本身採 CC BY 4.0,標示出處即可自由使用(見授權)。
⚠️ 若需引用,請使用版本化凍結資料集,不要引用即時 /api/aggregates 數字。
站上另有一個即時彙總端點 /api/aggregates,每次呼叫回傳當下數字。它與本資料集口徑不同:它是「全部作答」口徑(不是測驗情境首答),而且它的 totalUsers 只計主要集合的 learner identifiers(688),不是全部 1,053 個。那個端點的數字每天都在變,不適合引用。
給記者
- 樣本:56,613 筆匿名作答、1,053 個匿名 learner identifiers(不是經驗證的人數)、12 天(2026 年 8 月 2–13 日)。
- 方法一句話:自選觀察性樣本的原始正確率,主要數字採「測驗情境首答」集合(challenge/程度測驗/特訓的首次作答)。
- 限制一句話:不是台灣日語學習者的代表性調查,也不能用來比較 JLPT 各級的客觀難度。
三個可以直接寫的數字:
- 句型題正確率 53.7%(n=8,678),詞彙題 92.1%(n=22,869)——差 38 個百分點。
- 助詞「が」正確率 60.9%(n=358),「を」78.7%(n=385)。
- 句型軸的「正確率」在 53.7% 到 74.1% 之間,取決於納入哪些作答情境(教材情境首答 85.4%,測驗情境首答 53.7%)。⚠️ 兩種情境的題目集合幾乎不重疊,不能斷定原因——但這本身就是一則關於「學習平台數據怎麼被引用」的故事。
嵌入這份資料(部落格與教材可直接貼)
把下面這段 HTML 貼進你的文章或講義即可。它已經內建樣本數、版本、授權與「不代表母體」的警語——這正是引用統計數字時最常被漏掉、也最容易出錯的部分。不需要事先告知我們。
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">在 56,613 筆匿名作答中,測驗情境首答的句型/文法正確率為 <strong>53.7%</strong>(n=8,678),詞彙為 <strong>92.1%</strong>(n=22,869)。</p><p style="margin:0;font-size:13px;color:#8a7a68">資料:<a href="https://www.nihongotojapan.com/research/japanese-learning-data-2026">Nihongo to Japan《日語學習作答彙總資料集・2026 年 8 月》</a> v1.1.0・CC BY 4.0・自選觀察性樣本,不代表母體</p></blockquote>
為什麼給的是可貼上的 HTML,不是 iframe?兩個原因:本站基於資安設定不允許被 iframe 嵌入(全站 frame-ancestors 'none');而且 iframe 裡的內容掛在我們的網域,對你的頁面來說不算一條你給出的連結,可貼上的區塊才是。你也完全可以自己排版——資料是 CC BY 4.0,只要標示出處就好。
要放圖的話:本站圖表不在授權範圍,但你可以用 CSV 自己畫,畫出來的圖是你的。教學或媒體用途想直接拿我們的圖,見給媒體。
給媒體:新聞資料包
這一節的內容可以直接複製使用,不需要事先取得同意(圖表除外,見下)。快速事實與可直接引用的三個數字在給記者;完整的十條發現在可直接引用的十條發現。
機構簡介(boilerplate)
長版:
Nihongo to Japan 是一個由台灣的個人開發者獨立經營的免費日文學習網站,免註冊、不設付費牆,內容涵蓋 JLPT N5 到 N1 的文法解說、自學教材與練習題庫。本資料集來自站上使用者的匿名作答紀錄,依凍結 snapshot 彙總後公開,附完整方法與限制說明。
短版:
Nihongo to Japan,台灣獨立經營的免費日文學習網站,公開其學習者匿名作答的彙總資料集。
媒體用圖
本站製作的圖表不在 CC BY 4.0 範圍內(授權只涵蓋資料,見授權)。我們不希望這變成你的阻礙,所以提供兩條路:
- 來信索取:我們在 24 小時內寄出可刊登的圖檔(PNG 與 SVG)+正確的圖說、樣本數與版本標註。這是圖片的快速通道,比一般詢問(2–3 個工作日)快。
- 不想等:自己畫。資料本身是 CC BY 4.0,你可以直接用 JSON 或 CSV 製作自己的圖表,你畫的圖是你的,不需要任何同意,也不必告知我們。
負責任報導的四個提醒
這些不是條件,是為了讓你不用事後更正:
- ✅ 請寫「在這批作答裡」「在測驗情境的首次作答中」——本頁所有數字都是這份資料集內的觀察值。
- ❌ 不要寫成「台灣人如何如何」。樣本是自己選擇來這個網站刷題的人,不代表任何母體。
- ❌ 不要比較 JLPT 級別的難度。各級題目集合不同、沒有做 IRT 難度等化,而且 N3 與 N2 的信賴區間重疊——這份資料無法區分兩者。
- ❌ 不要寫成因果。資料能說「同時觀察到」,不能說「因為所以」。
不確定某個寫法可不可以,直接寫信問我們——這比見報後更正省事得多。
可署名引述
以下兩句可以直接引用,不需另外詢問。
「同樣是測驗題的首次作答,詞彙題答對 92.1%,句型題只有 53.7%。這只描述了會主動來這個網站刷題的人身上發生的事,不能推到所有學習者身上。但如果你也卡在『字都看得懂、句子就是組不出來』,至少這不是你一個人的問題。」
— Nihongo to Japan 站長(Founder)
「同一批資料,光是換掉『要納入哪些作答』的定義,句型正確率就從 53.7% 變成 85.4%。我們把四種口徑一起公開,是因為只報一個數字,讀者根本看不出來那是哪一種。」
— Nihongo to Japan 站長(Founder)
本站沒有研究團隊,也沒有發言人。以上引述掛在實際製作這份資料的人名下;若需要針對特定問題的回應,請走聯絡窗口。
給研究者與教育工作者
資料結構:一列=一個彙總格。維度為 dimension(axis/jlpt/knowledge_point/axis_x_jlpt)× analysis_set(quiz_first_attempt/lesson_first_attempt/first_attempt/all_events)。每格提供 n、learners、accuracy、Wilson ci95_low/ci95_high 與 flag。JSON 另含 analysis-set 分解、成對比較與 weighting effect。
抽樣:自選、觀察性;分析單位為 answer event;learner identifier 為匿名 UUID(跨裝置無法合併,因此這個數字是自然人數的上界,不是經驗證的不重複人數)。
已知的方法缺口(我們認為值得寫出來,而不是藏起來):
- 沒有 IRT 難度等化,也沒有跨級別共同題設計 → 級別間的比較不成立。
- 教材情境與測驗情境的題目集合幾乎不重疊(5,772 道句型題只有 6 道重疊)→ 情境效果與題目難度無法分離。
- 提示/看解析/看答案三個欄位從未被寫入 → 這些行為不可觀測,不能作為分析條件,也不能宣稱「沒有發生」。
- 回應時間 94% 為空值 → 無法做速度/正確率的權衡分析,也無法過濾異常快的作答。
- 沒有人口統計變項(年齡、母語、學習年資、國家)→ 無法做分層分析。資料集沒有母語欄位,也沒有地理欄位,因此本報告不對學習者的母語或所在地做任何推論。
- 12 天的窗口 → 不能做學習曲線或保留率分析。
- 學習者層級的資料未公開(只有彙總),因此無法在外部重做多層次模型。若研究上有需要,請聯絡討論。
媒體與資料聯絡窗口
Nihongo to Japan 站長(Founder)・Email:[email protected]
可回答:方法論細節、彙總數字的複查、圖表使用申請、限制與適用範圍、以及「這份資料能不能回答我的問題」這類判斷。一般在 2–3 個工作日內回覆;媒體索取可刊登圖檔走快速通道,24 小時內回覆(見給媒體)。
本站由台灣的個人開發者獨立經營。本站沒有研究團隊,也沒有發言人——上面這個信箱就是實際做出這份資料的人,不是轉接窗口。這點寫在這裡,是因為引用者有權知道資料背後是誰。
版本與更新紀錄
本頁網址永遠指向最新一版的 snapshot。每一版都有版本號與凍結日期,引用時請一併寫出版本(例:v1.1.0,snapshot 2026-08-14)——日後數字更新時,你引用的那一版仍然可以被指認。JSON 與 CSV 下載檔內含相同的版本欄位。
| 版本 | snapshot 凍結日 | 涵蓋期間 | 說明 |
|---|---|---|---|
| v1.1.0 | 2026-08-14 | 2026-08-02 至 08-13(12 天) | 首次公開發布。主要分析集合為「測驗情境首答」,四種分析集合並列公開。 |
下一版預計在累積約三個月資料後發布,屆時才有趨勢可談。資料更新不會改寫已發布版本的數字:新版會是新的版本號與新的凍結日期,舊版數字仍以其版本號被指認。若你已在論文或報導中引用某個版本而該版數字有變動,請來信,我們會直接告知差異。