ชุดข้อมูลคำตอบของผู้เรียนภาษาญี่ปุ่น — สิงหาคม 2026: อัตราการตอบถูกจากคำตอบนิรนาม 56,613 รายการ (สแนปช็อต 12 วัน)
📢 มีเวอร์ชันใหม่กว่าแล้ว: ชุดข้อมูลสรุปการตอบคำถามการเรียนภาษาญี่ปุ่น — ตุลาคม 2026 (v2.0.0, คำตอบ 543,344 รายการ) v2 ใช้ชุดวิเคราะห์ที่ต่างออกไป จึงนำตัวเลขไปลบกับตัวเลขในหน้านี้โดยตรงไม่ได้ ส่วนตัวเลขของ v1.1.0 ในหน้านี้ไม่มีการเปลี่ยนแปลงและยังอ้างอิงได้ตามเดิม
สรุปในหนึ่งบรรทัด: สถิติรวมจากเหตุการณ์การตอบแบบนิรนาม 56,613 รายการบน Nihongo to Japan ซึ่งมาจากตัวระบุผู้เรียนนิรนาม 1,053 ตัว ครอบคลุมโจทย์ 11,987 ข้อ
⚠️ นี่คือสแนปช็อตของเดือนสิงหาคม 2026 ไม่ใช่การศึกษาที่ครอบคลุมทั้งปี 2026 ข้อมูลครอบคลุมวันที่ 2–13 สิงหาคม 2026 รวมทั้งสิ้นสิบสองวัน (ระบบรวบรวมข้อมูลเริ่มทำงานวันที่ 2 สิงหาคม วันแรกจึงมีข้อมูลไม่ครบทั้งวัน) ข้อมูลนี้ไม่สามารถใช้อ่านแนวโน้มระยะยาวได้ เวอร์ชัน 1.1.0 สแนปช็อตตรึงไว้ ณ วันที่ 2026-08-14
เกี่ยวกับ "ตัวระบุผู้เรียน": ตัวระบุเหล่านี้เป็นรหัสนิรนามที่เบราว์เซอร์สุ่มสร้างขึ้น และไม่สามารถรวมข้ามอุปกรณ์ได้ คนคนเดียวที่ใช้ทั้งโทรศัพท์และแล็ปท็อปจะเกิดตัวระบุสองตัว ดังนั้น 1,053 จึงไม่ใช่จำนวนบุคคลที่ผ่านการยืนยันแล้ว แต่เป็นค่าขอบบน ตลอดทั้งหน้านี้จึงใช้คำว่า "ตัวระบุผู้เรียน" แทนคำว่า "คน"
สิ่งที่ข้อมูลนี้ไม่ใช่ ข้อมูลนี้ไม่ใช่การสำรวจที่เป็นตัวแทนของผู้เรียนภาษาญี่ปุ่นในไต้หวันหรือที่ใดก็ตาม กลุ่มตัวอย่างประกอบด้วยผู้ที่เลือกมาฝึกบนเว็บไซต์นี้เอง จึงเป็นกลุ่มตัวอย่างเชิงสังเกตที่เลือกตนเองเข้ามา (self-selected) ตัวเลขทุกตัวบรรยายเฉพาะสิ่งที่เกิดขึ้นในชุดคำตอบนี้ และไม่สามารถขยายผลไปยังประชากรกลุ่มใดได้ ดูข้อจำกัด
ข้อค้นพบสิบข้อที่อ้างอิงได้ทันที
แต่ละข้อด้านล่างสมบูรณ์ในตัวเอง: ในประโยคมีทั้งชื่อชุดข้อมูล ช่วงเวลาของสแนปช็อต ขนาดตัวอย่าง และช่วงความเชื่อมั่น นักข่าวหรือนักวิจัยจึงคัดลอกข้อใดข้อหนึ่งไปใช้ได้โดยไม่ต้องย้อนกลับมาหาบริบท ตัวเลขทุกตัวเป็นค่าที่สังเกตได้ภายในชุดข้อมูลนี้ (ชุดวิเคราะห์หลักคือการตอบครั้งแรกในบริบทแบบทดสอบ — ดูระเบียบวิธี) ไม่ใช่การอนุมานถึงประชากรผู้เรียนภาษาญี่ปุ่น และไม่มีการกล่าวอ้างเชิงเหตุและผล กรุณาอ้างอิงข้อจำกัดควบคู่ไปกับตัวเลขด้วย
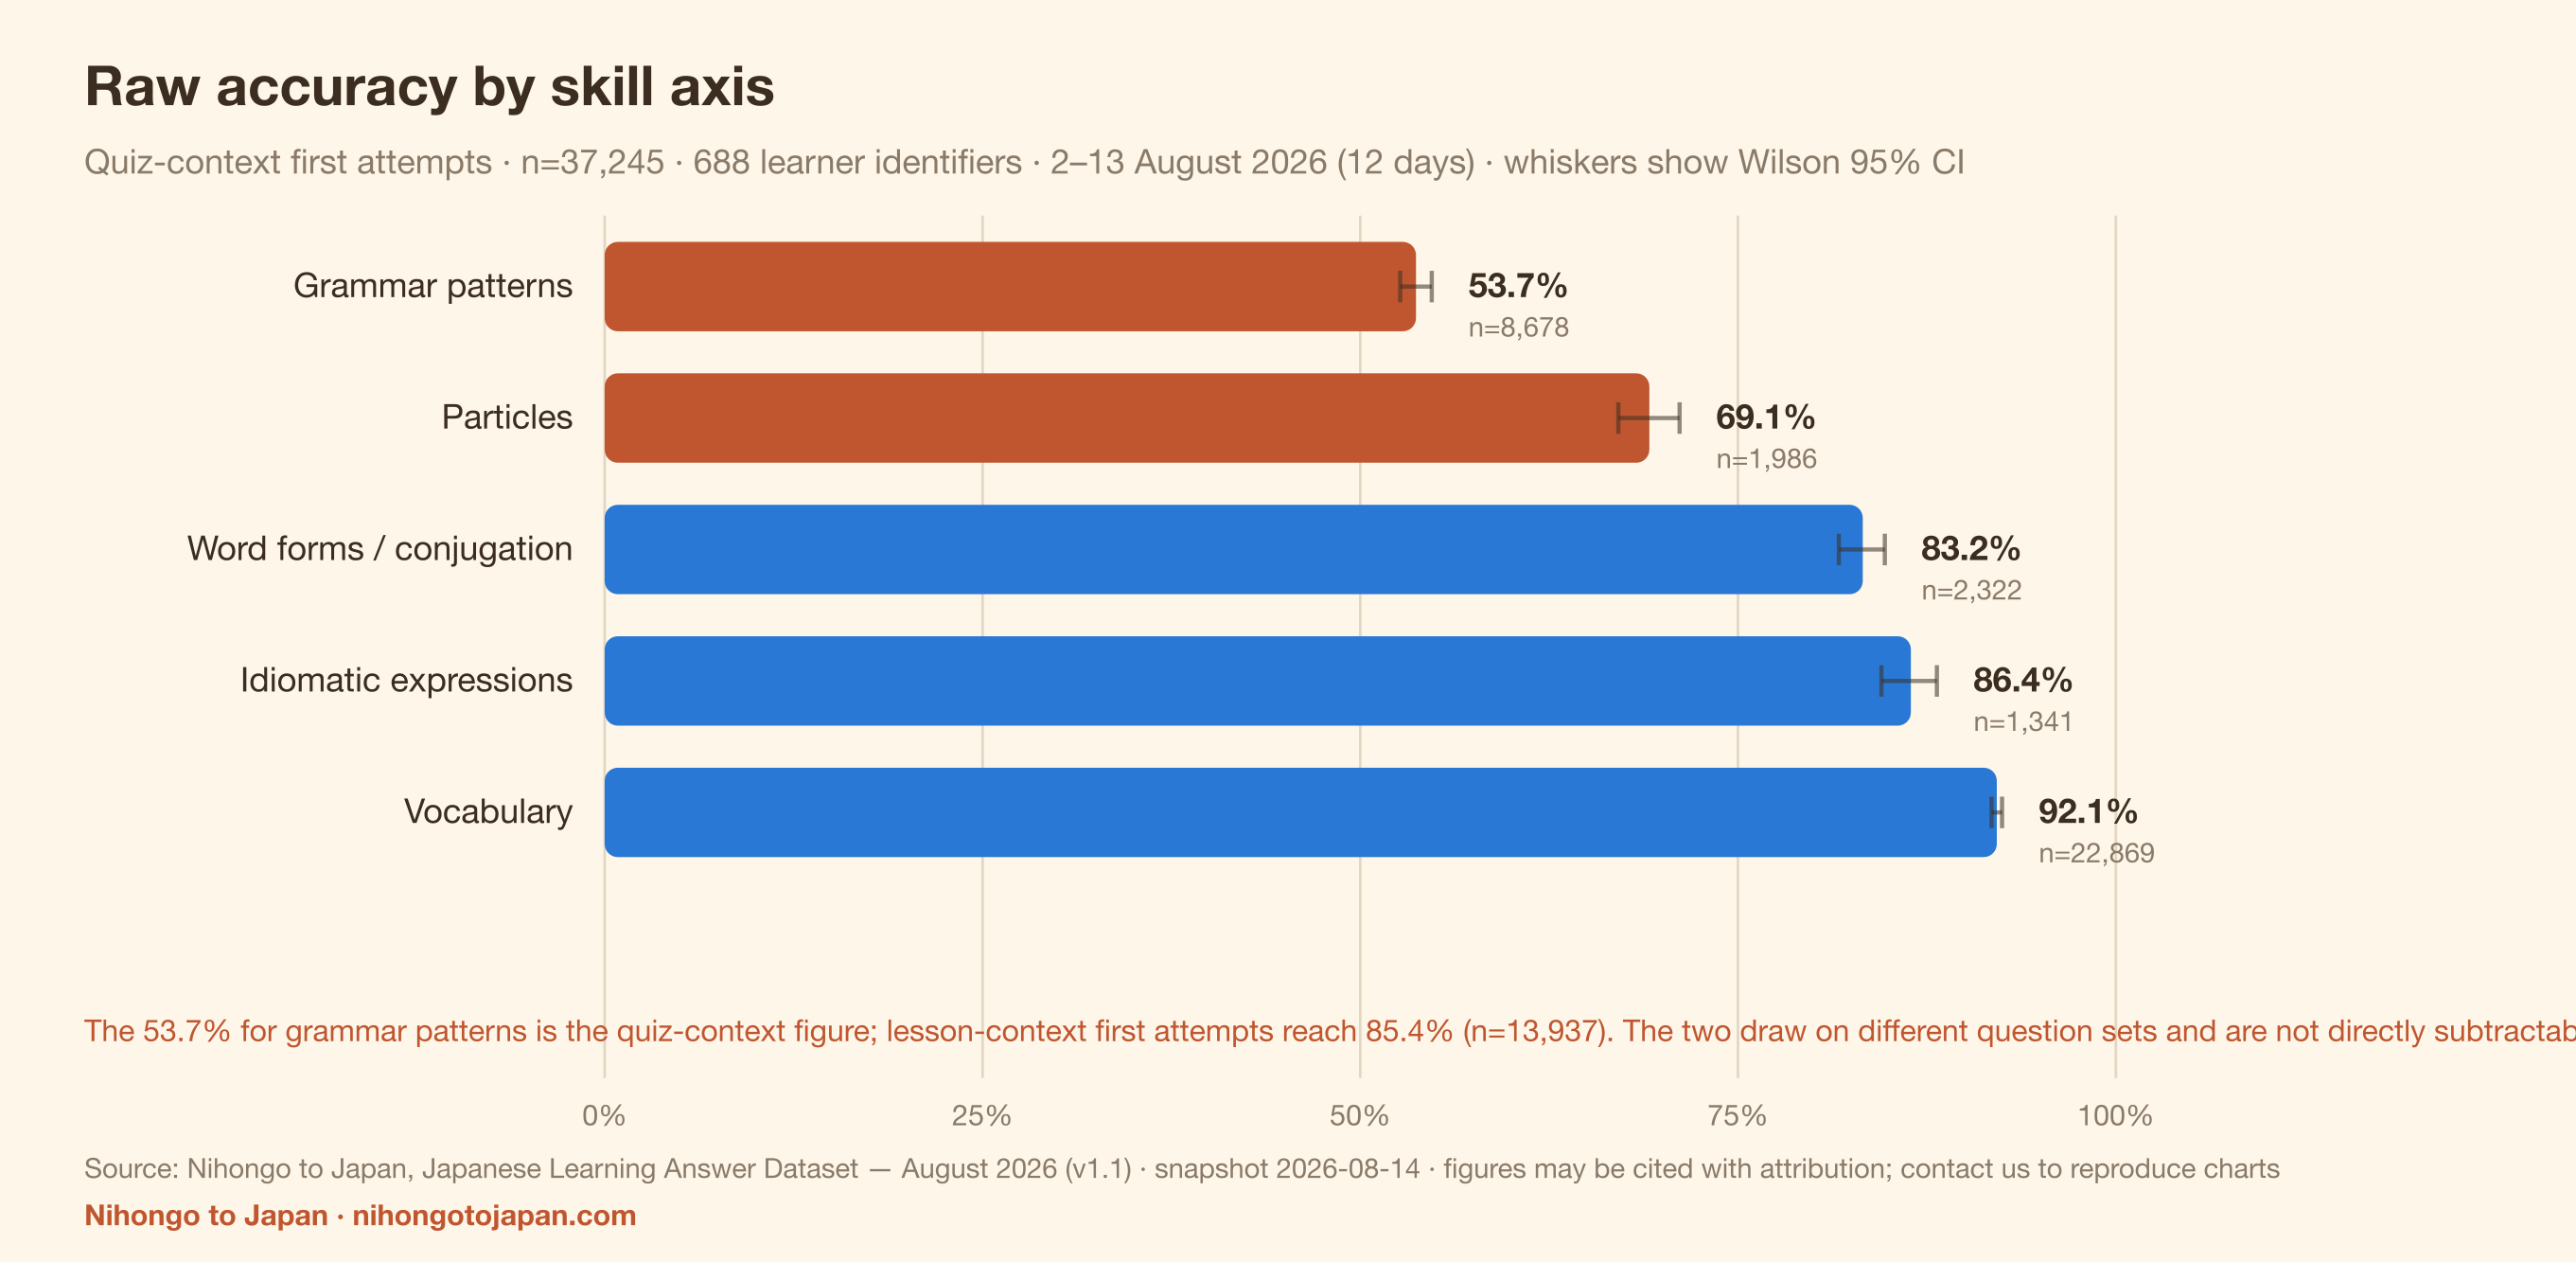
- ในการตอบครั้งแรกในบริบทแบบทดสอบของชุดข้อมูลคำตอบของผู้เรียนภาษาญี่ปุ่นของ NTJ (สแนปช็อตสิงหาคม 2026, 12 วัน) โจทย์รูปประโยคมีอัตราการตอบถูก 53.7% (n=8,678; ช่วงความเชื่อมั่น Wilson 95% 52.6%–54.7%) เทียบกับ 92.1% สำหรับคำศัพท์ (n=22,869; ช่วงความเชื่อมั่น 95% 91.8%–92.5%) ห่างกัน 38 จุดร้อยละ
ช่วงความเชื่อมั่นทั้งสองไม่ซ้อนทับกัน ช่องว่างนี้จึงไม่ใช่ความคลาดเคลื่อนจากการสุ่มตัวอย่าง ทั้งนี้รายงานนี้ไม่ได้กล่าวอ้างถึงสาเหตุ - ในการตอบครั้งแรกในบริบทแบบทดสอบของชุดข้อมูลเดียวกัน แกนความสามารถทั้งห้าเรียงจากต่ำไปสูงได้ดังนี้: รูปประโยค 53.7% (n=8,678), คำช่วย 69.1% (n=1,986; ช่วงความเชื่อมั่น 95% 67.1%–71.1%), รูปคำและการผัน 83.2% (n=2,322; ช่วงความเชื่อมั่น 95% 81.7%–84.7%), สำนวน 86.4% (n=1,341; ช่วงความเชื่อมั่น 95% 84.5%–88.2%) และคำศัพท์ 92.1% (n=22,869)
แต่ละแกนใช้ชุดโจทย์ต่างกัน นี่จึงเป็นการเรียงลำดับอัตราการตอบถูกที่สังเกตได้ ไม่ใช่การเรียงลำดับความยาก - ในชุดข้อมูลเดียวกัน อัตราการตอบถูกที่สังเกตได้ของแกนรูปประโยคอยู่ระหว่าง 53.7% ถึง 85.4% ขึ้นอยู่กับว่านับคำตอบใดบ้าง: 53.7% ในการตอบครั้งแรกในบริบทแบบทดสอบ (n=8,678), 85.4% ในการตอบครั้งแรกในบริบทบทเรียน (n=13,937) และ 74.1% เมื่อนับเหตุการณ์การตอบทั้งหมด (n=24,293)
สองบริบทนี้ใช้ชุดโจทย์ที่แทบไม่ซ้ำกันเลย — จากโจทย์รูปประโยคที่ไม่ซ้ำกัน 5,772 ข้อ มีเพียง 6 ข้อที่ปรากฏในทั้งสองบริบท — จึงแยกผลของบริบทออกจากความต่างของความยากของโจทย์ไม่ได้ ประเด็นของข้อค้นพบนี้คือ ตัวเลขอัตราการตอบถูกใดก็ตามที่อ้างจากแพลตฟอร์มการเรียน ต้องระบุว่านับคำตอบใดบ้าง - ในการตอบครั้งแรกในบริบทแบบทดสอบของชุดข้อมูลเดียวกัน อัตราการตอบถูกดิบของ N3 คือ 67.8% (n=5,985; ช่วงความเชื่อมั่น 95% 66.6%–69.0%) และของ N2 คือ 69.4% (n=2,726; ช่วงความเชื่อมั่น 95% 67.6%–71.1%) ช่วงความเชื่อมั่นซ้อนทับกัน ดังนั้นชุดข้อมูลนี้แยก N2 กับ N3 ออกจากกันไม่ได้
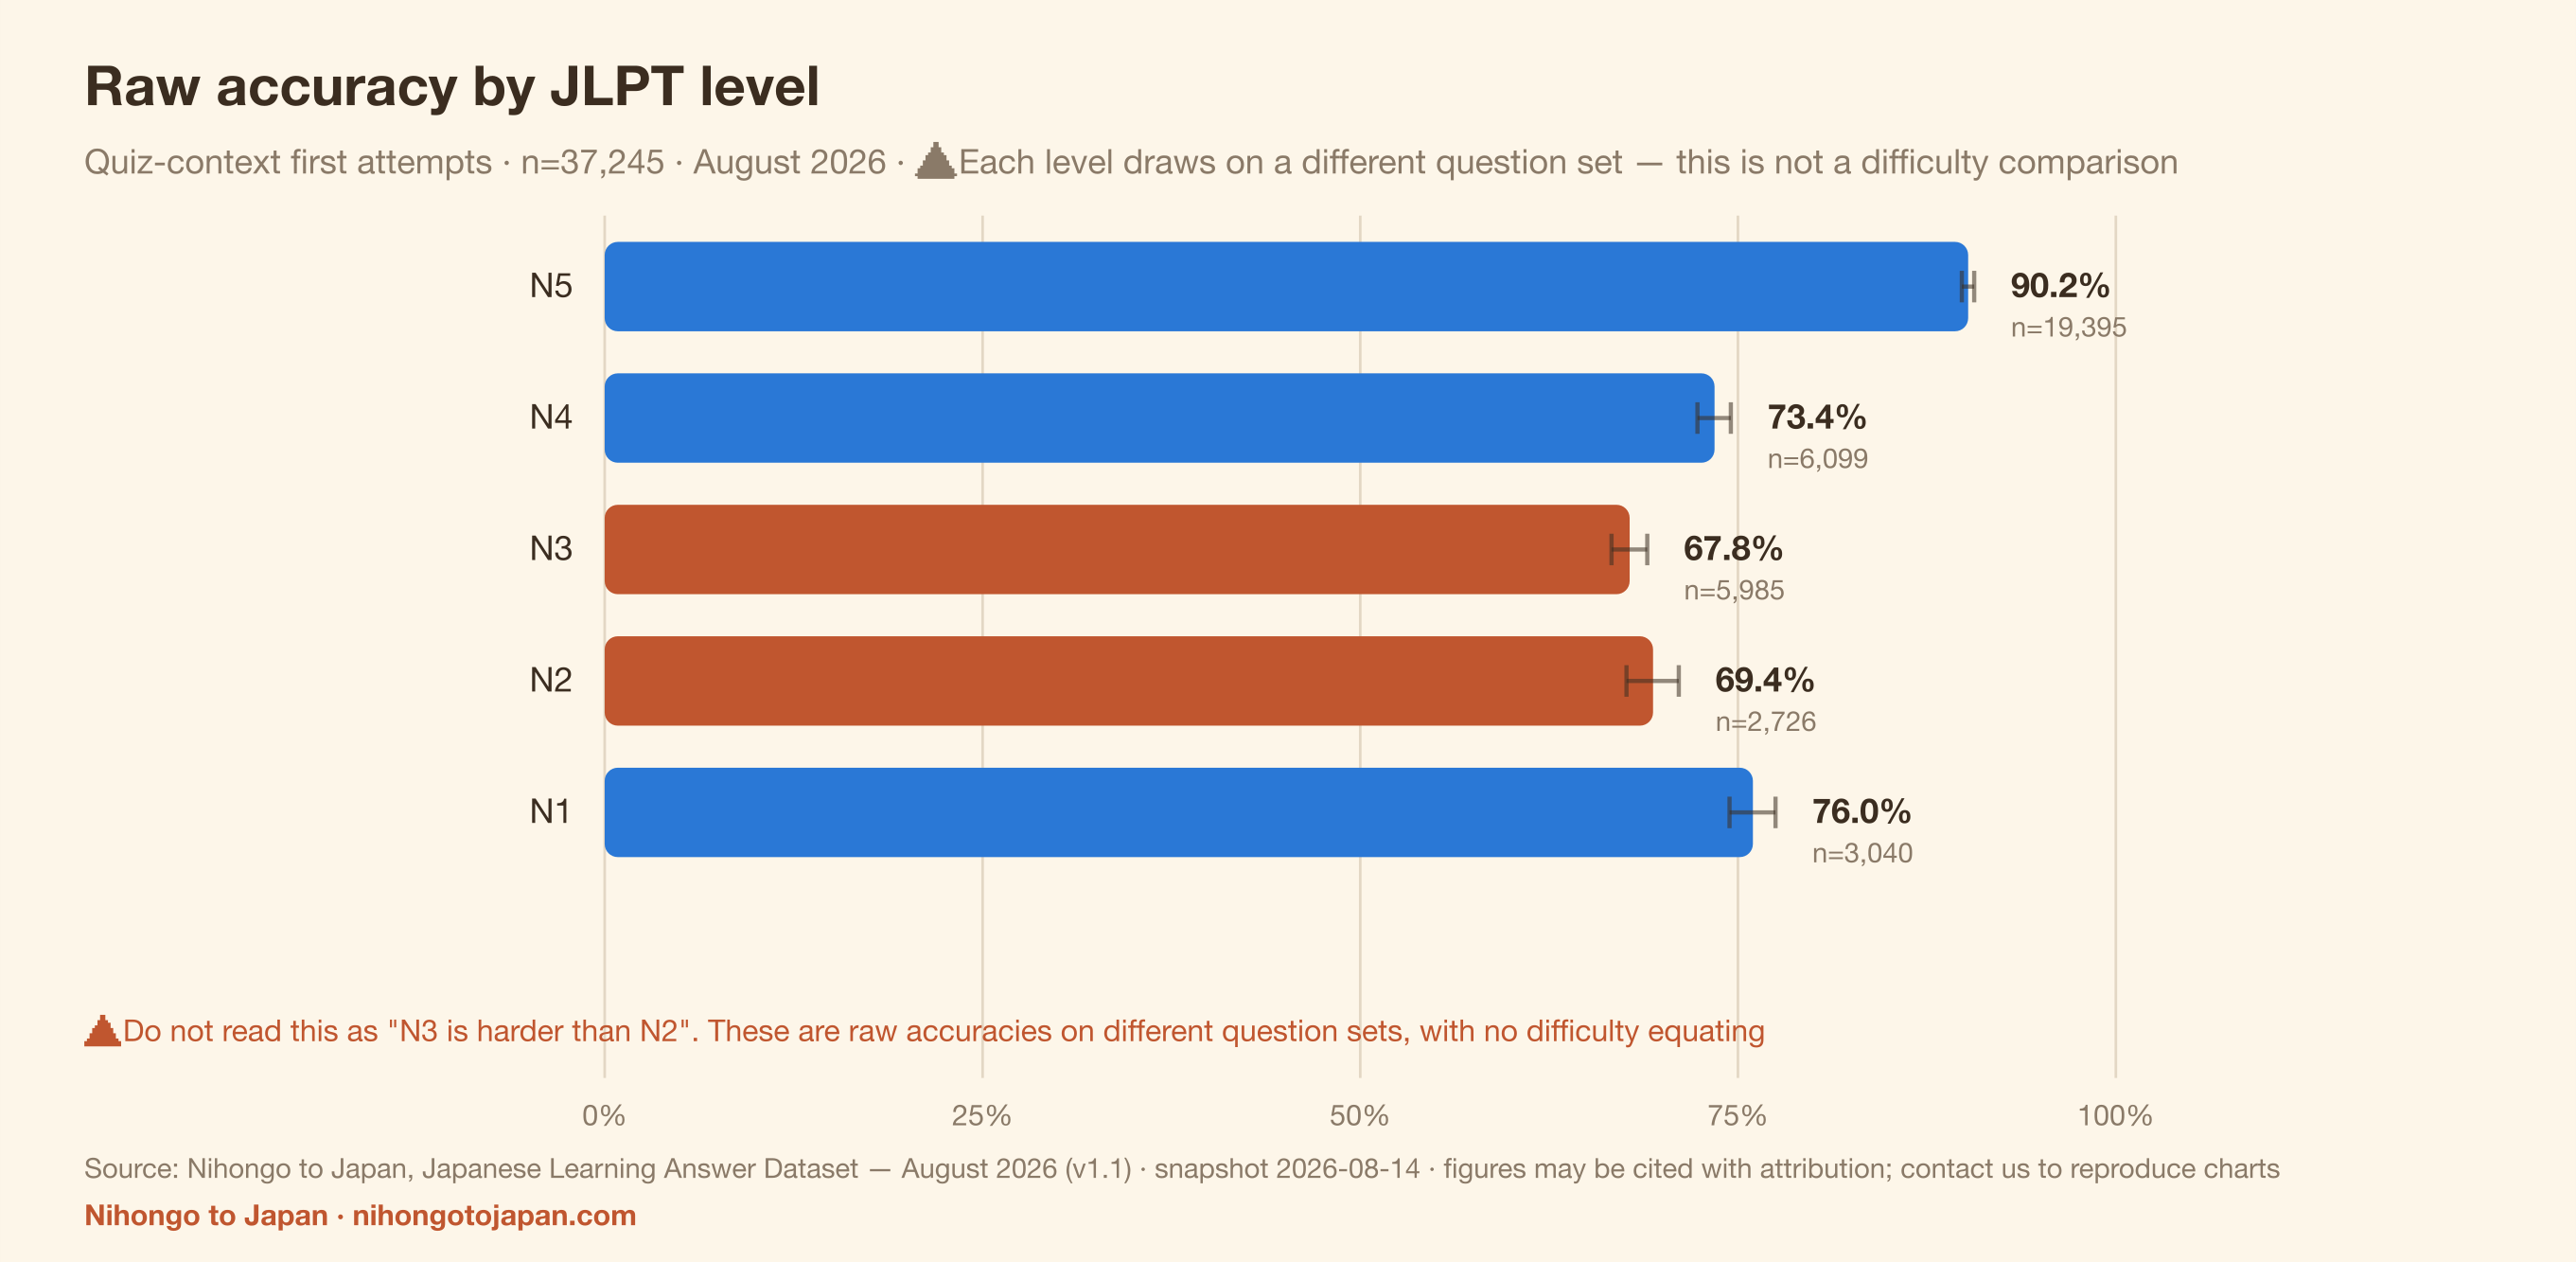
อย่ารายงานว่า "N2 ยากกว่า N3" หรือในทางกลับกัน - ในการตอบครั้งแรกในบริบทแบบทดสอบของชุดข้อมูลเดียวกัน อัตราการตอบถูกดิบแยกตามระดับ JLPT คือ N5 90.2% (n=19,395), N1 76.0% (n=3,040), N4 73.4% (n=6,099), N2 69.4% (n=2,726) และ N3 67.8% (n=5,985) — อัตราการตอบถูกดิบของ N1 สูงกว่าทั้ง N2 และ N3
แต่ละระดับใช้ชุดโจทย์ต่างกัน ไม่มีการปรับเทียบด้วย IRT และกลุ่มตัวอย่างเลือกตนเองเข้ามา (ผู้ที่ทำโจทย์ N1 มักเรียนมาไกลกว่า) ลำดับนี้จึงไม่สามารถตีความเป็นความยากเชิงวัตถุวิสัยของระดับ JLPT ได้ - ในการตอบครั้งแรกในบริบทแบบทดสอบของชุดข้อมูลเดียวกัน ความแตกต่างภายในหมวดคำช่วยกว้างกว่าความแตกต่างระหว่างระดับ JLPT: คำช่วย が มีอัตราการตอบถูก 60.9% (n=358; ช่วงความเชื่อมั่น 95% 55.8%–65.8%) และ を 78.7% (n=385; ช่วงความเชื่อมั่น 95% 74.3%–82.5%) — ห่างกัน 17.8 จุด เทียบกับ 5.6 จุดระหว่าง N3 (67.8%) กับ N4 (73.4%)
นัยต่อการสอนคือ การจัดสรรการฝึกตามระดับ JLPT อาจหยาบกว่าการจัดสรรตามจุดความรู้ - ในการตอบครั้งแรกในบริบทแบบทดสอบของชุดข้อมูลเดียวกัน รูปประโยคเป็นแกนที่คะแนนต่ำสุดในทุกระดับ JLPT: 64.0% ที่ N5 (n=1,939), 48.0% ที่ N4 (n=1,734), 49.2% ที่ N3 (n=2,531), 51.1% ที่ N2 (n=1,179) และ 57.0% ที่ N1 (n=1,295)
คำศัพท์ในระดับเดียวกัน: 94.4% ที่ N5, 89.0% ที่ N4, 84.0% ที่ N3, 85.0% ที่ N2 และ 89.2% ที่ N1 - ในชุดข้อมูลเดียวกัน เมื่อคำนวณจากตัวระบุผู้เรียน 372 ตัวชุดเดียวกันทุกประการและเหตุการณ์การตอบ 34,392 รายการชุดเดียวกัน การให้หนึ่งคำตอบเท่ากับหนึ่งเสียง (ถ่วงน้ำหนักตามเหตุการณ์) ได้ 82.53% ขณะที่การให้หนึ่งตัวระบุเท่ากับหนึ่งเสียงได้ 75.49% — ต่างกัน 7.04 จุดร้อยละ
ตัวเลขทั้งสองใช้ประชากรและชุดวิเคราะห์เดียวกันทุกประการ ความต่างจึงมาจากวิธีถ่วงน้ำหนักล้วน ๆ รายงานใดที่อ้างอัตราการตอบถูกจากแพลตฟอร์มการเรียนควรระบุว่าใช้การถ่วงน้ำหนักแบบใด - ในชุดข้อมูลเดียวกัน ปริมาณการตอบกระจุกตัวสูงมาก: ตัวระบุผู้เรียนที่ตอบมากที่สุดเพียงตัวเดียวคิดเป็น 3.73% ของเหตุการณ์การตอบทั้งหมด 56,613 รายการ และตัวระบุ 10 อันดับแรกรวมกันคิดเป็น 19.44%
การกระจุกตัวนี้คือเหตุผลโดยตรงที่การถ่วงน้ำหนักสองแบบให้ผลต่างกัน 7 จุด และเป็นอคติเชิงโครงสร้างที่ข้อมูลจากแพลตฟอร์มการเรียนโดยทั่วไปมีร่วมกัน - ในชุดข้อมูลเดียวกัน การเปรียบเทียบแบบจับคู่ที่จำกัดเฉพาะตัวระบุผู้เรียน 75 ตัวที่ตอบในทั้งสองบริบท (อย่างน้อยฝั่งละ 5 คำตอบ) ได้ 86.57% ในบริบทบทเรียน (n=5,858) เทียบกับ 55.52% ในบริบทแบบทดสอบ (n=2,055) ผลต่างเฉลี่ยแบบจับคู่ 27.47 จุดร้อยละ (ช่วงความเชื่อมั่น 95% 22.56–32.39)
ข้อนี้แสดงว่าช่องว่างระหว่างบริบทไม่ได้เป็นผลพลอยได้จากการที่คนต่างกลุ่มตอบในบริบทต่างกัน แต่เนื่องจากเปรียบเทียบด้วยโจทย์ข้อเดียวกันไม่ได้ (ดูข้อค้นพบที่ 3) จึงยังแยกผลของบริบทออกจากความยากของโจทย์ไม่ได้
แต่ละข้อค้นพบมีคำอธิบายเพิ่มเติม ตาราง และกราฟในหัวข้อด้านล่าง หากต้องการเฉพาะตัวเลข ไปที่ดาวน์โหลดข้อมูล หากต้องการอ้างอิง ดูวิธีอ้างอิง หากมีคำถาม ดูหัวข้อติดต่อ
1. ข้อค้นพบหลักห้าข้อ
1. รูปประโยคเป็นแกนเดียวที่ต่ำกว่า 60% ตามหลังคำศัพท์ 38 จุด
ในการตอบครั้งแรกในบริบทแบบทดสอบ (นิยามของชุดดูได้ที่ระเบียบวิธี) โจทย์คำศัพท์มีอัตราการตอบถูก 92.1% (n=22,869, ตัวระบุผู้เรียน 627 ตัว, ช่วงความเชื่อมั่น 95% 91.8%–92.5%) ขณะที่โจทย์รูปประโยคได้เพียง 53.7% (n=8,678, ตัวระบุ 532 ตัว, ช่วงความเชื่อมั่น 95% 52.6%–54.7%)
ช่วงความเชื่อมั่นห่างกันมาก นี่จึงไม่ใช่ความคลาดเคลื่อนจากการสุ่มตัวอย่าง ข้อมูลแสดงให้เห็นช่องว่างขนาดใหญ่ระหว่างสองแกนนี้ แต่ไม่ได้บอกอะไรเลยว่าเป็นเพราะอะไร
2. "อัตราการตอบถูก" ของรูปประโยคอยู่ระหว่าง 53.7% ถึง 74.1% ขึ้นอยู่กับว่านับคำตอบใดบ้าง
ภายใต้นิยามชุดวิเคราะห์ที่ต่างกัน อัตราการตอบถูกที่สังเกตได้ของแกนรูปประโยคอยู่ระหว่าง 53.7% (การตอบครั้งแรกในบริบทแบบทดสอบ, n=8,678) ถึง 74.1% (เหตุการณ์การตอบทั้งหมด, n=24,293) เนื่องจากทั้งเหตุการณ์ที่นับรวมและองค์ประกอบของตัวระบุผู้เรียนต่างกัน จึงไม่สามารถตีความความต่างทั้งหมดว่าเป็นผลของกฎการนับเพียงข้อเดียว
ทีละขั้นตอน:
| ขั้นตอน | n | อัตราการตอบถูกดิบ | การเปลี่ยนแปลงจากขั้นก่อนหน้า |
|---|---|---|---|
| เหตุการณ์การตอบทั้งหมด | 24,293 | 74.1% | — |
| → เก็บเฉพาะการตอบครั้งแรก | 22,638 | 73.2% | -0.87 จุดร้อยละ |
| → เก็บเฉพาะบริบทแบบทดสอบ (ตัดบทเรียน/การทบทวนออก) | 8,678 | 53.7% | -19.54 จุดร้อยละ |
| (เปรียบเทียบ) การตอบครั้งแรกในบริบทบทเรียน | 13,937 | 85.4% | — |
การตัดการตอบซ้ำออกทำให้ตัวเลขเปลี่ยนเพียง 0.9 จุดร้อยละ ส่วนที่เหลือเกือบทั้งหมดมาจากความต่างระหว่างคำตอบในบริบทบทเรียนกับคำตอบในบริบทแบบทดสอบ
การเปรียบเทียบแบบจับคู่บนตัวระบุผู้เรียนชุดเดียวกัน: ตัวระบุ 75 ตัวมีการตอบโจทย์รูปประโยคครั้งแรกอย่างน้อย 5 ครั้งในแต่ละบริบท กลุ่มนี้ได้ 86.6% ในบริบทบทเรียน (n=5,858) และ 55.5% ในบริบทแบบทดสอบ (n=2,055) ผลต่างเฉลี่ยแบบจับคู่ +27.5 จุดร้อยละ (ช่วงความเชื่อมั่น 95% 22.6–32.4; มัธยฐาน +26.9) ดังนั้นช่องว่างนี้ไม่ได้เป็นเพียงเรื่องของว่าใครเป็นผู้ตอบ
⚠️ ไม่สามารถเปรียบเทียบด้วยโจทย์ข้อเดียวกันได้ จึงยังสรุปไม่ได้ จากโจทย์รูปประโยคที่ไม่ซ้ำกัน 5,772 ข้อ มีเพียง 6 ข้อที่ปรากฏในทั้งสองบริบท และมีเพียง 1 ข้อที่มีคำตอบอย่างน้อยฝั่งละ 3 คำตอบ สองบริบทนี้ใช้ชุดโจทย์ที่แทบไม่ซ้ำกันเลย จึงแยกผลของบริบทออกจากความต่างของความยากของโจทย์ไม่ได้ โจทย์ในบริบทบทเรียนอาจเพียงแค่ง่ายกว่าก็ได้
สิ่งที่พูดได้อย่างซื่อตรงคือ เมื่ออ้างอิงตัวเลขอัตราการตอบถูกจากแพลตฟอร์มการเรียน ให้ถามเสมอว่ามาจากชุดวิเคราะห์ใด ทั้งสี่ชุดอยู่ในข้อมูลที่ดาวน์โหลดได้
3. N3 และ N2 มีอัตราการตอบถูกดิบต่ำที่สุด — แต่ข้อมูลนี้แยกทั้งสองออกจากกันไม่ได้
อัตราการตอบถูกดิบของการตอบครั้งแรกในบริบทแบบทดสอบแยกตามระดับ: N5 90.2%, N4 73.4%, N3 67.8%, N2 69.4%, N1 76.0%
ช่วงความเชื่อมั่นของ N3 (ช่วงความเชื่อมั่น 95% 66.6%–69.0%) และ N2 (ช่วงความเชื่อมั่น 95% 67.6%–71.1%) ซ้อนทับกัน การกล่าวว่า "N3 ยากกว่า N2" จึงไม่ถูกต้อง สิ่งที่พูดได้คือ ในกลุ่มตัวอย่างนี้ N2 และ N3 ต่างก็มีอัตราการตอบถูกดิบต่ำกว่า N4, N1 และ N5
⚠️ ที่สำคัญกว่านั้น แต่ละระดับใช้ชุดโจทย์ที่ต่างกันโดยสิ้นเชิง ลำดับนี้ไม่ใช่การเปรียบเทียบความยาก และไม่ใช่หลักฐานว่าระดับ JLPT ใดยากกว่ากันในเชิงวัตถุวิสัย
4. ความแตกต่างภายในหมวดคำช่วยกว้างกว่าความแตกต่างระหว่างระดับ
อัตราการตอบถูกของการตอบครั้งแรกในบริบทแบบทดสอบสำหรับคำช่วยแต่ละตัว: が 60.9% (n=358, ช่วงความเชื่อมั่น 55.8%–65.8%), に 62.4% (n=370), で 63.3% (n=330) เทียบกับ を 78.7% (n=385, ช่วงความเชื่อมั่น 74.3%–82.5%) และ の 83.3% (n=120)
ช่วงความเชื่อมั่นของ が และ を ไม่ซ้อนทับกัน ช่องว่างอยู่ที่ 18 จุดร้อยละ
5. หนึ่งตัวระบุหนึ่งเสียงกับหนึ่งคำตอบหนึ่งเสียงต่างกัน 7.04 จุด
คำนวณจากตัวระบุผู้เรียน 372 ตัวชุดเดียวกันทุกประการ ชุดวิเคราะห์เดียวกัน และเหตุการณ์ที่เข้าเกณฑ์ 34,392 รายการชุดเดียวกัน:
| การถ่วงน้ำหนัก | อัตราการตอบถูก |
|---|---|
| ถ่วงน้ำหนักตามเหตุการณ์ (หนึ่งคำตอบหนึ่งเสียง) | 82.5% |
| ถ่วงน้ำหนักตามตัวระบุ (หนึ่งตัวระบุหนึ่งเสียง) | 75.5% (มัธยฐาน 76.2%) |
| WEIGHTING_EFFECT_PP | 7.04 จุดร้อยละ |
กลุ่มที่ศึกษา: ตัวระบุผู้เรียนที่มีคำตอบอย่างน้อย 20 คำตอบในชุดวิเคราะห์หลัก ตัวเลขทั้งสองใช้ประชากรของตัวเศษและตัวส่วนเดียวกัน ช่องว่างจึงสะท้อนเฉพาะการเลือกวิธีถ่วงน้ำหนัก ไม่ได้ปนเปื้อนจากความต่างขององค์ประกอบกลุ่มตัวอย่าง
สาเหตุคือการวัดซ้ำ: ตัวระบุที่ตอบมากที่สุดเพียงตัวเดียวคิดเป็น 3.7% ของคำตอบทั้งหมด และสิบอันดับแรกคิดเป็น 19.4% งานศึกษาใดที่ใช้ข้อมูลจากแพลตฟอร์มก็ต้องเจอเรื่องนี้ เราจึงเผยแพร่ตัวเลขทั้งสองแบบ
2. ภาพรวมชุดข้อมูล
| รายการ | ค่า |
|---|---|
| เหตุการณ์การตอบที่ใช้ได้ | 56,613 |
| ตัวระบุผู้เรียนนิรนาม (ค่าขอบบนของจำนวนคน) | 1,053 |
| โจทย์ที่ไม่ซ้ำกัน | 11,987 |
| จุดความรู้ | 39 |
| ช่วงเวลาที่ครอบคลุม | 2 ถึง 13 สิงหาคม 2026 (12 วัน) วันแรกมีข้อมูลไม่ครบทั้งวัน |
| เวลาตัดของสแนปช็อต | 2026-08-14T00:00:00Z |
| เหตุการณ์การตอบครั้งแรก | 52,934 |
| การตอบครั้งแรกในบริบทแบบทดสอบ (ชุดหลัก) | 37,245 |
| ตัวระบุผู้เรียนในชุดหลัก | 688 |
| การตอบครั้งแรกในบริบทบทเรียน (ชุดเปรียบเทียบ) | 15,741 |
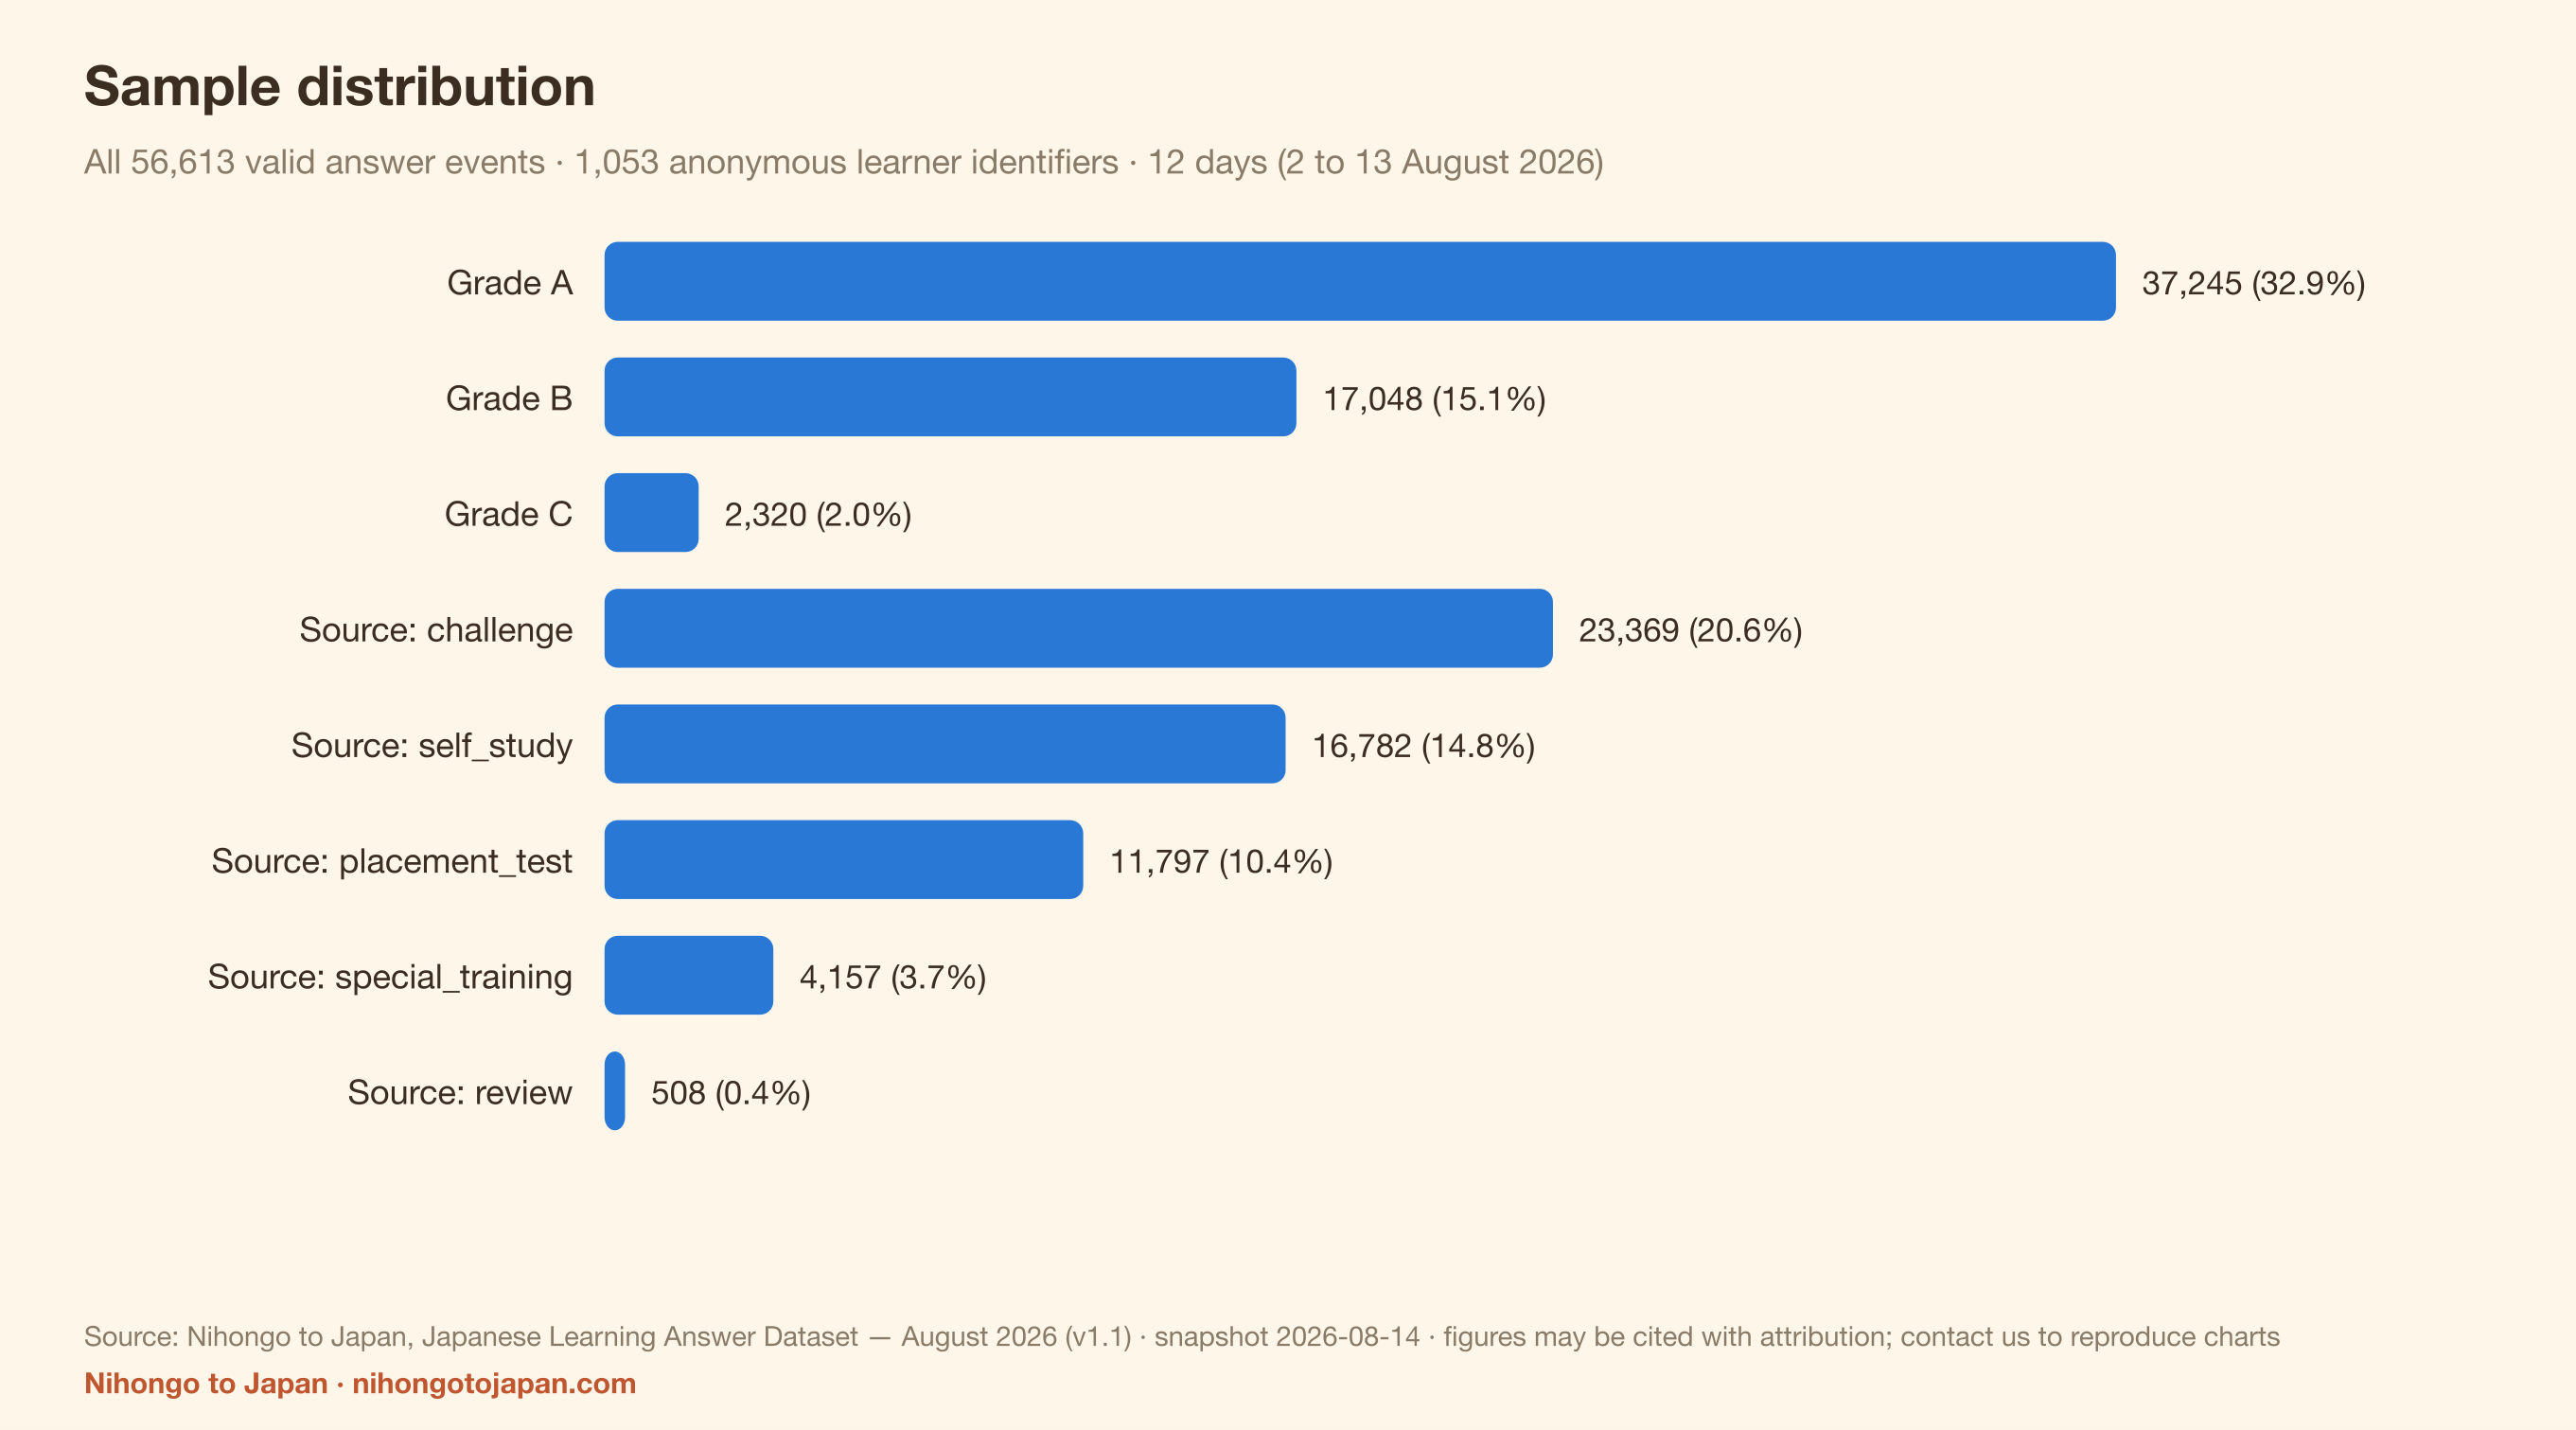
คำตอบแยกตามแหล่งที่มา: challenge 23,369 (41.3%), self_study 16,782 (29.6%), placement_test 11,797 (20.8%), special_training 4,157 (7.3%), review 508 (0.9%)
การกระจายของคอลัมน์ evidence_class ในฐานข้อมูล (เป็นฟิลด์ดิบของตาราง ไม่ใช่ชื่อชุดวิเคราะห์ในรายงานนี้): A 37,245 (65.8%), B 17,048 (30.1%), C 2,320 (4.1%) ชุดวิเคราะห์หลักตรงกับ evidence_class = A ทุกประการ

3. อัตราการตอบถูกแยกตามแกนความสามารถ

| แกนความสามารถ | n | ตัวระบุ | อัตราการตอบถูกดิบ | ช่วงความเชื่อมั่น 95% | สถานะ |
|---|---|---|---|---|---|
| รูปประโยค | 8,678 | 532 | 53.7% | 52.6%–54.7% | OK |
| คำช่วย | 1,986 | 137 | 69.1% | 67.1%–71.1% | OK |
| รูปคำ / การผัน | 2,322 | 386 | 83.2% | 81.7%–84.7% | OK |
| สำนวน | 1,341 | 261 | 86.4% | 84.5%–88.2% | OK |
| คำศัพท์ | 22,869 | 627 | 92.1% | 91.8%–92.5% | OK |
แกนต่อไปนี้มีขนาดต่ำกว่าขนาดเซลล์ขั้นต่ำ (n<30 หรือตัวระบุผู้เรียนน้อยกว่า 5 ตัว) จึงไม่เผยแพร่ตัวเลขอัตราการตอบถูก — เผยแพร่เฉพาะจำนวนเหตุการณ์: แบบผสม / รอบด้าน (n=27, ตัวระบุ 8 ตัว), การอ่านจับใจความ (n=22, ตัวระบุ 4 ตัว)
4. อัตราการตอบถูกแยกตามระดับ JLPT
⚠️ หัวข้อนี้ถูกอ่านผิดได้ง่ายที่สุด แต่ละระดับใช้ชุดโจทย์ที่ต่างกันโดยสิ้นเชิง และไม่มีการปรับเทียบความยากด้วย IRT ตัวเลขด้านล่างคือสัดส่วนที่ตอบถูกของโจทย์ชุดนี้โดยเฉพาะ — ไม่ใช่ตัววัดว่าระดับใดยากกว่ากัน

| ระดับ JLPT | n | ตัวระบุ | อัตราการตอบถูกดิบ | ช่วงความเชื่อมั่น 95% |
|---|---|---|---|---|
| N5 | 19,395 | 380 | 90.2% | 89.8%–90.6% |
| N4 | 6,099 | 313 | 73.4% | 72.3%–74.5% |
| N3 | 5,985 | 432 | 67.8% | 66.6%–69.0% |
| N2 | 2,726 | 212 | 69.4% | 67.6%–71.1% |
| N1 | 3,040 | 139 | 76.0% | 74.4%–77.5% |
ระดับเดียวกันในชุดวิเคราะห์ทั้งสี่ชุด:
| ระดับ | ครั้งแรกในบริบทแบบทดสอบ (หลัก) | ครั้งแรกในบริบทบทเรียน | การตอบครั้งแรก (ทั้งหมด) | เหตุการณ์ทั้งหมด |
|---|---|---|---|---|
| N5 | 90.2% (n=19,395) | 83.7% (n=11,154) | 87.8% (n=30,495) | 88.2% (n=33,286) |
| N4 | 73.4% (n=6,099) | 83.1% (n=2,694) | 76.5% (n=8,758) | 76.6% (n=9,262) |
| N3 | 67.8% (n=5,985) | 82.1% (n=1,507) | 70.8% (n=7,522) | 71.1% (n=7,727) |
| N2 | 69.4% (n=2,726) | 79.2% (n=260) | 70.2% (n=2,985) | 70.5% (n=3,072) |
| N1 | 76.0% (n=3,040) | 86.5% (n=126) | 76.4% (n=3,174) | 76.5% (n=3,266) |
5. จุดความรู้ที่มีอัตราการตอบถูกต่ำที่สุด
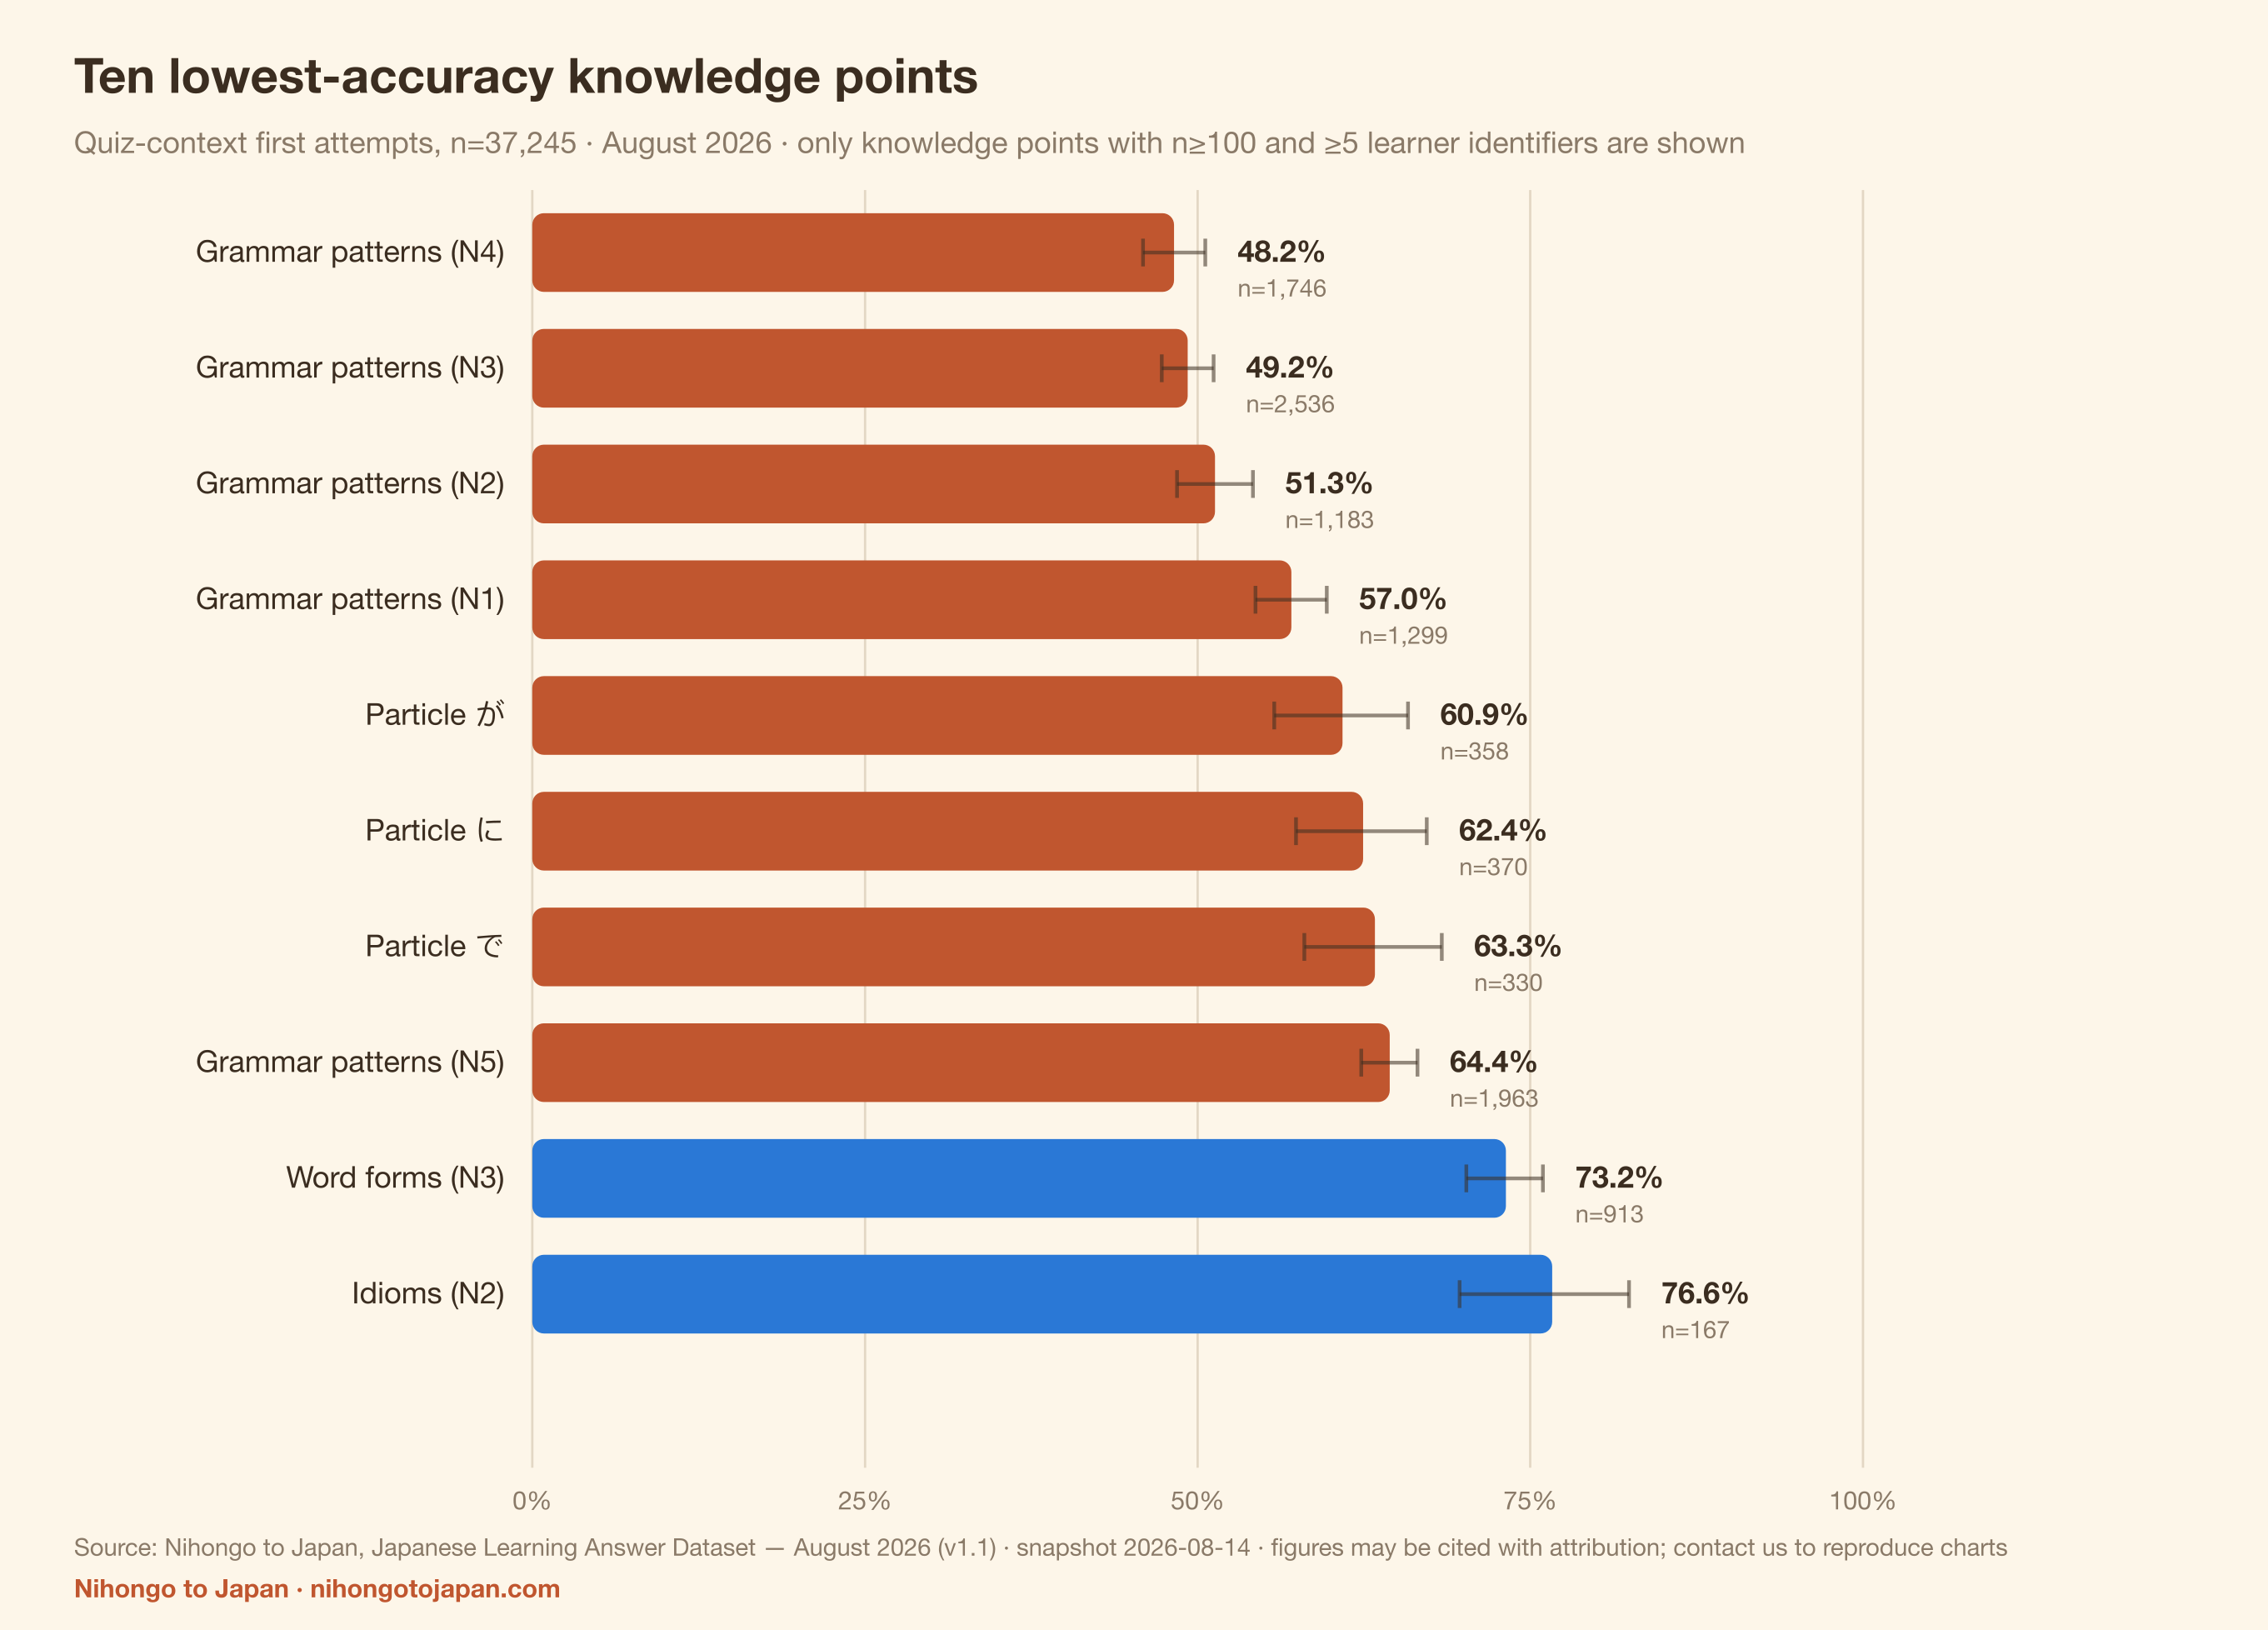
แสดงเฉพาะจุดความรู้ที่มี n≥100 และตัวระบุผู้เรียนอย่างน้อย 5 ตัว (เข้าเกณฑ์ 23 จุด) โดยแสดง n ระดับ และหมวดไว้คู่กับเปอร์เซ็นต์ — เซลล์ขนาดเล็กมักดูสุดโต่งด้วยเหตุผลที่ส่วนใหญ่เป็นเพียงความคลาดเคลื่อนสุ่ม

| # | จุดความรู้ | หมวด | ระดับ | n | ตัวระบุ | อัตราการตอบถูกดิบ | ช่วงความเชื่อมั่น 95% |
|---|---|---|---|---|---|---|---|
| 1 | รูปประโยค (N4) | รูปประโยค | N4 | 1,746 | 234 | 48.2% | 45.9%–50.6% |
| 2 | รูปประโยค (N3) | รูปประโยค | N3 | 2,536 | 390 | 49.2% | 47.3%–51.2% |
| 3 | รูปประโยค (N2) | รูปประโยค | N2 | 1,183 | 191 | 51.3% | 48.5%–54.1% |
| 4 | รูปประโยค (N1) | รูปประโยค | N1 | 1,299 | 118 | 57.0% | 54.3%–59.7% |
| 5 | คำช่วย が | คำช่วย | — | 358 | 81 | 60.9% | 55.8%–65.8% |
| 6 | คำช่วย に | คำช่วย | — | 370 | 75 | 62.4% | 57.4%–67.2% |
| 7 | คำช่วย で | คำช่วย | — | 330 | 85 | 63.3% | 58.0%–68.3% |
| 8 | รูปประโยค (N5) | รูปประโยค | N5 | 1,963 | 209 | 64.4% | 62.3%–66.5% |
| 9 | รูปคำ (N3) | รูปคำ | N3 | 913 | 294 | 73.2% | 70.2%–75.9% |
| 10 | สำนวน (N2) | สำนวน | N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| 11 | คำช่วย を | คำช่วย | — | 385 | 61 | 78.7% | 74.3%–82.5% |
| 12 | รูปคำ (N2) | รูปคำ | N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
6. จุดแข็งที่สม่ำเสมอที่สุด
| # | จุดความรู้ | หมวด | ระดับ | n | ตัวระบุ | อัตราการตอบถูกดิบ | ช่วงความเชื่อมั่น 95% |
|---|---|---|---|---|---|---|---|
| 1 | รูปคำ (N1) | รูปคำ | N1 | 296 | 79 | 95.6% | 92.6%–97.4% |
| 2 | คำศัพท์ (N5) | คำศัพท์ | N5 | 16,029 | 311 | 94.4% | 94.0%–94.8% |
| 3 | คำศัพท์ (N1) | คำศัพท์ | N1 | 703 | 94 | 89.2% | 86.7%–91.3% |
| 4 | คำศัพท์ (N4) | คำศัพท์ | N4 | 2,828 | 243 | 89.0% | 87.8%–90.1% |
| 5 | สำนวน (N1) | สำนวน | N1 | 742 | 111 | 88.8% | 86.3%–90.9% |
| 6 | รูปคำ (N4) | รูปคำ | N4 | 461 | 149 | 87.0% | 83.6%–89.8% |
| 7 | สำนวน (N4) | สำนวน | N4 | 140 | 91 | 86.4% | 79.8%–91.1% |
| 8 | สำนวน (N3) | สำนวน | N3 | 290 | 142 | 85.9% | 81.4%–89.4% |
7. รูปแบบที่สังเกตได้และควรจับตา
ข้อสังเกต A: อัตราการตอบถูกดิบของ N1 สูงกว่า N2 และ N3
N1 76.0% (n=3,040, ตัวระบุ 139 ตัว) สูงกว่า N2 69.4% และ N3 67.8%
นี่คือรูปแบบที่สังเกตได้ ไม่ใช่หลักฐานว่า N1 ง่ายกว่า มีคำอธิบายอย่างน้อยสามข้อที่ข้อมูลนี้ตัดทิ้งไม่ได้: มีตัวระบุเพียง 139 ตัวที่ตอบโจทย์ N1 เทียบกับ 432 ตัวสำหรับ N3 องค์ประกอบของกลุ่มจึงต่างกัน ชุดโจทย์ต่างกัน และไม่มีการประมาณค่าความสามารถ การจะตอบว่า "ระดับใดยากกว่ากันจริง ๆ" ต้องอาศัยการปรับเทียบด้วย IRT และการออกแบบโจทย์ยึดโยง (anchor items) ซึ่งชุดข้อมูลนี้ไม่มีทั้งสองอย่าง
ข้อสังเกต B: แกนรูปประโยคต่ำที่สุดในทุกระดับ
| แกน × ระดับ | n | ตัวระบุ | อัตราการตอบถูกดิบ | ช่วงความเชื่อมั่น 95% |
|---|---|---|---|---|
| รูปประโยค × N4 | 1,734 | 233 | 48.0% | 45.6%–50.3% |
| รูปประโยค × N3 | 2,531 | 389 | 49.2% | 47.2%–51.1% |
| รูปประโยค × N2 | 1,179 | 191 | 51.1% | 48.3%–54.0% |
| รูปประโยค × N1 | 1,295 | 118 | 57.0% | 54.3%–59.7% |
| คำช่วย × N4 | 766 | 92 | 58.5% | 55.0%–61.9% |
| รูปประโยค × N5 | 1,939 | 208 | 64.0% | 61.8%–66.1% |
| รูปคำ / การผัน × N3 | 948 | 302 | 74.2% | 71.3%–76.8% |
| คำช่วย × N5 | 1,220 | 111 | 75.8% | 73.3%–78.1% |
| สำนวน × N2 | 167 | 62 | 76.6% | 69.7%–82.4% |
| รูปคำ / การผัน × N2 | 278 | 107 | 80.2% | 75.1%–84.5% |
เมื่อไขว้แกนกับระดับ เซลล์ที่ต่ำที่สุดแทบทั้งหมดเป็นเซลล์ของรูปประโยค ซึ่งให้ข้อมูลมากกว่าการแยกตามระดับเพียงอย่างเดียว
8. ครูและผู้ออกแบบสื่อการสอนนำข้อมูลนี้ไปใช้อะไรได้บ้าง
หัวข้อนี้ตั้งใจแยกข้อมูลออกจากการตีความ ข้อมูลอ้างอิงได้ ส่วนการตีความเป็นวิจารณญาณของเรา และคุณมีอิสระที่จะไม่เห็นด้วย
| ข้อมูล (อ้างอิงได้) | การตีความ (วิจารณญาณของเรา ไม่ใช่ข้อมูล) |
|---|---|
| การตอบครั้งแรกในบริบทแบบทดสอบ: แกนรูปประโยค 53.7% เทียบกับคำศัพท์ 92.1% (n=8,678 และ 22,869) | บนแพลตฟอร์มนี้มีช่องว่างชัดเจนระหว่างการจำคำศัพท์ได้กับการประกอบประโยค หากต้องจัดสรรเวลาฝึก รูปประโยคอาจให้ผลตอบแทนส่วนเพิ่มสูงกว่า |
| が 60.9%, に 62.4%, で 63.3% ต่ำกว่า を 78.7% และ の 83.3% อย่างชัดเจน | を และ の มีหน้าที่ค่อนข้างแคบ ขณะที่ が, に และ で มีหลายความหมายมาก การสอนหน้าที่ที่ต่างกันของคำช่วยตัวเดียวแยกกันอาจได้ผลดีกว่าการแนะนำคำช่วยทีละตัว |
| อัตราการตอบถูกดิบของ N2 และ N3 (69.4% / 67.8%) ต่ำกว่า N4, N1 และ N5 | ⚠️ อย่าใช้ข้อนี้จัดอันดับความยาก การตีความที่น่าจะเป็นไปได้มากกว่าคือ ผู้เรียนที่ตอบในระดับ N2/N3 มีองค์ประกอบต่างจากผู้เรียนในระดับอื่น มากกว่าจะเป็นเรื่องของตัวโจทย์ |
| รูปประโยค: 85.4% ในบริบทบทเรียน (n=13,937) เทียบกับ 53.7% ในบริบทแบบทดสอบ (n=8,678) ผลต่างแบบจับคู่ +27.5 จุดร้อยละ จากตัวระบุ 75 ตัว | การตอบระหว่างเรียนบทเรียนกับการตอบแบบทดสอบให้ผลต่างกันมาก — ควรคำนึงถึงข้อนี้เมื่อนำคะแนนการฝึกบนแพลตฟอร์มไปใช้ตัดสินผลการเรียนรู้ ⚠️ แต่สองบริบทใช้ชุดโจทย์ที่แทบไม่ซ้ำกันเลย เราจึงบอกไม่ได้ว่าเป็นผลของบริบทหรือเพียงเพราะโจทย์ง่ายกว่า |
9. ระเบียบวิธี
| รายการ | รายละเอียด |
|---|---|
| ประชากร | บันทึกการตอบที่เกิดจากผู้เรียนที่ใช้ Nihongo to Japan |
| การสุ่มตัวอย่าง | กลุ่มตัวอย่างเชิงสังเกตที่เลือกตนเองเข้ามา ไม่ใช่การสุ่มตัวอย่าง และไม่เป็นตัวแทนของประชากร |
| หน่วยการวิเคราะห์ | เหตุการณ์การตอบ (ตัวระบุผู้เรียนหนึ่งตัวตอบโจทย์หนึ่งข้อหนึ่งครั้ง) |
| การนับผู้ใช้ | ตัวระบุผู้เรียน = รหัสนิรนามที่ไม่ซ้ำกัน ไม่สามารถรวมข้ามอุปกรณ์ได้ จึงเป็นค่าขอบบนของจำนวนคน ไม่ใช่จำนวนคนที่ผ่านการยืนยัน |
| ตัวชี้วัด | อัตราการตอบถูกดิบ = จำนวนที่ตอบถูก ÷ เหตุการณ์การตอบที่ใช้ได้ ไม่ใช่การประมาณค่าความสามารถ |
| ช่วงความเชื่อมั่น | ช่วงความเชื่อมั่น Wilson 95% สะท้อนเฉพาะความคลาดเคลื่อนจากการสุ่มตัวอย่าง ไม่ได้แก้อคติจากการเลือกตัวอย่าง |
ชุดวิเคราะห์สี่ชุด
| ชุด | นิยาม | n |
|---|---|---|
| การตอบครั้งแรกในบริบทแบบทดสอบ (ชุดวิเคราะห์หลัก) | คำตอบจาก challenge / placement_test / special_training ที่เป็นการตอบโจทย์ข้อนั้นครั้งแรกของตัวระบุผู้เรียนนั้น ไม่ใช่การตอบซ้ำภายใน 24 ชั่วโมง และมีข้อมูลกำกับโจทย์ครบถ้วน | 37,245 |
| การตอบครั้งแรกในบริบทบทเรียน (ชุดเปรียบเทียบ) | การตอบครั้งแรกจาก self_study / review — คำตอบที่ให้ระหว่างเรียนเนื้อหาบทเรียน | 15,741 |
| การตอบครั้งแรก (ทุกบริบท) | คำตอบแรกของตัวระบุผู้เรียนแต่ละตัวต่อโจทย์แต่ละข้อ ไม่ว่าจะมาจากแหล่งใด | 52,934 |
| เหตุการณ์การตอบทั้งหมด | เหตุการณ์การตอบที่ใช้ได้ทุกรายการ รวมการตอบซ้ำ | 56,613 |
⚠️ ชุดหลักไม่ได้กล่าวอ้างใด ๆ เกี่ยวกับคำใบ้หรือคำอธิบาย ฟิลด์used_hint/viewed_explanation/used_answer_keyมีค่าเป็น false ทั้งฐานข้อมูล แต่นั่นเป็นเพราะไม่เคยมีส่วนใดของระบบเขียนค่าลงฟิลด์เหล่านี้ — ไม่มีจุดเรียกใช้การบันทึกคำตอบจุดใดส่งพารามิเตอร์เหล่านี้ และปัจจุบันผลิตภัณฑ์ไม่มีฟีเจอร์คำใบ้ก่อนตอบหรือการเปิดเฉลย ค่า false ที่คงที่นี้เป็นคุณสมบัติของระบบเก็บข้อมูล ไม่ใช่หลักฐานเกี่ยวกับพฤติกรรมของผู้เรียน จึงไม่ได้ใช้ฟิลด์เหล่านี้เป็นเงื่อนไขในการวิเคราะห์ และไม่มีการกล่าวอ้างใด ๆ เกี่ยวกับการใช้คำใบ้
การตรวจสอบชุดหลักอย่างอิสระ: เมื่อคำนวณเหตุการณ์แรกสุดต่อคู่ (ตัวระบุ, โจทย์) ใหม่บนเซิร์ฟเวอร์ เหตุการณ์ในชุดหลัก 99.59% (37,094 จาก 37,245) ผ่านการทดสอบว่าเป็นการตอบครั้งแรก อีก 151 รายการที่ไม่ผ่านน่าจะเกิดจากการใช้ข้ามอุปกรณ์มากที่สุด — คนคนเดียวตอบบนสองอุปกรณ์ และแต่ละอุปกรณ์บันทึกเป็นการตอบครั้งแรก ทุกเหตุการณ์ในชุดนี้มี attempt_number = 1
สิ่งที่ถูกคัดออก
- โจทย์ที่ทราบว่าข้อมูลบกพร่อง: รหัสโจทย์ 520 รหัสถูกคัดออกจากสถิติรวมทุกตัว ด้วยสาเหตุสองประการ: (1) โจทย์เติมคำที่ไม่ใช่ไวยากรณ์จากเนื้อหาบทเรียน (การแปลงตัวอักษรคานะ การสะกด คำตอบที่เป็นตัวเลข) ถูกติดป้ายผิดเข้าไปในแกนรูปประโยค (2) โจทย์ "ข้อประจำวัน" เวอร์ชันเก่าที่ใช้โทเค็นคำตอบเป็นตัวระบุโจทย์ ทำให้โจทย์ต่างข้อกันถูกรวมอยู่ใต้รหัสเดียว ส่วนหน้าบ้านแก้ไขแล้ว และข้อมูลย้อนหลังถูกคัดออกด้วยรายการปฏิเสธ (denylist) ไม่มีการลบเหตุการณ์ดิบใด ๆ — ตารางเป็นแบบเพิ่มต่อท้ายเท่านั้น (append-only)
- เหตุการณ์หลังเวลาตัดของสแนปช็อต: รายงานนี้ตรึงไว้ ณ 2026-08-14T00:00:00Z ข้อมูลยังสะสมต่อไป แต่ตัวเลขทุกตัวในหน้านี้และในไฟล์ที่ดาวน์โหลดได้มาจากจุดที่ตรึงไว้จุดเดียวนั้น
ขนาดเซลล์ขั้นต่ำ
เซลล์ที่มี n<30 หรือตัวระบุผู้เรียนน้อยกว่า 5 ตัวจะถูกระงับ (SUPPRESSED): เผยแพร่จำนวนเหตุการณ์แต่ไม่เผยแพร่อัตราการตอบถูก เซลล์ที่มี n≥30 และตัวระบุ ≥5 ตัวแต่ n<100 จะติดสถานะ LOW_SAMPLE และควรอ้างอิงพร้อมค่า n เสมอ เซลล์ที่มี n≥100 และตัวระบุ ≥5 ตัวจะติดสถานะ OK
ในสแนปช็อตนี้ มีจุดความรู้สถานะ OK 23 จุด, LOW_SAMPLE 12 จุด และ SUPPRESSED 3 จุด
การทำให้เป็นนิรนาม
- แต่ละเหตุการณ์มีเพียง UUID อุปกรณ์แบบนิรนามที่สร้างขึ้นในเบราว์เซอร์ ไม่มีชื่อ อีเมล ที่อยู่ IP ลายนิ้วมืออุปกรณ์ หรือข้อความที่พิมพ์อิสระใด ๆ ทั้งสิ้น
- Cloudflare Pages Function ที่รับข้อมูลเขียนเฉพาะคอลัมน์ที่อยู่ในรายการอนุญาต และกำหนดไว้ชัดเจนว่าไม่เขียนที่อยู่ IP
- ชุดข้อมูลสาธารณะมีเฉพาะสถิติรวม — ไม่มีเหตุการณ์การตอบดิบแม้แต่รายการเดียว
- ผู้เรียนเลือกไม่เข้าร่วมการเก็บข้อมูลรวมได้ด้วยการคลิกครั้งเดียวที่หน้านโยบายความเป็นส่วนตัว
10. ข้อจำกัด (กรุณาอ้างอิงควบคู่ไปกับตัวเลข)
ถ้าจะอ่านเพียงย่อหน้าเดียว ขอให้อ่านย่อหน้านี้ ข้อมูลนี้บรรยายว่าผู้ที่มาฝึกที่ Nihongo to Japan ทำโจทย์ของ Nihongo to Japan ได้อย่างไร ไม่ใช่ภาพของผู้เรียนภาษาญี่ปุ่นในไต้หวัน ไม่ใช่ตัววัดความยากของ JLPT และไม่สามารถใช้เปรียบเทียบความยากเชิงวัตถุวิสัยระหว่างระดับต่าง ๆ ได้
- อคติจากการเลือกตัวอย่าง: กลุ่มตัวอย่างคือผู้ที่เลือกมาฝึกที่นี่ ซึ่งน่าจะมีแรงจูงใจสูงกว่าผู้เรียนทั่วไป และอาจอายุน้อยกว่าและคุ้นเคยกับเครื่องมือออนไลน์มากกว่า
- การวัดซ้ำ: ตัวระบุที่ตอบมากที่สุดเพียงตัวเดียวคิดเป็น 3.7% ของคำตอบทั้งหมด และสิบอันดับแรกคิดเป็น 19.4% บนตัวระบุ 372 ตัวชุดเดียวกัน การถ่วงน้ำหนักตามเหตุการณ์กับการถ่วงน้ำหนักตามตัวระบุให้ผลต่างกัน 7.04 จุดร้อยละ
- ชุดวิเคราะห์นำมาลบกันโดยตรงไม่ได้: บริบทบทเรียนกับบริบทแบบทดสอบใช้ชุดโจทย์ที่แทบไม่ซ้ำกันเลย (จากโจทย์รูปประโยค 5,772 ข้อ มีเพียง 6 ข้อที่ปรากฏในทั้งสองบริบท) ช่องว่างของอัตราการตอบถูกระหว่างสองบริบทจึงไม่สามารถโยงไปยังสาเหตุเดียวได้
- สังเกตพฤติกรรมการใช้คำใบ้และคำอธิบายไม่ได้: ฟิลด์ที่เกี่ยวข้องไม่เคยถูกเขียนค่า ชุดข้อมูลนี้จึงไม่กล่าวอ้างใด ๆ เลยเกี่ยวกับพฤติกรรมเหล่านี้
- ความยากของโจทย์ไม่เท่ากัน: แต่ละระดับและแต่ละแกนใช้ชุดโจทย์ต่างกัน อัตราการตอบถูกดิบจึงไม่ใช่ตัววัดความยากที่ปรับมาตรฐานแล้ว
- ไม่มีการปรับเทียบด้วย IRT: ไม่มีการปรับเทียบด้วยทฤษฎีการตอบสนองข้อสอบ (IRT) และไม่มีการออกแบบโจทย์ยึดโยงข้ามระดับ ข้อมูลนี้จึงตอบไม่ได้ว่าระดับใดยากกว่ากัน
- ขนาดตัวอย่างไม่เท่ากัน: คำตอบระดับ N5 มีมากกว่าคำตอบระดับ N1 กว่าหกเท่า
- ช่วงเวลาสั้น: เพียง 12 วัน (ระบบรวบรวมข้อมูลเริ่มทำงานวันที่ 2026-08-02) ข้อมูลนี้ไม่สามารถใช้อ่านแนวโน้มระยะยาวได้
- ระบุทราฟฟิกอัตโนมัติไม่ได้: ไม่มีกลไกแยกมนุษย์ออกจากสคริปต์ เวลาในการตอบเป็นค่าว่าง (null) ใน 94% ของเหตุการณ์ แม้แต่ตัวกรองพื้นฐานแบบ "ตอบเร็วเกินกว่าที่เป็นไปได้" ก็ยังใช้ไม่ได้ นี่คือช่องโหว่ด้านคุณภาพข้อมูลที่ทราบอยู่แล้ว
- ไม่เป็นตัวแทนของประชากร: ไม่ได้เป็นตัวแทนของผู้เรียนภาษาญี่ปุ่นทั้งหมดในไต้หวันหรือในประเทศอื่นใด
11. วิธีอ้างอิง
ยินดีให้อ้างอิงในบทความวิชาการ รายงานวิจัย สื่อการสอน และงานข่าว กรุณาระบุแหล่งที่มาพร้อมลิงก์กลับมายังหน้านี้
APA (ฉบับที่ 7)
Nihongo to Japan. (2026). Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/en/research/japanese-learning-data-2026MLA (ฉบับที่ 9)
Nihongo to Japan. Japanese Learning Answer Dataset — August 2026. Version 1.1.0, 2026, https://www.nihongotojapan.com/en/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/en/research/japanese-learning-data-2026}

}
สถานะสัญญาอนุญาต
ข้อมูลเผยแพร่ภายใต้สัญญาอนุญาต CC BY 4.0: ใช้ได้อย่างเสรี รวมถึงเชิงพาณิชย์ เพียงระบุแหล่งที่มา กราฟและเนื้อหารายงานไม่อยู่ในขอบเขตนี้ เงื่อนไขฉบับเต็มอยู่ในหัวข้อสัญญาอนุญาต
ข้อความระบุแหล่งที่มาที่แนะนำ:
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026สัญญาอนุญาต: ข้อมูลเป็น CC BY 4.0
ข้อมูลในชุดข้อมูลนี้เผยแพร่ภายใต้สัญญาอนุญาต Creative Commons Attribution 4.0 International (CC BY 4.0) คุณสามารถทำสำเนา เผยแพร่ซ้ำ ดัดแปลง และต่อยอดได้ รวมถึงเพื่อการค้า โดยต้องให้เครดิตอย่างเหมาะสมและระบุหากมีการเปลี่ยนแปลง
⚠️ สัญญาอนุญาตครอบคลุมเฉพาะข้อมูลเท่านั้น สิ่งที่ CC BY 4.0 ครอบคลุม: ตัวเลขสถิติรวมในหน้านี้และไฟล์ที่ดาวน์โหลดได้สองไฟล์ คือjapanese-learning-2026.jsonและjapanese-learning-2026.csvกราฟที่ Nihongo to Japan จัดทำ (SVG/PNG) และเนื้อหารายงานไม่อยู่ในขอบเขต และยังสงวนลิขสิทธิ์
สิ่งที่ทำได้โดยไม่ต้องขออนุญาตเรา
- อ้างอิงสถิติในบทความวิชาการ รายงานวิจัย สื่อการสอน และงานข่าว รวมถึงสิ่งพิมพ์เชิงพาณิชย์
- วิเคราะห์ตัวเลขสถิติรวมซ้ำและสร้างกราฟของคุณเอง — กราฟที่คุณวาดเป็นของคุณ
- ดัดแปลง รีมิกซ์ แปลงรูปแบบ และเผยแพร่ซ้ำในรูปแบบใดก็ได้ รวมถึงการเผยแพร่ไฟล์ข้อมูลซ้ำทั้งไฟล์หรือรวมเข้าไปในผลิตภัณฑ์ข้อมูลของคุณเอง
- ใช้ข้อมูลในห้องเรียนและในบริบทการศึกษา
การระบุแหล่งที่มา
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026สิ่งที่เราขอ (ไม่ใช่เงื่อนไขของสัญญาอนุญาต)
ข้อต่อไปนี้ไม่ใช่เงื่อนไขของ CC BY และการไม่ทำตามก็ไม่ถือเป็นการละเมิด แต่เราขอไว้ พร้อมแนบเหตุผลของแต่ละข้อ:
- ระบุข้อจำกัดของกลุ่มตัวอย่างไปด้วย (กลุ่มตัวอย่างเชิงสังเกตที่เลือกตนเองเข้ามา เพียง 12 วัน ไม่เป็นตัวแทน) — การยกตัวเลขโดยไม่มีข้อจำกัดเหล่านี้เท่ากับเผยแพร่สถิติที่ชวนให้เข้าใจผิด
- ลิงก์กลับมายังหน้านี้ — เพื่อให้ผู้อ่านของคุณดูระเบียบวิธีและเวอร์ชันได้
- เขียนว่า "ตัวระบุผู้เรียน" ไม่ใช่ "คน" — จำนวนตัวระบุเป็นค่าขอบบนของจำนวนคน ไม่ใช่จำนวนหัวที่นับได้จริง
- ระบุเวอร์ชัน (เช่น v1.1.0, สแนปช็อต 2026-08-14) — เพื่อให้ตัวเลขที่คุณอ้างยังระบุตัวตนได้หลังการอัปเดตในภายหลัง
สิ่งที่สัญญาอนุญาตไม่ครอบคลุม
- กราฟที่เราจัดทำ (
/images/research/*.svgและ*.png): กรุณาติดต่อเราก่อนนำไปทำซ้ำ การวาดกราฟของคุณเองจากข้อมูลไม่ต้องขออนุญาต - เนื้อหาของรายงานและของเว็บไซต์นี้: สงวนลิขสิทธิ์
- ชื่อเว็บไซต์ โลโก้ และเครื่องหมายแบรนด์: สัญญาอนุญาตนี้ไม่ได้ให้สิทธิ์ใช้สิ่งเหล่านี้
⚠️ CC BY เพิกถอนไม่ได้ ผู้ที่ได้รับข้อมูลภายใต้เงื่อนไขเหล่านี้จะยังคงมีสิทธิ์นั้นอยู่ แม้เราจะเปลี่ยนเงื่อนไขในภายหลัง เราระบุไว้ตรงนี้เพราะผู้ที่อ้างอิงข้อมูลมีสิทธิ์ที่จะรู้ว่าการอนุญาตที่ตนได้รับมั่นคงเพียงใด
12. ดาวน์โหลดข้อมูล
มีสองรูปแบบที่เนื้อหาเหมือนกัน ทั้งสองเป็นสถิติรวมเท่านั้น (ไม่มีเหตุการณ์การตอบดิบ):
- japanese-learning-2026.json — เมทาดาทาฉบับเต็ม นิยาม ระเบียบวิธี ข้อจำกัด และเซลล์สถิติรวมทุกเซลล์
- japanese-learning-2026-LICENSE.txt — ประกาศสัญญาอนุญาต (CC BY 4.0 ขอบเขต และข้อความระบุแหล่งที่มา) ไฟล์ CSV ไม่มีที่ให้ใส่ข้อความนี้ จึงแนบไปด้วยเป็นไฟล์แยก
- japanese-learning-2026.csv — หนึ่งแถวต่อหนึ่งเซลล์ คอลัมน์:
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag
เวอร์ชัน 1.1.0 · สแนปช็อต 2026-08-14 · ระเบียบวิธีเวอร์ชัน 1.1 การอัปเดตในอนาคตจะเพิ่มหมายเลขเวอร์ชันและเก็บตัวเลขเดิมไว้ แทนที่จะเขียนทับตัวเลขเดิม
ไฟล์กราฟ: กราฟทั้งสี่ในหน้านี้มีให้ทั้งแบบ PNG (ความละเอียด 2× สำหรับสไลด์และงานจัดหน้าสิ่งพิมพ์) และ SVG (เวกเตอร์ ย่อขยายได้)
- อัตราการตอบถูกดิบแยกตามแกนความสามารถ:PNG・SVG
- อัตราการตอบถูกดิบแยกตามระดับ JLPT:PNG・SVG
- จุดความรู้ที่มีอัตราการตอบถูกต่ำที่สุด:PNG・SVG
- การกระจายของกลุ่มตัวอย่าง:PNG・SVG
กราฟทุกภาพมีชื่อ ค่า n เวอร์ชัน และป้ายแหล่งที่มากำกับในตัว จึงยังบอกขอบเขตของตัวเองได้แม้ถูกนำไปใช้แยกเดี่ยว ข้อความแสดงแทนภาพ (alt text) ของทั้งสี่ภาพรวบรวมไว้ใน alt-text.json ⚠️ กราฟไม่อยู่ในขอบเขตของ CC BY กรุณาติดต่อเราก่อนนำไปทำซ้ำ (ดูติดต่อ) ส่วนตัวข้อมูลเป็น CC BY 4.0 ใช้ได้อย่างเสรีเพียงระบุแหล่งที่มา (ดูสัญญาอนุญาต)
⚠️ สำหรับการอ้างอิง กรุณาใช้ชุดข้อมูลที่ตรึงไว้พร้อมเวอร์ชัน แทนปลายทางสถิติรวมที่รีเฟรชเป็นระยะ
นอกจากนี้ยังมีปลายทางสถิติรวมที่รีเฟรชเป็นระยะอยู่ที่ /api/aggregates ตัวเลขของปลายทางนี้เปลี่ยนไปตามเวลา (ไม่ใช่เวอร์ชันที่ตรึงไว้) และใช้นิยามที่ต่างออกไป: นับจากเหตุการณ์การตอบทั้งหมดแทนการตอบครั้งแรกในบริบทแบบทดสอบ และ totalUsers นับเฉพาะตัวระบุผู้เรียนในชุดหลัก (688) แทนที่จะเป็นทั้งหมด 1,053 ตัวเลขเปลี่ยนทุกวันและไม่เหมาะสำหรับการอ้างอิง
สำหรับนักข่าว
- กลุ่มตัวอย่าง: คำตอบนิรนาม 56,613 รายการจากตัวระบุผู้เรียนนิรนาม 1,053 ตัว (ไม่ใช่จำนวนคนที่ผ่านการยืนยัน) ในช่วง 12 วัน คือ 2–13 สิงหาคม 2026
- ระเบียบวิธีในหนึ่งบรรทัด: อัตราการตอบถูกดิบจากกลุ่มตัวอย่างเชิงสังเกตที่เลือกตนเองเข้ามา ตัวเลขหลักใช้ชุดการตอบครั้งแรกในบริบทแบบทดสอบ (การตอบครั้งแรกในบริบทชาเลนจ์ แบบทดสอบวัดระดับ และการฝึกพิเศษ)
- ข้อจำกัดในหนึ่งบรรทัด: นี่ไม่ใช่การสำรวจที่เป็นตัวแทนของผู้เรียนภาษาญี่ปุ่น และไม่สามารถใช้เปรียบเทียบความยากเชิงวัตถุวิสัยของระดับ JLPT ได้
ตัวเลขสามตัวที่อ้างอิงได้ทันที:
- อัตราการตอบถูกของรูปประโยค 53.7% (n=8,678) เทียบกับคำศัพท์ 92.1% (n=22,869) — ห่างกัน 38 จุด
- คำช่วย が ตอบถูก 60.9% (n=358) ส่วน を ได้ 78.7% (n=385)
- อัตราการตอบถูกของรูปประโยคอยู่ระหว่าง 53.7% ถึง 74.1% ขึ้นอยู่กับว่านับบริบทการตอบใดบ้าง (บริบทบทเรียน 85.4%, บริบทแบบทดสอบ 53.7%) ⚠️ สองบริบทใช้ชุดโจทย์ที่แทบไม่ซ้ำกันเลย จึงชี้ชัดถึงสาเหตุไม่ได้ — แต่ตัวเรื่องนี้เองก็เป็นประเด็นข่าวว่าข้อมูลจากแพลตฟอร์มการเรียนถูกนำไปอ้างอย่างไร
รูปแบบการอ้างอิง · ดาวน์โหลดข้อมูล · ติดต่อ
ฝังข้อมูลนี้ (วางลงในบล็อกหรือสื่อการสอน)
วาง HTML ด้านล่างลงในบทความหรือเอกสารประกอบการสอนของคุณ โค้ดนี้มีขนาดตัวอย่าง เวอร์ชัน สัญญาอนุญาต และข้อความเตือนว่า "ไม่เป็นตัวแทนของประชากร" อยู่แล้ว — ซึ่งเป็นส่วนที่มักหายไปเมื่อสถิติถูกอ้างต่อกันเป็นทอด ๆ ไม่ต้องแจ้งเราล่วงหน้า
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">จากคำตอบนิรนาม 56,613 รายการ อัตราการตอบถูกของรูปประโยคในการตอบครั้งแรกในบริบทแบบทดสอบอยู่ที่ <strong>53.7%</strong> (n=8,678) เทียบกับ <strong>92.1%</strong> สำหรับคำศัพท์ (n=22,869)</p><p style="margin:0;font-size:13px;color:#8a7a68">ที่มา: <a href="https://www.nihongotojapan.com/en/research/japanese-learning-data-2026">Nihongo to Japan, Japanese Learning Answer Dataset — August 2026</a> v1.1.0 · CC BY 4.0 · กลุ่มตัวอย่างเชิงสังเกตที่เลือกตนเองเข้ามา ไม่เป็นตัวแทนของประชากร</p></blockquote>
ทำไมจึงเป็นโค้ดสำหรับวาง ไม่ใช่ iframe? มีเหตุผลสองข้อ: เว็บไซต์นี้ไม่อนุญาตให้ตัวเองถูกฝังในเฟรม (frame-ancestors 'none' ทั้งเว็บไซต์ เป็นการป้องกัน clickjacking ที่เราอยากคงไว้) และเนื้อหาใน iframe ถูกส่งมาจากโดเมนของเรา จึงไม่นับเป็นลิงก์ที่หน้าของคุณให้ไว้ — ส่วนโค้ดที่วางลงไปนับ คุณมีอิสระที่จะจัดวางเองได้เช่นกัน ข้อมูลเป็น CC BY 4.0 ดังนั้นสิ่งที่เราขอมีเพียงการระบุแหล่งที่มา
สำหรับภาพ: กราฟของเราไม่อยู่ในขอบเขตของสัญญาอนุญาต แต่คุณวาดกราฟเองจากCSVได้ และกราฟนั้นเป็นของคุณ หากต้องการใช้กราฟของเราเพื่อการสอนหรือสื่อมวลชน ดูชุดข้อมูลสำหรับสื่อ
ชุดข้อมูลสำหรับสื่อ
ทุกอย่างในหัวข้อนี้คัดลอกไปใช้ได้โดยไม่ต้องขออนุญาตเราก่อน (ยกเว้นกราฟ — ดูด้านล่าง) ข้อเท็จจริงฉบับย่อและตัวเลขสามตัวที่อ้างได้ทันทีอยู่ในสำหรับนักข่าว ส่วนชุดเต็มอยู่ในข้อค้นพบสิบข้อที่อ้างอิงได้
ข้อความแนะนำมาตรฐาน
ฉบับยาว:
Nihongo to Japan เป็นเว็บไซต์เรียนภาษาญี่ปุ่นที่ดำเนินการอย่างอิสระโดยนักพัฒนาเพียงคนเดียว ไม่ต้องสมัครสมาชิก คอร์สเรียนฉบับเต็มฟรีตลอดไป และครอบคลุม JLPT N5 ถึง N1 ผ่านคำอธิบายไวยากรณ์ บทเรียนเรียนด้วยตนเอง และโจทย์ฝึก ชุดข้อมูลนี้มาจากบันทึกการตอบแบบนิรนามที่ผู้เรียนสร้างขึ้นบนเว็บไซต์ รวบรวมจากสแนปช็อตที่ตรึงไว้ และเผยแพร่พร้อมระเบียบวิธีและข้อจำกัดฉบับเต็ม
ฉบับสั้น:
Nihongo to Japan เว็บไซต์เรียนภาษาญี่ปุ่นที่ดำเนินการอย่างอิสระและเปิดคอร์สเรียนฉบับเต็มให้เรียนฟรีตลอดไป เผยแพร่ชุดข้อมูลสถิติรวมจากคำตอบนิรนามของผู้เรียนบนเว็บไซต์
ภาพสำหรับการตีพิมพ์
กราฟที่เราจัดทำไม่อยู่ในขอบเขตของ CC BY 4.0 (สัญญาอนุญาตครอบคลุมเฉพาะข้อมูล — ดูสัญญาอนุญาต) เราไม่อยากให้เรื่องนี้กลายเป็นอุปสรรค จึงมีสองทางเลือก:
- ขอจากเรา: เราจะส่งไฟล์ภาพพร้อมตีพิมพ์ให้ภายใน 24 ชั่วโมง (PNG และ SVG) พร้อมคำบรรยายภาพ ขนาดตัวอย่าง และป้ายเวอร์ชันที่ถูกต้อง นี่คือช่องทางด่วนสำหรับภาพ ซึ่งเร็วกว่าการสอบถามทั่วไป (2–3 วันทำการ)
- หรือไม่ต้องรอ — วาดเอง ตัวข้อมูลเป็น CC BY 4.0 คุณจึงสร้างกราฟเองได้โดยตรงจาก JSON หรือ CSV กราฟที่คุณวาดเป็นของคุณ: ไม่ต้องขออนุญาต และไม่ต้องแจ้งเรา
ข้อควรคำนึงสี่ข้อเพื่อการรายงานอย่างรับผิดชอบ
ข้อเหล่านี้ไม่ใช่เงื่อนไข — มีไว้เพื่อให้คุณไม่ต้องลงคำแก้ไขในภายหลัง:
- ✅ กรุณาเขียนว่า "ในชุดคำตอบนี้" หรือ "ในการตอบโจทย์แบบทดสอบครั้งแรก" ตัวเลขทุกตัวในหน้านี้เป็นค่าที่สังเกตได้ภายในชุดข้อมูลนี้
- ❌ อย่าเปลี่ยนเป็น "ผู้เรียนชาวไต้หวันทำ X" กลุ่มตัวอย่างคือผู้ที่เลือกมาฝึกบนเว็บไซต์นี้ และไม่ได้เป็นตัวแทนของประชากรกลุ่มที่กว้างกว่านั้น
- ❌ อย่าเปรียบเทียบความยากของระดับ JLPT แต่ละระดับใช้ชุดโจทย์ต่างกัน ไม่มีการปรับเทียบด้วย IRT และช่วงความเชื่อมั่นของ N3 กับ N2 ซ้อนทับกัน — ข้อมูลนี้แยกทั้งสองออกจากกันไม่ได้
- ❌ อย่าเขียนในเชิงเหตุและผล ข้อมูลบอกได้ว่า "สังเกตพบควบคู่กัน" แต่บอกไม่ได้ว่า "เพราะ"
หากไม่แน่ใจว่าถ้อยคำใดใช้ได้หรือไม่ ถามเราได้เลย — ง่ายกว่าการลงคำแก้ไขหลังตีพิมพ์มาก
คำพูดที่อ้างอิงได้
คำพูดทั้งสองด้านล่างนำไปใช้ได้โดยตรงโดยไม่ต้องขออนุญาต
"ในการตอบโจทย์แบบทดสอบครั้งแรก คำศัพท์ได้ 92.1% ส่วนรูปประโยคได้ 53.7% ตัวเลขนี้บรรยายเฉพาะคนที่เลือกมาฝึกบนเว็บไซต์ของเรา และใช้เหมารวมกับผู้เรียนทั่วไปไม่ได้ แต่ถ้าคุณกำลังติดอยู่ตรงที่ 'รู้คำศัพท์ แต่ประกอบประโยคไม่ได้' คุณไม่ได้เป็นอยู่คนเดียว"
— ผู้ก่อตั้ง Nihongo to Japan
"จากข้อมูลชุดเดียวกัน แค่เปลี่ยนว่าจะนับคำตอบใดบ้าง อัตราการตอบถูกของรูปประโยคก็ขยับจาก 53.7% ไปเป็น 85.4% เราจึงเผยแพร่นิยามทั้งสี่แบบไว้เคียงกัน เพราะตัวเลขพาดหัวเพียงตัวเดียวไม่เปิดโอกาสให้ผู้อ่านรู้เลยว่ากำลังดูตัวเลขแบบไหนอยู่"
— ผู้ก่อตั้ง Nihongo to Japan
เราไม่มีทีมวิจัยและไม่มีเจ้าหน้าที่ประชาสัมพันธ์ คำพูดข้างต้นเป็นของผู้ที่สร้างชุดข้อมูลนี้ขึ้นจริง หากต้องการคำตอบสำหรับคำถามเฉพาะ กรุณาใช้หัวข้อติดต่อ
สำหรับนักวิจัยและนักการศึกษา
โครงสร้าง: หนึ่งแถวต่อหนึ่งเซลล์สถิติรวม จัดดัชนีตาม dimension (axis / jlpt / knowledge_point / axis_x_jlpt) × analysis_set (quiz_first_attempt / lesson_first_attempt / first_attempt / all_events) แต่ละเซลล์รายงาน n, learners, accuracy, ci95_low/ci95_high แบบ Wilson และ flag ไฟล์ JSON มีข้อมูลเพิ่มเติม ได้แก่ การแยกส่วนตามชุดวิเคราะห์ การเปรียบเทียบแบบจับคู่ และผลของการถ่วงน้ำหนัก
การสุ่มตัวอย่าง: เลือกตนเองเข้ามาและเป็นเชิงสังเกต หน่วยการวิเคราะห์คือเหตุการณ์การตอบ ตัวระบุผู้เรียนเป็น UUID นิรนาม จำนวนตัวระบุจึงเป็นค่าขอบบนของจำนวนคน (คนเดียวกันบนสองอุปกรณ์จะเกิดตัวระบุสองตัว และไม่สามารถเชื่อมโยงตัวระบุเข้าด้วยกันได้)
ช่องว่างด้านระเบียบวิธีที่ทราบอยู่ — เราคิดว่าควรระบุไว้มากกว่าจะซ่อน:
- ไม่มีการปรับเทียบความยากด้วย IRT และไม่มีโจทย์ยึดโยงข้ามระดับ การเปรียบเทียบระหว่างระดับจึงใช้ไม่ได้
- บริบทบทเรียนกับบริบทแบบทดสอบใช้ชุดโจทย์ที่แทบไม่ซ้ำกันเลย (จากโจทย์รูปประโยค 5,772 ข้อ ซ้อนทับกันเพียง 6 ข้อ) จึงแยกผลของบริบทออกจากความยากของโจทย์ไม่ได้
- ฟิลด์คำใบ้ / คำอธิบาย / เฉลย ไม่เคยถูกเขียนค่า พฤติกรรมเหล่านั้นจึงสังเกตไม่ได้ ไม่สามารถใช้เป็นเงื่อนไขในการวิเคราะห์ และการไม่มีค่าก็ตีความว่า "ไม่ได้เกิดขึ้น" ไม่ได้
- เวลาในการตอบเป็นค่าว่าง (null) ใน 94% ของเหตุการณ์ จึงไม่มีการวิเคราะห์การแลกเปลี่ยนระหว่างความเร็วกับความแม่นยำ และไม่มีการกรองคำตอบที่เร็วผิดปกติ
- ไม่มีตัวแปรทางประชากรศาสตร์ (อายุ ภาษาแม่ จำนวนปีที่เรียน ประเทศ) จึงวิเคราะห์แบบจำแนกชั้นไม่ได้ ชุดข้อมูลไม่มีฟิลด์ภาษาแม่และไม่มีฟิลด์ภูมิศาสตร์ รายงานนี้จึงไม่อนุมานใด ๆ เกี่ยวกับภาษาแม่หรือที่ตั้งของผู้เรียน
- ช่วงเวลา 12 วัน จึงไม่มีเส้นโค้งการเรียนรู้และไม่มีการวิเคราะห์การคงอยู่ของความรู้
- ไม่เผยแพร่ข้อมูลระดับผู้เรียน (เฉพาะสถิติรวม) จึงไม่สามารถประมาณโมเดลพหุระดับซ้ำจากภายนอกได้ หากเรื่องนี้สำคัญต่องานวิจัยของคุณ กรุณาติดต่อเรา
ดาวน์โหลด JSON · ดาวน์โหลด CSV · รูปแบบการอ้างอิง · ระเบียบวิธีฉบับเต็ม
ติดต่อด้านสื่อและข้อมูล
ผู้ก่อตั้ง Nihongo to Japan · อีเมล: [email protected]
ยินดีตอบเรื่อง: รายละเอียดระเบียบวิธี การตรวจทานตัวเลขสถิติรวมใด ๆ คำขอทำซ้ำกราฟ ขอบเขตของสิ่งที่ข้อมูลนี้รองรับได้ และชุดข้อมูลนี้ตอบคำถามเฉพาะเรื่องได้หรือไม่ โดยปกติตอบกลับภายใน 2–3 วันทำการ คำขอภาพพร้อมตีพิมพ์จากสื่อมวลชนเป็นช่องทางด่วน ตอบภายใน 24 ชั่วโมง (ดูชุดข้อมูลสำหรับสื่อ)
เว็บไซต์นี้ดำเนินการอย่างอิสระโดยนักพัฒนาเพียงคนเดียว ไม่มีทีมวิจัยและไม่มีเจ้าหน้าที่ประชาสัมพันธ์ — อีเมลข้างต้นส่งตรงถึงผู้ที่สร้างชุดข้อมูลนี้ขึ้นจริง ไม่ใช่โต๊ะประชาสัมพันธ์ เราระบุไว้ตรงนี้เพราะผู้ที่อ้างอิงข้อมูลมีสิทธิ์ที่จะรู้ว่าใครอยู่เบื้องหลัง
เวอร์ชันและบันทึกการเปลี่ยนแปลง
URL นี้ชี้ไปยังสแนปช็อตล่าสุดเสมอ ทุกการเผยแพร่มีหมายเลขเวอร์ชันและวันที่ตรึงข้อมูล ดังนั้นกรุณาระบุเวอร์ชันเมื่ออ้างอิง (เช่น v1.1.0, สแนปช็อต 2026-08-14) — เมื่อมีการอัปเดตตัวเลขในภายหลัง เวอร์ชันที่คุณอ้างจะยังระบุตัวตนได้ ไฟล์ JSON และ CSV ที่ดาวน์โหลดได้มีฟิลด์เวอร์ชันเดียวกัน
| เวอร์ชัน | วันที่ตรึงสแนปช็อต | ช่วงเวลาที่ครอบคลุม | หมายเหตุ |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 ถึง 10-21 (81 วัน) | เวอร์ชันใหม่กว่า อยู่ที่ URL ของตัวเอง (ชุดวิเคราะห์ต่างกัน) |
| v1.1.0 | 2026-08-14 | 2–13 สิงหาคม 2026 (12 วัน) | การเผยแพร่สาธารณะครั้งแรก ชุดวิเคราะห์หลัก: การตอบครั้งแรกในบริบทแบบทดสอบ เผยแพร่ชุดวิเคราะห์ทั้งสี่ชุดไว้เคียงกัน |
คาดว่าการเผยแพร่ครั้งถัดไปจะมีขึ้นหลังจากสะสมข้อมูลเพิ่มอีกประมาณสามเดือน ซึ่งเป็นจุดเร็วที่สุดที่จะเริ่มพูดถึงแนวโน้มใด ๆ ได้ การอัปเดตข้อมูลจะไม่เขียนทับตัวเลขของเวอร์ชันที่เผยแพร่ไปแล้ว: การเผยแพร่ใหม่จะได้หมายเลขเวอร์ชันใหม่และวันที่ตรึงข้อมูลใหม่ และตัวเลขเดิมจะยังระบุได้ตามเวอร์ชัน หากคุณอ้างอิงเวอร์ชันใดไว้แล้วและตัวเลขของเวอร์ชันนั้นเปลี่ยนไป เขียนมาหาเรา แล้วเราจะบอกคุณอย่างละเอียดว่าอะไรต่างไปบ้าง
← กลับไปที่งานวิจัยและข้อมูล | คนไต้หวันเรียนภาษาญี่ปุ่นกันยังไงในปี 2026 | สำหรับครูผู้สอนและห้องสมุด