ชุดข้อมูลคำตอบของผู้เรียนภาษาญี่ปุ่น — ตุลาคม 2026: คำตอบ 543,344 รายการ ความยากที่ปรับตามความสามารถ และระยะห่างของการทบทวน
สรุปในประโยคเดียว: สถิติรวมจากคำตอบนิรนาม 543,344 รายการบน Nihongo to Japan ครอบคลุมช่วง 2 สิงหาคม – 21 ตุลาคม 2026 (81 วัน) และโจทย์ 25,850 ข้อ — มากกว่าปริมาณของฉบับเดือนสิงหาคม (v1.1.0) 9.6 เท่า
⚠️ v2 และ v1 ใช้ชุดการวิเคราะห์ต่างกัน ห้ามนำอัตราการตอบถูกของฉบับหนึ่งไปลบกับอีกฉบับ v1 คำนวณจากฐานข้อมูลโดยตรง โดยใช้ "การตอบครั้งแรกในบริบทแบบทดสอบ" เป็นชุดหลัก ส่วน v2 จงใจใช้เฉพาะเอนด์พอยต์ข้อมูลรวมสาธารณะที่ใครก็เรียกดูได้ (/api/aggregates,/api/community) ตัววัดหลักจึงเป็น "คำตอบทั้งหมด" และ "การตอบครั้งแรกระดับโจทย์ หนึ่งโจทย์หนึ่งเสียง" ข้อดีคือทำซ้ำได้: ค่า sha256 ของไฟล์อินพุตทุกไฟล์บันทึกไว้ในไฟล์ดาวน์โหลด นักวิจัยภายนอกจึงตรวจสอบได้ว่าเราใช้ข้อมูลชุดใดแน่ ดูระเบียบวิธี
ชุดข้อมูลนี้ไม่ใช่อะไร ชุดข้อมูลนี้ไม่ใช่การสำรวจที่เป็นตัวแทนของผู้เรียนภาษาญี่ปุ่น กลุ่มตัวอย่างคือผู้ที่เลือกมาฝึกบนเว็บไซต์นี้เอง — เป็นกลุ่มตัวอย่างเชิงสังเกตที่คัดเลือกตัวเอง ตัวเลขทุกตัวบรรยายเฉพาะสิ่งที่เกิดขึ้นในบันทึกคำตอบของ NTJ เท่านั้น ไม่มีตัวเลขใดสรุปอ้างอิงไปยังประชากรได้ และไม่มีตัวเลขใดเป็นข้อกล่าวอ้างเชิงเหตุและผล ดูข้อจำกัด
ข้อค้นพบสิบข้อที่อ้างอิงได้
แต่ละข้ออ่านจบได้ในตัว: ระบุชื่อชุดข้อมูล ช่วงเวลา จำนวนตัวอย่าง และชุดการวิเคราะห์ไว้ครบ จึงยกไปอ้างอิงแยกได้ โปรดอ้างอิงข้อจำกัดควบคู่ไปด้วย
- ชุดข้อมูลคำตอบของผู้เรียนภาษาญี่ปุ่นของ NTJ (ตุลาคม 2026, v2.0.0) มีคำตอบนิรนาม 543,344 รายการ จากโจทย์ 25,850 ข้อ ที่บันทึกระหว่างวันที่ 2 สิงหาคมถึง 21 ตุลาคม 2026 — มากกว่า 56,613 รายการในฉบับเดือนสิงหาคม 2026 ของเว็บไซต์ 9.6 เท่า
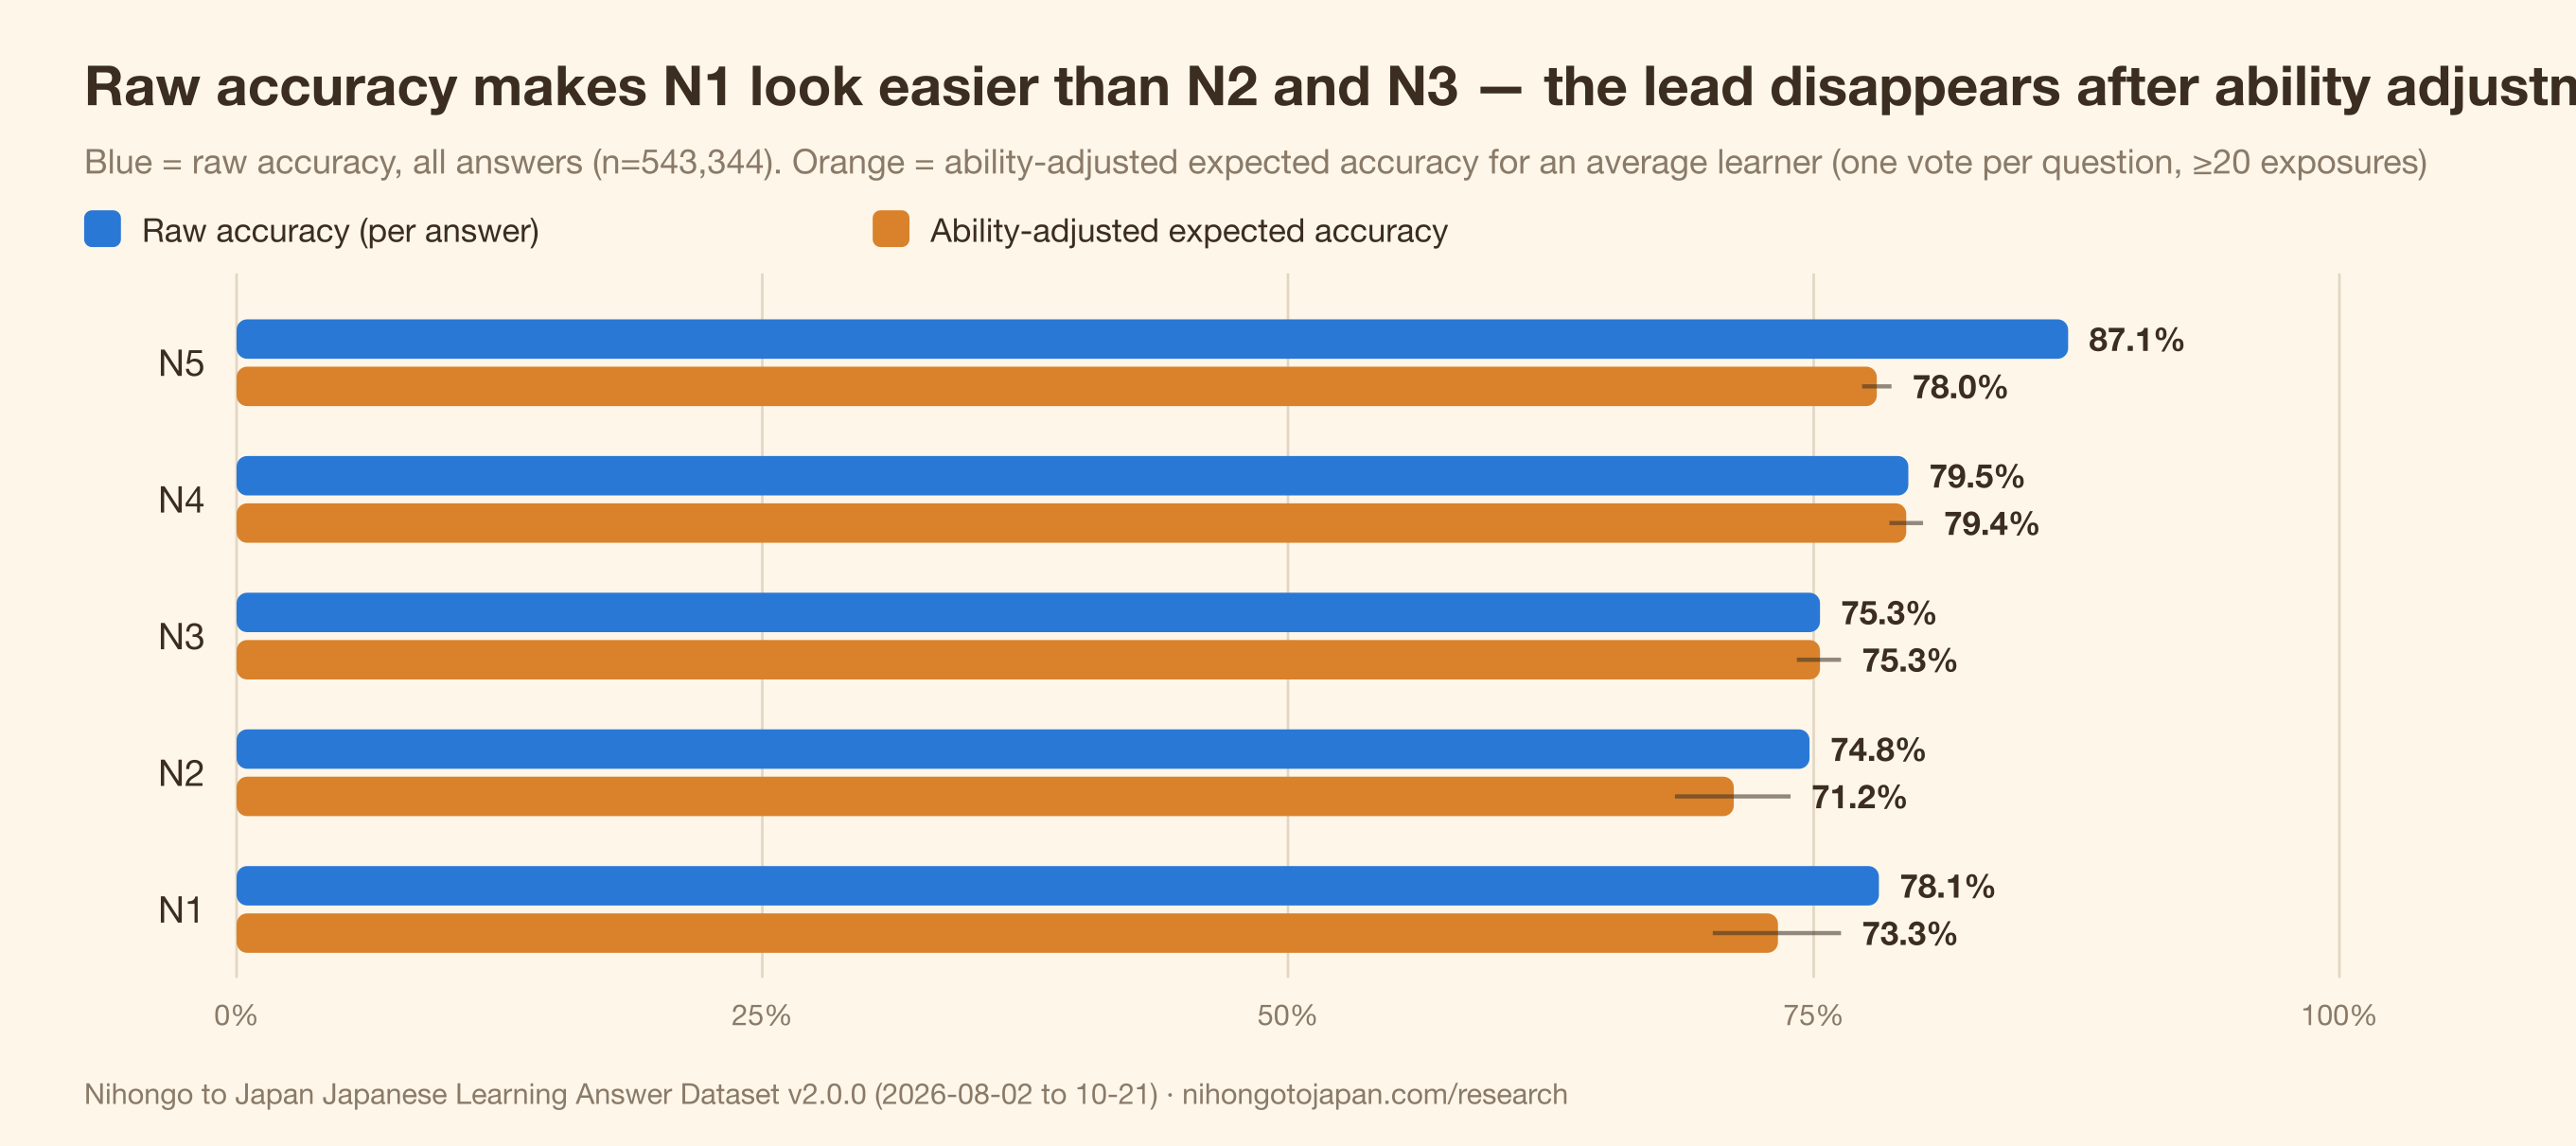
- เมื่อนับคำตอบทั้งหมดในชุดข้อมูลเดียวกัน อัตราการตอบถูกดิบตามระดับ JLPT คือ N5 87.1%, N4 79.5%, N3 75.3%, N2 74.8% และ N1 78.1% (n=33,082) — N1 ได้คะแนนสูงกว่าทั้ง N2 และ N3
- หลังตัดผลของความสามารถผู้เรียนออกด้วยการประมาณค่า Rasch แบบขั้นตอนเดียว (หนึ่งโจทย์หนึ่งเสียง, มีผู้ทำ ≥20 ครั้ง) อัตราการตอบถูกที่คาดหมายสำหรับผู้เรียนที่มีความสามารถเฉลี่ยคือ N3 75.3% (CI 95% 74.2–76.3%, โจทย์ 847 ข้อ), N1 73.3% (70.2–76.3%, โจทย์ 210 ข้อ) และ N2 71.2% (68.4–73.9%, โจทย์ 204 ข้อ) ความได้เปรียบของ N1 เหนือ N3 หายไป ซึ่งสอดคล้องกับผลจากการคัดเลือก กล่าวคือผู้ที่เลือกทำโจทย์ N1 คือผู้เรียนที่เก่งกว่าอยู่แล้ว
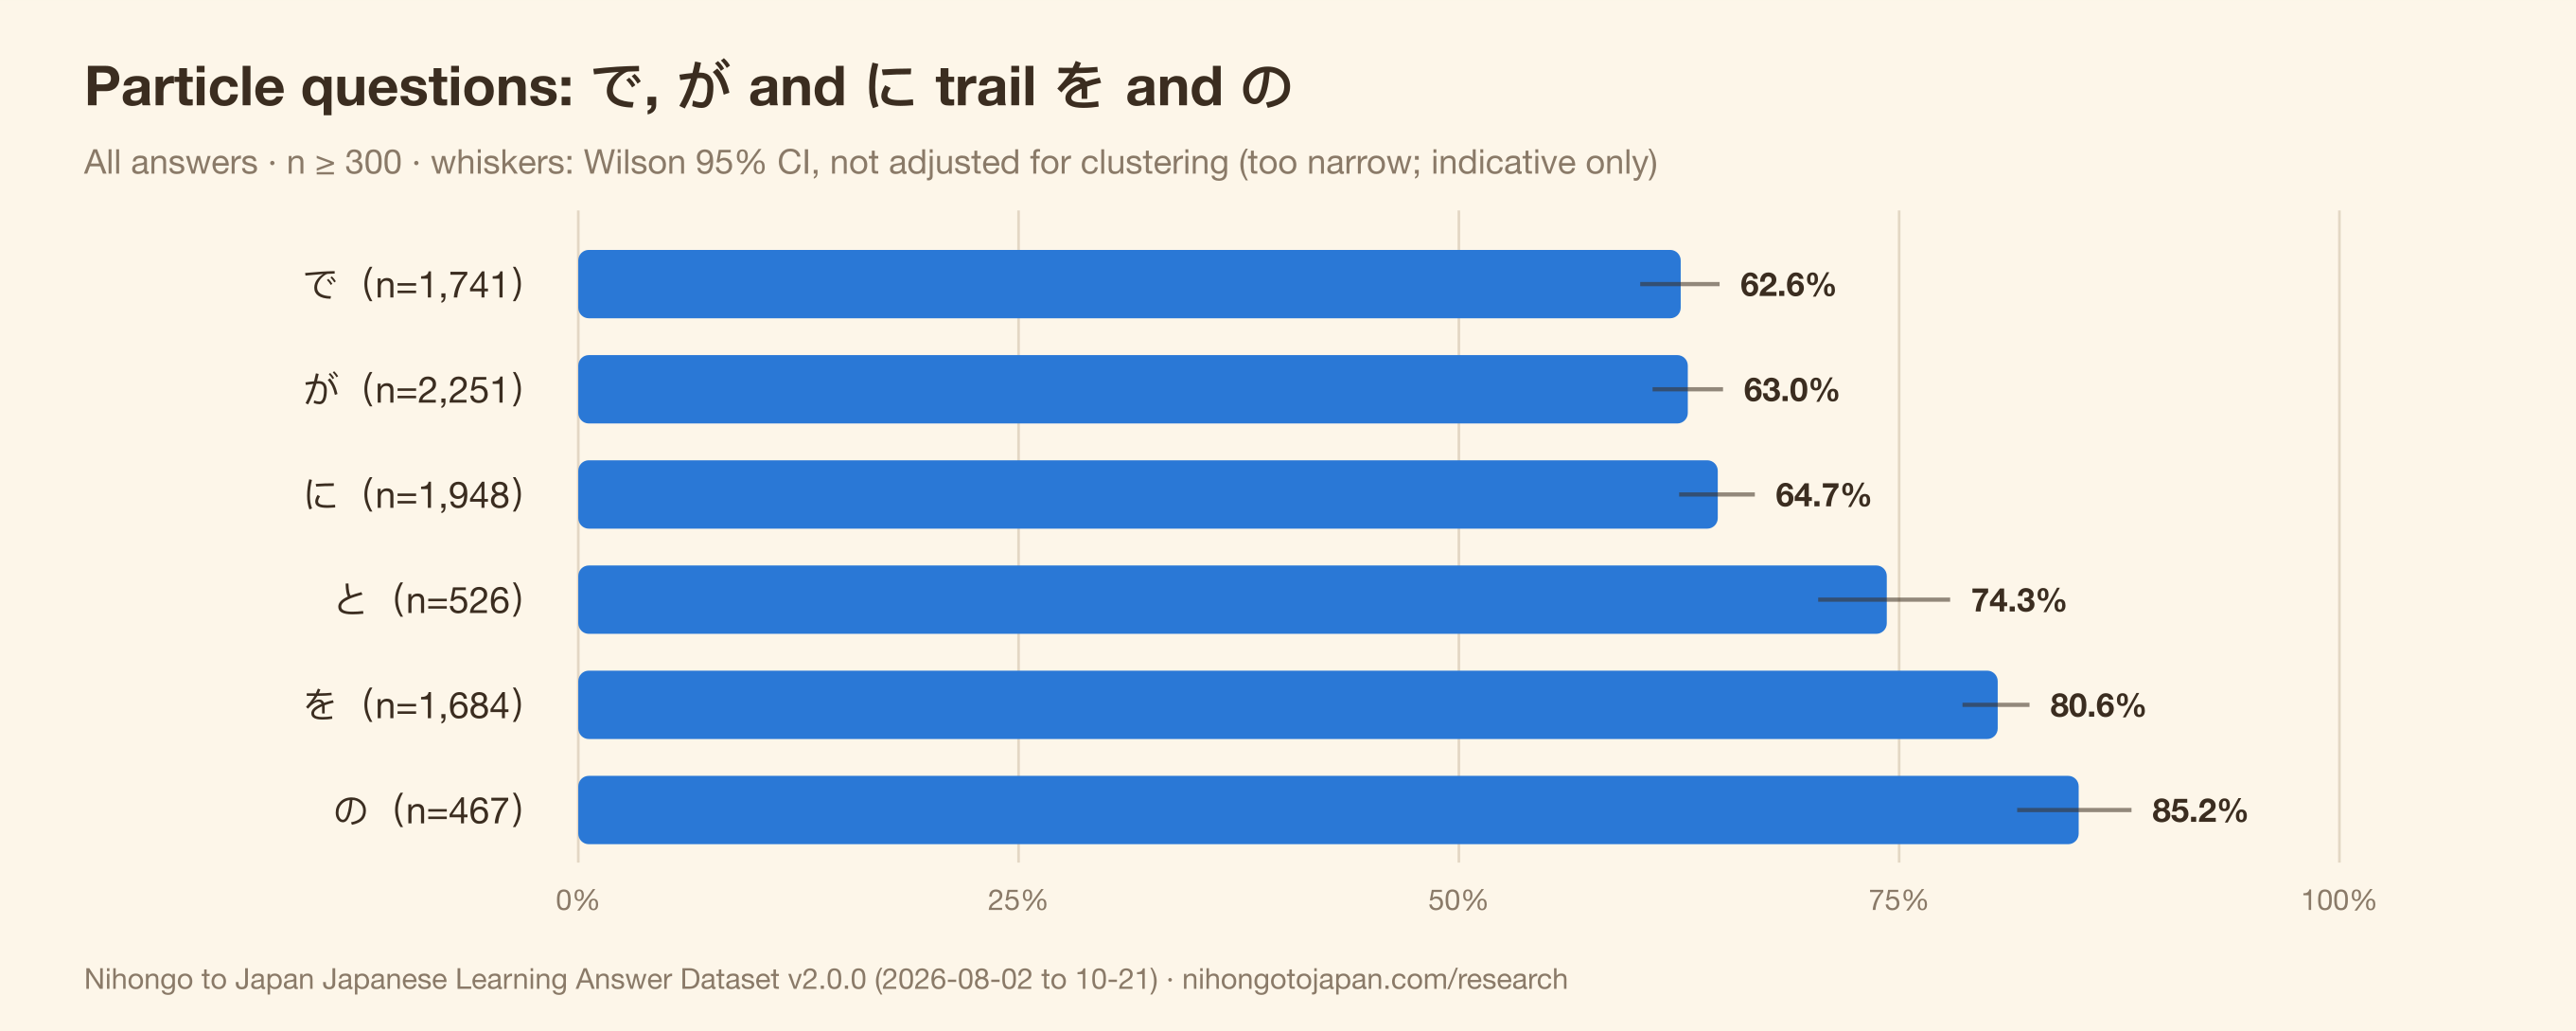
ช่วงของ N1 และ N3 หลังปรับยังซ้อนทับกันอยู่ จึงไม่ได้แสดงว่า N1 ยากกว่า N3 — แสดงเพียงว่าลำดับจากค่าดิบเชื่อถือไม่ได้ - เมื่อนับคำตอบทั้งหมด คำช่วยที่มีอัตราการตอบถูกต่ำที่สุดคือ で 62.6% (n=1,741), が 63.0% (n=2,251) และ に 64.7% (n=1,948) ส่วนที่สูงที่สุดคือ を 80.6% (n=1,684) และ の 85.2% (n=467) — で กับ の ต่างกัน 22.6 จุด
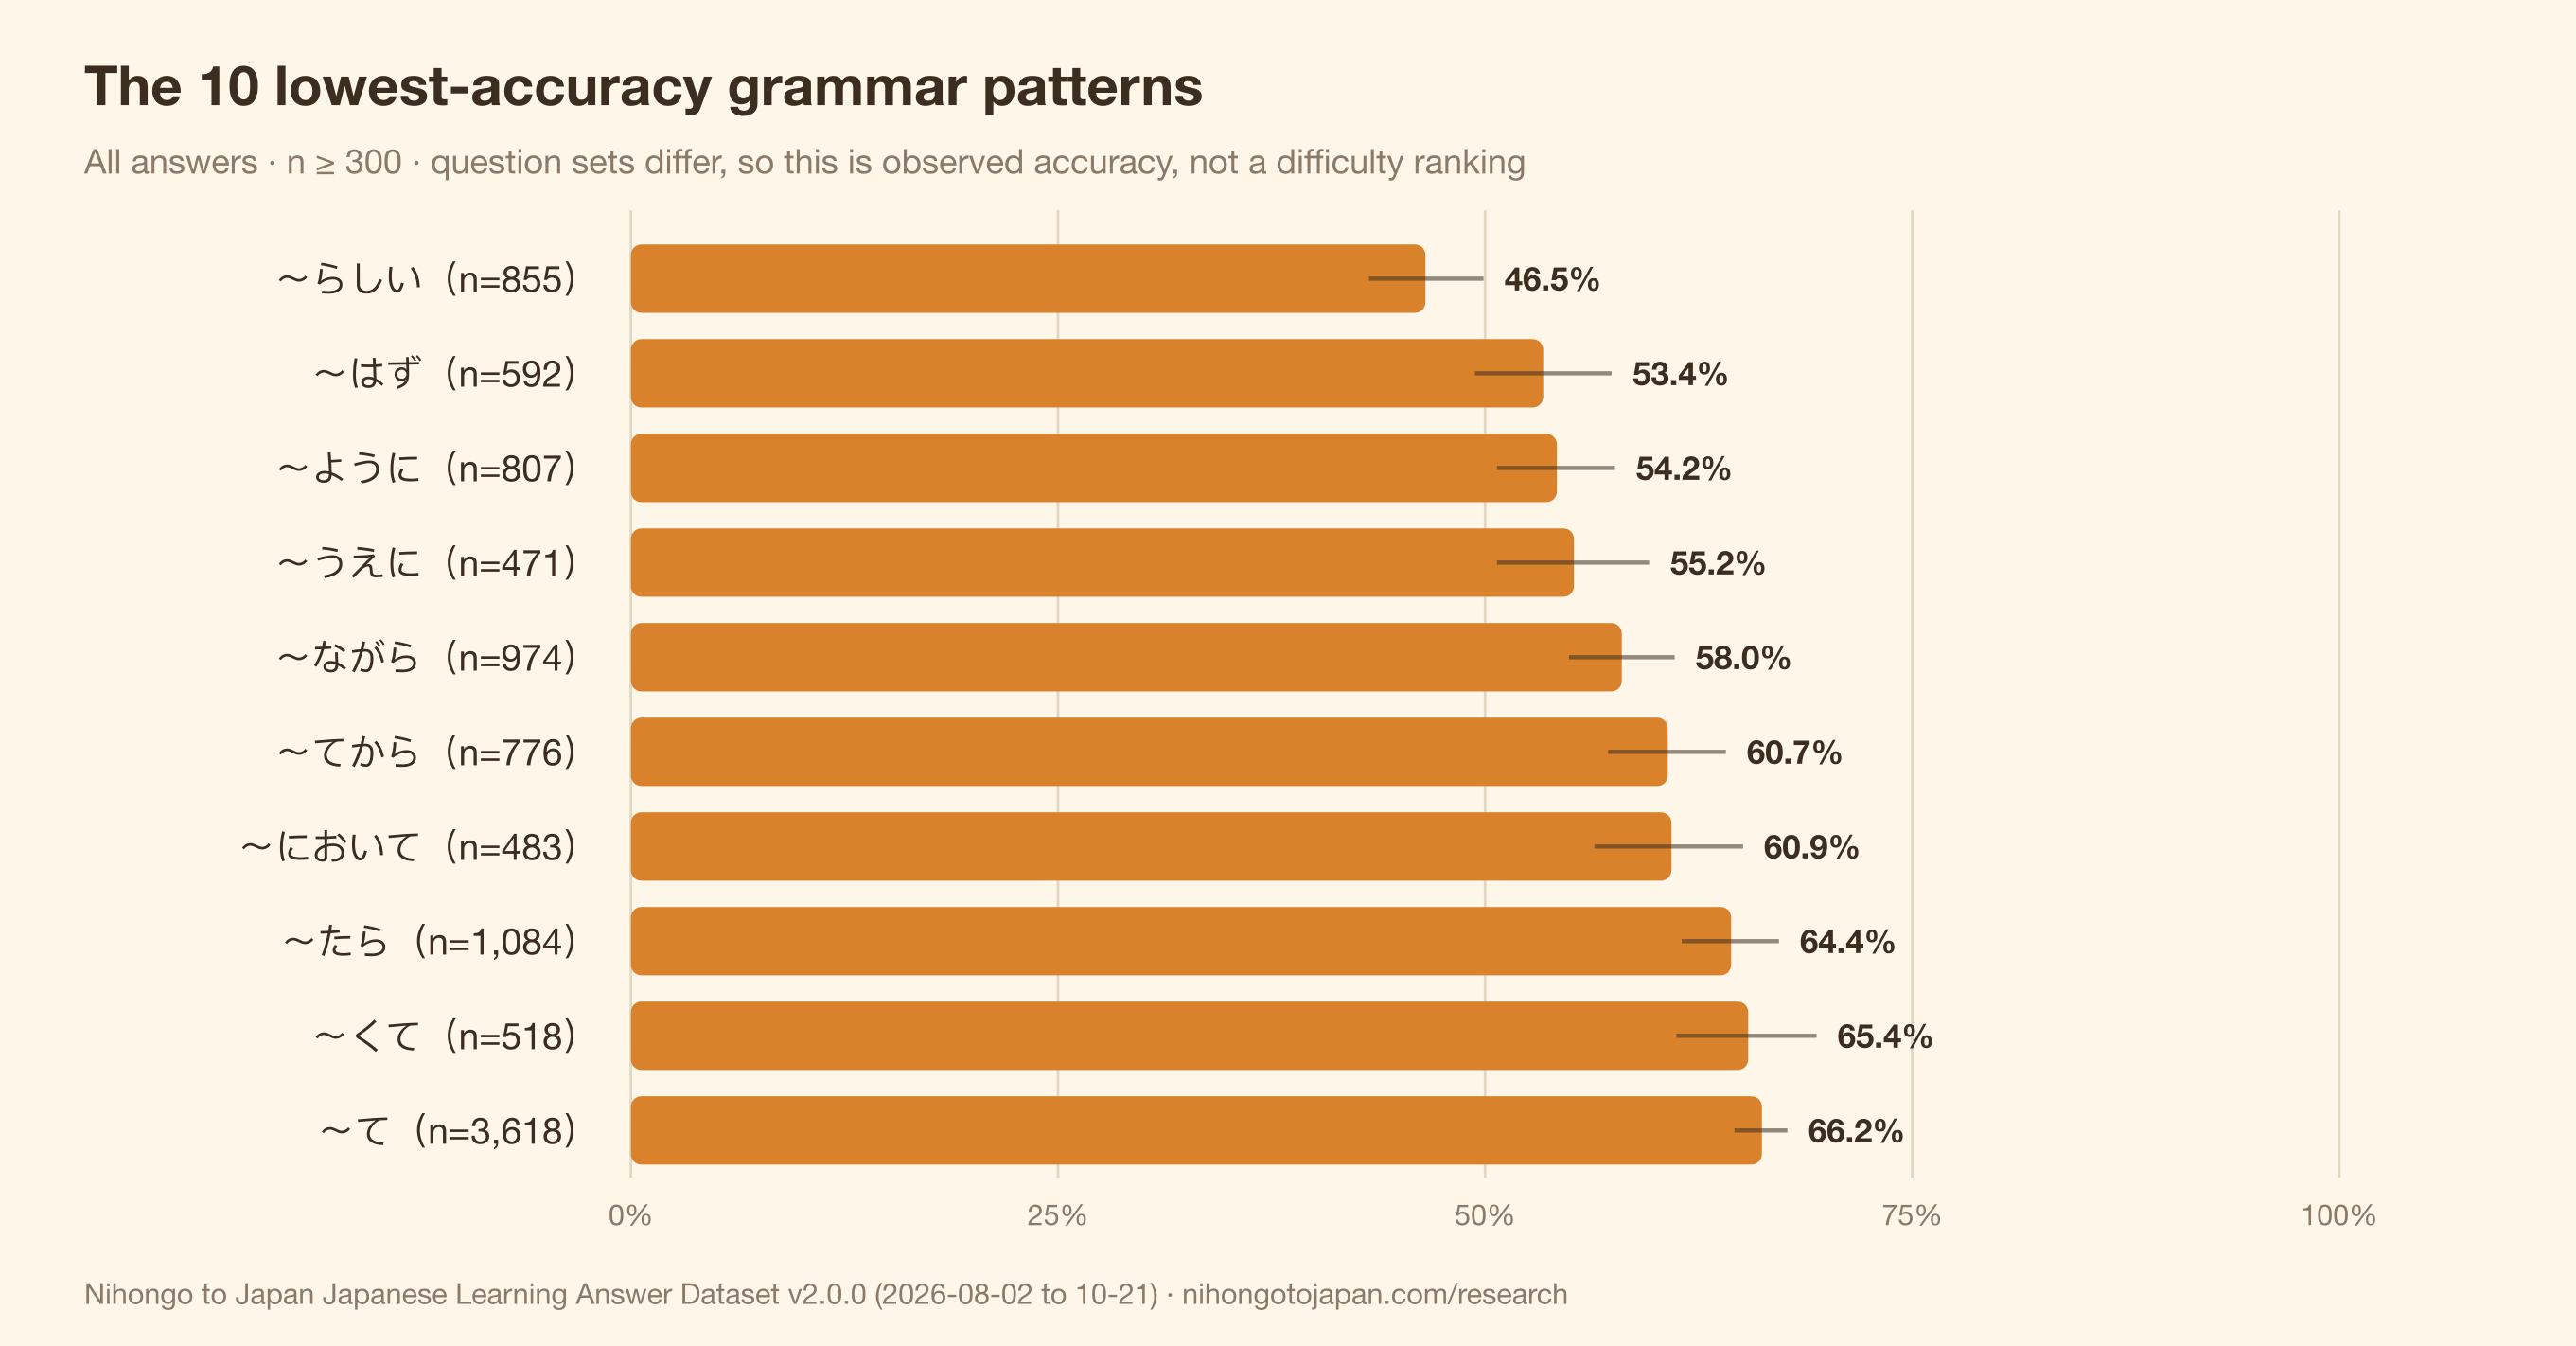
- ในบรรดารูปประโยคที่มี n ≥ 300 อัตราการตอบถูกจากคำตอบทั้งหมดที่ต่ำที่สุดคือ 〜らしい 46.5% (n=855) ตามด้วย 〜はず 53.4% (n=592), 〜ように 54.2% (n=807), 〜うえに 55.2% (n=471) และ 〜ながら 58.0% (n=974)
- ในโจทย์รูปคำกริยา รูปสามารถได้คะแนนต่ำที่สุดที่ 64.5% (n=1,923) และรูป ます สูงที่สุดที่ 84.0% (n=2,270) โดยมีรูป た 70.7% รูป て 74.1% และรูป ない 75.0% อยู่ระหว่างกลาง
- เมื่อนับหนึ่งโจทย์หนึ่งเสียง (โจทย์ 7,057 ข้อที่มีผู้ทำ ≥20 ครั้ง) อัตราการตอบถูกเฉลี่ยในการตอบครั้งแรกคือ 89.1% สำหรับคำศัพท์ (CI 95% 88.7–89.5%), 73.9% สำหรับรูปประโยค (73.1–74.7%) และ 67.6% สำหรับคำช่วย (64.9–70.4%)
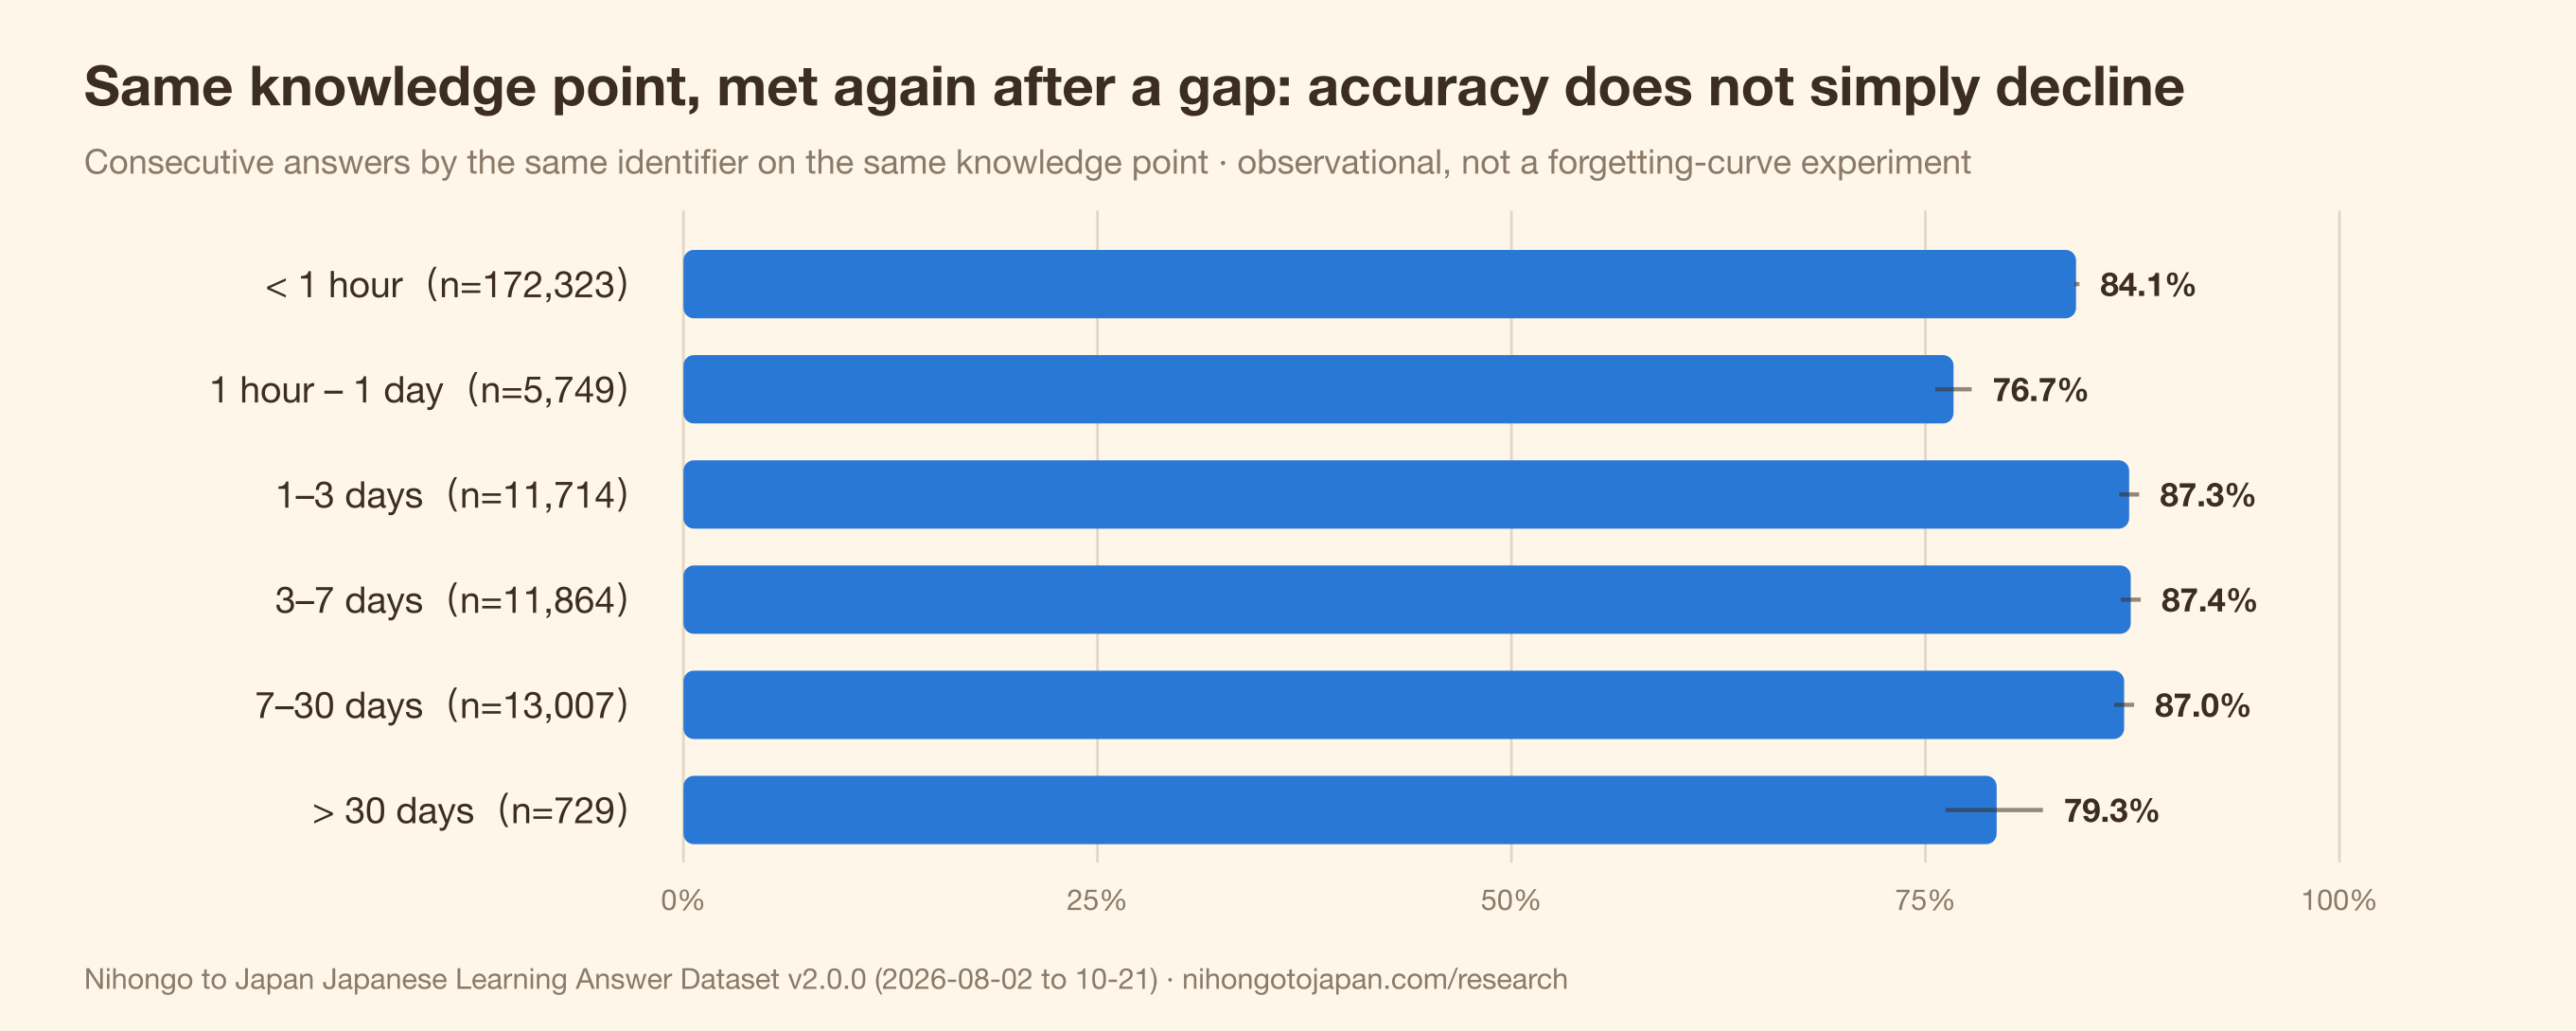
- สำหรับคำตอบต่อเนื่องของตัวระบุเดียวกันในจุดความรู้เดียวกัน อัตราการตอบถูกคือ 84.1% เมื่อเว้นช่วงไม่ถึงหนึ่งชั่วโมง 76.7% เมื่อเว้น 1 ชั่วโมง – 1 วัน 87.0–87.4% เมื่อเว้น 1–3, 3–7 และ 7–30 วัน และ 79.3% เมื่อเว้นเกิน 30 วัน (n=729) อัตราการตอบถูกไม่ได้ลดลงตามระยะห่างอย่างสม่ำเสมอ
นี่เป็นข้อมูลเชิงสังเกต: ผู้ที่กลับมาหลังผ่านไปไม่กี่วันไม่ได้เกิดขึ้นแบบสุ่ม ข้อมูลนี้ไม่ได้แสดงว่าการทบทวนหลังผ่านไปไม่กี่วันได้ผลดีที่สุด - จากโจทย์ 7,057 ข้อที่มีผู้ทำ ≥20 ครั้ง มี 283 ข้อ (4.0%) ที่อัตราการตอบถูกในการตอบครั้งแรกต่ำกว่า 35% (การเดาสุ่มจากสี่ตัวเลือกได้ประมาณ 25%) สาเหตุที่พบบ่อยคือมีตัวเลือกที่สองที่ถือว่าถูกได้เช่นกัน โจทย์เหล่านี้อยู่ในคิวตรวจสอบด้วยคน
- โมเดลทำนายคำตอบ v2 ของเว็บไซต์ได้ Brier score 0.199 จากคำตอบ 257,010 รายการ ต่ำกว่า 0.409 ของ v1 อยู่ 51.4% — แต่ยังแย่กว่าค่า 0.161 ของเส้นฐานคงที่ที่ทำนายอัตราการตอบถูกโดยรวม 79.9% เสมอ มีเพียงเวอร์ชันที่เพิ่มความยากระดับโจทย์ (0.130) เท่านั้นที่เอาชนะเส้นฐานได้
1. ข้อค้นพบหลักห้าข้อ
1. "N1 ง่ายกว่า N3" เป็นภาพลวงที่เกิดจากการคัดเลือก
หากดูอัตราการตอบถูกดิบจากคำตอบทั้งหมด N1 (78.1%) ชนะ N3 (75.3%) และ N2 (74.8%) ซึ่งไม่ค่อยสมเหตุสมผล และ v1 ก็พบสิ่งเดียวกัน คำอธิบายที่เป็นไปได้มากที่สุดคือใครเป็นผู้ตอบ: คนที่กดเข้าไปทำโจทย์ N1 คือคนที่เก่งกว่าอยู่แล้ว
v2 คำนวณใหม่ด้วยความยากที่ปรับตามความสามารถ: ผลที่สังเกตได้ของแต่ละโจทย์จะถูกปรับตามความสามารถเฉลี่ยของผู้ที่ตอบโจทย์นั้นจริง แล้วแสดงเป็นความน่าจะเป็นที่ผู้เรียนที่มีความสามารถเฉลี่ยจะตอบถูก หลังปรับแล้ว ความได้เปรียบของ N1 หายไป (N3 75.3%, N1 73.3%, N2 71.2%)
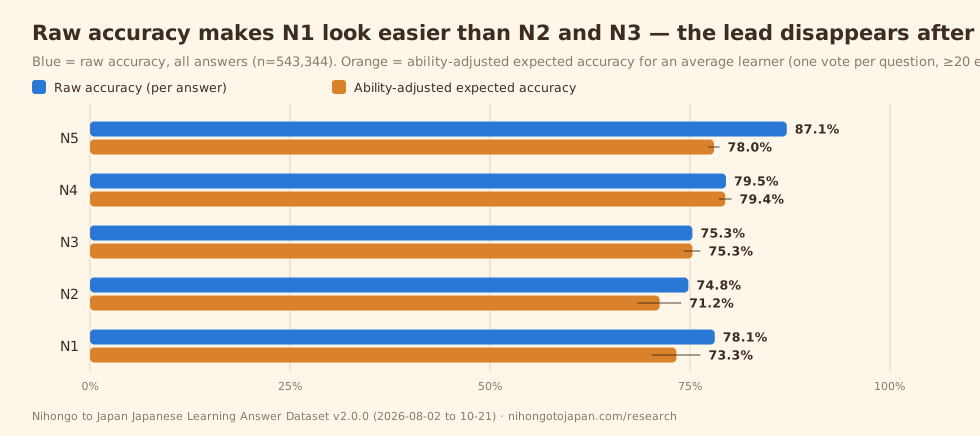
มีข้อควรระวังสองข้อ ข้อแรก ช่วงของ N1 และ N3 หลังปรับยังซ้อนทับกัน เราจึงไม่สามารถกล่าวได้ว่า N1 ยากกว่า N3 ข้อสอง N5 หลังปรับ (78.0%) ไม่ได้สูงกว่า N4 (79.4%): การปรับนี้จัดการเรื่องใครเป็นผู้ตอบ แต่ไม่ได้จัดการเรื่องว่าแต่ละระดับมีโจทย์ประเภทใด — โจทย์ N5 ในการวิเคราะห์ 53% เป็นรูปประโยค เทียบกับ 33% ใน N4 และโจทย์รูปประโยคตอบถูกได้ยากกว่าโจทย์คำศัพท์
2. ช่องว่างของคำช่วย: で が และ に ตามหลัง を และ の ราว 20 จุด
で (62.6%), が (63.0%) และ に (64.7%) ต่ำกว่า を (80.6%) และ の (85.2%) เกือบ 20 จุด สิ่งที่สามตัวล่างมีร่วมกันคือคำช่วยตัวเดียว แต่มีหลายหน้าที่: で บอกสถานที่ วิธีการ สาเหตุ และขอบเขต; に บอกเวลา จุดหมาย ผู้รับ และจุดประสงค์
ผลนี้สอดคล้องกับ v1 ("ช่องว่างภายในกลุ่มคำช่วยกว้างกว่าช่องว่างระหว่างระดับ") และกลุ่มตัวอย่างที่ใหญ่ขึ้นของ v2 ทำให้ทิศทางนี้มั่นคงยิ่งขึ้น
3. รูปประโยคที่ยากที่สุดกระจุกตัวอยู่ที่การคาดคะเนและจุดประสงค์/สภาพ
ในห้ารูปประโยคที่ต่ำที่สุด 〜らしい (46.5%) และ 〜はず (53.4%) ต่างแสดงการคาดคะเนหรือการคาดหมาย และสับสนได้ง่ายกับ 〜そう 〜よう และ 〜みたい; 〜ように (54.2%) ครอบคลุมทั้งจุดประสงค์ การเปลี่ยนแปลง และการขอร้อง; 〜ながら (58.0%) มักถูกใช้ปนกับ 〜て และ 〜まま
รูปคำกริยาก็มีโครงสร้างคล้ายกัน: รูปสามารถ (64.5%) ต่ำที่สุดในห้ารูป กฎการผันต่างกันสำหรับกริยากลุ่ม ichidan, godan และกริยาผิดปกติ และผู้เรียนยังได้พบรูปภาษาพูดที่ตัด ら ออกด้วย
4. อัตราการตอบถูกหลังเว้นช่วงไม่ได้ลดลงแบบตรงไปตรงมา
จับคู่คำตอบต่อเนื่องของตัวระบุเดียวกันในจุดความรู้เดียวกัน แล้วจัดกลุ่มตามระยะห่าง:
| ระยะห่าง | คำตอบ | ตัวระบุ | อัตราการตอบถูก |
|---|---|---|---|
| < 1 ชั่วโมง | 172,323 | 3,472 | 84.1% |
| 1 ชั่วโมง – 1 วัน | 5,749 | 647 | 76.7% |
| 1–3 วัน | 11,714 | 532 | 87.3% |
| 3–7 วัน | 11,864 | 449 | 87.4% |
| 7–30 วัน | 13,007 | 405 | 87.0% |
| > 30 วัน | 729 | 126 | 79.3% |
เส้นโค้งการลืมในตำราบอกว่ายิ่งเว้นนานก็ยิ่งลืมมาก แต่ในที่นี้ช่วง 1 ชั่วโมง – 1 วันต่ำที่สุด และช่วง 1–30 วันสูงที่สุด เราไม่ตีความว่า "ทบทวนหลังผ่านไปไม่กี่วันได้ผลดีที่สุด": ผู้ที่กลับมาหลังผ่านไปไม่กี่วันไม่ได้เกิดขึ้นแบบสุ่ม — ผู้เรียนที่กลับมามีความตั้งใจมากกว่าและอาจเก่งกว่า กลุ่ม 1 ชั่วโมง – 1 วันมีตัวระบุเพียง 647 ตัว และอาจรวมถึงคนที่ทำชุดโจทย์เดิมซ้ำบนอุปกรณ์เครื่องที่สองในวันเดียวกัน การจะตอบคำถามเรื่องระยะห่างของการทบทวนต้องอาศัยการทดลองแบบสุ่ม ซึ่งชุดข้อมูลนี้ให้ไม่ได้
5. โมเดลทำนายลดความคลาดเคลื่อนลงครึ่งหนึ่ง แต่ยังเอาชนะเส้นฐานที่ง่ายที่สุดไม่ได้
ระบบแนะนำโจทย์ของเว็บไซต์จะทำนายความน่าจะเป็นที่คุณจะตอบถูกก่อน เราประเมินด้วย Brier score (ค่าเฉลี่ยของผลต่างกำลังสองระหว่างความน่าจะเป็นที่ทำนายกับผลจริง ยิ่งต่ำยิ่งดี):
- โมเดล v1: 0.409
- โมเดล v2: 0.199 (ต่ำลง 51.4%)
- v2 ที่เพิ่มความยากระดับโจทย์: 0.130 (ต่ำลง 68.1%)
- ค่าอ้างอิง: เส้นฐานคงที่ที่ทำนาย 79.9% โดยรวมเสมอ: 0.161
v2 ลดความคลาดเคลื่อนของ v1 ลงครึ่งหนึ่ง แต่โดยรวมยังแพ้เส้นฐานคงที่ มีเพียงการเพิ่มความยากระดับโจทย์เท่านั้นที่เอาชนะได้ เราเผยแพร่ผลนี้เพราะแสดงให้เห็นโดยตรงว่าความยากของโจทย์ทำนายการตอบถูกได้ดีกว่าระดับของผู้เรียน — ซึ่งเป็นเหตุผลเดียวกับที่ข้อค้นพบข้อ 1 ต้องใช้การปรับตามความสามารถ
2. ภาพรวมชุดข้อมูล
| รายการ | ค่า | หมายเหตุ |
|---|---|---|
| คำตอบที่ใช้ได้ | 543,344 | สแนปช็อตข้อมูลรวม 2026-10-21 19:18 UTC ขอบเขต all_clean_events (ใช้กฎการทำความสะอาดข้อมูลของเว็บไซต์แล้ว) |
| ตัวระบุผู้เรียน (มีคำตอบระดับ A ≥1 รายการ) | 5,410 | totalUsers ในเอนด์พอยต์ข้อมูลรวม |
| ตัวระบุผู้เรียน (ทั้งหมด) | 8,073 | เอนด์พอยต์ community; เป็นขอบบนของจำนวนคน |
| โจทย์ที่มีผู้ตอบ | 25,850 | โจทย์ 7,057 ข้อที่มีผู้ทำ ≥20 ครั้งเข้าสู่การวิเคราะห์ระดับโจทย์ |
| โจทย์ที่มีค่าความยากหลังปรับ | 18,139 | การประมาณค่า Rasch แบบขั้นตอนเดียวพร้อมการหดค่าแบบเบย์เชิงประจักษ์ |
| ระดับหลักฐาน | A 59.8% · B 33.5% · C 6.7% | A = บริบทแบบทดสอบ; B = แบบฝึกในบทเรียน; C = อื่น ๆ (เหมือน v1) |
| ช่วงที่ครอบคลุม | 2026-08-02 ถึง 10-21 | 81 วัน |
เกี่ยวกับตัวนับแบบเรียลไทม์: ข้อความในหน้าแรกที่ว่า "ผู้เรียน NTJ ทำแบบฝึกไปแล้ว 552,850 ข้อ" คือตัวเลขเรียลไทม์ของเอนด์พอยต์ community ณ วันที่ 2026-10-23 สูงกว่าชุดข้อมูลนี้ราว 9,500 — คือคำตอบที่เพิ่มเข้ามาในสองวันหลังสแนปช็อต โปรดอ้างอิงตัวเลข 543,344
3. แกนทักษะ (คำตอบทั้งหมด)
| แกน | คำตอบ | อัตราการตอบถูก | การตอบครั้งแรกระดับโจทย์ (จำนวนโจทย์) |
|---|---|---|---|
| คำศัพท์ | 267,127 | 90.1% | 89.1% (3,398) |
| รูปประโยค | 234,602 | 75.2% | 73.9% (3,252) |
| รูปคำกริยา | 18,479 | 75.2% | 76.2% (154) |
| คำช่วย | 13,870 | 71.3% | 67.6% (189) |
| สำนวน | 7,413 | 88.1% | 92.4% (64) |
| การอ่าน | 1,103 | 78.7% | — |
| การฟัง | 605 | 69.8% | — |
| การพูด | 118 | SUPPRESSED | — |
การอ่าน การฟัง และการพูดเป็นโจทย์ประเภทใหม่ที่มีกลุ่มตัวอย่างน้อย การพูดมีจำนวนต่ำกว่าเกณฑ์ 300 คำตอบ จึงรายงานเฉพาะจำนวนเท่านั้น
4. ระดับ JLPT
| ระดับ | อัตราการตอบถูกจากคำตอบทั้งหมด (n) | การตอบครั้งแรกระดับโจทย์ (จำนวนโจทย์) | อัตราการตอบถูกที่คาดหมายหลังปรับตามความสามารถ (CI 95%) |
|---|---|---|---|
| N5 | 87.1% (297,809) | 82.6% (3,817) | 78.0% (77.3–78.7%) |
| N4 | 79.5% (93,609) | 84.5% (1,766) | 79.4% (78.6–80.2%) |
| N3 | 75.3% (82,010) | 75.7% (1,008) | 75.3% (74.2–76.3%) |
| N2 | 74.8% (36,837) | 66.9% (249) | 71.2% (68.4–73.9%) |
| N1 | 78.1% (33,082) | 74.2% (217) | 73.3% (70.2–76.3%) |
สามคอลัมน์นี้ใช้ชุดการวิเคราะห์ต่างกัน ให้เปรียบเทียบภายในคอลัมน์เดียวกัน ไม่ใช่ข้ามคอลัมน์ คอลัมน์ที่ 1 นับทุกคำตอบรวมการทำซ้ำ และขึ้นกับสัดส่วนประเภทโจทย์ของแต่ละระดับ; คอลัมน์ที่ 2 ให้แต่ละโจทย์มีหนึ่งเสียง; คอลัมน์ที่ 3 ตัดผลของความสามารถผู้เรียนออกเพิ่มเติม
5. คุณภาพของโจทย์: คลังโจทย์ของเราเองก็ถูกวัดด้วย
| อัตราการตอบถูกในการตอบครั้งแรก | จำนวนโจทย์ |
|---|---|
| < 35% | 283 |
| 35–50% | 377 |
| 50–70% | 971 |
| 70–85% | 1,347 |
| 85–95% | 1,937 |
| ≥ 95% | 2,142 |
โจทย์ 283 ข้อ (4.0%) ที่ต่ำกว่า 35% ไม่จำเป็นต้องเป็นโจทย์ที่ไม่ดี — บางข้อแค่ยาก แต่การตรวจด้วยคนของเราในเดือนสิงหาคมพบว่าช่วงนี้มักมีตัวเลือกที่สองที่ถือว่าถูกได้เช่นกัน (เช่น ใน 「ピアノ_弾けます」 ใช้ได้ทั้ง が และ を) ระบบยังติดธงโจทย์ 415 ข้อให้ตรวจสอบตามเกณฑ์ต่าง ๆ เช่น ค่าอำนาจจำแนกติดลบอย่างชัดเจน ความแม่นยำ (precision) ของธงนี้อยู่ที่ราว 0.19: นี่คือคิวสำหรับตรวจสอบ ไม่ใช่รายชื่อโจทย์ที่ไม่ดี
6. ครูและผู้ออกแบบสื่อการสอนนำไปใช้ได้อย่างไร
- คำช่วย: で が และ に ตามหลัง を และ の ราว 20 จุด การฝึกทีละหน้าที่พร้อมตัวอย่างเฉพาะของหน้าที่นั้น ตรงจุดกว่าการฝึกคำช่วยแบบรวมทั้งตัว
- สำนวนแสดงการคาดคะเน: 〜らしい และ 〜はず เป็นรูปประโยคที่ตอบผิดบ่อยที่สุดในข้อมูลนี้ ควรสอนเปรียบเทียบกับ 〜そう 〜よう และ 〜みたい
- รูปสามารถ: ต่ำที่สุดในห้ารูปคำกริยา ควรฝึกแยกตามกลุ่มคำกริยา
- การอ่านข้อมูลของคุณเอง: หากแพลตฟอร์มของคุณก็พบว่าโจทย์ระดับสูงได้คะแนนสูงกว่าโจทย์ระดับกลาง ให้สงสัยผลจากการคัดเลือกก่อนจะสงสัยตัวโจทย์
7. ระเบียบวิธี
แหล่งข้อมูลและความสามารถในการทำซ้ำ
ตัวเลขทุกตัวใน v2 มาจากเอนด์พอยต์สาธารณะหกตัว ซึ่งดึงข้อมูลและตรึงไว้เมื่อวันที่ 2026-10-23: /api/aggregates?kind=summary, kind=items, kind=difficulty, kind=spacing, kind=brier และ /api/community?kind=overview เวลาสแนปช็อตของแต่ละเอนด์พอยต์และค่า sha256 ของไฟล์อินพุตแต่ละไฟล์อยู่ในไฟล์ดาวน์โหลด JSON ภายใต้ dataset.source_snapshot_at_utc และ dataset.input_sha256 สคริปต์สร้างข้อมูล scripts/build-research-dataset-2026-10.py ไม่มีสิทธิ์เข้าถึงข้อมูลระดับผู้เรียน
ชุดการวิเคราะห์ห้าชุด
- คำตอบทั้งหมด (แกนทักษะ ระดับ จุดความรู้): นับทุกคำตอบที่ใช้ได้ รวมถึงการทำซ้ำของตัวระบุเดียวกัน
- การตอบครั้งแรกระดับโจทย์: สำหรับแต่ละโจทย์ คำนวณอัตราการตอบถูกจากการตอบครั้งแรกของแต่ละตัวระบุ แล้วหาค่าเฉลี่ยข้ามโจทย์ ใช้เฉพาะโจทย์ที่มีผู้ทำ ≥20 ครั้ง; CI 95% ใช้โจทย์เป็นหน่วย
- ความยากที่ปรับตามความสามารถ: การประมาณค่า Rasch แบบขั้นตอนเดียว b̂ = θ̄ (ความสามารถเฉลี่ยของผู้ตอบจริง) − logit(p̂) หดค่าเข้าหาค่าเฉลี่ยของแกนด้วยน้ำหนัก n/(n+5) แล้วแปลงเป็นอัตราการตอบผิดที่คาดหมายสำหรับผู้เรียนที่มีความสามารถเท่าค่าเฉลี่ยทั้งเว็บไซต์ เรารายงานค่า 1 − อัตราการตอบผิดที่คาดหมาย
- คู่คำตอบต่อเนื่อง (ระยะห่างของการทบทวน): คำตอบต่อเนื่องของตัวระบุเดียวกันในจุดความรู้เดียวกัน เฉพาะระดับหลักฐาน A และ B
- ความแม่นยำของการทำนาย: คำตอบระดับ A ทั้งหมดที่มีค่าทำนายทั้งของ v1 และ v2 (ฟิลด์ค่าทำนายมีตั้งแต่ 2026-08-20)
ขนาดเซลล์ขั้นต่ำ
เซลล์ระดับเหตุการณ์ที่มี n < 300 จะถูกงดแสดงค่า (SUPPRESSED); จุดความรู้จะแสดงเฉพาะเมื่อ n ≥ 300; การวิเคราะห์ระดับโจทย์รวมเฉพาะโจทย์ที่มีผู้ทำ ≥20 ครั้ง
ช่วงความเชื่อมั่น
CI 95% แบบ Wilson ระดับเหตุการณ์ไม่ได้ปรับสำหรับคำตอบซ้ำของตัวระบุเดียวกัน (เอนด์พอยต์สาธารณะไม่เปิดเผยข้อมูลระดับตัวระบุ) จึงแคบเกินจริงและใช้เป็นเพียงข้อบ่งชี้ ส่วน CI ระดับโจทย์ใช้โจทย์เป็นหน่วยการสุ่ม: บรรยายคลังโจทย์นี้ ไม่ใช่ประชากรผู้เรียน
การไม่ระบุตัวตน
เอนด์พอยต์สาธารณะส่งคืนเฉพาะข้อมูลรวม ชุดข้อมูลนี้ไม่มีข้อมูลคำตอบดิบรายเหตุการณ์ ไม่มีตัวระบุ และไม่มีเวลาประทับระดับเหตุการณ์
8. ข้อจำกัด (โปรดอ้างอิงควบคู่กับตัวเลข)
- กลุ่มตัวอย่างเชิงสังเกตที่คัดเลือกตัวเอง ประกอบด้วยผู้ที่ฝึกบน NTJ; ไม่เป็นตัวแทนของประชากรผู้เรียนกลุ่มใด
- ตัวระบุไม่ใช่คน: ตัวระบุเบราว์เซอร์นิรนามไม่สามารถรวมข้ามอุปกรณ์ได้; 8,073 เป็นขอบบน
- ชุดโจทย์ต่างกัน: ระดับ แกนทักษะ และจุดความรู้ใช้โจทย์ต่างกัน ช่องว่างของอัตราการตอบถูกจึงไม่ใช่การจัดอันดับความยาก
- ตัวเลขจากคำตอบทั้งหมดสูงเกินจริงเพราะการฝึกซ้ำ
- การปรับตามความสามารถมีข้อสมมติ: โมเดล Rasch สมมติว่าความสามารถมีมิติเดียว; ความสามารถจะประมาณค่าได้เฉพาะตัวระบุที่มีคำตอบมากพอ
- CI ระดับเหตุการณ์แคบเกินจริง (ดูระเบียบวิธี)
- รายการโจทย์ถูกตัดทอน:
kind=itemsส่งคืนโจทย์สูงสุด 25,000 ข้อ เรียงตามจำนวนครั้งที่มีผู้ทำจากมากไปน้อย (จากทั้งหมด 25,850 ข้อ); 850 ข้อที่ขาดไปคือข้อที่มีผู้ทำน้อยที่สุด และไม่กระทบการวิเคราะห์ที่ใช้เกณฑ์ ≥20 ครั้ง - เฉพาะจุดความรู้ 100 อันดับแรก: เอนด์พอยต์ข้อมูลรวมส่งคืนจุดความรู้ 100 จุดที่มีผู้ตอบมากที่สุด
- เวลาในการตอบใช้ไม่ได้: แท็บที่เปิดค้างไว้ทำให้ค่าเฉลี่ยสูงเกินจริง จึงไม่รายงานเวลาในการตอบ
- ไม่มีข้อกล่าวอ้างเชิงเหตุและผล ในส่วนใดของรายงานนี้
9. วิธีอ้างอิง
ยินดีให้อ้างอิงชุดข้อมูลนี้ในบทความวิชาการ รายงาน สื่อการสอน และการรายงานข่าว โปรดระบุแหล่งที่มา ระบุเวอร์ชัน และลิงก์กลับมายังหน้านี้
APA (7th)
Nihongo to Japan. (2026). Japanese learning answer dataset — October 2026 (Version 2.0.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026-10MLA (9th)
Nihongo to Japan. Japanese Learning Answer Dataset — October 2026. Version 2.0.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10.BibTeX
@misc{ntj_jlad_2026_10,

  title = {Japanese Learning Answer Dataset --- October 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {2.0.0},

  note = {Snapshot 2026-10-21; aggregate statistics from 543,344 anonymous answer events, 2 August -- 21 October 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026-10}

}
สัญญาอนุญาต: ข้อมูลใช้ CC BY 4.0
ข้อมูลในชุดข้อมูลนี้เผยแพร่ภายใต้สัญญาอนุญาต Creative Commons Attribution 4.0 International (CC BY 4.0) คุณสามารถคัดลอก แจกจ่ายซ้ำ ดัดแปลง และต่อยอดได้ รวมถึงเพื่อการค้า โดยต้องให้เครดิตอย่างเหมาะสมและระบุหากมีการเปลี่ยนแปลง
⚠️ สัญญาอนุญาตครอบคลุมเฉพาะข้อมูลเท่านั้น: ได้แก่ตัวเลขรวมในหน้านี้และไฟล์ดาวน์โหลดสองไฟล์japanese-learning-2026-10.jsonและjapanese-learning-2026-10.csvกราฟของเรา (SVG/PNG) และเนื้อหารายงานไม่อยู่ในขอบเขตนี้ และสงวนลิขสิทธิ์ทั้งหมด
การระบุแหล่งที่มา
Nihongo to Japan, Japanese Learning Answer Dataset — October 2026, v2.0.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10คำขอของเรา (ไม่ใช่เงื่อนไขของสัญญาอนุญาต)
- ระบุข้อจำกัดไปด้วย: คัดเลือกตัวเอง เป็นข้อมูลเชิงสังเกต ไม่เป็นตัวแทนประชากร
- ระบุชุดการวิเคราะห์: ตัวเลขจากคำตอบทั้งหมด การตอบครั้งแรกระดับโจทย์ และตัวเลขหลังปรับตามความสามารถ ต่างกันมาก
- เขียนว่า "ตัวระบุผู้เรียน" ไม่ใช่ "คน"
- ระบุเวอร์ชัน (v2.0.0, สแนปช็อต 2026-10-21)
⚠️ CC BY เพิกถอนไม่ได้ ผู้ที่ได้รับข้อมูลภายใต้เงื่อนไขนี้จะยังคงมีสิทธิ์ดังกล่าว แม้ภายหลังเราจะเปลี่ยนเงื่อนไขก็ตาม
10. ดาวน์โหลด
- japanese-learning-2026-10.json — เมทาดาทาฉบับเต็ม ค่า sha256 ของอินพุต เกณฑ์ต่าง ๆ และเซลล์ข้อมูลรวมทุกเซลล์
- japanese-learning-2026-10.csv — หนึ่งแถวต่อหนึ่งเซลล์; คอลัมน์
table, key, n, value, ci95_low, ci95_high, unit, note - japanese-learning-2026-10-LICENSE.txt — คำแถลงสัญญาอนุญาต
ไฟล์กราฟ (PNG ความละเอียด 2× และ SVG ที่ปรับขนาดได้; กราฟไม่อยู่ภายใต้ CC BY — โปรดติดต่อเราก่อนนำไปเผยแพร่ซ้ำ):
- อัตราการตอบถูกดิบเทียบกับหลังปรับตามความสามารถ: PNG · SVG
- อัตราการตอบถูกของคำช่วย: PNG · SVG
- รูปประโยค 10 รูปที่มีอัตราการตอบถูกต่ำที่สุด: PNG · SVG
- อัตราการตอบถูกตามระยะห่างของการทบทวน: PNG · SVG
ข้อความ alt ของกราฟทุกภาพอยู่ใน alt-text.json
ติดต่อสำหรับสื่อมวลชนและเรื่องข้อมูล
หากต้องการการแจกแจงที่ละเอียดขึ้น สงสัยว่ามีข้อผิดพลาด หรือมีคำถามว่าควรอ้างอิงตัวเลขใด โปรดส่งอีเมลถึง [email protected] โดยใส่ "Dataset v2.0.0" ในหัวเรื่อง
เวอร์ชัน
| เวอร์ชัน | สแนปช็อต | ช่วงที่ครอบคลุม | หมายเหตุ |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 ถึง 10-21 (81 วัน) | หน้านี้ สร้างจากเอนด์พอยต์ข้อมูลรวมสาธารณะ เพิ่มความยากที่ปรับตามความสามารถ ระยะห่างของการทบทวน คุณภาพของโจทย์ และความแม่นยำของการทำนาย |
| v1.1.0 | 2026-08-14 | 2026-08-02 ถึง 08-13 (12 วัน) | ฉบับแรก ชุดหลักคือ "การตอบครั้งแรกในบริบทแบบทดสอบ" ตัวเลขในฉบับนั้นไม่มีการเปลี่ยนแปลงและยังอ้างอิงได้ |
ตัวเลขที่เผยแพร่แล้วจะไม่ถูกแก้ไขย้อนหลัง ← งานวิจัยและข้อมูล | สำหรับครูผู้สอนและห้องสมุด