Bộ dữ liệu câu trả lời học tiếng Nhật — tháng 8 năm 2026: tỷ lệ đúng trên 56.613 câu trả lời ẩn danh (ảnh chụp dữ liệu 12 ngày)
📢 Đã có bản phát hành mới hơn: Bộ dữ liệu câu trả lời học tiếng Nhật — tháng 10 năm 2026 (v2.0.0, 543.344 câu trả lời). Bản v2 dùng các tập phân tích khác, nên không thể lấy số liệu của bản đó trừ trực tiếp cho số liệu trên trang này; các số liệu v1.1.0 tại đây được giữ nguyên và vẫn có thể trích dẫn.
Tóm tắt một câu: thống kê tổng hợp từ 56.613 lượt trả lời ẩn danh trên Nihongo to Japan, do 1.053 mã định danh người học ẩn danh đóng góp, trên 11.987 câu hỏi.
⚠️ Đây là bản chụp dữ liệu tháng 8 năm 2026, không phải nghiên cứu về toàn bộ năm 2026. Dữ liệu bao phủ từ ngày 2 đến 13 tháng 8 năm 2026, tổng cộng mười hai ngày (quy trình tổng hợp bắt đầu vận hành ngày 2 tháng 8; ngày đầu tiên chỉ có dữ liệu một phần). Không thể rút ra bất kỳ xu hướng theo thời gian nào từ dữ liệu này. Phiên bản 1.1.0, bản chụp được cố định ngày 2026-08-14.
Về khái niệm "mã định danh người học": đây là các mã định danh ẩn danh được tạo ngẫu nhiên trong trình duyệt và không thể gộp giữa các thiết bị. Một người dùng cả điện thoại lẫn máy tính xách tay sẽ tạo ra hai mã định danh, vì vậy con số 1.053 không phải là số người riêng biệt đã được xác minh — đó là giới hạn trên. Xuyên suốt trang này, chúng tôi dùng cách nói "mã định danh người học" thay vì "người".
Dữ liệu này không phải là gì. Đây không phải là khảo sát đại diện cho người học tiếng Nhật ở Đài Loan hay bất kỳ nơi nào khác. Mẫu gồm những người tự chọn luyện tập trên trang web này — một mẫu quan sát tự chọn. Mọi con số chỉ mô tả những gì đã diễn ra trong tập câu trả lời này và không thể suy rộng cho bất kỳ tổng thể nào. Xem Các giới hạn.
Mười phát hiện có thể trích dẫn trực tiếp
Mỗi mục dưới đây đều đứng độc lập: bản thân câu đã nêu tên bộ dữ liệu, khoảng thời gian của bản chụp, cỡ mẫu và khoảng tin cậy, nên nhà báo hay nhà nghiên cứu có thể sao chép riêng bất kỳ mục nào mà không cần quay lại tìm ngữ cảnh. Mọi con số đều là giá trị quan sát được trong bộ dữ liệu này (tập phân tích chính là các lần trả lời đầu tiên trong ngữ cảnh kiểm tra — xem Phương pháp), không phải suy luận về tổng thể người học tiếng Nhật, và không đưa ra bất kỳ khẳng định nhân quả nào. Vui lòng trích dẫn kèm phần Các giới hạn.
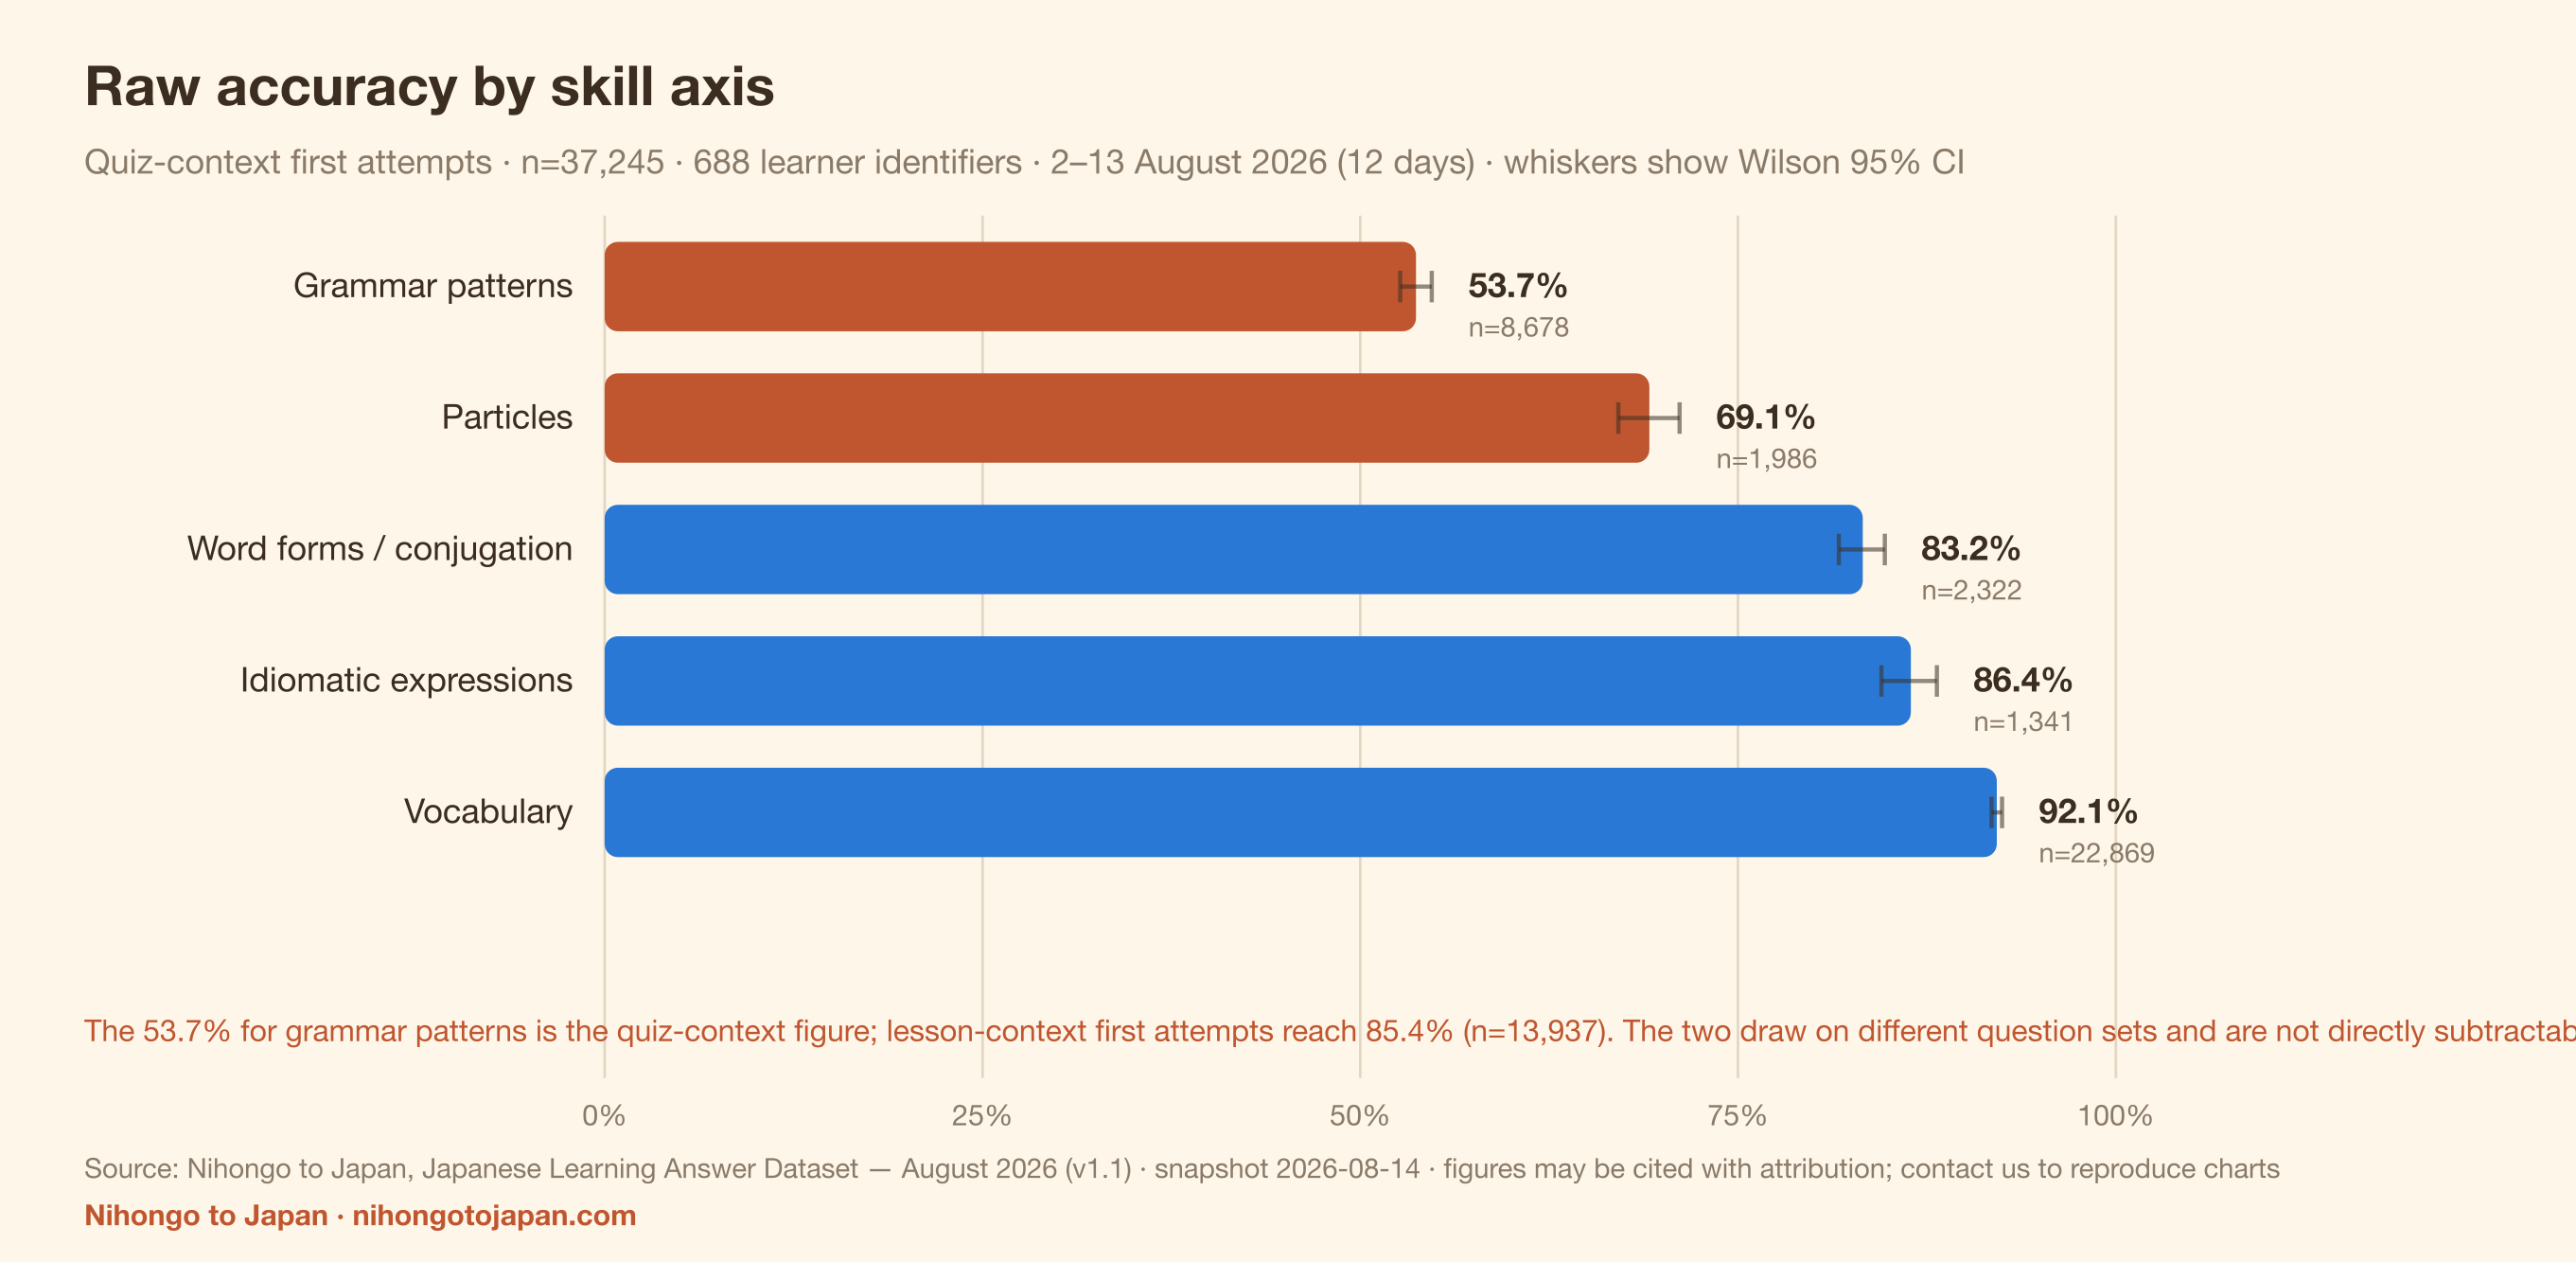
- Trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra thuộc Bộ dữ liệu câu trả lời học tiếng Nhật của NTJ (bản chụp tháng 8 năm 2026, 12 ngày), câu hỏi về mẫu ngữ pháp được trả lời đúng 53,7% (n=8.678; khoảng tin cậy Wilson 95%: 52,6%–54,7%), so với 92,1% ở từ vựng (n=22.869; khoảng tin cậy 95%: 91,8%–92,5%) — chênh lệch 38 điểm phần trăm.
Hai khoảng tin cậy không chồng lên nhau, nên chênh lệch này không phải nhiễu do lấy mẫu; báo cáo này không đưa ra nhận định nào về nguyên nhân. - Trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra của cùng bộ dữ liệu, năm trục học tập xếp từ thấp đến cao như sau: mẫu ngữ pháp 53,7% (n=8.678), trợ từ 69,1% (n=1.986; khoảng tin cậy 95%: 67,1%–71,1%), dạng từ và chia động từ 83,2% (n=2.322; khoảng tin cậy 95%: 81,7%–84,7%), thành ngữ và cách diễn đạt quen dùng 86,4% (n=1.341; khoảng tin cậy 95%: 84,5%–88,2%) và từ vựng 92,1% (n=22.869).
Mỗi trục dựa trên một bộ câu hỏi khác nhau, nên đây là thứ tự của tỷ lệ đúng quan sát được, không phải thứ tự độ khó. - Trong cùng bộ dữ liệu, tỷ lệ đúng quan sát được ở trục mẫu ngữ pháp dao động từ 53,7% đến 85,4% tùy theo những câu trả lời nào được tính: 53,7% ở các lần trả lời đầu tiên trong ngữ cảnh kiểm tra (n=8.678), 85,4% ở các lần trả lời đầu tiên trong ngữ cảnh bài học (n=13.937) và 74,1% trên toàn bộ lượt trả lời (n=24.293).
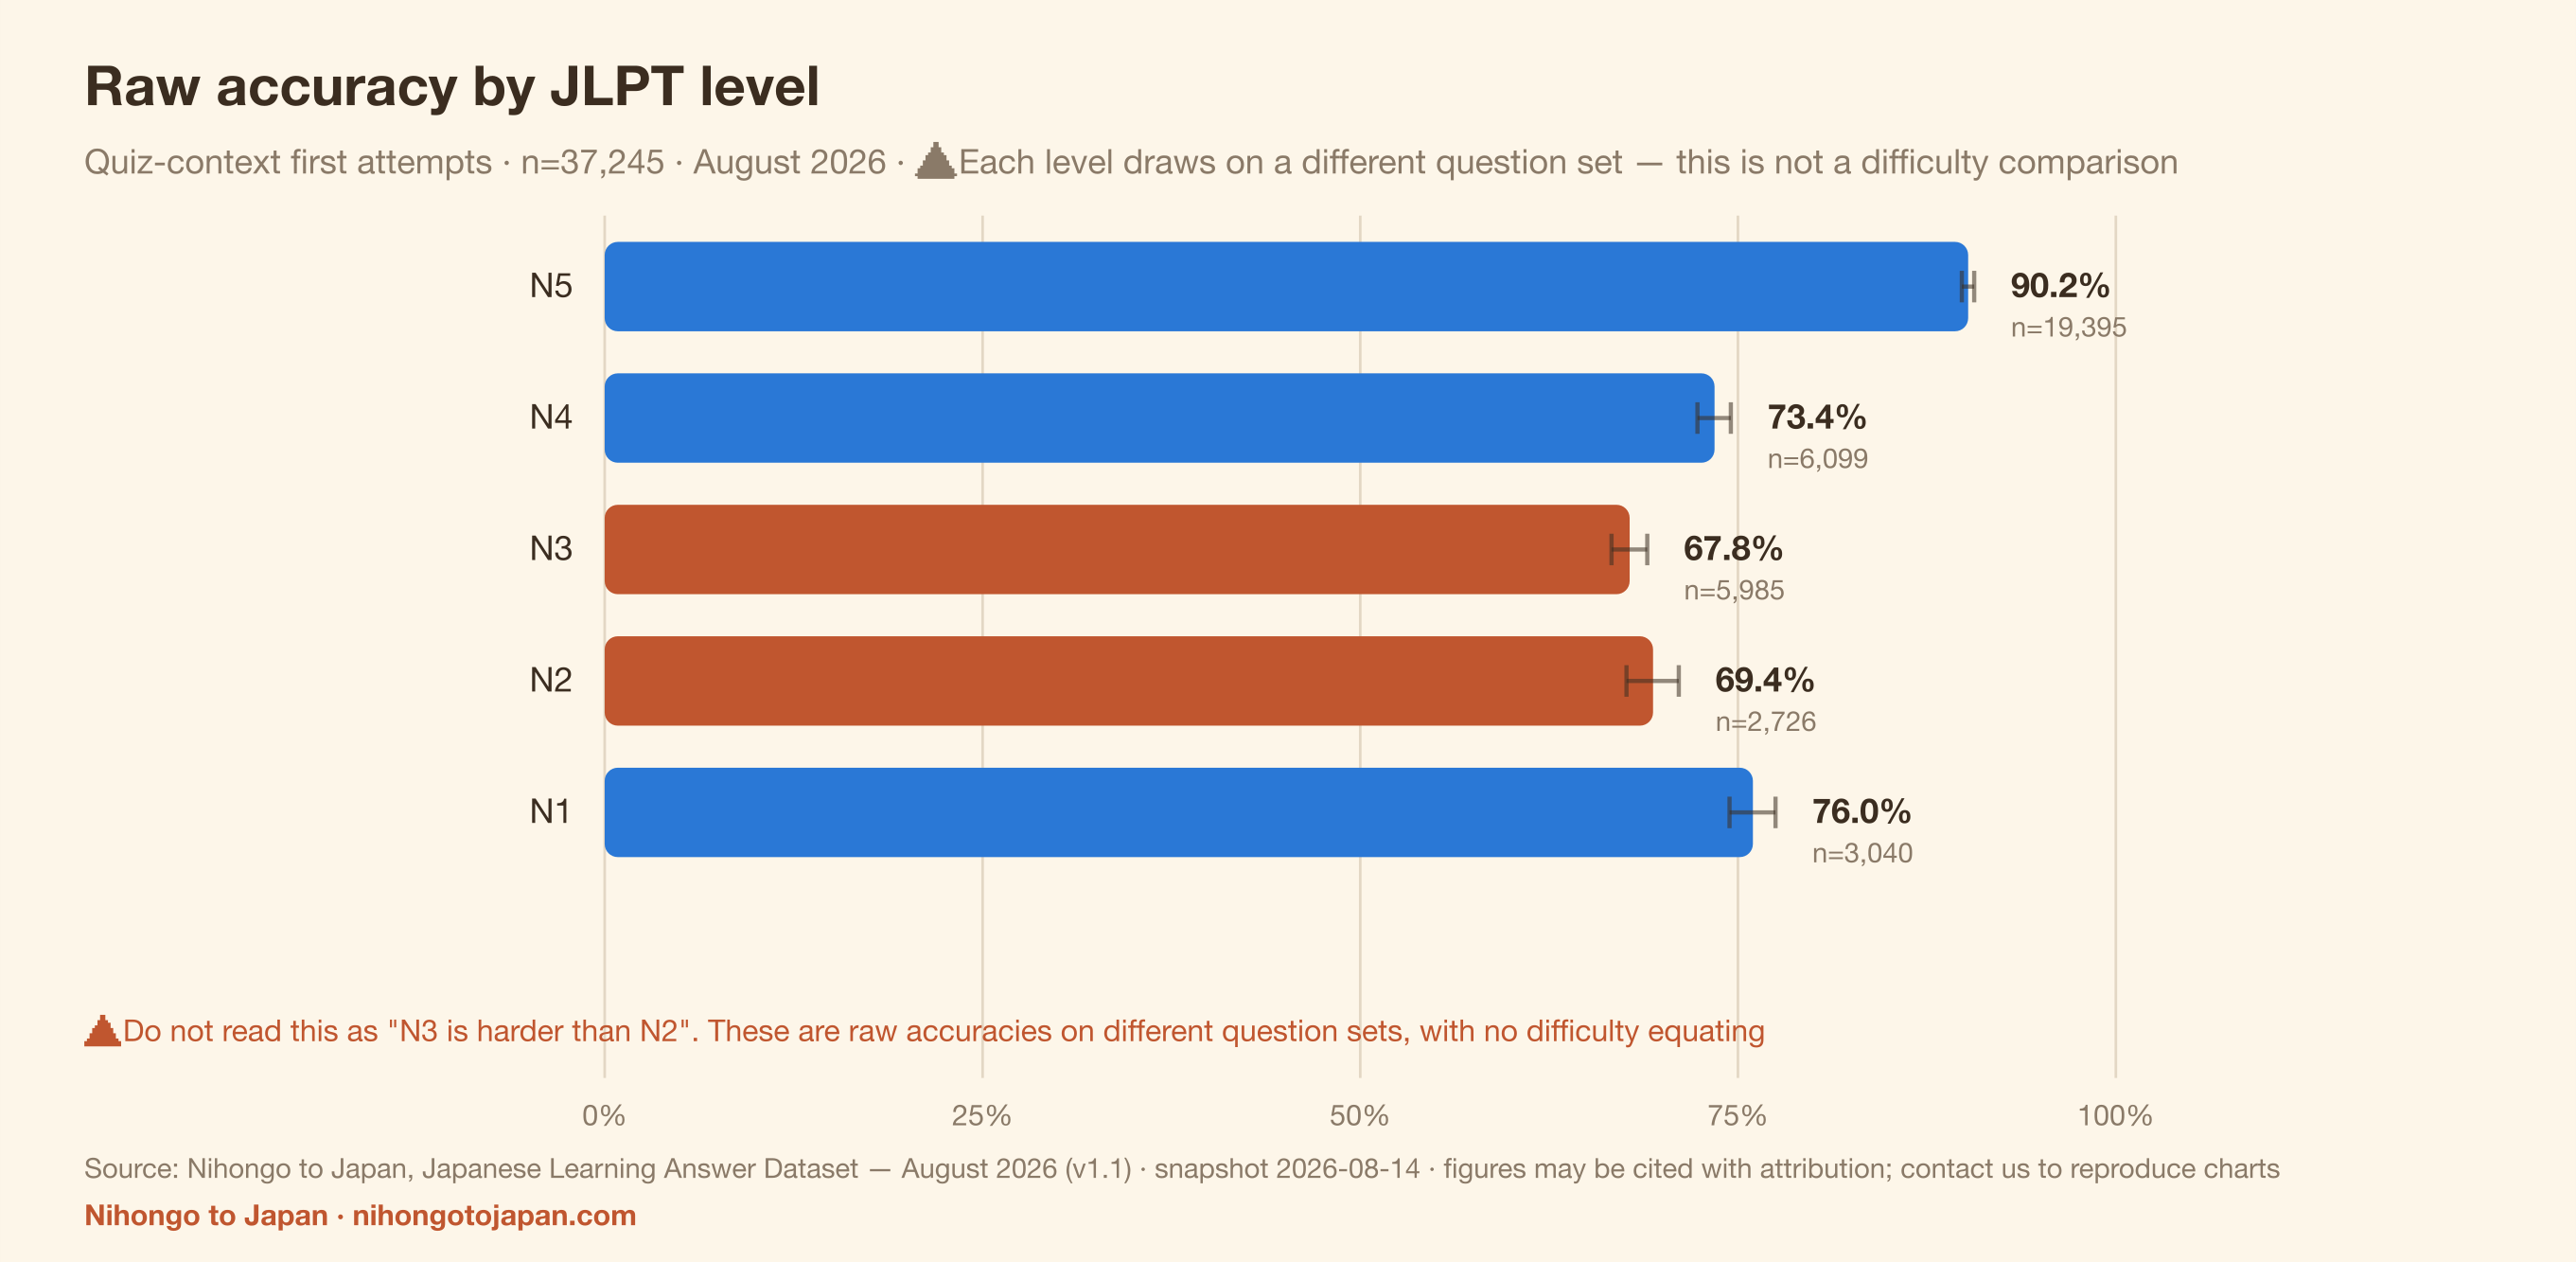
Hai ngữ cảnh dựa trên hai bộ câu hỏi gần như không giao nhau — trong 5.772 câu hỏi mẫu ngữ pháp khác nhau, chỉ có 6 câu xuất hiện ở cả hai — nên không thể tách ảnh hưởng của ngữ cảnh khỏi khác biệt về độ khó câu hỏi. Ý nghĩa của phát hiện này là: bất kỳ con số tỷ lệ đúng nào được trích dẫn từ một nền tảng học tập đều phải nêu rõ nó bao gồm những câu trả lời nào. - Trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra của cùng bộ dữ liệu, tỷ lệ đúng thô là 67,8% ở N3 (n=5.985; khoảng tin cậy 95%: 66,6%–69,0%) và 69,4% ở N2 (n=2.726; khoảng tin cậy 95%: 67,6%–71,1%); hai khoảng tin cậy chồng lên nhau, nên bộ dữ liệu này không thể phân biệt N2 với N3.
Đừng đưa tin rằng "N2 khó hơn N3" hay ngược lại. - Trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra của cùng bộ dữ liệu, tỷ lệ đúng thô theo cấp độ JLPT là N5 90,2% (n=19.395), N1 76,0% (n=3.040), N4 73,4% (n=6.099), N2 69,4% (n=2.726) và N3 67,8% (n=5.985) — tỷ lệ đúng thô của N1 cao hơn cả N2 lẫn N3.
Các cấp độ dùng những bộ câu hỏi khác nhau, không có quy đổi tương đương bằng IRT, và mẫu là mẫu tự chọn (người làm câu hỏi N1 thường đã học xa hơn), vì vậy thứ tự này không thể được hiểu là độ khó khách quan của các cấp độ JLPT. - Trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra của cùng bộ dữ liệu, mức chênh lệch giữa các trợ từ còn lớn hơn mức chênh lệch giữa các cấp độ JLPT: trợ từ が được trả lời đúng 60,9% (n=358; khoảng tin cậy 95%: 55,8%–65,8%) và を đạt 78,7% (n=385; khoảng tin cậy 95%: 74,3%–82,5%) — cách nhau 17,8 điểm, trong khi N3 (67,8%) và N4 (73,4%) chỉ cách nhau 5,6 điểm.
Hàm ý cho việc giảng dạy là: phân bổ thời gian luyện tập theo cấp độ JLPT có thể thô hơn so với phân bổ theo từng điểm kiến thức. - Trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra của cùng bộ dữ liệu, mẫu ngữ pháp là trục có điểm thấp nhất ở mọi cấp độ JLPT: 64,0% ở N5 (n=1.939), 48,0% ở N4 (n=1.734), 49,2% ở N3 (n=2.531), 51,1% ở N2 (n=1.179) và 57,0% ở N1 (n=1.295).
Từ vựng ở cùng các cấp độ: 94,4% ở N5, 89,0% ở N4, 84,0% ở N3, 85,0% ở N2 và 89,2% ở N1. - Trong cùng bộ dữ liệu, khi tính trên đúng cùng 372 mã định danh người học và cùng 34.392 lượt trả lời, cách tính mỗi câu trả lời một phiếu (trọng số theo lượt trả lời) cho kết quả 82,53%, còn cách tính mỗi mã định danh một phiếu cho kết quả 75,49% — chênh lệch 7,04 điểm phần trăm.
Cả hai con số dùng cùng một tổng thể và cùng một tập phân tích; chênh lệch hoàn toàn đến từ cách chọn trọng số. Bất kỳ báo cáo nào trích dẫn tỷ lệ đúng từ một nền tảng học tập đều nên nêu rõ mình dùng cách tính trọng số nào. - Trong cùng bộ dữ liệu, lượng câu trả lời tập trung rất cao: riêng mã định danh người học hoạt động nhiều nhất đã chiếm 3,73% trong tổng số 56.613 lượt trả lời, và 10 mã định danh đứng đầu cộng lại chiếm 19,44%.
Mức tập trung này là nguyên nhân trực tiếp khiến hai cách tính trọng số chênh nhau 7 điểm, và đây là một thiên lệch mang tính cấu trúc chung của dữ liệu từ các nền tảng học tập. - Trong cùng bộ dữ liệu, phép so sánh cặp giới hạn ở 75 mã định danh người học đã trả lời ở cả hai ngữ cảnh (mỗi bên ít nhất 5 câu trả lời) cho kết quả 86,57% ở ngữ cảnh bài học (n=5.858) so với 55,52% ở ngữ cảnh kiểm tra (n=2.055), hiệu trung bình theo cặp là 27,47 điểm phần trăm (khoảng tin cậy 95%: 22,56–32,39).
Điều này cho thấy khoảng cách giữa hai ngữ cảnh không phải là sản phẩm của việc ai trả lời ở đâu; nhưng vì không thể so sánh trên cùng một câu hỏi (xem phát hiện 3), vẫn không thể tách ảnh hưởng của ngữ cảnh khỏi độ khó của câu hỏi.
Mỗi phát hiện được triển khai chi tiết, lập bảng và vẽ biểu đồ ở các phần dưới đây. Nếu bạn chỉ cần số liệu, hãy đến Tải dữ liệu; để trích dẫn, xem Cách trích dẫn; nếu có câu hỏi, xem phần liên hệ.
1. Năm phát hiện chính
1. Mẫu ngữ pháp là trục duy nhất dưới 60%, thấp hơn từ vựng 38 điểm
Trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra (định nghĩa tập này xem tại Phương pháp), câu hỏi từ vựng được trả lời đúng 92,1% (n=22.869, 627 mã định danh người học, khoảng tin cậy 95%: 91,8%–92,5%), trong khi câu hỏi mẫu ngữ pháp chỉ đạt 53,7% (n=8.678, 532 mã định danh, khoảng tin cậy 95%: 52,6%–54,7%).
Hai khoảng tin cậy cách xa nhau, nên đây không phải nhiễu do lấy mẫu. Dữ liệu cho thấy khoảng cách lớn giữa hai trục; nó không cho biết vì sao.
2. "Tỷ lệ đúng" của mẫu ngữ pháp dao động từ 53,7% đến 74,1% tùy theo những câu trả lời nào được tính
Với các định nghĩa tập phân tích khác nhau, tỷ lệ đúng quan sát được ở trục mẫu ngữ pháp dao động từ 53,7% (lần trả lời đầu tiên ở ngữ cảnh kiểm tra, n=8.678) đến 74,1% (toàn bộ lượt trả lời, n=24.293). Vì cả các lượt trả lời được đưa vào lẫn thành phần mã định danh người học đều khác nhau, không thể xem toàn bộ chênh lệch là kết quả của một quy tắc đếm duy nhất.
Từng bước một:
| Bước | n | Tỷ lệ đúng thô | Thay đổi so với bước trước |
|---|---|---|---|
| Toàn bộ lượt trả lời | 24.293 | 74,1% | — |
| → chỉ giữ lần trả lời đầu tiên | 22.638 | 73,2% | -0,87 điểm % |
| → chỉ giữ ngữ cảnh kiểm tra (bỏ bài học/ôn tập) | 8.678 | 53,7% | -19,54 điểm % |
| (đối chiếu) lần trả lời đầu tiên ở ngữ cảnh bài học | 13.937 | 85,4% | — |
Loại bỏ các lần trả lời lặp lại chỉ làm con số thay đổi 0,9 điểm phần trăm. Gần như toàn bộ phần còn lại đến từ khác biệt giữa câu trả lời trong ngữ cảnh bài học và câu trả lời trong ngữ cảnh kiểm tra.
So sánh cặp trên cùng các mã định danh người học: 75 mã định danh có ít nhất 5 lần trả lời đầu tiên về mẫu ngữ pháp ở mỗi ngữ cảnh. Nhóm này đạt 86,6% ở ngữ cảnh bài học (n=5.858) và 55,5% ở ngữ cảnh kiểm tra (n=2.055), hiệu trung bình theo cặp là +27,5 điểm phần trăm (khoảng tin cậy 95%: 22,6–32,4; trung vị +26,9). Như vậy, khoảng cách này không đơn thuần là chuyện ai đang trả lời.
⚠️ Không thể so sánh trên cùng một câu hỏi, nên không thể rút ra kết luận. Trong 5.772 câu hỏi mẫu ngữ pháp khác nhau, chỉ có 6 câu xuất hiện ở cả hai ngữ cảnh, và chỉ 1 câu có ít nhất 3 câu trả lời ở mỗi bên. Hai ngữ cảnh dựa trên hai bộ câu hỏi gần như không giao nhau, nên không thể tách ảnh hưởng của ngữ cảnh khỏi khác biệt về độ khó câu hỏi. Có thể đơn giản là câu hỏi trong ngữ cảnh bài học dễ hơn.
Điều có thể nói một cách trung thực là: khi trích dẫn một con số tỷ lệ đúng từ nền tảng học tập, hãy luôn hỏi nó đến từ tập phân tích nào. Cả bốn tập đều có trong dữ liệu có thể tải về.
3. N3 và N2 có tỷ lệ đúng thô thấp nhất — nhưng dữ liệu này không thể phân biệt hai cấp độ
Tỷ lệ đúng thô của lần trả lời đầu tiên ở ngữ cảnh kiểm tra theo cấp độ: N5 90,2%, N4 73,4%, N3 67,8%, N2 69,4%, N1 76,0%.
Khoảng tin cậy của N3 (khoảng tin cậy 95%: 66,6%–69,0%) và N2 (khoảng tin cậy 95%: 67,6%–71,1%) chồng lên nhau, nên nói "N3 khó hơn N2" là không đúng. Điều có thể nói là: trong mẫu này, tỷ lệ đúng thô của cả N2 và N3 đều thấp hơn N4, N1 và N5.
⚠️ Quan trọng hơn, mỗi cấp độ dựa trên một bộ câu hỏi hoàn toàn khác nhau. Thứ tự này không phải là phép so sánh độ khó và không phải bằng chứng về việc cấp độ JLPT nào khó hơn một cách khách quan.
4. Mức chênh lệch giữa các trợ từ lớn hơn mức chênh lệch giữa các cấp độ
Tỷ lệ đúng của lần trả lời đầu tiên ở ngữ cảnh kiểm tra đối với từng trợ từ: が 60,9% (n=358, khoảng tin cậy 55,8%–65,8%), に 62,4% (n=370), で 63,3% (n=330), so với を 78,7% (n=385, khoảng tin cậy 74,3%–82,5%) và の 83,3% (n=120).
Khoảng tin cậy của が và を không chồng lên nhau; chênh lệch là 18 điểm phần trăm.
5. Cách tính mỗi mã định danh một phiếu và mỗi câu trả lời một phiếu chênh nhau 7,04 điểm
Tính trên đúng cùng 372 mã định danh người học, cùng tập phân tích và cùng 34.392 lượt trả lời hợp lệ:
| Cách tính trọng số | Tỷ lệ đúng |
|---|---|
| Trọng số theo lượt trả lời (mỗi câu trả lời một phiếu) | 82,5% |
| Trọng số theo mã định danh (mỗi mã định danh một phiếu) | 75,5% (trung vị 76,2%) |
| WEIGHTING_EFFECT_PP | 7,04 điểm % |
Nhóm phân tích: các mã định danh người học có ít nhất 20 câu trả lời trong tập phân tích chính. Hai con số dùng chung tổng thể ở tử số và chung mẫu số, nên chênh lệch chỉ phản ánh cách chọn trọng số, không bị lẫn khác biệt về thành phần mẫu.
Nguyên nhân là đo lặp lại: riêng mã định danh hoạt động nhiều nhất đã chiếm 3,7% tổng số câu trả lời, và mười mã định danh đứng đầu chiếm 19,4%. Mọi nghiên cứu dùng dữ liệu nền tảng đều gặp vấn đề này, vì vậy chúng tôi công bố cả hai con số.
2. Tổng quan bộ dữ liệu
| Hạng mục | Giá trị |
|---|---|
| Lượt trả lời hợp lệ | 56.613 |
| Mã định danh người học ẩn danh (giới hạn trên của số người) | 1.053 |
| Số câu hỏi khác nhau | 11.987 |
| Điểm kiến thức | 39 |
| Phạm vi thời gian | Từ ngày 2 đến 13 tháng 8 năm 2026 (12 ngày); ngày đầu tiên chỉ có dữ liệu một phần |
| Mốc chốt bản chụp | 2026-08-14T00:00:00Z |
| Lượt trả lời lần đầu | 52.934 |
| Lần trả lời đầu tiên ở ngữ cảnh kiểm tra (tập chính) | 37.245 |
| Mã định danh người học trong tập chính | 688 |
| Lần trả lời đầu tiên ở ngữ cảnh bài học (tập đối chiếu) | 15.741 |
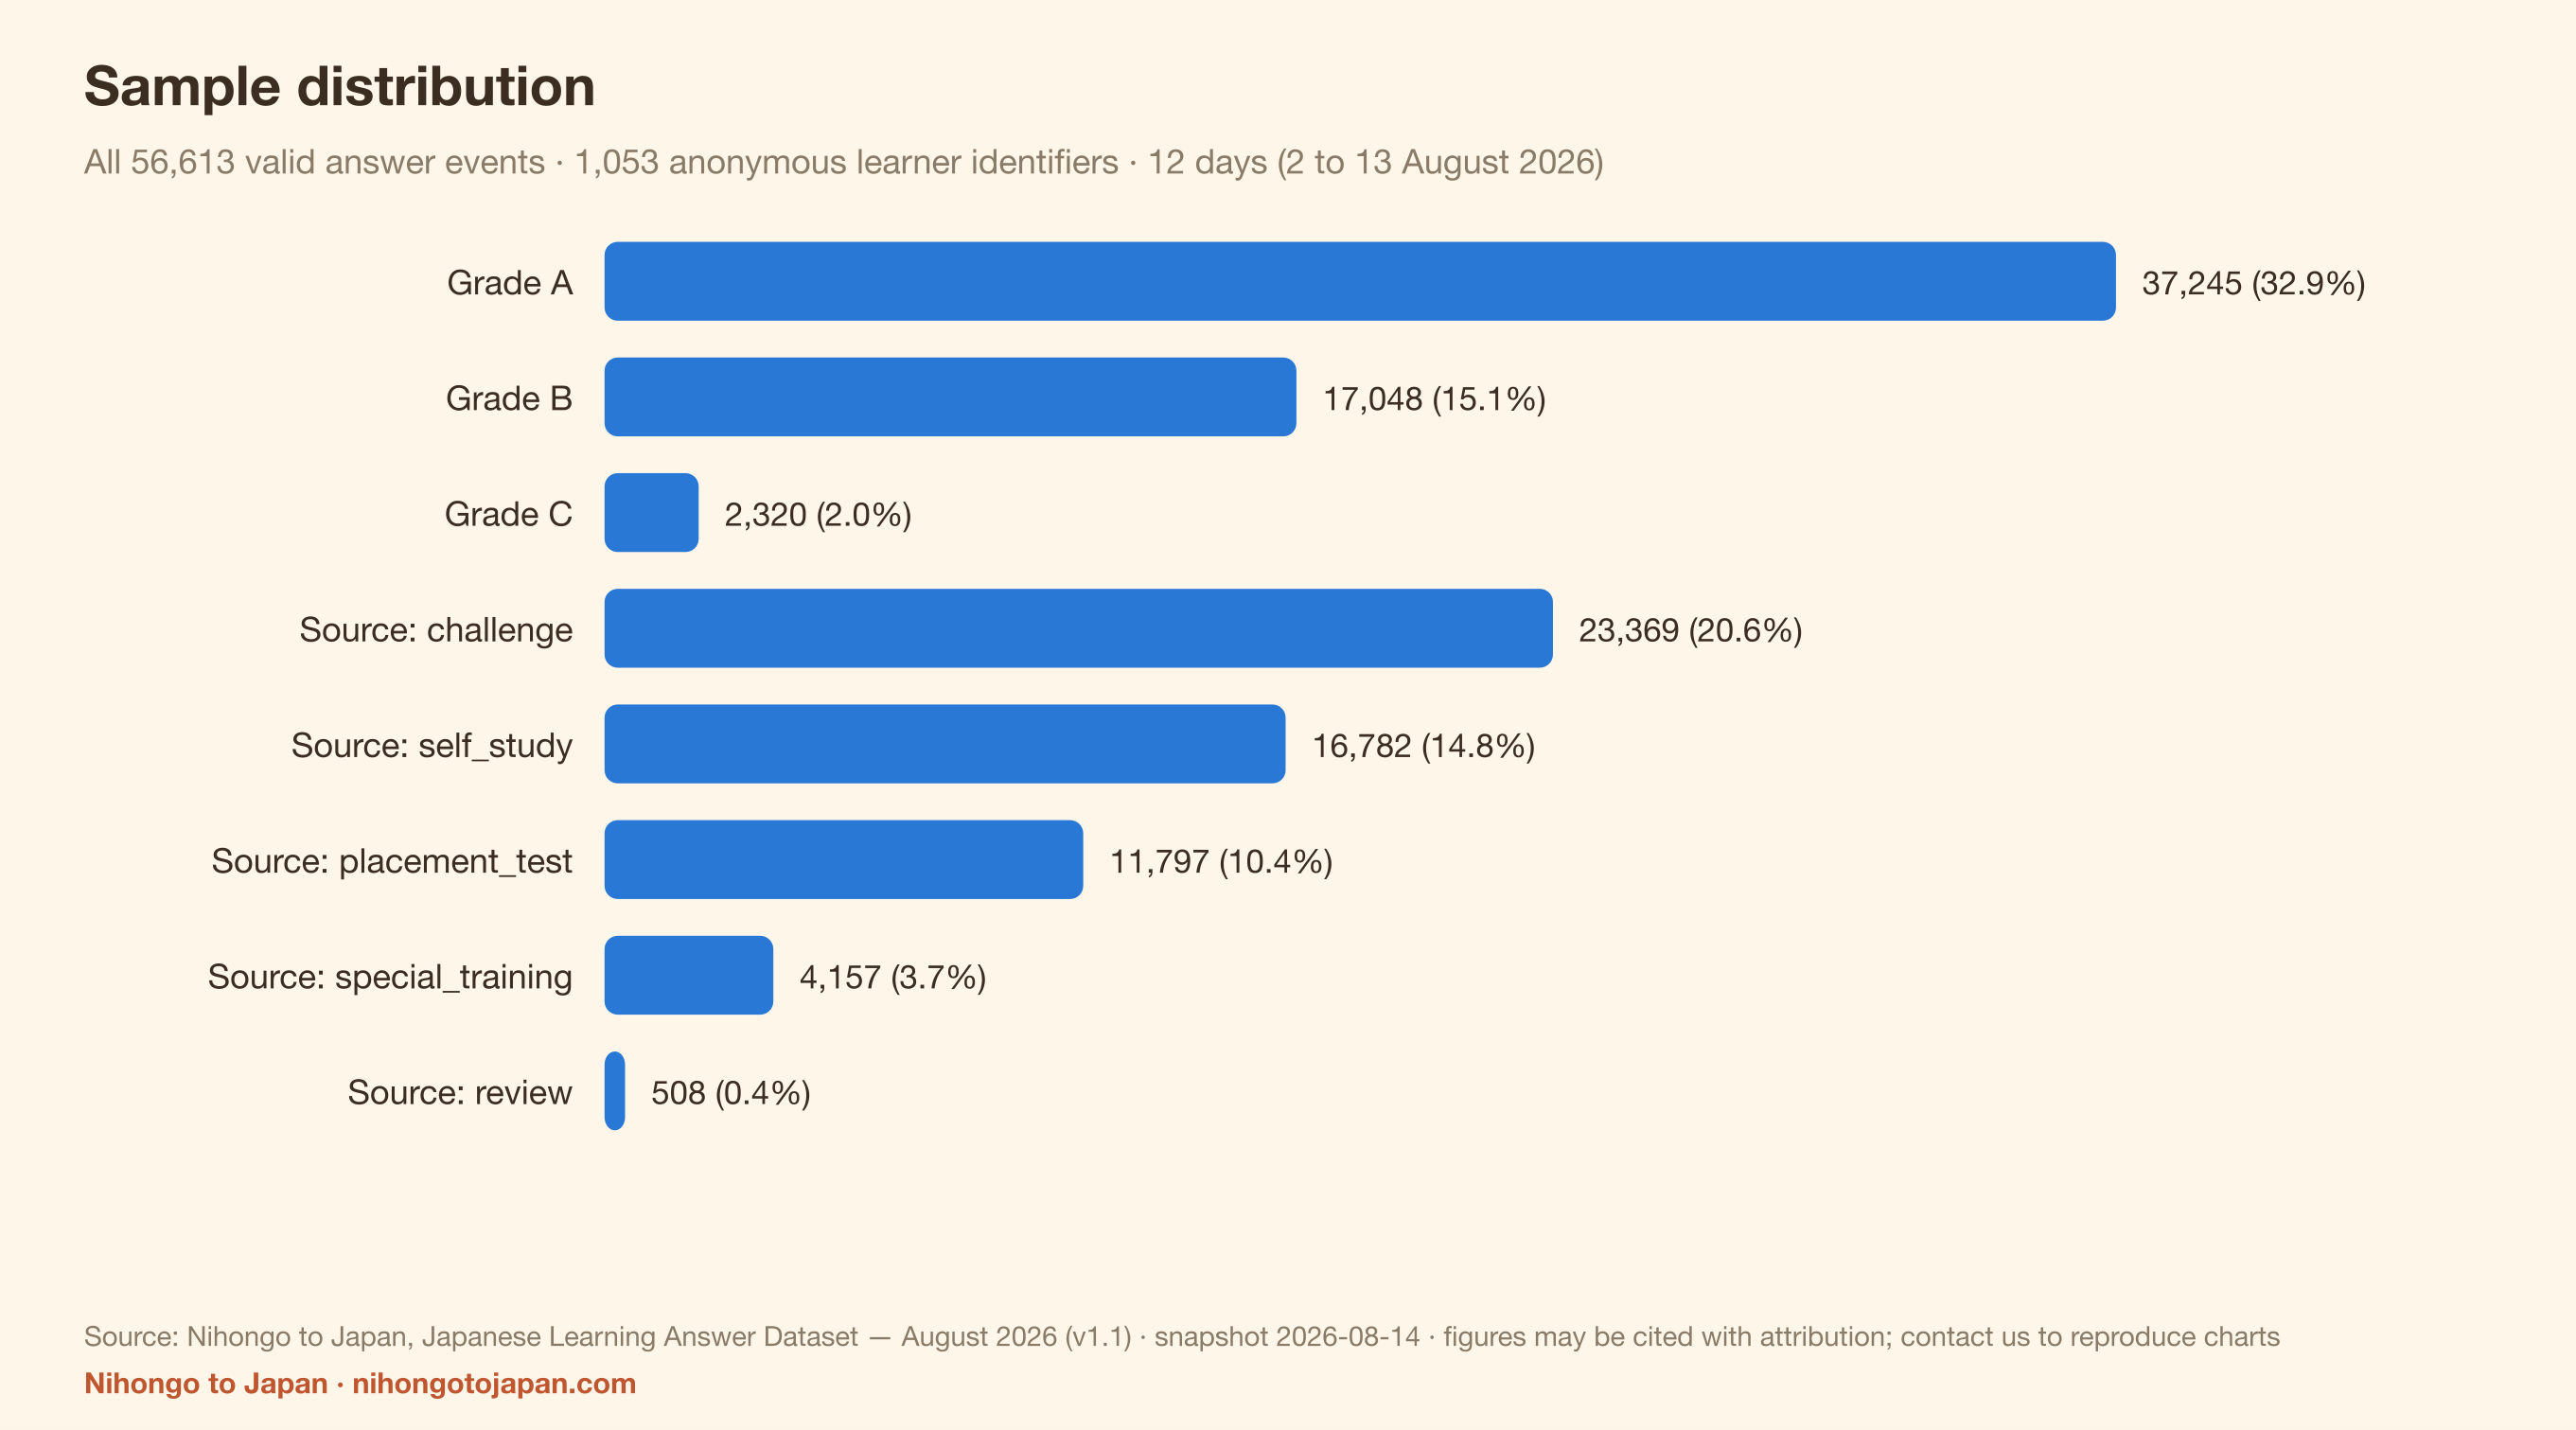
Số câu trả lời theo nguồn: challenge 23.369 (41,3%), self_study 16.782 (29,6%), placement_test 11.797 (20,8%), special_training 4.157 (7,3%), review 508 (0,9%).
Phân bố của cột evidence_class trong cơ sở dữ liệu (một trường gốc của bảng, không phải tên của tập phân tích nào trong báo cáo này): A 37.245 (65,8%), B 17.048 (30,1%), C 2.320 (4,1%). Tập phân tích chính chính xác là evidence_class = A.

3. Tỷ lệ đúng theo trục học tập

| Trục kỹ năng | n | Mã định danh | Tỷ lệ đúng thô | KTC 95% | Cờ |
|---|---|---|---|---|---|
| Mẫu ngữ pháp | 8.678 | 532 | 53,7% | 52,6%–54,7% | OK |
| Trợ từ | 1.986 | 137 | 69,1% | 67,1%–71,1% | OK |
| Dạng từ / chia động từ | 2.322 | 386 | 83,2% | 81,7%–84,7% | OK |
| Thành ngữ và cách diễn đạt quen dùng | 1.341 | 261 | 86,4% | 84,5%–88,2% | OK |
| Từ vựng | 22.869 | 627 | 92,1% | 91,8%–92,5% | OK |
Các trục sau không đạt cỡ ô tối thiểu (n<30 hoặc ít hơn 5 mã định danh người học), nên không công bố tỷ lệ đúng — chỉ công bố số lượt trả lời: Tổng hợp / toàn diện (n=27, 8 mã định danh), Đọc hiểu (n=22, 4 mã định danh).
4. Tỷ lệ đúng theo cấp độ JLPT
⚠️ Đây là phần dễ bị hiểu sai nhất. Mỗi cấp độ dựa trên một bộ câu hỏi hoàn toàn khác nhau, và không thực hiện quy đổi tương đương độ khó bằng IRT. Các con số dưới đây là tỷ lệ trả lời đúng của chính những câu hỏi này — không phải thước đo xem cấp độ nào khó hơn.

| Cấp độ JLPT | n | Mã định danh | Tỷ lệ đúng thô | KTC 95% |
|---|---|---|---|---|
| N5 | 19.395 | 380 | 90,2% | 89,8%–90,6% |
| N4 | 6.099 | 313 | 73,4% | 72,3%–74,5% |
| N3 | 5.985 | 432 | 67,8% | 66,6%–69,0% |
| N2 | 2.726 | 212 | 69,4% | 67,6%–71,1% |
| N1 | 3.040 | 139 | 76,0% | 74,4%–77,5% |
Cùng các cấp độ đó trên cả bốn tập phân tích:
| Cấp độ | Lần đầu, ngữ cảnh kiểm tra (tập chính) | Lần đầu, ngữ cảnh bài học | Lần đầu (mọi ngữ cảnh) | Toàn bộ lượt trả lời |
|---|---|---|---|---|
| N5 | 90,2% (n=19.395) | 83,7% (n=11.154) | 87,8% (n=30.495) | 88,2% (n=33.286) |
| N4 | 73,4% (n=6.099) | 83,1% (n=2.694) | 76,5% (n=8.758) | 76,6% (n=9.262) |
| N3 | 67,8% (n=5.985) | 82,1% (n=1.507) | 70,8% (n=7.522) | 71,1% (n=7.727) |
| N2 | 69,4% (n=2.726) | 79,2% (n=260) | 70,2% (n=2.985) | 70,5% (n=3.072) |
| N1 | 76,0% (n=3.040) | 86,5% (n=126) | 76,4% (n=3.174) | 76,5% (n=3.266) |
5. Các điểm kiến thức có tỷ lệ đúng thấp nhất
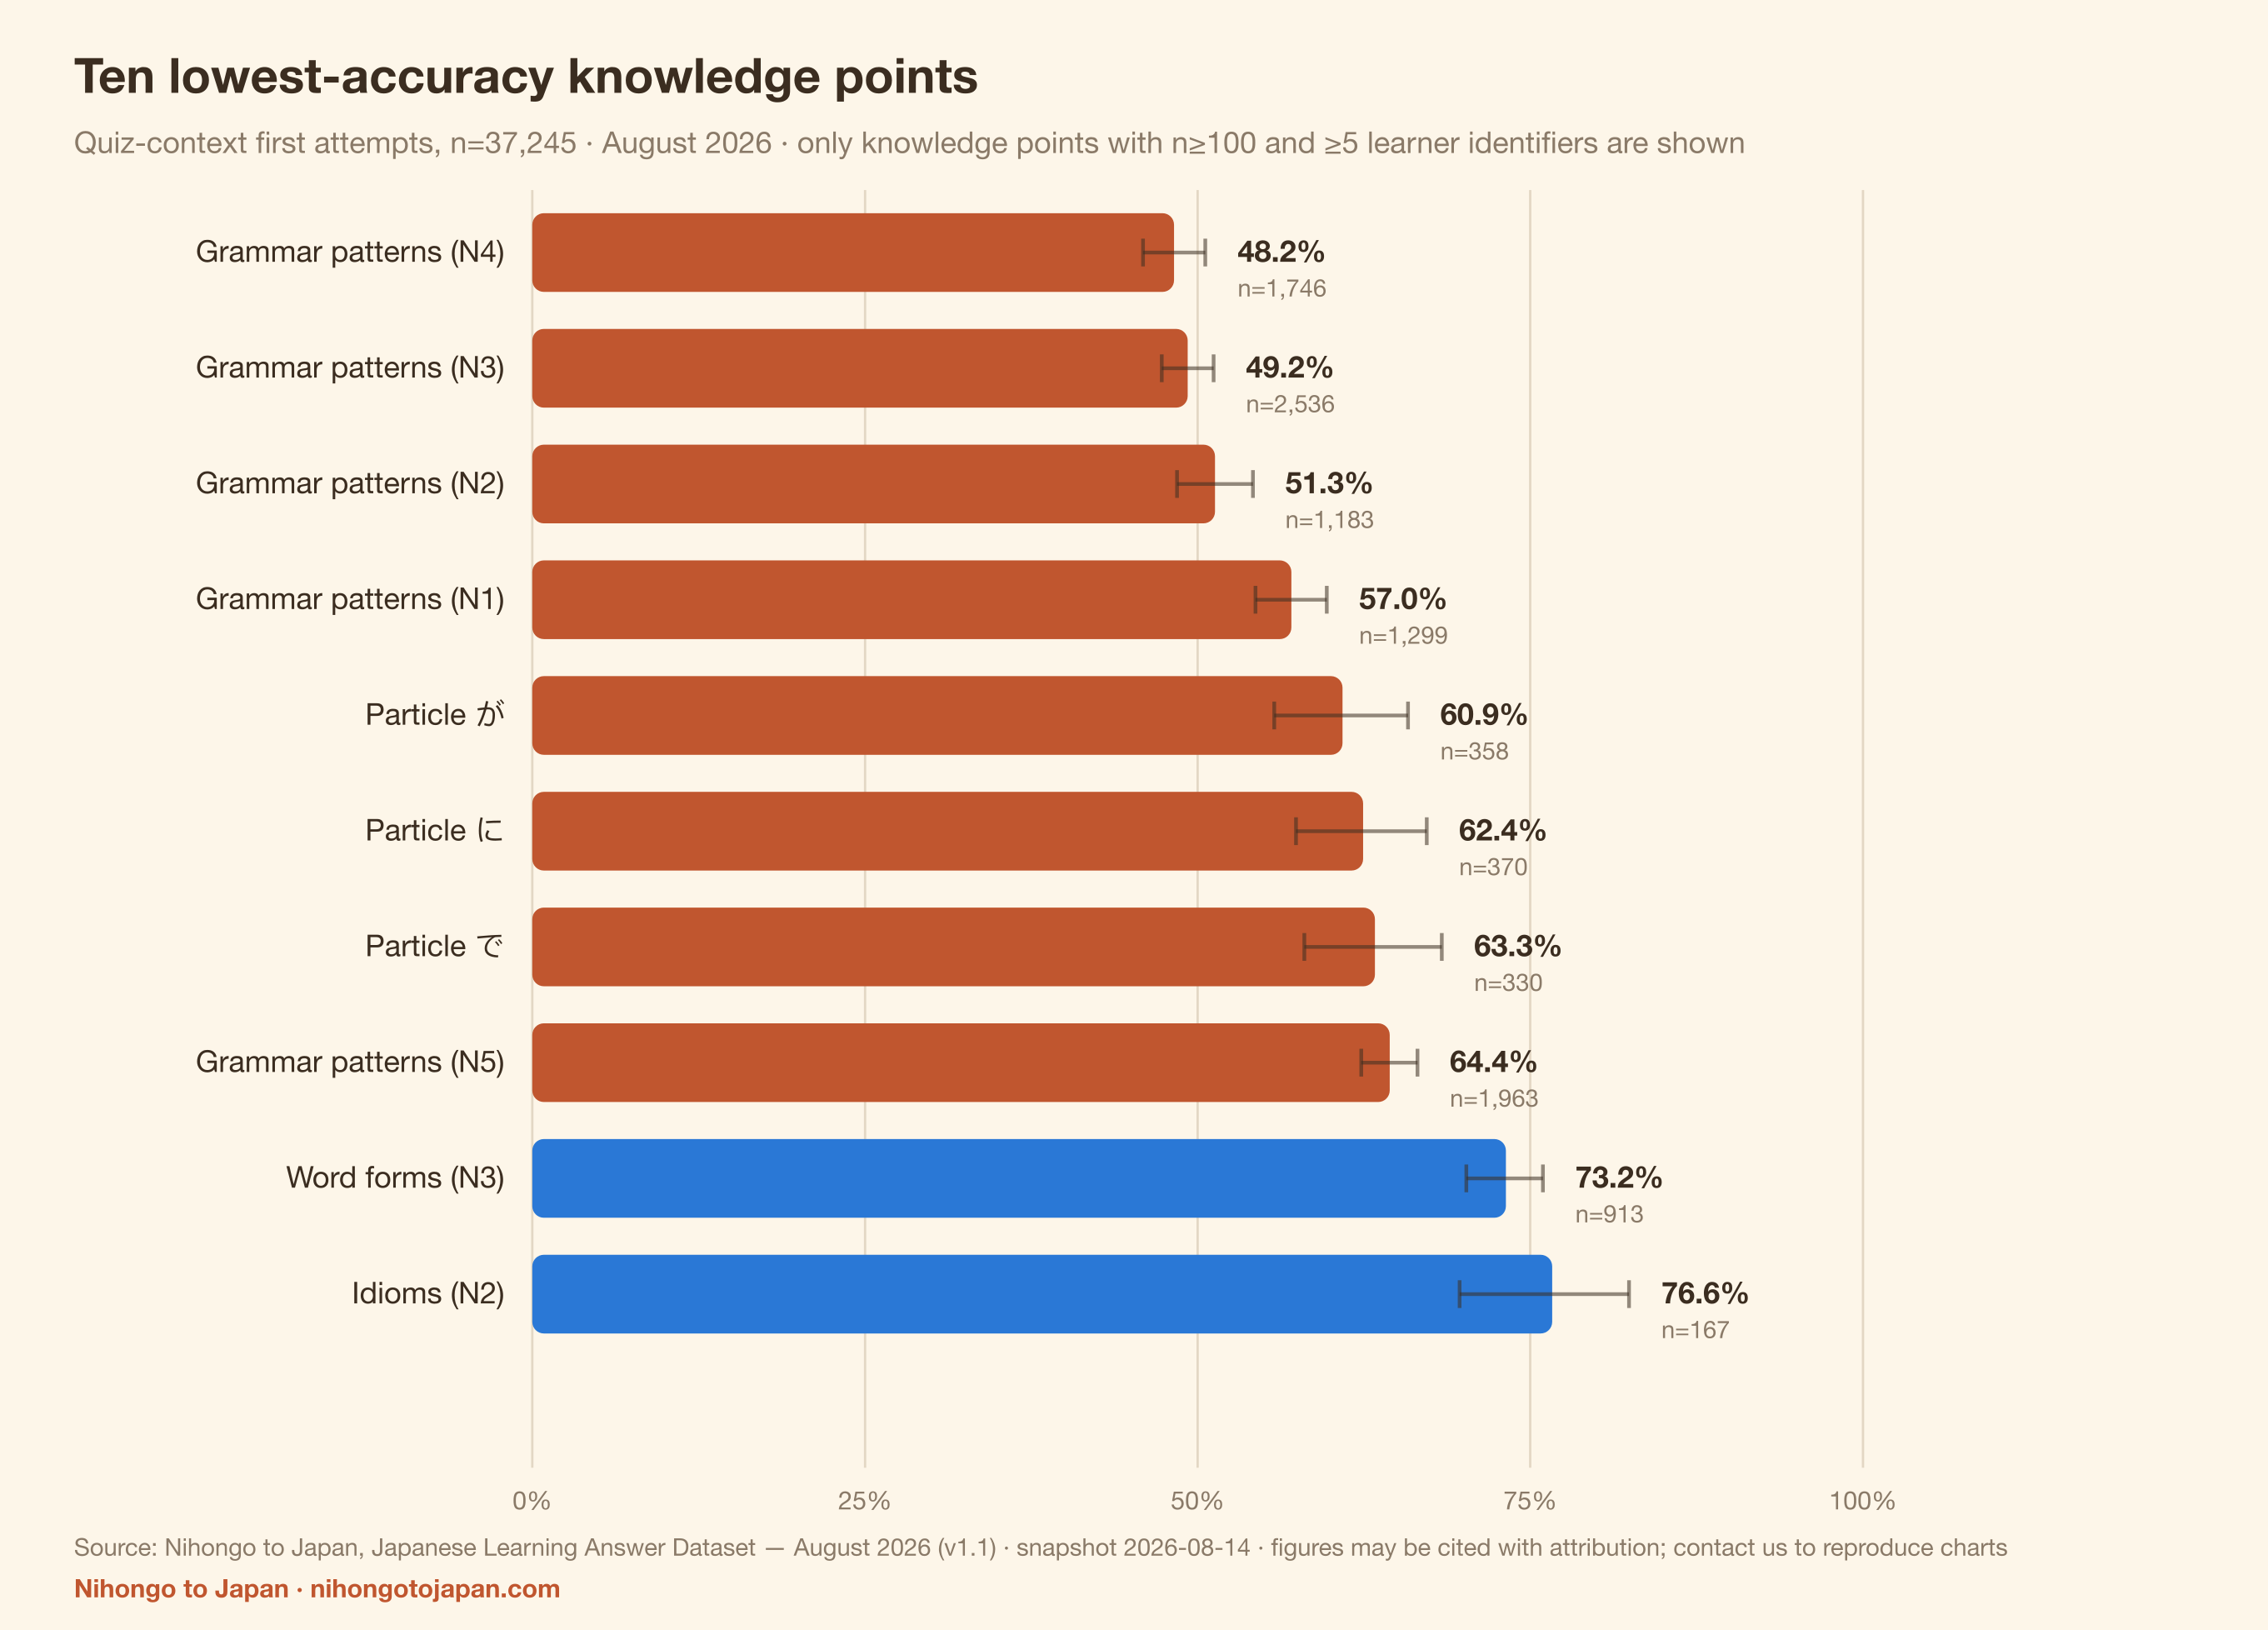
Chỉ liệt kê các điểm kiến thức có n≥100 và ít nhất 5 mã định danh người học (23 điểm đạt điều kiện). n, cấp độ và loại được hiển thị cùng tỷ lệ phần trăm — các ô có cỡ mẫu nhỏ trông có vẻ cực đoan vì những lý do thường chỉ là nhiễu.

| # | Điểm kiến thức | Loại | Cấp độ | n | Mã định danh | Tỷ lệ đúng thô | KTC 95% |
|---|---|---|---|---|---|---|---|
| 1 | Mẫu ngữ pháp (N4) | Mẫu ngữ pháp | N4 | 1.746 | 234 | 48,2% | 45,9%–50,6% |
| 2 | Mẫu ngữ pháp (N3) | Mẫu ngữ pháp | N3 | 2.536 | 390 | 49,2% | 47,3%–51,2% |
| 3 | Mẫu ngữ pháp (N2) | Mẫu ngữ pháp | N2 | 1.183 | 191 | 51,3% | 48,5%–54,1% |
| 4 | Mẫu ngữ pháp (N1) | Mẫu ngữ pháp | N1 | 1.299 | 118 | 57,0% | 54,3%–59,7% |
| 5 | Trợ từ が | Trợ từ | — | 358 | 81 | 60,9% | 55,8%–65,8% |
| 6 | Trợ từ に | Trợ từ | — | 370 | 75 | 62,4% | 57,4%–67,2% |
| 7 | Trợ từ で | Trợ từ | — | 330 | 85 | 63,3% | 58,0%–68,3% |
| 8 | Mẫu ngữ pháp (N5) | Mẫu ngữ pháp | N5 | 1.963 | 209 | 64,4% | 62,3%–66,5% |
| 9 | Dạng từ (N3) | Dạng từ | N3 | 913 | 294 | 73,2% | 70,2%–75,9% |
| 10 | Thành ngữ (N2) | Thành ngữ | N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| 11 | Trợ từ を | Trợ từ | — | 385 | 61 | 78,7% | 74,3%–82,5% |
| 12 | Dạng từ (N2) | Dạng từ | N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
6. Những điểm mạnh ổn định nhất
| # | Điểm kiến thức | Loại | Cấp độ | n | Mã định danh | Tỷ lệ đúng thô | KTC 95% |
|---|---|---|---|---|---|---|---|
| 1 | Dạng từ (N1) | Dạng từ | N1 | 296 | 79 | 95,6% | 92,6%–97,4% |
| 2 | Từ vựng (N5) | Từ vựng | N5 | 16.029 | 311 | 94,4% | 94,0%–94,8% |
| 3 | Từ vựng (N1) | Từ vựng | N1 | 703 | 94 | 89,2% | 86,7%–91,3% |
| 4 | Từ vựng (N4) | Từ vựng | N4 | 2.828 | 243 | 89,0% | 87,8%–90,1% |
| 5 | Thành ngữ (N1) | Thành ngữ | N1 | 742 | 111 | 88,8% | 86,3%–90,9% |
| 6 | Dạng từ (N4) | Dạng từ | N4 | 461 | 149 | 87,0% | 83,6%–89,8% |
| 7 | Thành ngữ (N4) | Thành ngữ | N4 | 140 | 91 | 86,4% | 79,8%–91,1% |
| 8 | Thành ngữ (N3) | Thành ngữ | N3 | 290 | 142 | 85,9% | 81,4%–89,4% |
7. Một số mô thức quan sát đáng chú ý
Quan sát A: tỷ lệ đúng thô của N1 cao hơn N2 và N3
N1 đạt 76,0% (n=3.040, 139 mã định danh), cao hơn N2 69,4% và N3 67,8%.
Đây là một mô thức quan sát được, không phải bằng chứng cho thấy N1 dễ hơn. Có ít nhất ba cách giải thích mà dữ liệu này không thể loại trừ: chỉ có 139 mã định danh trả lời câu hỏi N1 so với 432 ở N3, nên thành phần các nhóm khác nhau; các bộ câu hỏi khác nhau; và không thực hiện ước lượng năng lực. Muốn trả lời "cấp độ nào thực sự khó hơn" cần quy đổi tương đương bằng IRT và thiết kế câu hỏi neo, mà bộ dữ liệu này không có cả hai.
Quan sát B: trục mẫu ngữ pháp thấp nhất ở mọi cấp độ
| Trục × cấp độ | n | Mã định danh | Tỷ lệ đúng thô | KTC 95% |
|---|---|---|---|---|
| Mẫu ngữ pháp × N4 | 1.734 | 233 | 48,0% | 45,6%–50,3% |
| Mẫu ngữ pháp × N3 | 2.531 | 389 | 49,2% | 47,2%–51,1% |
| Mẫu ngữ pháp × N2 | 1.179 | 191 | 51,1% | 48,3%–54,0% |
| Mẫu ngữ pháp × N1 | 1.295 | 118 | 57,0% | 54,3%–59,7% |
| Trợ từ × N4 | 766 | 92 | 58,5% | 55,0%–61,9% |
| Mẫu ngữ pháp × N5 | 1.939 | 208 | 64,0% | 61,8%–66,1% |
| Dạng từ / chia động từ × N3 | 948 | 302 | 74,2% | 71,3%–76,8% |
| Trợ từ × N5 | 1.220 | 111 | 75,8% | 73,3%–78,1% |
| Thành ngữ và cách diễn đạt quen dùng × N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| Dạng từ / chia động từ × N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
Khi kết hợp trục với cấp độ, gần như mọi ô thấp nhất đều là ô mẫu ngữ pháp. Điều này cho nhiều thông tin hơn so với chỉ xem riêng phân tích theo cấp độ.
8. Giáo viên và người thiết kế tài liệu có thể dùng dữ liệu này vào việc gì
Phần này cố ý tách dữ liệu khỏi diễn giải. Dữ liệu có thể trích dẫn; phần diễn giải là nhận định của chúng tôi, và bạn hoàn toàn có thể không đồng ý.
| Dữ liệu (có thể trích dẫn) | Diễn giải (nhận định của chúng tôi, không phải dữ liệu) |
|---|---|
| Lần trả lời đầu tiên ở ngữ cảnh kiểm tra: trục mẫu ngữ pháp 53,7% so với từ vựng 92,1% (n=8.678 và 22.869) | Trên nền tảng này có một khoảng cách rõ rệt giữa việc nhận ra từ và việc ghép thành câu. Nếu phải phân bổ thời gian luyện tập, mẫu ngữ pháp có thể mang lại hiệu quả biên cao hơn. |
| が 60,9%, に 62,4%, で 63,3% thấp hơn đáng kể so với を 78,7% và の 83,3% | を và の có chức năng tương đối hẹp, trong khi が, に và で mang rất nhiều nghĩa. Dạy riêng từng chức năng khác nhau của một trợ từ có thể hiệu quả hơn so với giới thiệu lần lượt từng trợ từ. |
| Tỷ lệ đúng thô của N2 và N3 (69,4% / 67,8%) thấp hơn N4, N1 và N5 | ⚠️ Đừng dùng điều này để xếp hạng độ khó. Cách hiểu hợp lý hơn là nhóm người học trả lời ở N2/N3 có thành phần khác với nhóm ở các cấp độ khác, chứ không phải do bản thân câu hỏi. |
| Mẫu ngữ pháp: 85,4% ở ngữ cảnh bài học (n=13.937) so với 53,7% ở ngữ cảnh kiểm tra (n=8.678); hiệu theo cặp +27,5 điểm phần trăm trên 75 mã định danh | Trả lời trong lúc học bài và trả lời khi làm kiểm tra cho kết quả rất khác nhau — điều đáng lưu ý khi dùng điểm luyện tập trên nền tảng để đánh giá kết quả học tập. ⚠️ Nhưng hai ngữ cảnh dùng hai bộ câu hỏi gần như không giao nhau, nên chúng tôi không thể nói đây là do ngữ cảnh hay chỉ đơn giản là câu hỏi dễ hơn. |
9. Phương pháp
| Hạng mục | Chi tiết |
|---|---|
| Tổng thể | Các bản ghi câu trả lời do người học sử dụng Nihongo to Japan tạo ra. |
| Cách lấy mẫu | Mẫu quan sát tự chọn. Không phải lấy mẫu ngẫu nhiên; không đại diện cho tổng thể. |
| Đơn vị phân tích | lượt trả lời (một mã định danh người học trả lời một câu hỏi một lần). |
| Số người dùng | mã định danh người học = số mã định danh ẩn danh khác nhau. Chúng không thể gộp giữa các thiết bị, nên đây là giới hạn trên của số người, không phải số người đã được xác minh. |
| Chỉ số | tỷ lệ đúng thô = số câu đúng ÷ số lượt trả lời hợp lệ. Không phải ước lượng năng lực. |
| Khoảng tin cậy | Khoảng tin cậy Wilson 95%. Chỉ phản ánh sai số lấy mẫu; không hiệu chỉnh thiên lệch chọn mẫu. |
Bốn tập phân tích
| Tập | Định nghĩa | n |
|---|---|---|
| Lần trả lời đầu tiên ở ngữ cảnh kiểm tra (tập phân tích chính) | Câu trả lời từ challenge / placement_test / special_training, trong đó đây là lần đầu tiên mã định danh người học trả lời câu hỏi đó, không phải lần lặp lại trong vòng 24 giờ, và có đầy đủ siêu dữ liệu câu hỏi. | 37.245 |
| Lần trả lời đầu tiên ở ngữ cảnh bài học (tập đối chiếu) | Các lần trả lời đầu tiên từ self_study / review — câu trả lời đưa ra trong khi học theo tài liệu bài học. | 15.741 |
| Lần trả lời đầu tiên (mọi ngữ cảnh) | Câu trả lời đầu tiên của mỗi mã định danh người học cho mỗi câu hỏi, bất kể nguồn. | 52.934 |
| Toàn bộ lượt trả lời | Mọi lượt trả lời hợp lệ, kể cả các lần lặp lại. | 56.613 |
⚠️ Tập chính không đưa ra bất kỳ khẳng định nào về gợi ý hay lời giải thích. Các trườngused_hint/viewed_explanation/used_answer_keyđều mang giá trị false trong toàn bộ cơ sở dữ liệu, nhưng chỉ vì không có thành phần nào từng ghi vào chúng — không điểm ghi nhận câu trả lời nào truyền các tham số này, và sản phẩm hiện không có chức năng gợi ý trước khi trả lời hay chức năng hiện đáp án. Giá trị false cố định này là đặc tính của cách đo, không phải bằng chứng về hành vi của người học. Vì vậy, các trường này không được dùng làm điều kiện phân tích, và không có khẳng định nào về việc sử dụng gợi ý.
Kiểm chứng độc lập tập chính: khi tính lại trên máy chủ lượt trả lời sớm nhất theo từng cặp (mã định danh, câu hỏi), 99,59% lượt trả lời trong tập chính (37.094 trên 37.245) vượt qua kiểm tra lần trả lời đầu tiên. 151 lượt không vượt qua nhiều khả năng là do dùng nhiều thiết bị — cùng một người trả lời trên hai thiết bị, mỗi thiết bị đều ghi nhận một lần trả lời đầu tiên. Mọi lượt trả lời trong tập đều có attempt_number = 1.
Những gì bị loại trừ
- Các câu hỏi đã biết là bị lỗi: 520 mã câu hỏi bị loại khỏi mọi số liệu tổng hợp. Có hai nguyên nhân: (1) các câu điền chỗ trống không thuộc ngữ pháp trong tài liệu bài học (chuyển đổi kana, chính tả, đáp án dạng số) bị gắn nhầm vào trục mẫu ngữ pháp; (2) một phiên bản cũ của tính năng "câu hỏi mỗi ngày" đã dùng mã đáp án làm mã định danh câu hỏi, khiến nhiều câu hỏi khác nhau bị gộp vào cùng một mã. Phần giao diện đã được sửa; dữ liệu lịch sử được loại trừ bằng danh sách chặn. Không có lượt trả lời gốc nào bị xóa — bảng chỉ cho phép ghi thêm.
- Các lượt trả lời sau mốc chốt bản chụp: báo cáo này được cố định tại 2026-08-14T00:00:00Z. Dữ liệu vẫn tiếp tục tích lũy, nhưng mọi con số trên trang này và trong các tệp tải về đều lấy từ đúng một thời điểm cố định đó.
Cỡ ô tối thiểu
Các ô có n<30 hoặc ít hơn 5 mã định danh người học bị SUPPRESSED (ẩn): công bố số lượt trả lời nhưng không công bố tỷ lệ đúng. Các ô có n≥30 và ≥5 mã định danh nhưng n<100 được gắn cờ LOW_SAMPLE và luôn phải trích dẫn kèm n. Các ô có n≥100 và ≥5 mã định danh được gắn cờ OK.
Trong bản chụp này, 23 điểm kiến thức ở mức OK, 12 ở mức LOW_SAMPLE và 3 ở mức SUPPRESSED.
Ẩn danh hóa
- Mỗi lượt trả lời chỉ mang một UUID thiết bị ẩn danh được tạo trong trình duyệt. Không có tên, email, địa chỉ IP, dấu vân tay thiết bị hay bất kỳ nội dung nhập tự do nào.
- Cloudflare Pages Function tiếp nhận dữ liệu chỉ ghi các cột trong danh sách cho phép và được thiết kế rõ ràng để không bao giờ ghi địa chỉ IP.
- Bộ dữ liệu công khai chỉ chứa thống kê tổng hợp — không có một lượt trả lời gốc nào.
- Người học có thể từ chối việc thu thập dữ liệu tổng hợp chỉ với một cú nhấp trên trang chính sách quyền riêng tư.
10. Các giới hạn (vui lòng trích dẫn kèm các con số)
Nếu chỉ đọc một đoạn, hãy đọc đoạn này. Dữ liệu này mô tả kết quả làm bài của những người đến Nihongo to Japan để luyện tập, trên các câu hỏi của Nihongo to Japan. Nó không phải bức tranh về người học tiếng Nhật ở Đài Loan, không phải thước đo độ khó của JLPT, và không thể dùng để so sánh độ khó khách quan giữa các cấp độ.
- Thiên lệch chọn mẫu: mẫu là những người tự chọn luyện tập tại đây. Họ nhiều khả năng có động lực cao hơn người học nói chung, và có thể trẻ hơn, quen dùng công cụ trực tuyến hơn.
- Đo lặp lại: riêng mã định danh hoạt động nhiều nhất đã chiếm 3,7% tổng số câu trả lời, và mười mã định danh đứng đầu chiếm 19,4%. Trên cùng 372 mã định danh, trọng số theo lượt trả lời và trọng số theo mã định danh chênh nhau 7,04 điểm phần trăm.
- Không thể trừ trực tiếp giữa các tập phân tích: ngữ cảnh bài học và ngữ cảnh kiểm tra dựa trên hai bộ câu hỏi gần như không giao nhau (trong 5.772 câu hỏi mẫu ngữ pháp, chỉ có 6 câu xuất hiện ở cả hai), nên không thể quy chênh lệch tỷ lệ đúng giữa chúng cho một nguyên nhân duy nhất.
- Không quan sát được hành vi xem gợi ý và lời giải thích: các trường liên quan không bao giờ được ghi, nên bộ dữ liệu này hoàn toàn không đưa ra khẳng định nào về chúng.
- Độ khó câu hỏi không đồng đều: mỗi cấp độ và mỗi trục dựa trên một bộ câu hỏi khác nhau, nên tỷ lệ đúng thô không phải thước đo độ khó đã chuẩn hóa.
- Không có quy đổi tương đương bằng IRT: không có quy đổi theo lý thuyết ứng đáp câu hỏi (IRT) và không có thiết kế câu hỏi neo giữa các cấp độ, nên dữ liệu này không thể trả lời cấp độ nào khó hơn.
- Cỡ mẫu không đồng đều: số câu trả lời ở N5 nhiều hơn gấp sáu lần so với N1.
- Khoảng thời gian ngắn: chỉ 12 ngày (quy trình tổng hợp bắt đầu vận hành ngày 2026-08-02). Không thể rút ra bất kỳ xu hướng theo thời gian nào từ dữ liệu này.
- Không nhận diện được lưu lượng tự động: không có cơ chế phân biệt người thật với script. Thời gian trả lời bị trống (null) ở 94% lượt trả lời, nên ngay cả bộ lọc cơ bản kiểu "trả lời nhanh đến mức không thể" cũng không áp dụng được. Đây là một thiếu sót đã biết về chất lượng dữ liệu.
- Không đại diện cho tổng thể: dữ liệu không đại diện cho toàn bộ người học tiếng Nhật ở Đài Loan hay ở bất kỳ quốc gia nào khác.
11. Cách trích dẫn
Chúng tôi hoan nghênh việc trích dẫn trong bài báo khoa học, báo cáo nghiên cứu, tài liệu giảng dạy và báo chí. Vui lòng ghi nguồn kèm liên kết dẫn về trang này.
APA (7th)
Nihongo to Japan. (2026). Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/en/research/japanese-learning-data-2026MLA (9th)
Nihongo to Japan. Japanese Learning Answer Dataset — August 2026. Version 1.1.0, 2026, https://www.nihongotojapan.com/en/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/en/research/japanese-learning-data-2026}

}
Tình trạng giấy phép
Dữ liệu được phát hành theo giấy phép CC BY 4.0: được tự do sử dụng, kể cả cho mục đích thương mại, miễn là ghi nguồn. Biểu đồ và văn bản của báo cáo không thuộc phạm vi giấy phép này. Điều khoản đầy đủ xem tại phần Giấy phép.
Chuỗi ghi nguồn đề xuất:
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Giấy phép: dữ liệu theo CC BY 4.0
Dữ liệu trong bộ dữ liệu này được phát hành theo giấy phép Creative Commons Attribution 4.0 International (CC BY 4.0). Bạn được sao chép, phân phối lại, chỉnh sửa và phát triển tiếp dựa trên dữ liệu, kể cả cho mục đích thương mại, miễn là ghi nguồn phù hợp và nêu rõ nếu có thay đổi.
⚠️ Giấy phép chỉ áp dụng cho dữ liệu. Phạm vi của CC BY 4.0 gồm: các số liệu tổng hợp trên trang này và hai tệp có thể tải về làjapanese-learning-2026.jsonvàjapanese-learning-2026.csv. Các biểu đồ do Nihongo to Japan thực hiện (SVG/PNG) và văn bản của báo cáo không thuộc phạm vi giấy phép và vẫn được bảo lưu mọi quyền.
Những việc bạn có thể làm mà không cần hỏi chúng tôi
- Trích dẫn số liệu thống kê trong bài báo khoa học, báo cáo nghiên cứu, tài liệu giảng dạy và báo chí, kể cả ấn phẩm thương mại.
- Phân tích lại các số liệu tổng hợp và tự vẽ biểu đồ của riêng bạn — biểu đồ bạn vẽ là của bạn.
- Chỉnh sửa, phối trộn, biến đổi và phân phối lại dưới mọi hình thức, kể cả phân phối lại nguyên vẹn các tệp dữ liệu hoặc đưa chúng vào sản phẩm dữ liệu của riêng bạn.
- Sử dụng dữ liệu trong lớp học và môi trường giáo dục.
Ghi nguồn
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Những điều chúng tôi mong muốn (không phải điều kiện của giấy phép)
Những điều sau không phải là điều kiện của CC BY, và bỏ qua chúng không phải là vi phạm. Dù vậy, chúng tôi vẫn đề nghị, kèm lý do cho từng điều:
- Nêu kèm các giới hạn về lấy mẫu (mẫu quan sát tự chọn, chỉ 12 ngày, không đại diện) — trích dẫn con số mà không có các giới hạn này là công bố một số liệu thống kê gây hiểu lầm.
- Đặt liên kết dẫn về trang này — để độc giả của bạn xem được phương pháp và phiên bản.
- Viết "mã định danh người học", không viết "người" — số mã định danh là giới hạn trên của số người, không phải số người thực tế.
- Nêu rõ phiên bản (ví dụ v1.1.0, bản chụp 2026-08-14) — để các con số bạn đã trích dẫn vẫn xác định được sau những lần cập nhật sau này.
Những gì giấy phép không bao gồm
- Các biểu đồ do chúng tôi thực hiện (
/images/research/*.svgvà*.png): vui lòng liên hệ với chúng tôi trước khi sử dụng lại. Tự vẽ biểu đồ từ dữ liệu thì không cần xin phép. - Văn bản của báo cáo và của trang web này: bảo lưu mọi quyền.
- Tên trang web, logo và các dấu hiệu thương hiệu: giấy phép này không cấp bất kỳ quyền sử dụng nào đối với chúng.
⚠️ CC BY là giấy phép không thể thu hồi. Bất kỳ ai nhận dữ liệu theo các điều khoản này đều giữ nguyên các quyền đó ngay cả khi sau này chúng tôi thay đổi điều khoản. Chúng tôi nêu rõ điều này vì bất kỳ ai trích dẫn dữ liệu đều có quyền biết sự cho phép của mình ổn định đến mức nào.
12. Tải dữ liệu
Hai định dạng có nội dung giống hệt nhau, đều chỉ gồm thống kê tổng hợp (không có lượt trả lời gốc):
- japanese-learning-2026.json — đầy đủ siêu dữ liệu, định nghĩa, phương pháp, các giới hạn và mọi ô tổng hợp.
- japanese-learning-2026-LICENSE.txt — thông báo giấy phép (CC BY 4.0, phạm vi, chuỗi ghi nguồn). Tệp CSV không có chỗ để chứa thông tin này, nên tệp được cung cấp kèm theo.
- japanese-learning-2026.csv — mỗi ô một dòng. Các cột:
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag.
Phiên bản 1.1.0 · bản chụp 2026-08-14 · phiên bản phương pháp 1.1. Các bản cập nhật sau sẽ tăng số phiên bản và giữ lại các số liệu cũ thay vì ghi đè lên chúng.
Tệp biểu đồ: cả bốn biểu đồ trên trang này đều có ở định dạng PNG (độ phân giải 2×, dùng cho trình chiếu và dàn trang in) và SVG (dạng vector, phóng to không vỡ).
- Tỷ lệ đúng thô theo trục học tập: PNG・SVG
- Tỷ lệ đúng thô theo cấp độ JLPT: PNG・SVG
- Các điểm kiến thức có tỷ lệ đúng thấp nhất: PNG・SVG
- Phân bố mẫu: PNG・SVG
Mỗi biểu đồ đều mang tiêu đề, n, phiên bản và nhãn nguồn của riêng nó, nên khi được dùng riêng lẻ vẫn tự nêu rõ phạm vi của mình; văn bản thay thế (alt text) của cả bốn biểu đồ được tập hợp trong alt-text.json. ⚠️ Các biểu đồ không thuộc phạm vi CC BY, vì vậy vui lòng liên hệ với chúng tôi trước khi sử dụng lại (xem phần liên hệ); bản thân dữ liệu theo CC BY 4.0 và được tự do sử dụng khi ghi nguồn (xem Giấy phép).
⚠️ Khi trích dẫn, hãy dùng bộ dữ liệu đã cố định có đánh số phiên bản, thay vì endpoint tổng hợp được làm mới định kỳ.
Ngoài ra còn có một endpoint tổng hợp được làm mới định kỳ tại /api/aggregates; các con số của nó thay đổi theo thời gian (không phải một phiên bản cố định). Endpoint này dùng các định nghĩa khác: tính trên toàn bộ lượt trả lời thay vì lần trả lời đầu tiên ở ngữ cảnh kiểm tra, và trường totalUsers của nó chỉ đếm các mã định danh người học trong tập chính (688) chứ không phải toàn bộ 1.053. Các con số của nó thay đổi hằng ngày và không phù hợp để trích dẫn.
Dành cho nhà báo
- Mẫu: 56.613 câu trả lời ẩn danh từ 1.053 mã định danh người học ẩn danh (không phải số người đã được xác minh) trong 12 ngày, từ 2 đến 13 tháng 8 năm 2026.
- Phương pháp trong một câu: tỷ lệ đúng thô trên một mẫu quan sát tự chọn; các con số chính dùng tập lần trả lời đầu tiên ở ngữ cảnh kiểm tra (lần trả lời đầu tiên trong các ngữ cảnh thử thách, kiểm tra xếp lớp và luyện tập chuyên đề).
- Giới hạn trong một câu: đây không phải khảo sát đại diện cho người học tiếng Nhật, và không thể dùng để so sánh độ khó khách quan giữa các cấp độ JLPT.
Ba con số có thể trích dẫn trực tiếp:
- Tỷ lệ đúng ở mẫu ngữ pháp 53,7% (n=8.678) so với từ vựng 92,1% (n=22.869) — chênh lệch 38 điểm.
- Trợ từ が được trả lời đúng 60,9% (n=358); を đạt 78,7% (n=385).
- Tỷ lệ đúng ở mẫu ngữ pháp dao động từ 53,7% đến 74,1% tùy theo những ngữ cảnh trả lời nào được tính (ngữ cảnh bài học 85,4%, ngữ cảnh kiểm tra 53,7%). ⚠️ Hai ngữ cảnh dùng hai bộ câu hỏi gần như không giao nhau nên không thể xác định nguyên nhân — nhưng chính điều đó đã là một câu chuyện về cách dữ liệu từ nền tảng học tập bị trích dẫn.
Định dạng trích dẫn · Tải dữ liệu · Liên hệ
Nhúng dữ liệu này (dán vào bài blog hoặc tài liệu giảng dạy)
Dán đoạn HTML dưới đây vào bài viết hoặc tài liệu phát tay của bạn. Đoạn này đã kèm sẵn cỡ mẫu, phiên bản, giấy phép và lưu ý "không đại diện cho tổng thể" — đúng những phần thường bị bỏ sót khi số liệu thống kê được trích dẫn lại qua nhiều tầng. Không cần báo trước với chúng tôi.
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">Trên 56,613 câu trả lời ẩn danh, tỷ lệ đúng ở mẫu ngữ pháp trong các lần trả lời đầu tiên ở ngữ cảnh kiểm tra là <strong>53.7%</strong> (n=8,678), so với <strong>92.1%</strong> ở từ vựng (n=22,869).</p><p style="margin:0;font-size:13px;color:#8a7a68">Nguồn: <a href="https://www.nihongotojapan.com/en/research/japanese-learning-data-2026">Nihongo to Japan, Japanese Learning Answer Dataset — August 2026</a> v1.1.0 · CC BY 4.0 · mẫu quan sát tự chọn, không đại diện cho tổng thể</p></blockquote>
Vì sao lại là một khối có thể dán, mà không phải iframe? Có hai lý do: trang web này không cho phép bị nhúng khung (frame-ancestors 'none' trên toàn trang, một biện pháp chống clickjacking mà chúng tôi muốn giữ); và nội dung trong iframe được phục vụ từ tên miền của chúng tôi, nên không được tính là một liên kết do trang của bạn đưa ra — còn khối được dán thì có. Bạn cũng hoàn toàn có thể tự trình bày: dữ liệu theo CC BY 4.0, nên chúng tôi chỉ cần bạn ghi nguồn.
Về hình ảnh: các biểu đồ của chúng tôi không thuộc phạm vi giấy phép, nhưng bạn có thể tự vẽ biểu đồ từ CSV và biểu đồ đó là của bạn. Nếu muốn dùng biểu đồ của chúng tôi cho mục đích giảng dạy hoặc truyền thông, xem bộ tài liệu báo chí.
Bộ tài liệu báo chí
Mọi nội dung trong phần này đều có thể sao chép và sử dụng mà không cần hỏi trước (trừ các biểu đồ — xem bên dưới). Thông tin nhanh và ba con số có thể trích dẫn trực tiếp nằm ở phần Dành cho nhà báo; bộ đầy đủ nằm ở mười phát hiện có thể trích dẫn.
Đoạn giới thiệu chuẩn
Bản dài:
Nihongo to Japan là một trang web học tiếng Nhật do một nhà phát triển cá nhân vận hành độc lập. Trang không yêu cầu đăng ký, toàn bộ khóa học miễn phí vĩnh viễn, và bao quát JLPT từ N5 đến N1 qua các bài giải thích ngữ pháp, bài học tự học và câu hỏi luyện tập. Bộ dữ liệu này được lấy từ các bản ghi câu trả lời ẩn danh do người học tạo ra trên trang, được tổng hợp từ một bản chụp dữ liệu đã cố định và công bố kèm đầy đủ phương pháp cùng các giới hạn.
Bản ngắn:
Nihongo to Japan, một trang web học tiếng Nhật vận hành độc lập với toàn bộ khóa học luôn miễn phí, công bố bộ dữ liệu tổng hợp từ các câu trả lời ẩn danh của người học trên trang.
Hình ảnh dùng để đăng tải
Các biểu đồ do chúng tôi thực hiện không thuộc phạm vi CC BY 4.0 (giấy phép chỉ áp dụng cho dữ liệu — xem Giấy phép). Chúng tôi không muốn điều đó trở thành trở ngại, nên có hai cách:
- Hỏi chúng tôi: chúng tôi gửi tệp hình ảnh sẵn sàng để đăng tải trong vòng 24 giờ (PNG và SVG), kèm chú thích, cỡ mẫu và nhãn phiên bản chính xác. Đây là kênh ưu tiên dành cho hình ảnh, nhanh hơn các yêu cầu thông thường (2–3 ngày làm việc).
- Hoặc không cần chờ — tự vẽ. Bản thân dữ liệu theo CC BY 4.0, nên bạn có thể dựng biểu đồ của riêng mình trực tiếp từ JSON hoặc CSV. Biểu đồ bạn vẽ là của bạn: không cần xin phép, cũng không cần báo cho chúng tôi.
Bốn lưu ý để đưa tin có trách nhiệm
Đây không phải điều kiện — chúng có mặt ở đây để bạn không phải đăng đính chính về sau:
- ✅ Hãy viết "trong tập câu trả lời này" hoặc "trong lần trả lời đầu tiên ở các câu hỏi kiểm tra". Mọi con số trên trang này đều là giá trị quan sát được trong bộ dữ liệu này.
- ❌ Đừng biến nó thành "người học Đài Loan thế này thế kia". Mẫu là những người tự chọn luyện tập trên trang này; nó không đại diện cho bất kỳ tổng thể rộng hơn nào.
- ❌ Đừng so sánh độ khó giữa các cấp độ JLPT. Các cấp độ dựa trên những bộ câu hỏi khác nhau, không có quy đổi tương đương bằng IRT, và khoảng tin cậy của N3 và N2 chồng lên nhau — dữ liệu này không thể phân biệt hai cấp độ đó.
- ❌ Đừng diễn đạt theo quan hệ nhân quả. Dữ liệu có thể nói "quan sát thấy cùng xuất hiện"; nó không thể nói "bởi vì".
Nếu bạn không chắc một cách diễn đạt cụ thể có đứng vững hay không, cứ hỏi chúng tôi — đỡ tốn kém hơn nhiều so với đính chính sau khi đã đăng.
Trích dẫn phát biểu có ghi tên
Cả hai phát biểu dưới đây đều có thể sử dụng trực tiếp, không cần hỏi.
"Ở lần trả lời đầu tiên với các câu hỏi kiểm tra, từ vựng đạt 92,1% còn mẫu ngữ pháp chỉ 53,7%. Con số này chỉ mô tả những người đã chọn luyện tập trên trang của chúng tôi; nó không khái quát được cho người học nói chung. Nhưng nếu bạn đang mắc kẹt ở chỗ 'biết từ rồi mà vẫn không ghép được thành câu', thì bạn không đơn độc đâu."
— Nhà sáng lập, Nihongo to Japan
"Trên cùng một dữ liệu, chỉ cần thay đổi việc tính những câu trả lời nào là tỷ lệ đúng ở mẫu ngữ pháp đã chuyển từ 53,7% lên 85,4%. Chúng tôi công bố cả bốn định nghĩa cạnh nhau, vì một con số tiêu đề duy nhất không cho người đọc cách nào biết mình đang nhìn vào con số nào."
— Nhà sáng lập, Nihongo to Japan
Không có nhóm nghiên cứu và không có người phụ trách truyền thông. Các phát biểu trên được ghi tên người thực sự đã xây dựng bộ dữ liệu này; nếu cần phản hồi cho một câu hỏi cụ thể, vui lòng dùng phần liên hệ.
Dành cho nhà nghiên cứu và nhà giáo dục
Cấu trúc: mỗi ô tổng hợp một dòng, được đánh chỉ mục theo dimension (axis / jlpt / knowledge_point / axis_x_jlpt) × analysis_set (quiz_first_attempt / lesson_first_attempt / first_attempt / all_events). Mỗi ô báo cáo n, learners, accuracy, ci95_low/ci95_high theo Wilson và một flag. Tệp JSON còn có thêm phần phân rã theo tập phân tích, phép so sánh cặp và hiệu ứng trọng số.
Lấy mẫu: tự chọn và mang tính quan sát; đơn vị phân tích là lượt trả lời; mã định danh người học là một UUID ẩn danh, nên số mã định danh là giới hạn trên của số người (cùng một người trên hai thiết bị tạo ra hai mã định danh, và các mã định danh không thể liên kết với nhau).
Những thiếu sót đã biết về phương pháp — chúng tôi cho rằng nên nói rõ thay vì che giấu:
- Không có quy đổi tương đương độ khó bằng IRT và không có câu hỏi neo giữa các cấp độ, nên các phép so sánh giữa cấp độ không đứng vững.
- Ngữ cảnh bài học và ngữ cảnh kiểm tra dựa trên hai bộ câu hỏi gần như không giao nhau (trong 5.772 câu hỏi mẫu ngữ pháp chỉ có 6 câu trùng), nên không thể tách ảnh hưởng của ngữ cảnh khỏi độ khó câu hỏi.
- Các trường gợi ý / giải thích / xem đáp án không bao giờ được ghi, nên các hành vi đó là không quan sát được. Chúng không thể dùng làm điều kiện phân tích, và việc không có dữ liệu không thể hiểu là "đã không xảy ra".
- Thời gian trả lời bị trống (null) ở 94% lượt trả lời, nên không thể phân tích đánh đổi giữa tốc độ và độ chính xác, cũng không thể lọc các câu trả lời nhanh bất thường.
- Không có biến nhân khẩu học (tuổi, tiếng mẹ đẻ, số năm học, quốc gia), nên không thể phân tích phân tầng. Bộ dữ liệu không có trường tiếng mẹ đẻ và không có trường địa lý, nên báo cáo này không đưa ra suy luận nào về tiếng mẹ đẻ hay nơi ở của người học.
- Khoảng thời gian 12 ngày, nên không có đường cong học tập và không có phân tích ghi nhớ.
- Dữ liệu ở cấp người học không được công bố (chỉ có số liệu tổng hợp), nên không thể ước lượng lại mô hình đa cấp từ bên ngoài. Nếu điều này quan trọng với nghiên cứu của bạn, vui lòng liên hệ.
Tải JSON · Tải CSV · Định dạng trích dẫn · Phương pháp đầy đủ
Liên hệ truyền thông và dữ liệu
Nhà sáng lập, Nihongo to Japan · Email: [email protected]
Chúng tôi sẵn lòng trả lời: chi tiết phương pháp, kiểm tra lại bất kỳ số liệu tổng hợp nào, yêu cầu sử dụng lại biểu đồ, giới hạn của những gì dữ liệu này có thể chứng minh, và liệu bộ dữ liệu có trả lời được một câu hỏi cụ thể hay không. Thường phản hồi trong vòng 2–3 ngày làm việc; yêu cầu hình ảnh sẵn sàng đăng tải từ phía truyền thông được ưu tiên, phản hồi trong vòng 24 giờ (xem bộ tài liệu báo chí).
Trang web do một nhà phát triển cá nhân vận hành độc lập. Không có nhóm nghiên cứu và không có người phụ trách truyền thông — địa chỉ trên dẫn thẳng đến người thực sự đã xây dựng bộ dữ liệu này, không phải một bộ phận tiếp nhận. Chúng tôi nêu rõ điều này vì bất kỳ ai trích dẫn dữ liệu đều có quyền biết ai đứng sau nó.
Phiên bản và nhật ký thay đổi
URL này luôn trỏ đến bản chụp mới nhất. Mỗi bản phát hành đều có số phiên bản và ngày cố định, vì vậy vui lòng ghi kèm phiên bản khi trích dẫn (ví dụ: v1.1.0, bản chụp 2026-08-14) — khi số liệu được cập nhật về sau, phiên bản bạn đã trích dẫn vẫn xác định được. Các tệp tải về JSON và CSV cũng mang cùng các trường phiên bản.
| Phiên bản | Ngày cố định bản chụp | Phạm vi | Ghi chú |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 đến 10-21 (81 ngày) | Bản phát hành mới hơn, có URL riêng (tập phân tích khác). |
| v1.1.0 | 2026-08-14 | Từ 2 đến 13 tháng 8 năm 2026 (12 ngày) | Bản phát hành công khai đầu tiên. Tập phân tích chính: lần trả lời đầu tiên ở ngữ cảnh kiểm tra; cả bốn tập phân tích được công bố cạnh nhau. |
Bản phát hành tiếp theo dự kiến ra mắt sau khoảng ba tháng thu thập thêm dữ liệu — đó là thời điểm sớm nhất có thể bàn đến bất kỳ xu hướng nào. Việc cập nhật dữ liệu sẽ không viết lại số liệu của một phiên bản đã công bố: bản phát hành mới sẽ có số phiên bản mới và ngày cố định mới, và các số liệu trước đó vẫn xác định được qua phiên bản của chúng. Nếu bạn đã trích dẫn một phiên bản và số liệu của nó thay đổi, hãy viết cho chúng tôi, chúng tôi sẽ cho bạn biết chính xác những gì khác đi.
← Quay lại Nghiên cứu và dữ liệu | Người Đài Loan học tiếng Nhật thế nào trong năm 2026 | Dành cho nhà giáo dục và thư viện