Bộ dữ liệu câu trả lời học tiếng Nhật — tháng 10 năm 2026: 543.344 câu trả lời, độ khó hiệu chỉnh theo năng lực và khoảng cách ôn tập
Tóm gọn trong một câu: số liệu thống kê tổng hợp từ 543.344 lượt trả lời ẩn danh trên Nihongo to Japan, trong giai đoạn từ ngày 2 tháng 8 đến ngày 21 tháng 10 năm 2026 (81 ngày), trên 25.850 câu hỏi — gấp 9,6 lần quy mô của bản phát hành tháng 8 (v1.1.0).
⚠️ v2 và v1 dùng các tập phân tích khác nhau. Đừng lấy tỷ lệ đúng của bản phát hành này trừ cho tỷ lệ đúng của bản kia. v1 được tính trực tiếp từ cơ sở dữ liệu, với tập chính là “lần trả lời đầu tiên trong ngữ cảnh bài kiểm tra”. v2 cố ý chỉ dùng các endpoint tổng hợp công khai mà bất kỳ ai cũng truy vấn được (/api/aggregates,/api/community), nên các thước đo chính của nó là “toàn bộ câu trả lời” và “lần trả lời đầu tiên ở cấp câu hỏi, mỗi câu hỏi một phiếu”. Lợi ích là khả năng tái lập: sha256 của từng tệp đầu vào được ghi lại trong tệp tải về, nên các nhà nghiên cứu bên ngoài có thể kiểm chứng chính xác chúng mình đã dùng dữ liệu nào. Xem phần Phương pháp.
Bộ dữ liệu này không phải là gì. Đây không phải một khảo sát mang tính đại diện về người học tiếng Nhật. Mẫu gồm những người tự chọn luyện tập trên trang web này — một mẫu quan sát, tự chọn. Mọi con số chỉ mô tả những gì đã diễn ra trong nhật ký trả lời của NTJ; không con số nào được khái quát hóa cho một tổng thể, và không con số nào là một khẳng định nhân quả. Xem phần Giới hạn.
Mười phát hiện có thể trích dẫn
Mỗi mục đều đứng độc lập: nêu rõ bộ dữ liệu, giai đoạn, cỡ mẫu và tập phân tích, nên có thể trích dẫn riêng lẻ. Vui lòng trích dẫn kèm phần giới hạn.
- Bộ dữ liệu câu trả lời học tiếng Nhật của NTJ (tháng 10 năm 2026, v2.0.0) gồm 543.344 lượt trả lời ẩn danh trên 25.850 câu hỏi, ghi nhận từ ngày 2 tháng 8 đến ngày 21 tháng 10 năm 2026 — gấp 9,6 lần con số 56.613 lượt trong bản phát hành tháng 8 năm 2026 của trang.
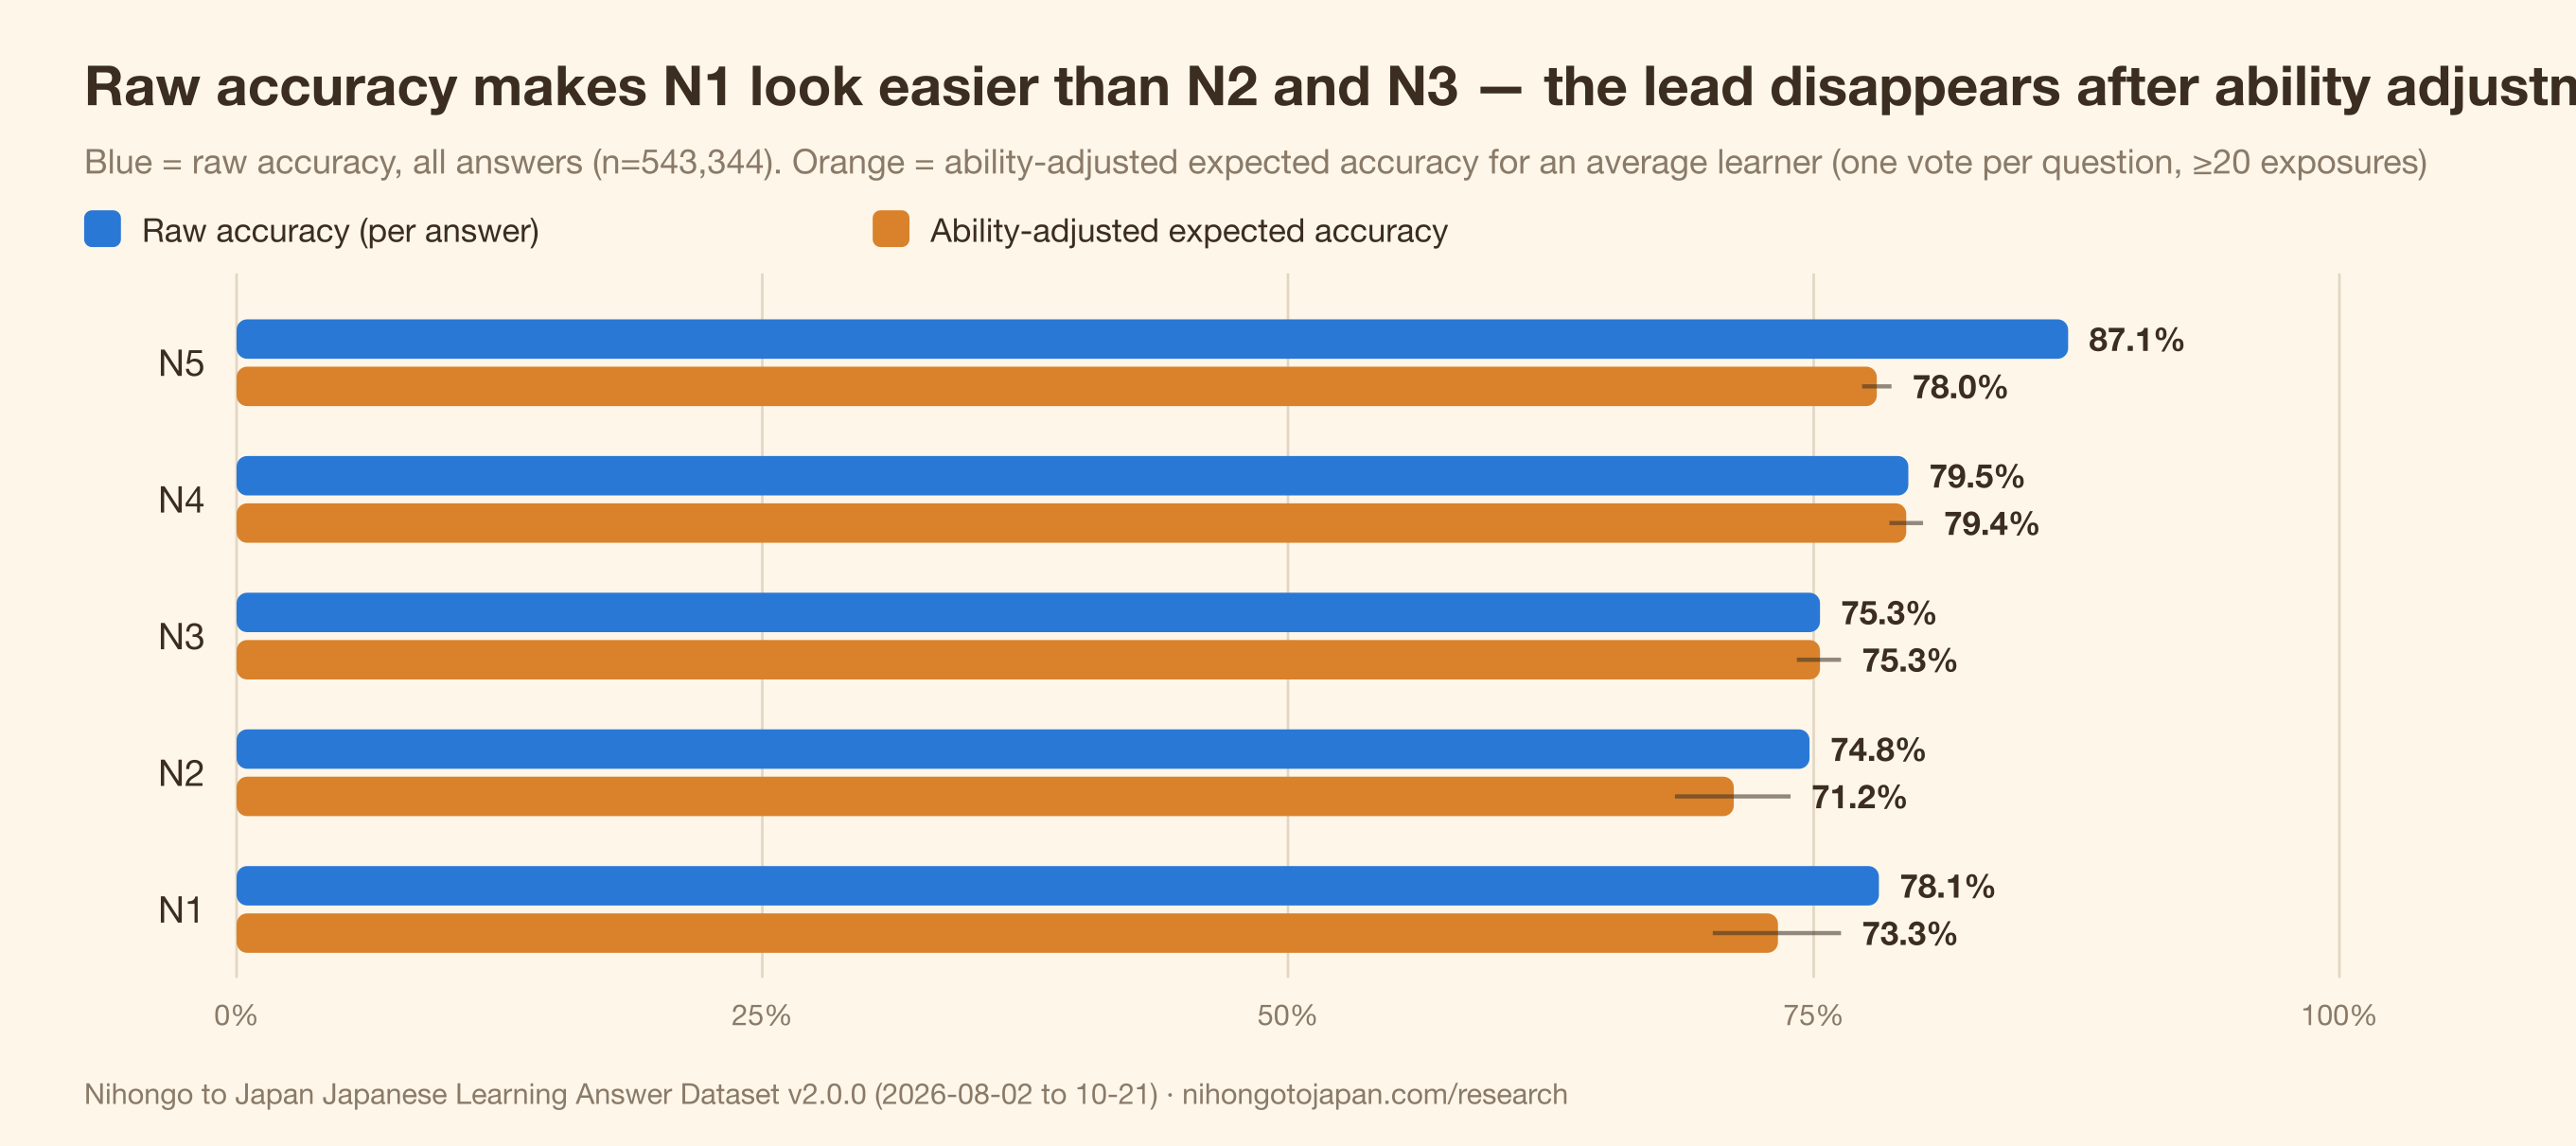
- Xét toàn bộ câu trả lời trong cùng bộ dữ liệu, tỷ lệ đúng thô theo cấp độ JLPT là N5 87,1%, N4 79,5%, N3 75,3%, N2 74,8% và N1 78,1% (n=33.082) — N1 cao hơn cả N2 lẫn N3.
- Sau khi loại bỏ ảnh hưởng của năng lực người học bằng ước lượng Rasch một bước (mỗi câu hỏi một phiếu, ≥20 lượt xuất hiện), tỷ lệ đúng kỳ vọng của một người học có năng lực trung bình là N3 75,3% (KTC 95% 74,2–76,3%, 847 câu hỏi), N1 73,3% (70,2–76,3%, 210 câu hỏi) và N2 71,2% (68,4–73,9%, 204 câu hỏi). Lợi thế của N1 so với N3 biến mất, phù hợp với một hiệu ứng chọn lọc, trong đó chính những người học giỏi hơn mới là người làm các câu hỏi N1.
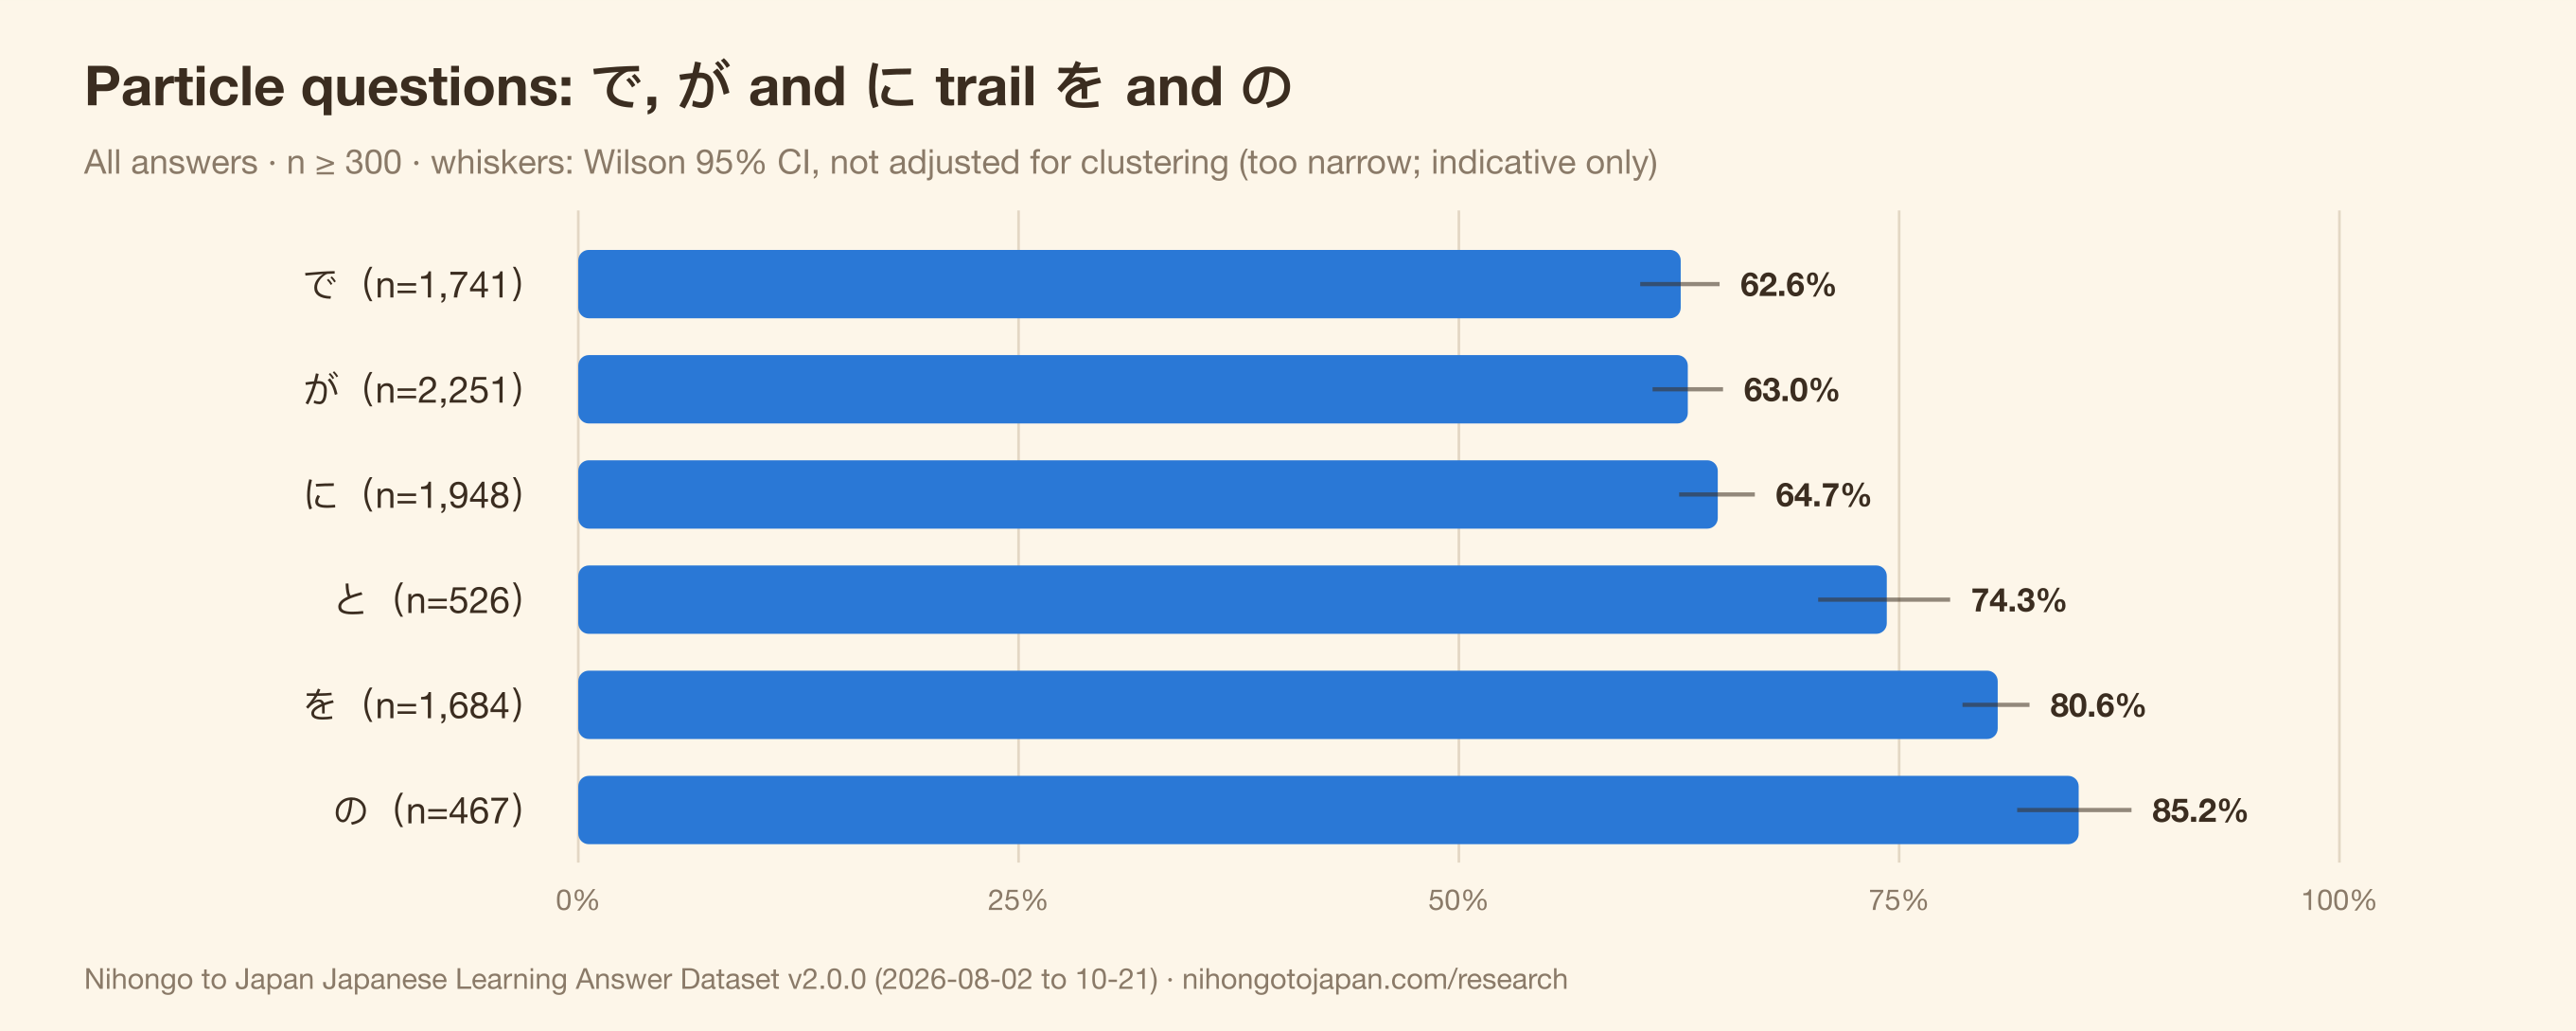
Khoảng tin cậy sau hiệu chỉnh của N1 và N3 chồng lấn nhau, nên điều này không cho thấy N1 khó hơn N3 — chỉ cho thấy thứ tự thô là không đáng tin. - Xét toàn bộ câu trả lời, các trợ từ có tỷ lệ đúng thấp nhất là で 62,6% (n=1.741), が 63,0% (n=2.251) và に 64,7% (n=1.948); cao nhất là を 80,6% (n=1.684) và の 85,2% (n=467) — chênh lệch 22,6 điểm giữa で và の.
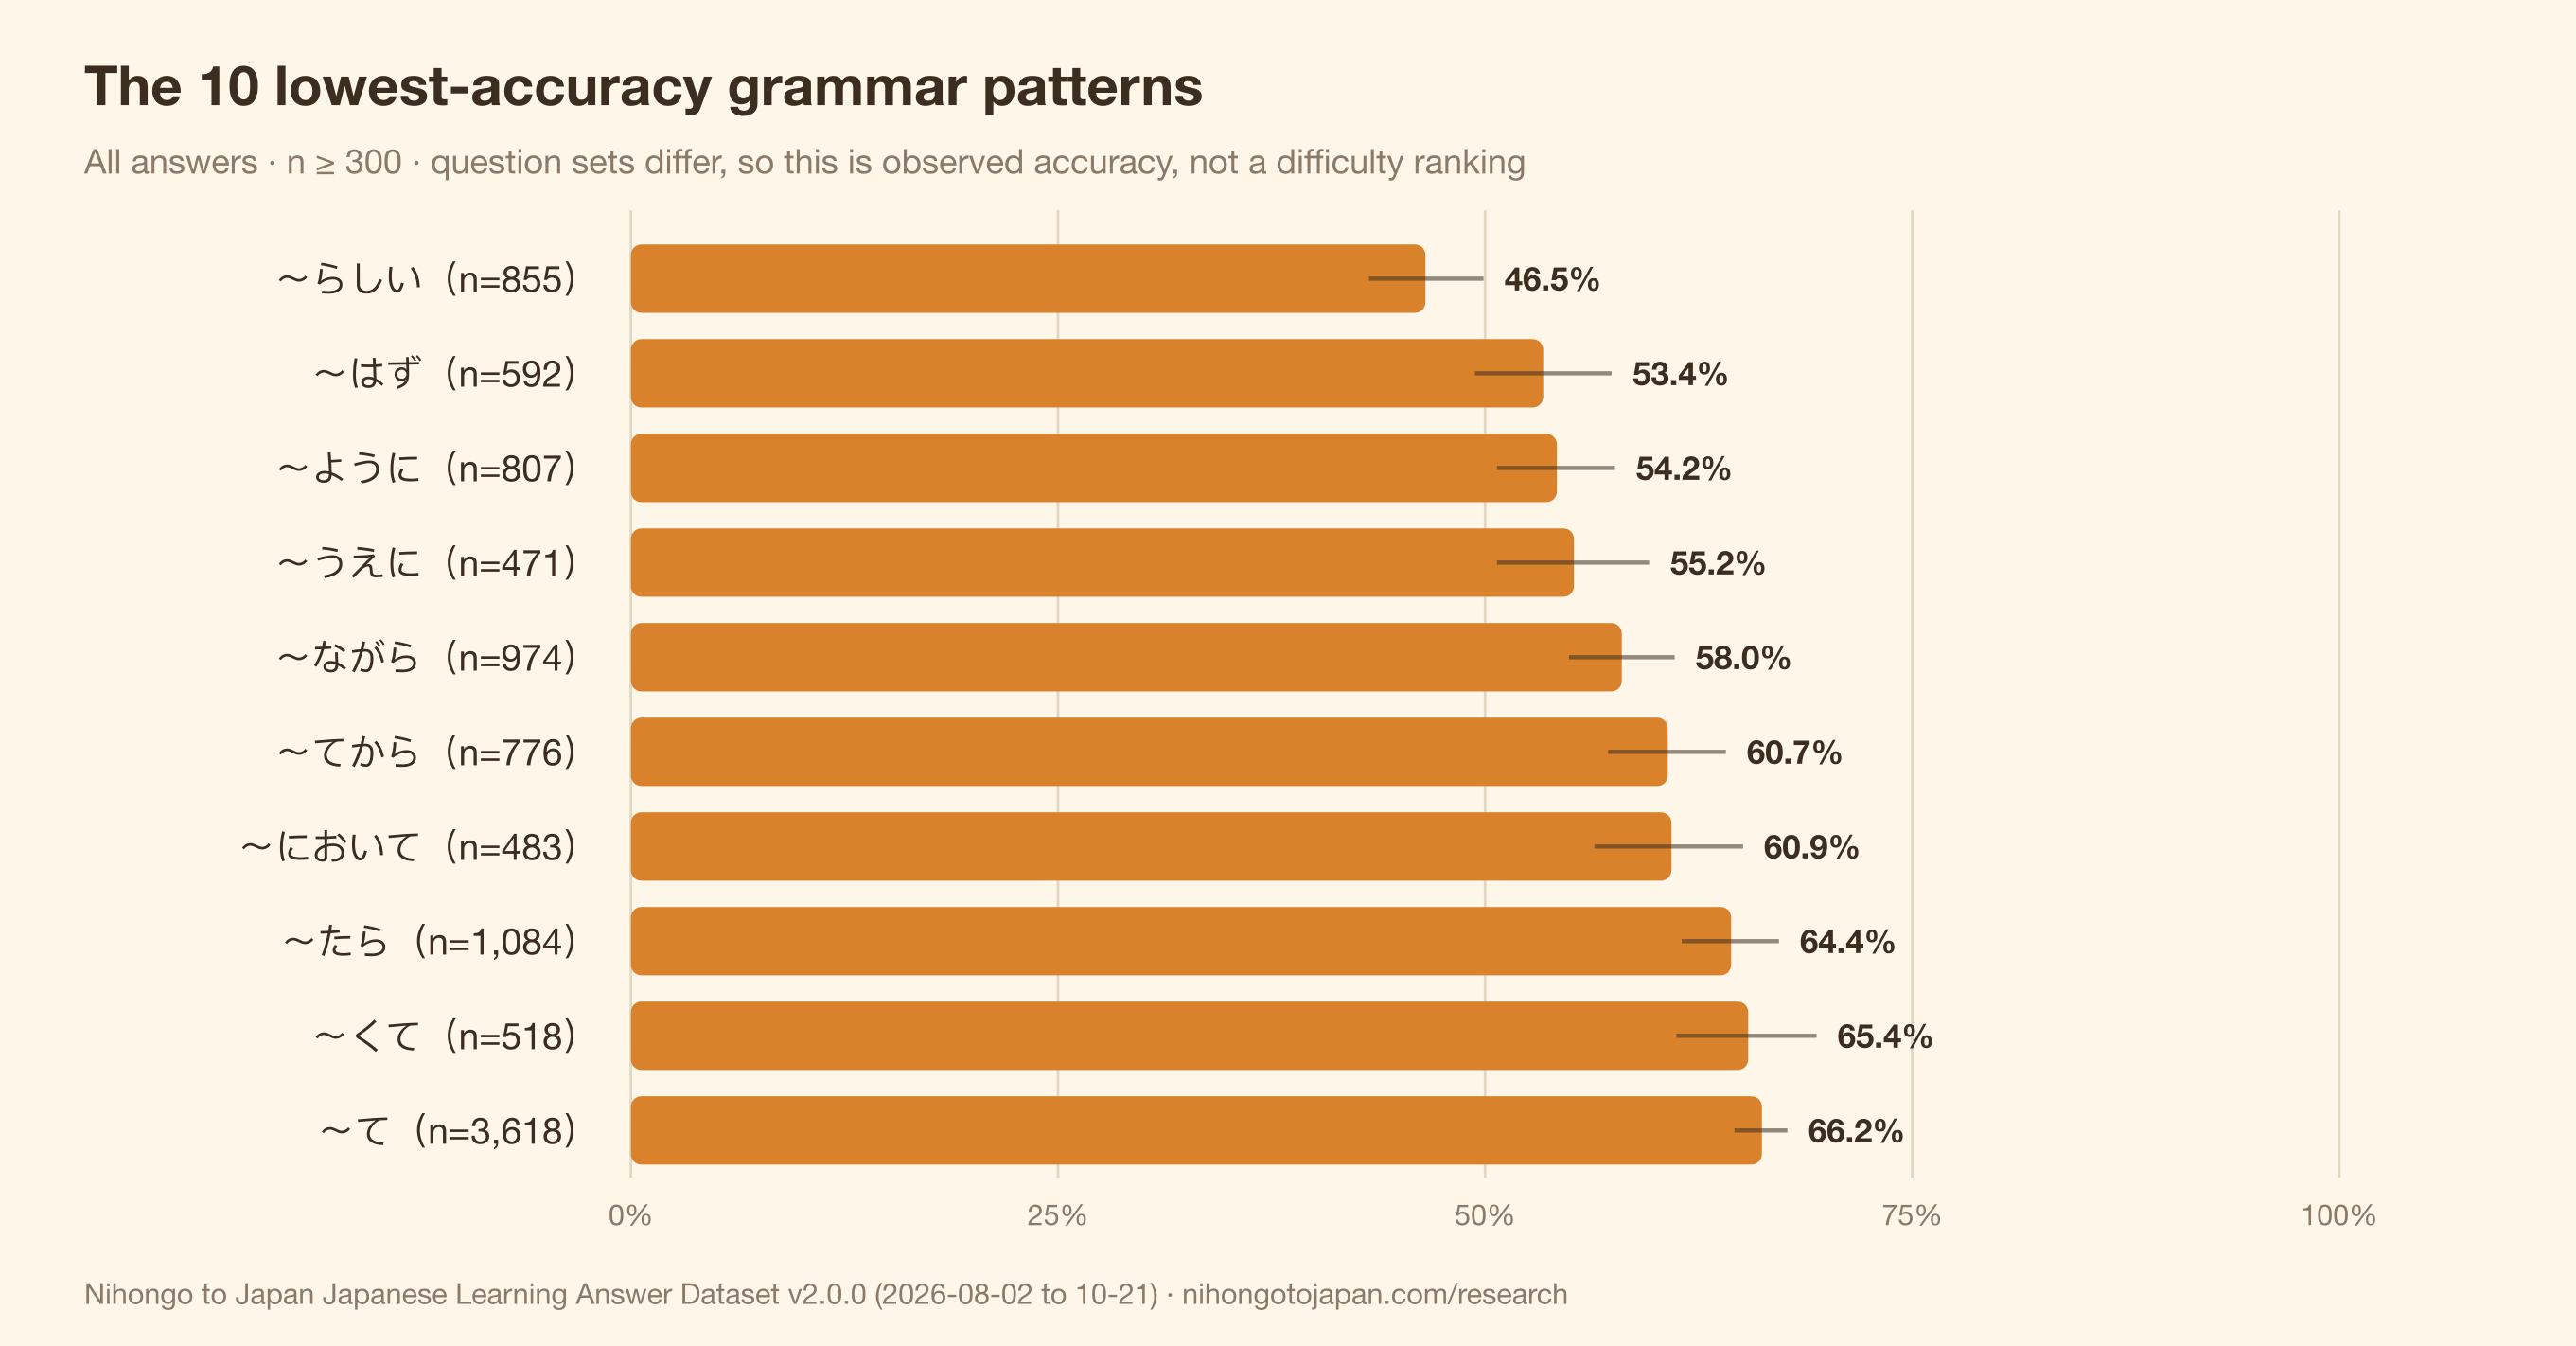
- Trong các mẫu ngữ pháp có n ≥ 300, tỷ lệ đúng tính trên toàn bộ câu trả lời thấp nhất thuộc về 〜らしい 46,5% (n=855), tiếp theo là 〜はず 53,4% (n=592), 〜ように 54,2% (n=807), 〜うえに 55,2% (n=471) và 〜ながら 58,0% (n=974).
- Trong các câu hỏi về dạng động từ, thể khả năng có tỷ lệ đúng thấp nhất, 64,5% (n=1.923), thể ます cao nhất với 84,0% (n=2.270), còn thể た 70,7%, thể て 74,1% và thể ない 75,0% nằm ở giữa.
- Tính mỗi câu hỏi một phiếu (7.057 câu hỏi có ≥20 lượt xuất hiện), tỷ lệ đúng trung bình ở lần trả lời đầu tiên là 89,1% với từ vựng (KTC 95% 88,7–89,5%), 73,9% với mẫu ngữ pháp (73,1–74,7%) và 67,6% với trợ từ (64,9–70,4%).
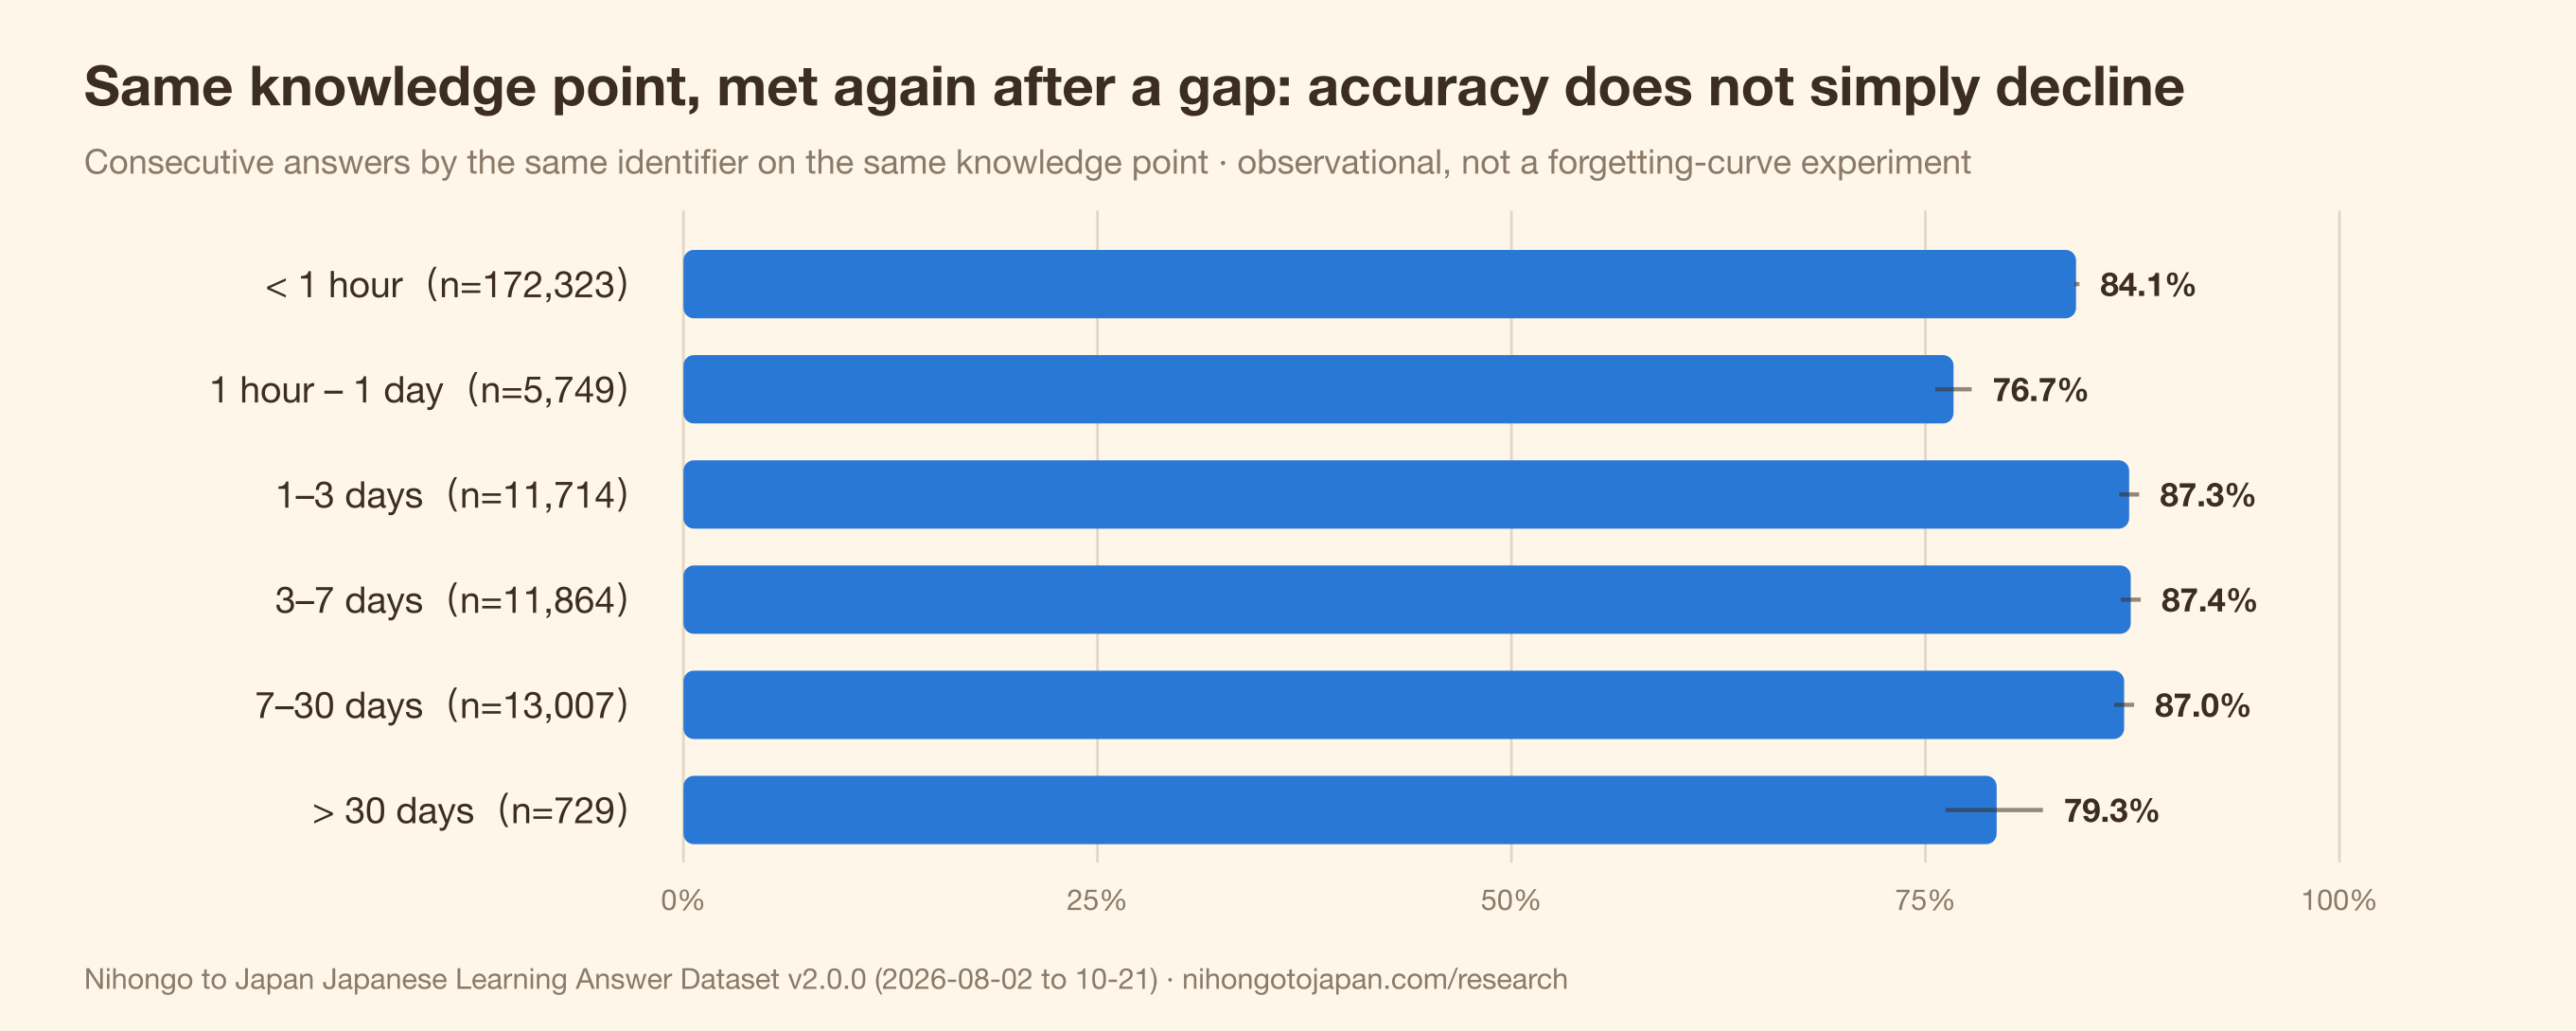
- Với các câu trả lời liên tiếp của cùng một mã định danh trên cùng một điểm kiến thức, tỷ lệ đúng là 84,1% khi khoảng cách dưới một giờ, 76,7% khi cách 1 giờ – 1 ngày, 87,0–87,4% khi cách 1–3, 3–7 và 7–30 ngày, và 79,3% khi cách trên 30 ngày (n=729). Tỷ lệ đúng không giảm đơn điệu theo khoảng cách.
Đây là dữ liệu quan sát: ai quay lại sau vài ngày không phải là ngẫu nhiên. Điều này không cho thấy ôn lại sau vài ngày là hiệu quả nhất. - Trong 7.057 câu hỏi có ≥20 lượt xuất hiện, 283 câu (4,0%) có tỷ lệ đúng ở lần trả lời đầu tiên dưới 35% (đoán ngẫu nhiên với bốn lựa chọn cho khoảng 25%). Một nguyên nhân thường gặp là có thêm một lựa chọn thứ hai cũng có thể bảo vệ được; các câu hỏi này đang nằm trong hàng đợi rà soát thủ công.
- Mô hình dự đoán câu trả lời v2 của trang đạt điểm Brier 0,199 trên 257.010 câu trả lời, thấp hơn 51,4% so với 0,409 của v1 — nhưng vẫn kém hơn mức 0,161 của một đường cơ sở hằng số luôn dự đoán tỷ lệ đúng chung là 79,9%. Chỉ phiên bản có thêm độ khó ở cấp câu hỏi (0,130) mới vượt được đường cơ sở.
1. Năm phát hiện chính
1. “N1 dễ hơn N3” là ảo giác do chọn lọc tạo ra
Xét tỷ lệ đúng thô trên toàn bộ câu trả lời, N1 (78,1%) vượt N3 (75,3%) và N2 (74,8%). Điều đó khó hợp lý, và v1 cũng thấy hiện tượng tương tự. Lời giải thích khả dĩ nhất là ai là người trả lời: những người bấm vào câu hỏi N1 vốn đã giỏi hơn.
v2 tính lại bằng độ khó đã hiệu chỉnh theo năng lực: kết quả quan sát được của mỗi câu hỏi được hiệu chỉnh theo năng lực trung bình của những người thực sự đã trả lời câu đó, rồi biểu diễn thành xác suất một người học có năng lực trung bình trả lời đúng. Sau hiệu chỉnh, lợi thế của N1 biến mất (N3 75,3%, N1 73,3%, N2 71,2%).
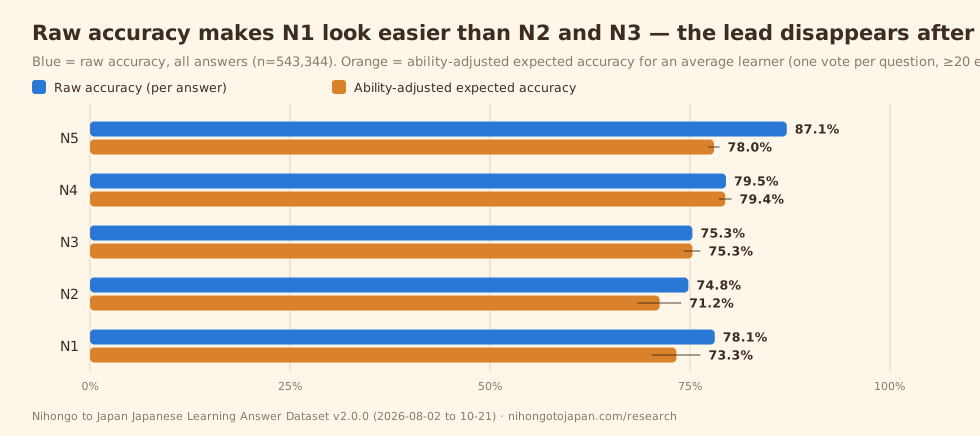
Có hai lưu ý. Thứ nhất, khoảng tin cậy sau hiệu chỉnh của N1 và N3 vẫn chồng lấn nhau, nên chúng mình không thể nói N1 khó hơn N3. Thứ hai, N5 sau hiệu chỉnh (78,0%) không cao hơn N4 (79,4%): việc hiệu chỉnh xử lý yếu tố ai là người trả lời, chứ không xử lý việc mỗi cấp độ gồm những câu hỏi nào — 53% câu hỏi N5 trong phân tích là mẫu ngữ pháp, so với 33% ở N4, và câu hỏi mẫu ngữ pháp khó trả lời đúng hơn câu hỏi từ vựng.
2. Khoảng cách giữa các trợ từ: で, が và に thua を và の khoảng 20 điểm
で (62,6%), が (63,0%) và に (64,7%) thấp hơn を (80,6%) và の (85,2%) gần 20 điểm. Điểm chung của ba trợ từ thấp nhất là một trợ từ, nhiều cách dùng: で đánh dấu nơi chốn, phương tiện, nguyên nhân và phạm vi; に đánh dấu thời gian, đích đến, người nhận và mục đích.
Kết quả này khớp với v1 (“chênh lệch giữa các trợ từ lớn hơn chênh lệch giữa các cấp độ”), và cỡ mẫu lớn hơn của v2 giúp xu hướng này ổn định hơn.
3. Các mẫu ngữ pháp khó nhất tập trung ở nhóm suy đoán và mục đích/trạng thái
Trong năm mẫu thấp nhất, 〜らしい (46,5%) và 〜はず (53,4%) đều diễn đạt suy đoán hoặc kỳ vọng và dễ bị nhầm với 〜そう, 〜よう và 〜みたい; 〜ように (54,2%) bao gồm mục đích, sự thay đổi và lời nhờ vả; 〜ながら (58,0%) thường bị lẫn với 〜て và 〜まま.
Dạng động từ cho thấy cấu trúc tương tự: thể khả năng (64,5%) thấp nhất trong năm dạng. Quy tắc của nó khác nhau giữa động từ ichidan, godan và bất quy tắc, và người học còn gặp các biến thể khẩu ngữ lược bỏ ら.
4. Tỷ lệ đúng sau một khoảng nghỉ không đơn giản là giảm dần
Ghép cặp các câu trả lời liên tiếp của cùng một mã định danh trên cùng một điểm kiến thức, rồi nhóm theo khoảng cách:
| Khoảng cách | Câu trả lời | Mã định danh | Tỷ lệ đúng |
|---|---|---|---|
| < 1 giờ | 172.323 | 3.472 | 84,1% |
| 1 giờ – 1 ngày | 5.749 | 647 | 76,7% |
| 1–3 ngày | 11.714 | 532 | 87,3% |
| 3–7 ngày | 11.864 | 449 | 87,4% |
| 7–30 ngày | 13.007 | 405 | 87,0% |
| > 30 ngày | 729 | 126 | 79,3% |
Đường cong lãng quên trong sách giáo khoa nói rằng khoảng cách càng dài thì càng quên nhiều. Ở đây, nhóm 1 giờ – 1 ngày thấp nhất còn nhóm 1–30 ngày cao nhất. Chúng mình không hiểu điều này là “ôn lại sau vài ngày là hiệu quả nhất”: ai quay lại sau vài ngày không phải là ngẫu nhiên — những người học quay lại thường gắn bó hơn và có thể giỏi hơn. Nhóm 1 giờ – 1 ngày chỉ có 647 mã định danh và có thể bao gồm những người làm lại một bộ câu hỏi trên thiết bị thứ hai trong cùng ngày. Muốn trả lời câu hỏi về khoảng cách ôn tập cần có một thí nghiệm ngẫu nhiên hóa, điều mà bộ dữ liệu này không thể cung cấp.
5. Mô hình dự đoán đã giảm một nửa sai số nhưng chưa vượt được đường cơ sở đơn giản nhất
Hệ thống gợi ý câu hỏi của trang trước tiên dự đoán xác suất bạn sẽ trả lời đúng. Chúng mình đánh giá nó bằng điểm Brier (trung bình bình phương chênh lệch giữa xác suất dự đoán và kết quả thực tế; càng thấp càng tốt):
- Mô hình v1: 0,409
- Mô hình v2: 0,199 (thấp hơn 51,4%)
- v2 kèm độ khó ở cấp câu hỏi: 0,130 (thấp hơn 68,1%)
- Tham chiếu: đường cơ sở hằng số luôn dự đoán tỷ lệ chung 79,9%: 0,161
v2 giảm một nửa sai số so với v1 nhưng xét tổng thể vẫn thua đường cơ sở hằng số; chỉ khi thêm độ khó ở cấp câu hỏi mới vượt được nó. Chúng mình công bố điều này vì nó cho thấy trực tiếp rằng độ khó của câu hỏi dự đoán việc trả lời đúng tốt hơn trình độ của người học — đó cũng là lý do phát hiện 1 cần đến bước hiệu chỉnh theo năng lực.
2. Tổng quan bộ dữ liệu
| Hạng mục | Giá trị | Ghi chú |
|---|---|---|
| Lượt trả lời hợp lệ | 543.344 | Ảnh chụp dữ liệu tổng hợp lúc 2026-10-21 19:18 UTC, phạm vi all_clean_events (đã áp dụng quy tắc làm sạch của trang) |
| Mã định danh người học (≥1 câu trả lời hạng A) | 5.410 | totalUsers trong endpoint tổng hợp |
| Mã định danh người học (tất cả) | 8.073 | Endpoint cộng đồng; là giới hạn trên của số người |
| Số câu hỏi đã được trả lời | 25.850 | 7.057 câu có ≥20 lượt xuất hiện được đưa vào phân tích cấp câu hỏi |
| Số câu hỏi có độ khó đã hiệu chỉnh | 18.139 | Ước lượng Rasch một bước với co rút Bayes thực nghiệm |
| Hạng bằng chứng | A 59,8% · B 33,5% · C 6,7% | A = ngữ cảnh bài kiểm tra; B = luyện tập trong bài học; C = khác (như ở v1) |
| Giai đoạn bao phủ | 2026-08-02 đến 10-21 | 81 ngày |
Về bộ đếm trực tiếp: dòng “Người học NTJ đã hoàn thành 552.850 câu trả lời luyện tập” trên trang chủ là con số trực tiếp của endpoint cộng đồng vào ngày 2026-10-23, cao hơn bộ dữ liệu này khoảng 9.500 — đó là các câu trả lời phát sinh trong hai ngày sau thời điểm chụp dữ liệu. Hãy trích dẫn con số 543.344.
3. Các trục kỹ năng (toàn bộ câu trả lời)
| Trục | Câu trả lời | Tỷ lệ đúng | Lần trả lời đầu tiên ở cấp câu hỏi (số câu hỏi) |
|---|---|---|---|
| Từ vựng | 267.127 | 90,1% | 89,1% (3.398) |
| Mẫu ngữ pháp | 234.602 | 75,2% | 73,9% (3.252) |
| Dạng động từ | 18.479 | 75,2% | 76,2% (154) |
| Trợ từ | 13.870 | 71,3% | 67,6% (189) |
| Thành ngữ | 7.413 | 88,1% | 92,4% (64) |
| Đọc hiểu | 1.103 | 78,7% | — |
| Nghe hiểu | 605 | 69,8% | — |
| Nói | 118 | KHÔNG CÔNG BỐ | — |
Đọc hiểu, nghe hiểu và nói là các dạng câu hỏi mới hơn với cỡ mẫu nhỏ; phần nói chưa đạt ngưỡng 300 câu trả lời, nên chỉ công bố số lượng.
4. Các cấp độ JLPT
| Cấp độ | Tỷ lệ đúng trên toàn bộ câu trả lời (n) | Lần trả lời đầu tiên ở cấp câu hỏi (số câu hỏi) | Tỷ lệ đúng kỳ vọng đã hiệu chỉnh theo năng lực (KTC 95%) |
|---|---|---|---|
| N5 | 87,1% (297.809) | 82,6% (3.817) | 78,0% (77,3–78,7%) |
| N4 | 79,5% (93.609) | 84,5% (1.766) | 79,4% (78,6–80,2%) |
| N3 | 75,3% (82.010) | 75,7% (1.008) | 75,3% (74,2–76,3%) |
| N2 | 74,8% (36.837) | 66,9% (249) | 71,2% (68,4–73,9%) |
| N1 | 78,1% (33.082) | 74,2% (217) | 73,3% (70,2–76,3%) |
Ba cột dùng ba tập phân tích khác nhau; hãy so sánh trong cùng một cột, đừng so sánh chéo giữa các cột. Cột 1 tính mọi câu trả lời, kể cả các lần làm lại, và phụ thuộc vào tỷ lệ các dạng câu hỏi ở từng cấp độ; cột 2 cho mỗi câu hỏi một phiếu; cột 3 còn loại bỏ thêm ảnh hưởng của năng lực người học.
5. Chất lượng câu hỏi: ngân hàng câu hỏi của chính chúng mình cũng được đo
| Tỷ lệ đúng ở lần trả lời đầu tiên | Số câu hỏi |
|---|---|
| < 35% | 283 |
| 35–50% | 377 |
| 50–70% | 971 |
| 70–85% | 1.347 |
| 85–95% | 1.937 |
| ≥ 95% | 2.142 |
283 câu hỏi (4,0%) dưới 35% không hẳn là câu hỏi tồi — có câu chỉ đơn giản là khó. Nhưng đợt rà soát thủ công hồi tháng 8 của chúng mình cho thấy nhóm này thường chứa một lựa chọn thứ hai cũng có thể bảo vệ được (ví dụ, cả が lẫn を đều dùng được trong 「ピアノ_弾けます」). Hệ thống cũng gắn cờ 415 câu hỏi cần rà soát dựa trên các tiêu chí như độ phân biệt âm rõ rệt. Độ chính xác (precision) của cờ này vào khoảng 0,19: đó là một hàng đợi rà soát, không phải danh sách câu hỏi tồi.
6. Giáo viên và người thiết kế tài liệu có thể dùng dữ liệu này thế nào
- Trợ từ: で, が và に thua を và の khoảng 20 điểm. Luyện từng cách dùng một, với ví dụ riêng cho từng cách dùng, sẽ trúng đích hơn là luyện cả trợ từ một lượt.
- Cách diễn đạt suy đoán: 〜らしい và 〜はず là những mẫu bị trả lời sai nhiều nhất ở đây; hãy đặt chúng cạnh 〜そう, 〜よう và 〜みたい để đối chiếu.
- Thể khả năng: thấp nhất trong năm dạng động từ; hãy luyện riêng theo từng nhóm động từ.
- Đọc dữ liệu của chính bạn: nếu nền tảng của bạn cũng cho thấy câu hỏi nâng cao có tỷ lệ đúng cao hơn câu hỏi trung cấp, hãy nghi ngờ yếu tố chọn lọc trước khi nghi ngờ câu hỏi.
7. Phương pháp
Nguồn dữ liệu và khả năng tái lập
Mọi con số trong v2 đều đến từ sáu endpoint công khai, được truy xuất và cố định vào ngày 2026-10-23: /api/aggregates?kind=summary, kind=items, kind=difficulty, kind=spacing, kind=brier và /api/community?kind=overview. Thời điểm chụp dữ liệu của từng endpoint và sha256 của từng tệp đầu vào nằm trong tệp JSON tải về, tại dataset.source_snapshot_at_utc và dataset.input_sha256. Script dựng dữ liệu, scripts/build-research-dataset-2026-10.py, không có quyền truy cập dữ liệu ở cấp người học.
Năm tập phân tích
- Toàn bộ câu trả lời (trục, cấp độ, điểm kiến thức): mọi câu trả lời hợp lệ đều được tính, kể cả các lần làm lại của cùng một mã định danh.
- Lần trả lời đầu tiên ở cấp câu hỏi: với mỗi câu hỏi, lấy tỷ lệ đúng ở lần trả lời đầu tiên của từng mã định danh, rồi lấy trung bình trên các câu hỏi. Chỉ gồm các câu hỏi có ≥20 lượt xuất hiện; KTC 95% lấy câu hỏi làm đơn vị.
- Độ khó đã hiệu chỉnh theo năng lực: ước lượng Rasch một bước b̂ = θ̄ (năng lực trung bình của những người thực sự trả lời) − logit(p̂), được co rút về giá trị trung bình của trục với trọng số n/(n+5), rồi quy đổi thành tỷ lệ sai kỳ vọng của một người học có năng lực bằng mức trung bình toàn trang. Chúng mình báo cáo 1 − tỷ lệ sai kỳ vọng.
- Các cặp câu trả lời liên tiếp (khoảng cách ôn tập): các câu trả lời liên tiếp của cùng một mã định danh trên cùng một điểm kiến thức, chỉ gồm hạng bằng chứng A và B.
- Độ chính xác của dự đoán: toàn bộ câu trả lời hạng A có kèm cả dự đoán của v1 và v2 (các trường dự đoán có từ ngày 2026-08-20).
Cỡ ô tối thiểu
Các ô ở cấp lượt trả lời có n < 300 không được công bố; điểm kiến thức chỉ được liệt kê khi n ≥ 300; các phân tích ở cấp câu hỏi chỉ gồm các câu hỏi có ≥20 lượt xuất hiện.
Khoảng tin cậy
KTC Wilson 95% ở cấp lượt trả lời chưa được hiệu chỉnh cho các câu trả lời lặp lại của cùng một mã định danh (các endpoint công khai không cung cấp dữ liệu ở cấp mã định danh), nên chúng quá hẹp và chỉ mang tính tham khảo. KTC ở cấp câu hỏi coi câu hỏi là đơn vị lấy mẫu: chúng mô tả ngân hàng câu hỏi này, không mô tả một tổng thể người học.
Tính ẩn danh
Các endpoint công khai chỉ trả về số liệu tổng hợp. Bộ dữ liệu này không chứa lượt trả lời thô nào, không chứa mã định danh và không chứa dấu thời gian ở cấp lượt trả lời.
8. Giới hạn (vui lòng trích dẫn kèm các con số)
- Mẫu quan sát tự chọn gồm những người luyện tập trên NTJ; không đại diện cho bất kỳ tổng thể người học nào.
- Mã định danh không phải là người: mã định danh trình duyệt ẩn danh không thể gộp giữa các thiết bị; 8.073 là giới hạn trên.
- Bộ câu hỏi khác nhau: các cấp độ, trục và điểm kiến thức dùng những câu hỏi khác nhau, nên chênh lệch tỷ lệ đúng không phải là bảng xếp hạng độ khó.
- Các con số tính trên toàn bộ câu trả lời bị đẩy cao do luyện tập lặp lại.
- Việc hiệu chỉnh theo năng lực có những giả định: mô hình Rasch giả định chỉ có một chiều năng lực duy nhất; năng lực chỉ được ước lượng cho những mã định danh có đủ số câu trả lời.
- KTC ở cấp lượt trả lời quá hẹp (xem phần Phương pháp).
- Danh sách câu hỏi bị cắt bớt:
kind=itemstrả về tối đa 25.000 câu hỏi theo thứ tự lượt xuất hiện giảm dần (trên tổng số 25.850); 850 câu bị thiếu là những câu ít xuất hiện nhất và không ảnh hưởng đến phân tích ≥20 lượt xuất hiện. - Chỉ có 100 điểm kiến thức hàng đầu: endpoint tổng hợp trả về 100 điểm kiến thức được trả lời nhiều nhất.
- Thời gian trả lời không dùng được: các tab mở mà bỏ không làm trung bình bị đẩy cao, nên thời gian trả lời không được báo cáo.
- Không có khẳng định nhân quả nào trong toàn bộ báo cáo này.
9. Cách trích dẫn
Bạn có thể thoải mái trích dẫn bộ dữ liệu này trong bài báo khoa học, báo cáo, tài liệu giảng dạy và tin tức. Vui lòng ghi rõ nguồn, nêu phiên bản và dẫn liên kết về trang này.
APA (7th)
Nihongo to Japan. (2026). Japanese learning answer dataset — October 2026 (Version 2.0.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026-10MLA (9th)
Nihongo to Japan. Japanese Learning Answer Dataset — October 2026. Version 2.0.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10.BibTeX
@misc{ntj_jlad_2026_10,

  title = {Japanese Learning Answer Dataset --- October 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {2.0.0},

  note = {Snapshot 2026-10-21; aggregate statistics from 543,344 anonymous answer events, 2 August -- 21 October 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026-10}

}
Giấy phép: dữ liệu theo CC BY 4.0
Dữ liệu trong bộ dữ liệu này được phát hành theo giấy phép Creative Commons Attribution 4.0 International (CC BY 4.0). Bạn có thể sao chép, phân phối lại, chỉnh sửa và phát triển tiếp từ dữ liệu này, kể cả cho mục đích thương mại, với điều kiện ghi nguồn phù hợp và cho biết nếu có thay đổi.
⚠️ Giấy phép chỉ áp dụng cho dữ liệu: các số liệu tổng hợp trên trang này và hai tệp tải vềjapanese-learning-2026-10.jsonvàjapanese-learning-2026-10.csv. Biểu đồ của chúng mình (SVG/PNG) và văn bản báo cáo không thuộc phạm vi giấy phép; mọi quyền được bảo lưu.
Ghi nguồn
Nihongo to Japan, Japanese Learning Answer Dataset — October 2026, v2.0.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10Đề nghị của chúng mình (không phải điều kiện của giấy phép)
- Nêu kèm các giới hạn: mẫu tự chọn, mang tính quan sát, không đại diện.
- Nêu rõ tập phân tích: số liệu tính trên toàn bộ câu trả lời, trên lần trả lời đầu tiên ở cấp câu hỏi và số liệu đã hiệu chỉnh theo năng lực khác nhau rất nhiều.
- Hãy viết “mã định danh người học”, đừng viết “người”.
- Nêu rõ phiên bản (v2.0.0, ảnh chụp dữ liệu ngày 2026-10-21).
⚠️ Giấy phép CC BY không thể thu hồi. Bất kỳ ai nhận được dữ liệu theo các điều khoản này vẫn giữ nguyên các quyền đó, kể cả khi sau này chúng mình thay đổi điều khoản.
10. Tải về
- japanese-learning-2026-10.json — đầy đủ siêu dữ liệu, sha256 của dữ liệu đầu vào, các ngưỡng và mọi ô số liệu tổng hợp.
- japanese-learning-2026-10.csv — mỗi ô một dòng; các cột
table, key, n, value, ci95_low, ci95_high, unit, note. - japanese-learning-2026-10-LICENSE.txt — tuyên bố giấy phép.
Tệp biểu đồ (PNG độ phân giải 2×, SVG co giãn được; biểu đồ không thuộc CC BY — vui lòng liên hệ với chúng mình trước khi đăng lại):
- Tỷ lệ đúng thô so với tỷ lệ đúng đã hiệu chỉnh theo năng lực: PNG · SVG
- Tỷ lệ đúng của trợ từ: PNG · SVG
- 10 mẫu ngữ pháp có tỷ lệ đúng thấp nhất: PNG · SVG
- Tỷ lệ đúng theo khoảng cách ôn tập: PNG · SVG
Văn bản thay thế (alt text) của mọi biểu đồ có trong alt-text.json.
Liên hệ truyền thông và dữ liệu
Nếu cần số liệu phân tách chi tiết hơn, nghi ngờ có sai sót hoặc có câu hỏi về việc nên trích dẫn con số nào, hãy gửi email tới [email protected] với tiêu đề có ghi “Dataset v2.0.0”.
Các phiên bản
| Phiên bản | Ảnh chụp dữ liệu | Giai đoạn bao phủ | Ghi chú |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 đến 10-21 (81 ngày) | Trang này. Dựng từ các endpoint tổng hợp công khai; bổ sung độ khó đã hiệu chỉnh theo năng lực, khoảng cách ôn tập, chất lượng câu hỏi và độ chính xác của dự đoán. |
| v1.1.0 | 2026-08-14 | 2026-08-02 đến 08-13 (12 ngày) | Bản phát hành đầu tiên; tập chính là “lần trả lời đầu tiên trong ngữ cảnh bài kiểm tra”. Các con số của bản này không thay đổi và vẫn có thể trích dẫn. |
Các con số đã công bố không bao giờ bị viết lại. ← Nghiên cứu và dữ liệu | Dành cho nhà giáo dục và thư viện