Jeu de données des réponses d’apprentissage du japonais — août 2026 : taux de réussite sur 56 613 réponses anonymes (instantané de 12 jours)
📢 Une version plus récente est disponible : Jeu de données de réponses d’apprenants de japonais — octobre 2026 (v2.0.0, 543 344 réponses). La v2 repose sur d’autres ensembles d’analyse : ses chiffres ne peuvent donc pas être soustraits de ceux de cette page. Les chiffres de la v1.1.0 présentés ici restent inchangés et peuvent toujours être cités.
En une phrase : statistiques agrégées issues de 56 613 événements de réponse anonymes sur Nihongo to Japan, produits par 1 053 identifiants d’apprenant anonymes sur 11 987 questions.
⚠️ Il s’agit d’un instantané d’août 2026, et non d’une étude portant sur l’ensemble de l’année 2026. Les données couvrent la période du 2 au 13 août 2026, soit douze jours au total (le pipeline d’agrégation a été mis en service le 2 août ; le premier jour est incomplet). Aucune tendance longitudinale ne peut en être tirée. Version 1.1.0, instantané figé le 2026-08-14.
À propos des « identifiants d’apprenant » : il s’agit d’identifiants anonymes générés aléatoirement dans le navigateur, qui ne peuvent pas être fusionnés d’un appareil à l’autre. Une même personne qui utilise un téléphone et un ordinateur portable produit deux identifiants : 1 053 n’est donc pas un nombre vérifié de personnes distinctes, mais une borne supérieure. C’est pourquoi cette page parle partout d’« identifiants d’apprenant » et non de « personnes ».
Ce que ces données ne sont pas. Il ne s’agit pas d’une enquête représentative des apprenants de japonais à Taïwan ni ailleurs. L’échantillon se compose de personnes qui ont choisi de s’entraîner sur ce site : c’est un échantillon observationnel auto-sélectionné. Chaque chiffre décrit ce qui s’est passé dans cet ensemble de réponses et ne peut être extrapolé à aucune population. Voir les Limites.
Dix constats à citer tels quels
Chacun des éléments ci-dessous est autonome : la phrase elle-même mentionne le nom du jeu de données, la période de l’instantané, la taille de l’échantillon et l’intervalle de confiance, de sorte qu’un journaliste ou un chercheur peut en reprendre un seul sans devoir rechercher le contexte. Chaque chiffre est une valeur observée au sein de ce jeu de données (l’ensemble d’analyse principal correspond aux premières tentatives en contexte de quiz — voir la Méthodologie), et non une inférence sur la population des apprenants de japonais ; aucune relation de cause à effet n’est avancée. Merci de citer les Limites avec les chiffres.
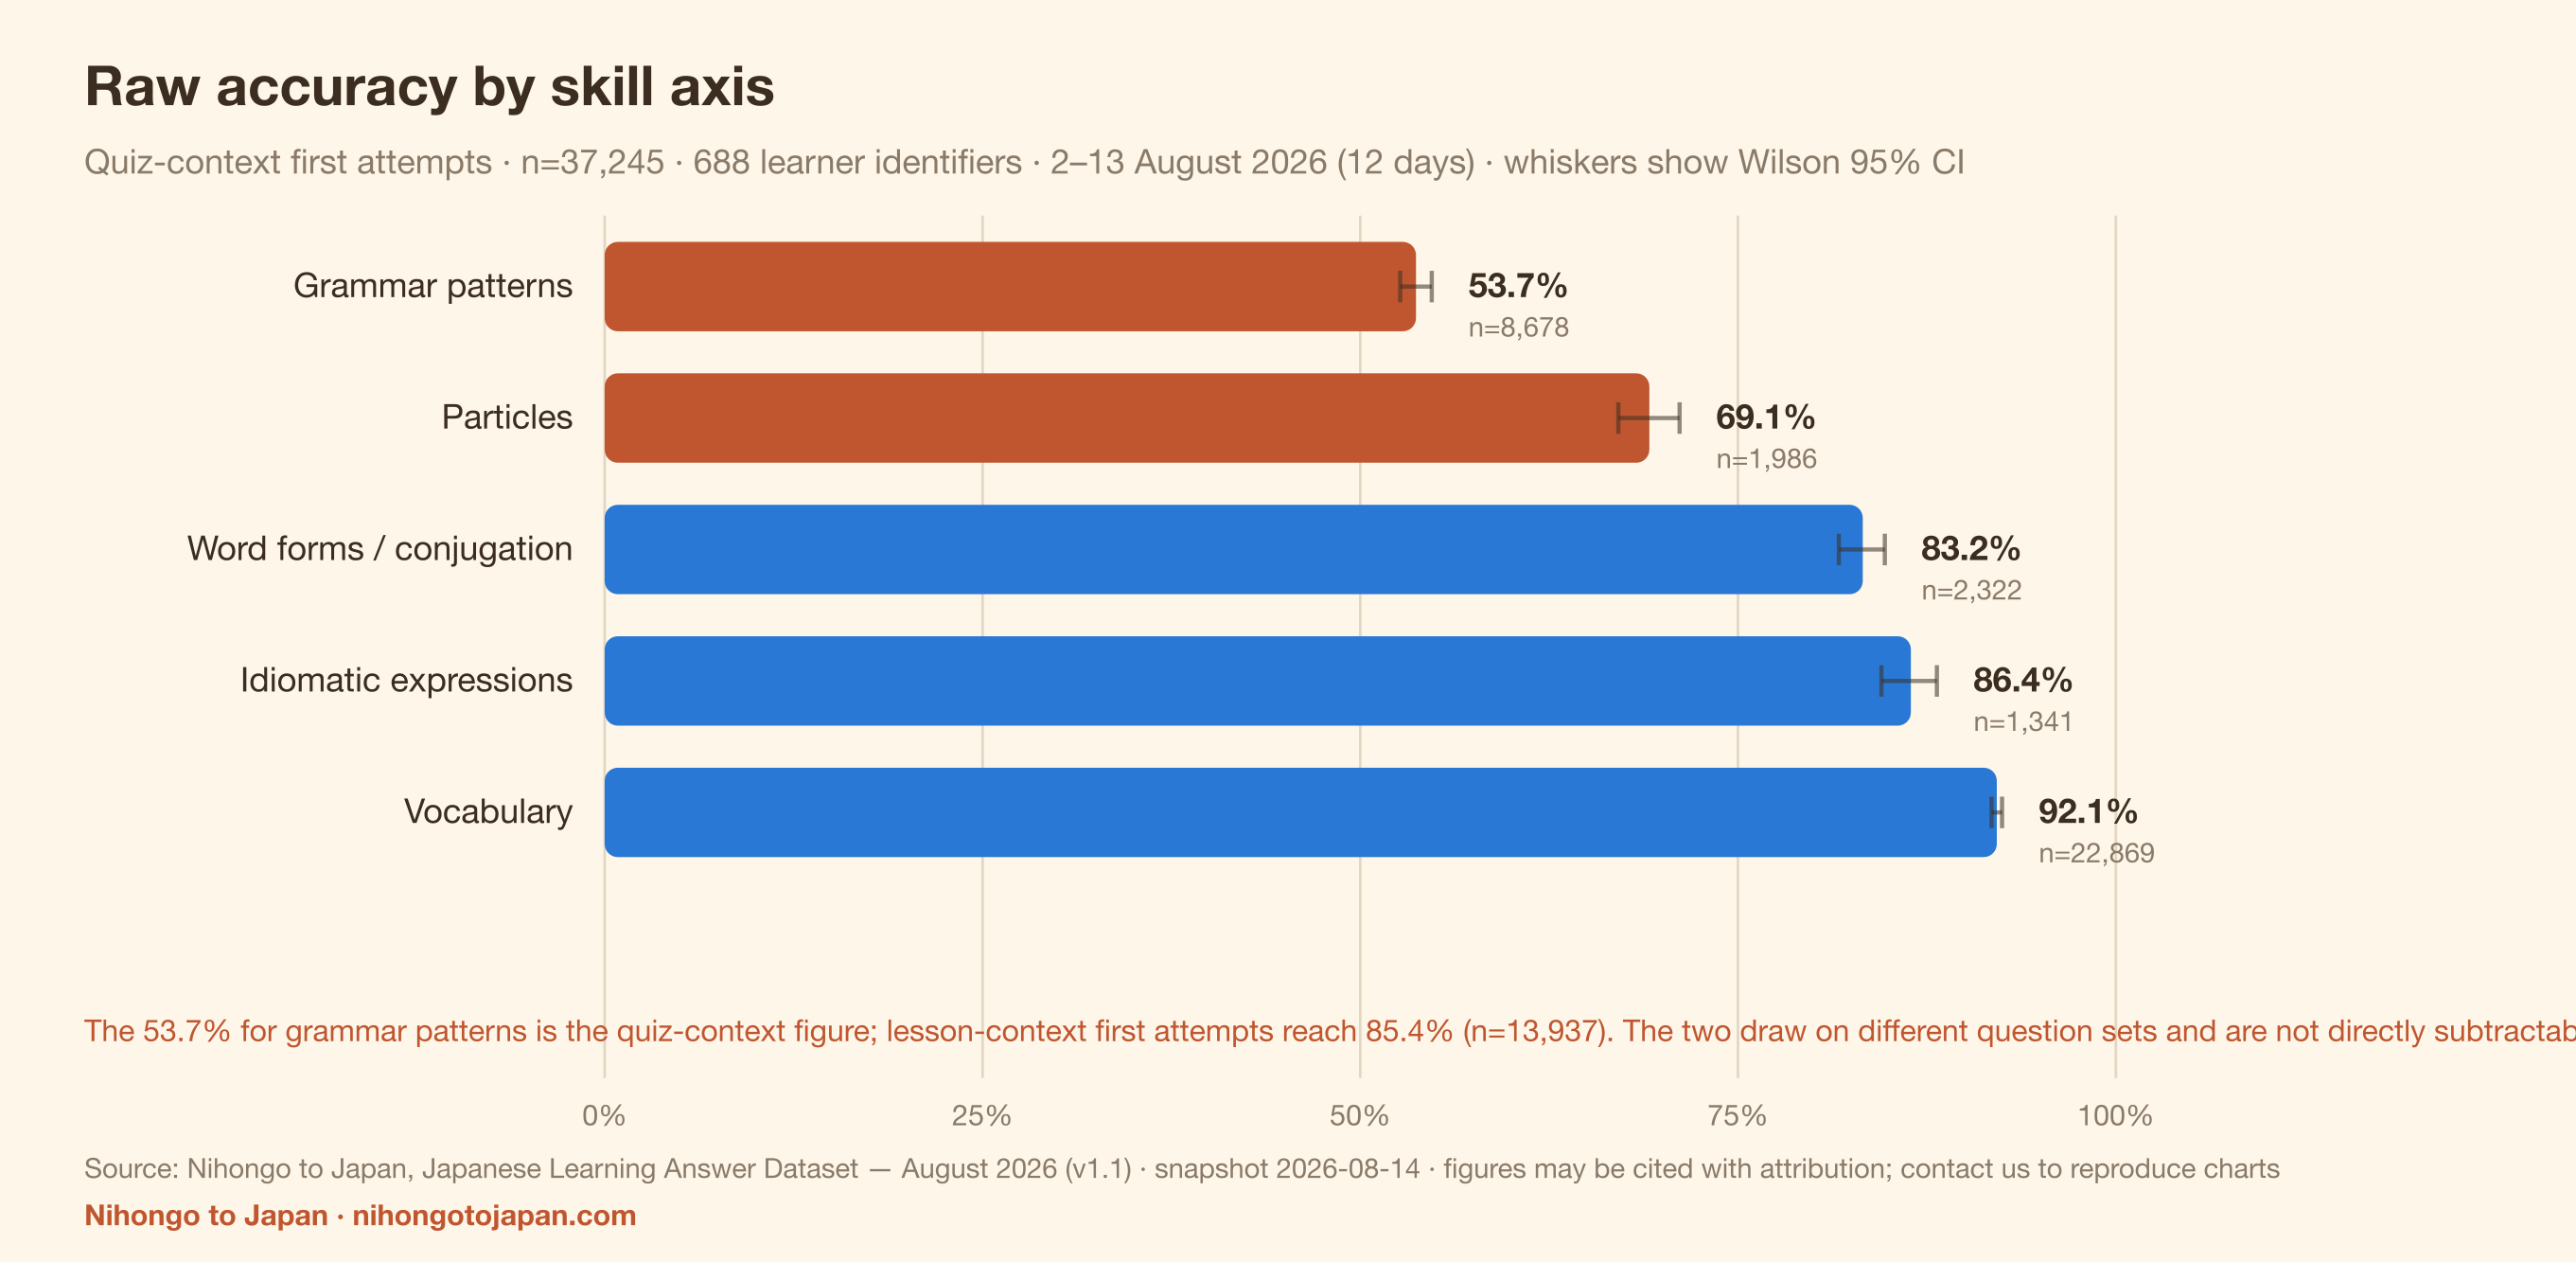
- Parmi les premières tentatives en contexte de quiz du NTJ Japanese Learning Answer Dataset (instantané d’août 2026, 12 jours), les questions portant sur les structures grammaticales ont obtenu un taux de bonnes réponses de 53,7% (n=8 678 ; IC de Wilson à 95% : 52,6%–54,7%), contre 92,1% pour le vocabulaire (n=22 869 ; IC à 95% : 91,8%–92,5%), soit un écart de 38 points de pourcentage.
Les deux intervalles ne se chevauchent pas : l’écart ne relève donc pas du bruit d’échantillonnage ; ce rapport ne se prononce pas sur sa cause. - Parmi les premières tentatives en contexte de quiz du même jeu de données, les cinq axes d’apprentissage se classent ainsi, du plus bas au plus élevé : structures grammaticales 53,7% (n=8 678), particules 69,1% (n=1 986 ; IC à 95% : 67,1%–71,1%), formes et conjugaison 83,2% (n=2 322 ; IC à 95% : 81,7%–84,7%), expressions idiomatiques 86,4% (n=1 341 ; IC à 95% : 84,5%–88,2%) et vocabulaire 92,1% (n=22 869).
Chaque axe repose sur un ensemble de questions différent : il s’agit d’un classement des taux de réussite observés, et non d’un classement de difficulté. - Dans le même jeu de données, le taux de réussite observé sur l’axe des structures grammaticales varie de 53,7% à 85,4% selon les réponses prises en compte : 53,7% pour les premières tentatives en contexte de quiz (n=8 678), 85,4% pour les premières tentatives en contexte de leçon (n=13 937) et 74,1% sur l’ensemble des événements de réponse (n=24 293).
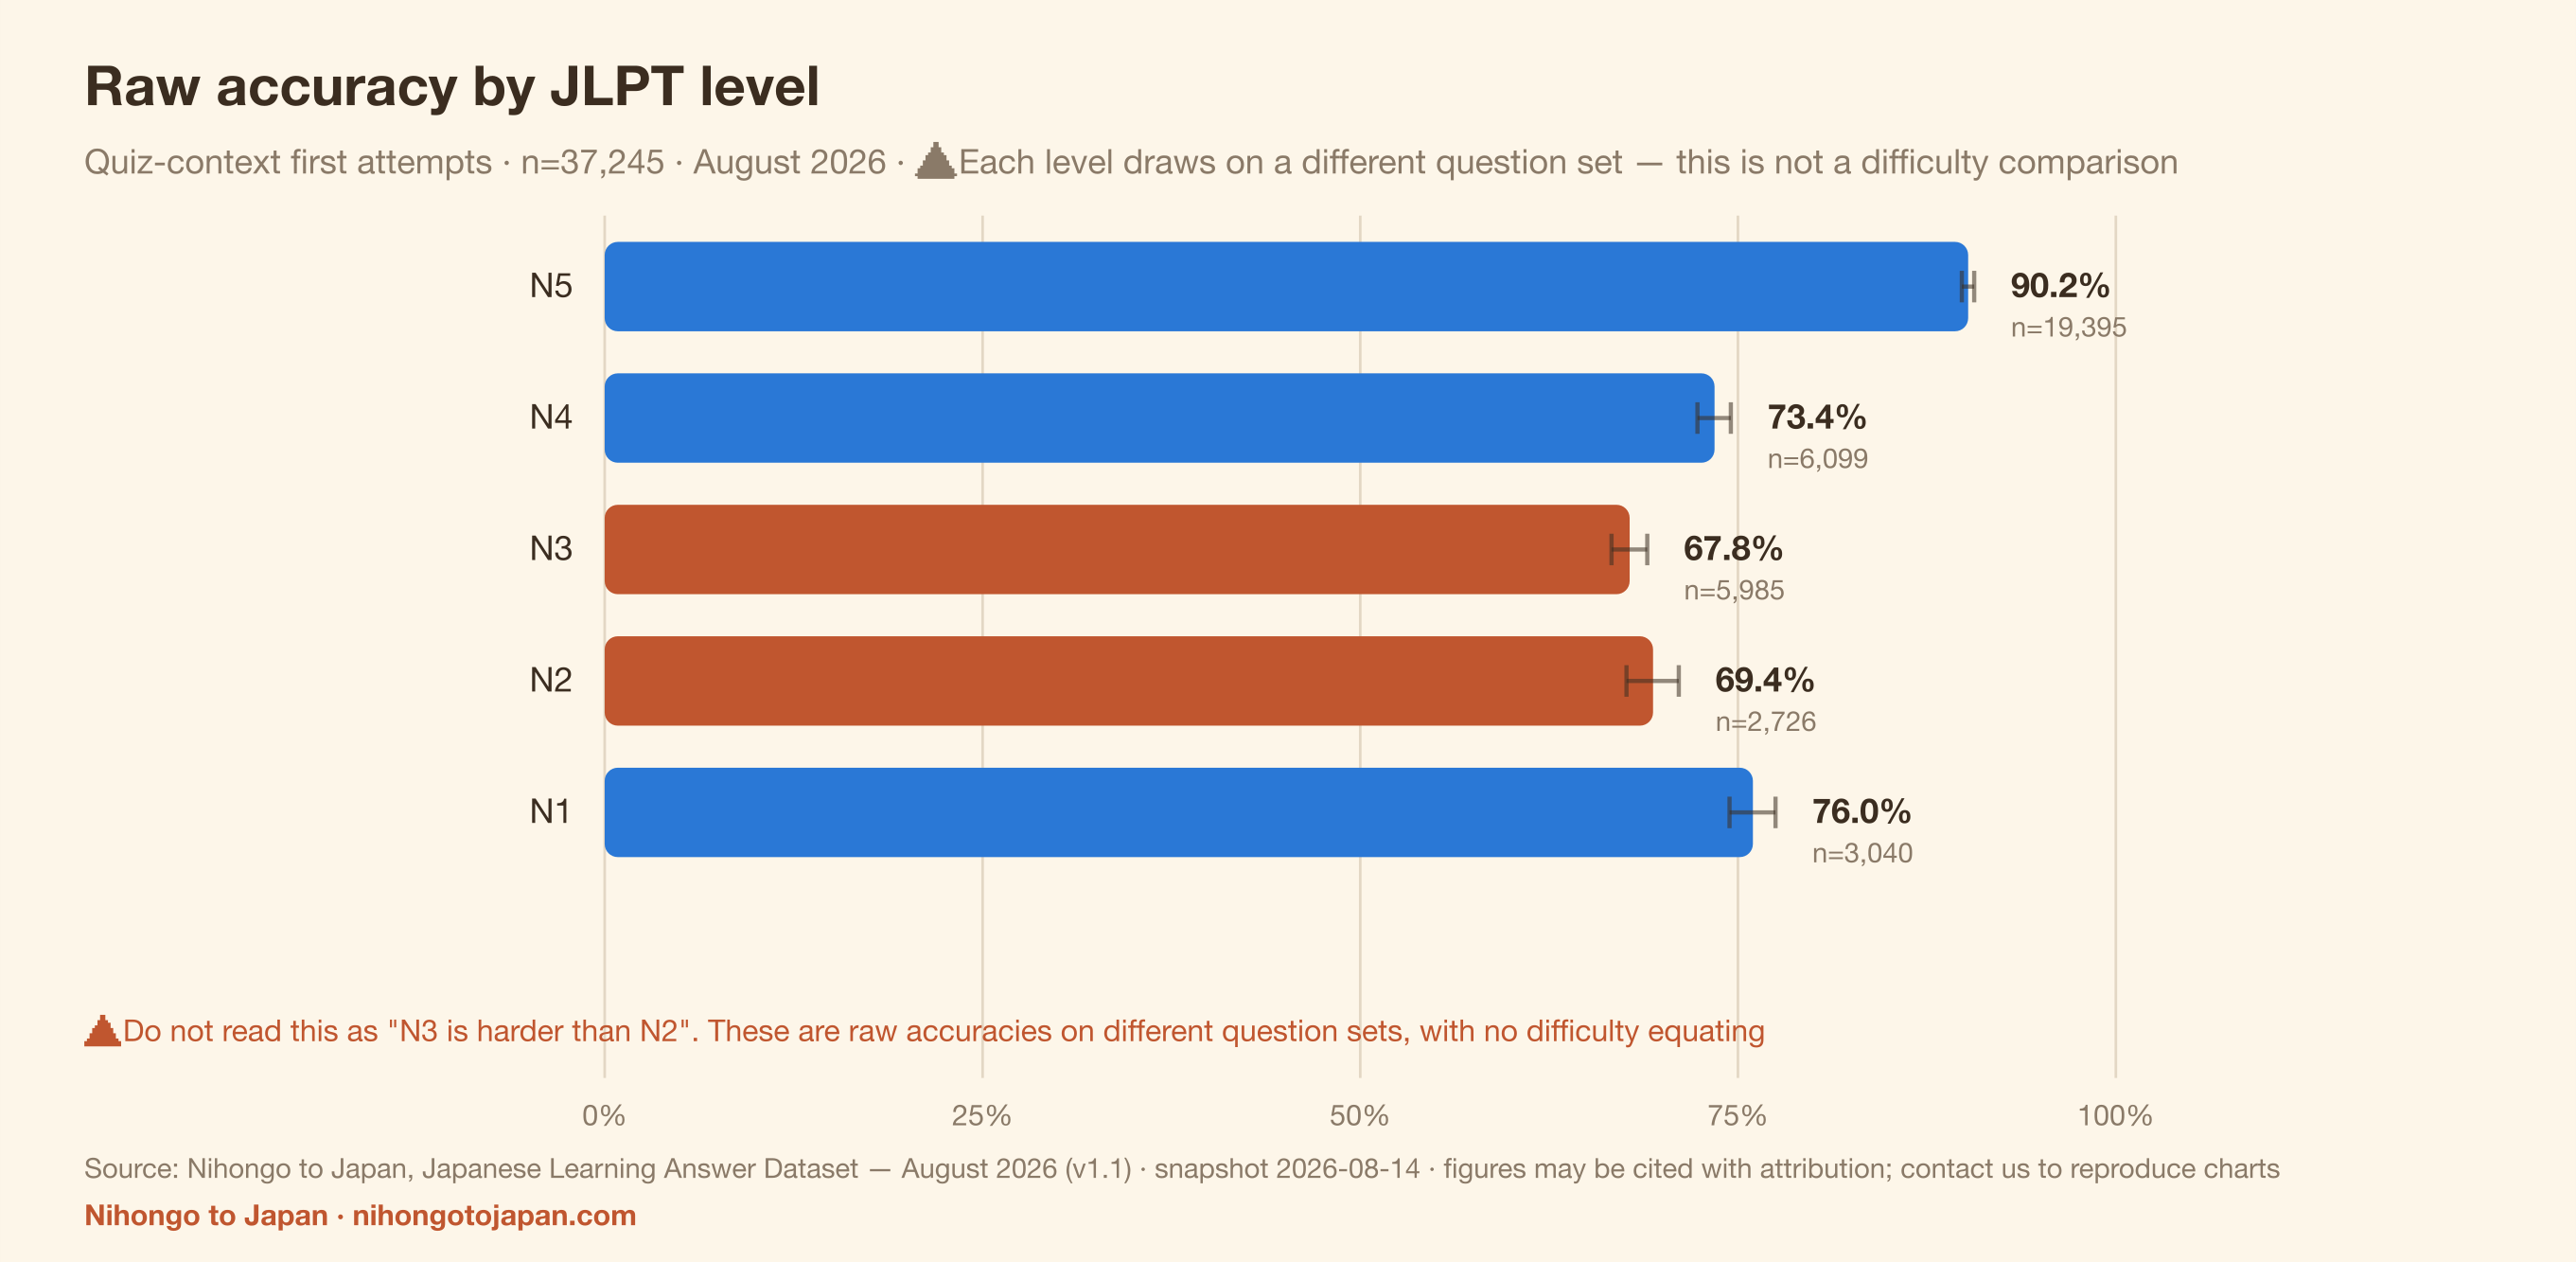
Les deux contextes reposent sur des ensembles de questions presque disjoints — seules 6 des 5 772 questions distinctes de structures grammaticales apparaissent dans les deux —, si bien que l’effet du contexte ne peut pas être séparé des différences de difficulté des questions. L’enseignement de ce constat est que tout taux de réussite cité à partir d’une plateforme d’apprentissage doit préciser quelles réponses il inclut. - Parmi les premières tentatives en contexte de quiz du même jeu de données, le taux de réussite brut était de 67,8% au N3 (n=5 985 ; IC à 95% : 66,6%–69,0%) et de 69,4% au N2 (n=2 726 ; IC à 95% : 67,6%–71,1%) ; les intervalles de confiance se chevauchent, si bien que ce jeu de données ne permet pas de distinguer le N2 du N3.
Ne pas présenter ce résultat comme « le N2 est plus difficile que le N3 », ni l’inverse. - Parmi les premières tentatives en contexte de quiz du même jeu de données, le taux de réussite brut par niveau du JLPT était de 90,2% pour le N5 (n=19 395), 76,0% pour le N1 (n=3 040), 73,4% pour le N4 (n=6 099), 69,4% pour le N2 (n=2 726) et 67,8% pour le N3 (n=5 985) : le taux brut du N1 est supérieur à ceux du N2 et du N3.
Les niveaux reposent sur des ensembles de questions différents, aucun équilibrage IRT n’a été effectué et l’échantillon est auto-sélectionné (ceux qui s’attaquent aux questions de N1 ont tendance à être plus avancés) : cet ordre ne peut donc pas être lu comme la difficulté objective des niveaux du JLPT. - Parmi les premières tentatives en contexte de quiz du même jeu de données, la dispersion au sein des particules est plus large que la dispersion entre niveaux du JLPT : la particule が a obtenu 60,9% de bonnes réponses (n=358 ; IC à 95% : 55,8%–65,8%) et を 78,7% (n=385 ; IC à 95% : 74,3%–82,5%), soit 17,8 points d’écart, contre 5,6 points entre le N3 (67,8%) et le N4 (73,4%).
Sur le plan pédagogique, répartir l’entraînement par niveau du JLPT pourrait être moins fin que le répartir par point de connaissance. - Parmi les premières tentatives en contexte de quiz du même jeu de données, les structures grammaticales constituent l’axe le moins bien réussi à chaque niveau du JLPT : 64,0% au N5 (n=1 939), 48,0% au N4 (n=1 734), 49,2% au N3 (n=2 531), 51,1% au N2 (n=1 179) et 57,0% au N1 (n=1 295).
Vocabulaire aux mêmes niveaux : 94,4% au N5, 89,0% au N4, 84,0% au N3, 85,0% au N2 et 89,2% au N1. - Dans le même jeu de données, calculé sur exactement les mêmes 372 identifiants d’apprenant et les mêmes 34 392 événements de réponse, le principe « une réponse, une voix » (pondération par événement) donne 82,53%, tandis que le principe « un identifiant, une voix » donne 75,49%, soit une différence de 7,04 points de pourcentage.
Les deux chiffres portent sur une population et un ensemble d’analyse identiques ; la différence tient uniquement au choix de la pondération. Tout rapport citant un taux de réussite issu d’une plateforme d’apprentissage devrait préciser quelle pondération il utilise. - Dans le même jeu de données, le volume de réponses est très concentré : l’identifiant d’apprenant le plus actif représente à lui seul 3,73% des 56 613 événements de réponse, et les 10 premiers identifiants en représentent ensemble 19,44%.
Cette concentration est la cause directe de l’écart de 7 points entre les deux pondérations ; c’est un biais structurel commun aux données des plateformes d’apprentissage en général. - Dans le même jeu de données, une comparaison appariée limitée aux 75 identifiants d’apprenant ayant répondu dans les deux contextes (au moins 5 réponses de chaque côté) donne 86,57% en contexte de leçon (n=5 858) contre 55,52% en contexte de quiz (n=2 055), soit une différence moyenne appariée de 27,47 points de pourcentage (IC à 95% : 22,56–32,39).
Cela montre que l’écart entre contextes n’est pas un artefact lié à qui a répondu où ; mais comme une comparaison sur les mêmes questions est impossible (voir le constat 3), l’effet du contexte ne peut toujours pas être séparé de la difficulté des questions.
Chaque constat est développé, présenté en tableau et illustré par un graphique dans les sections ci-dessous. Si vous ne voulez que les chiffres, rendez-vous à Télécharger les données ; pour citer, voir Comment citer ; pour toute question, voir la section contact.
1. Cinq constats principaux
1. Les structures grammaticales sont le seul axe sous les 60%, à 38 points du vocabulaire
Parmi les premières tentatives en contexte de quiz (voir la Méthodologie pour la définition de cet ensemble), les questions de vocabulaire ont obtenu 92,1% de bonnes réponses (n=22 869, 627 identifiants d’apprenant, IC à 95% : 91,8%–92,5%), tandis que celles de structures grammaticales n’atteignent que 53,7% (n=8 678, 532 identifiants, IC à 95% : 52,6%–54,7%).
Les intervalles de confiance sont très éloignés : il ne s’agit donc pas de bruit d’échantillonnage. Les données montrent un écart important entre les deux axes ; elles ne disent rien de sa cause.
2. Le « taux de réussite » en structures grammaticales va de 53,7% à 74,1% selon les réponses prises en compte
Selon la définition de l’ensemble d’analyse retenue, le taux de réussite observé sur l’axe des structures grammaticales va de 53,7% (premières tentatives en contexte de quiz, n=8 678) à 74,1% (ensemble des événements de réponse, n=24 293). Comme les événements inclus et la composition des identifiants d’apprenant diffèrent tous deux, l’écart total ne peut pas être attribué à une seule règle de comptage.
Étape par étape :
| Étape | n | Taux de réussite brut | Variation par rapport à l’étape précédente |
|---|---|---|---|
| Ensemble des événements de réponse | 24 293 | 74,1% | — |
| → ne garder que les premières tentatives | 22 638 | 73,2% | -0,87 pt |
| → ne garder que les contextes de quiz (sans leçon ni révision) | 8 678 | 53,7% | -19,54 pts |
| (comparaison) premières tentatives en contexte de leçon | 13 937 | 85,4% | — |
Écarter les tentatives répétées ne modifie le chiffre que de 0,9 point de pourcentage. La quasi-totalité du reste provient de la différence entre les réponses en contexte de leçon et celles en contexte de quiz.
Comparaison appariée sur les mêmes identifiants d’apprenant : 75 identifiants comptent au moins 5 premières tentatives en structures grammaticales dans chacun des deux contextes. Ils atteignent 86,6% en contexte de leçon (n=5 858) et 55,5% en contexte de quiz (n=2 055), soit une différence moyenne appariée de +27,5 pts (IC à 95% : 22,6–32,4 ; médiane +26,9). L’écart ne s’explique donc pas simplement par l’identité de ceux qui répondent.
⚠️ Une comparaison sur les mêmes questions est impossible ; aucune conclusion ne peut donc être tirée. Sur 5 772 questions distinctes de structures grammaticales, seules 6 apparaissent dans les deux contextes, et seulement 1 compte au moins 3 réponses de chaque côté. Les deux contextes reposent sur des ensembles de questions presque disjoints : l’effet du contexte ne peut pas être séparé des différences de difficulté des questions. Il se peut tout simplement que les questions du contexte de leçon soient plus faciles.
Ce que l’on peut honnêtement affirmer, c’est ceci : face à un taux de réussite issu d’une plateforme d’apprentissage, demandez-vous toujours de quel ensemble d’analyse il provient. Les quatre ensembles figurent dans les données téléchargeables.
3. Le N3 et le N2 ont les taux de réussite bruts les plus bas — mais ces données ne permettent pas de les distinguer
Taux de réussite brut des premières tentatives en contexte de quiz, par niveau : N5 90,2%, N4 73,4%, N3 67,8%, N2 69,4%, N1 76,0%.
Les intervalles du N3 (IC à 95% : 66,6%–69,0%) et du N2 (IC à 95% : 67,6%–71,1%) se chevauchent : il n’est donc pas correct d’affirmer que « le N3 est plus difficile que le N2 ». Ce que l’on peut dire, c’est que dans cet échantillon, le N2 et le N3 se situent tous deux en dessous du N4, du N1 et du N5 en taux de réussite brut.
⚠️ Plus important encore, chaque niveau repose sur un ensemble de questions entièrement différent. Cet ordre n’est pas une comparaison de difficulté et ne constitue pas une preuve quant au niveau du JLPT objectivement le plus difficile.
4. La dispersion au sein des particules est plus large que la dispersion entre niveaux
Taux de réussite des premières tentatives en contexte de quiz, particule par particule : が 60,9% (n=358, IC 55,8%–65,8%), に 62,4% (n=370), で 63,3% (n=330), contre を 78,7% (n=385, IC 74,3%–82,5%) et の 83,3% (n=120).
Les intervalles de が et de を ne se chevauchent pas ; l’écart est de 18 points de pourcentage.
5. « Un identifiant, une voix » et « une réponse, une voix » diffèrent de 7,04 points
Calculé sur exactement les mêmes 372 identifiants d’apprenant, le même ensemble d’analyse et les mêmes 34 392 événements éligibles :
| Pondération | Taux de réussite |
|---|---|
| Pondération par événement (une voix par réponse) | 82,5% |
| Pondération par identifiant (une voix par identifiant) | 75,5% (médiane 76,2%) |
| WEIGHTING_EFFECT_PP | 7,04 pts |
Cohorte : identifiants d’apprenant comptant au moins 20 réponses dans l’ensemble d’analyse principal. Les deux chiffres partagent la même population au numérateur et le même dénominateur : l’écart reflète uniquement le choix de la pondération et n’est pas faussé par des différences de composition de l’échantillon.
La cause en est la répétition des mesures : l’identifiant le plus actif représente à lui seul 3,7% de toutes les réponses, et les dix premiers 19,4%. Toute étude fondée sur des données de plateforme se heurte à ce problème ; c’est pourquoi nous publions les deux chiffres.
2. Présentation du jeu de données
| Élément | Valeur |
|---|---|
| Événements de réponse valides | 56 613 |
| Identifiants d’apprenant anonymes (borne supérieure du nombre de personnes) | 1 053 |
| Questions distinctes | 11 987 |
| Points de connaissance | 39 |
| Couverture temporelle | du 2 au 13 août 2026 (12 jours) ; le premier jour est incomplet |
| Date de gel de l’instantané | 2026-08-14T00:00:00Z |
| Événements de première tentative | 52 934 |
| Premières tentatives en contexte de quiz (ensemble principal) | 37 245 |
| Identifiants d’apprenant dans l’ensemble principal | 688 |
| Premières tentatives en contexte de leçon (ensemble de comparaison) | 15 741 |
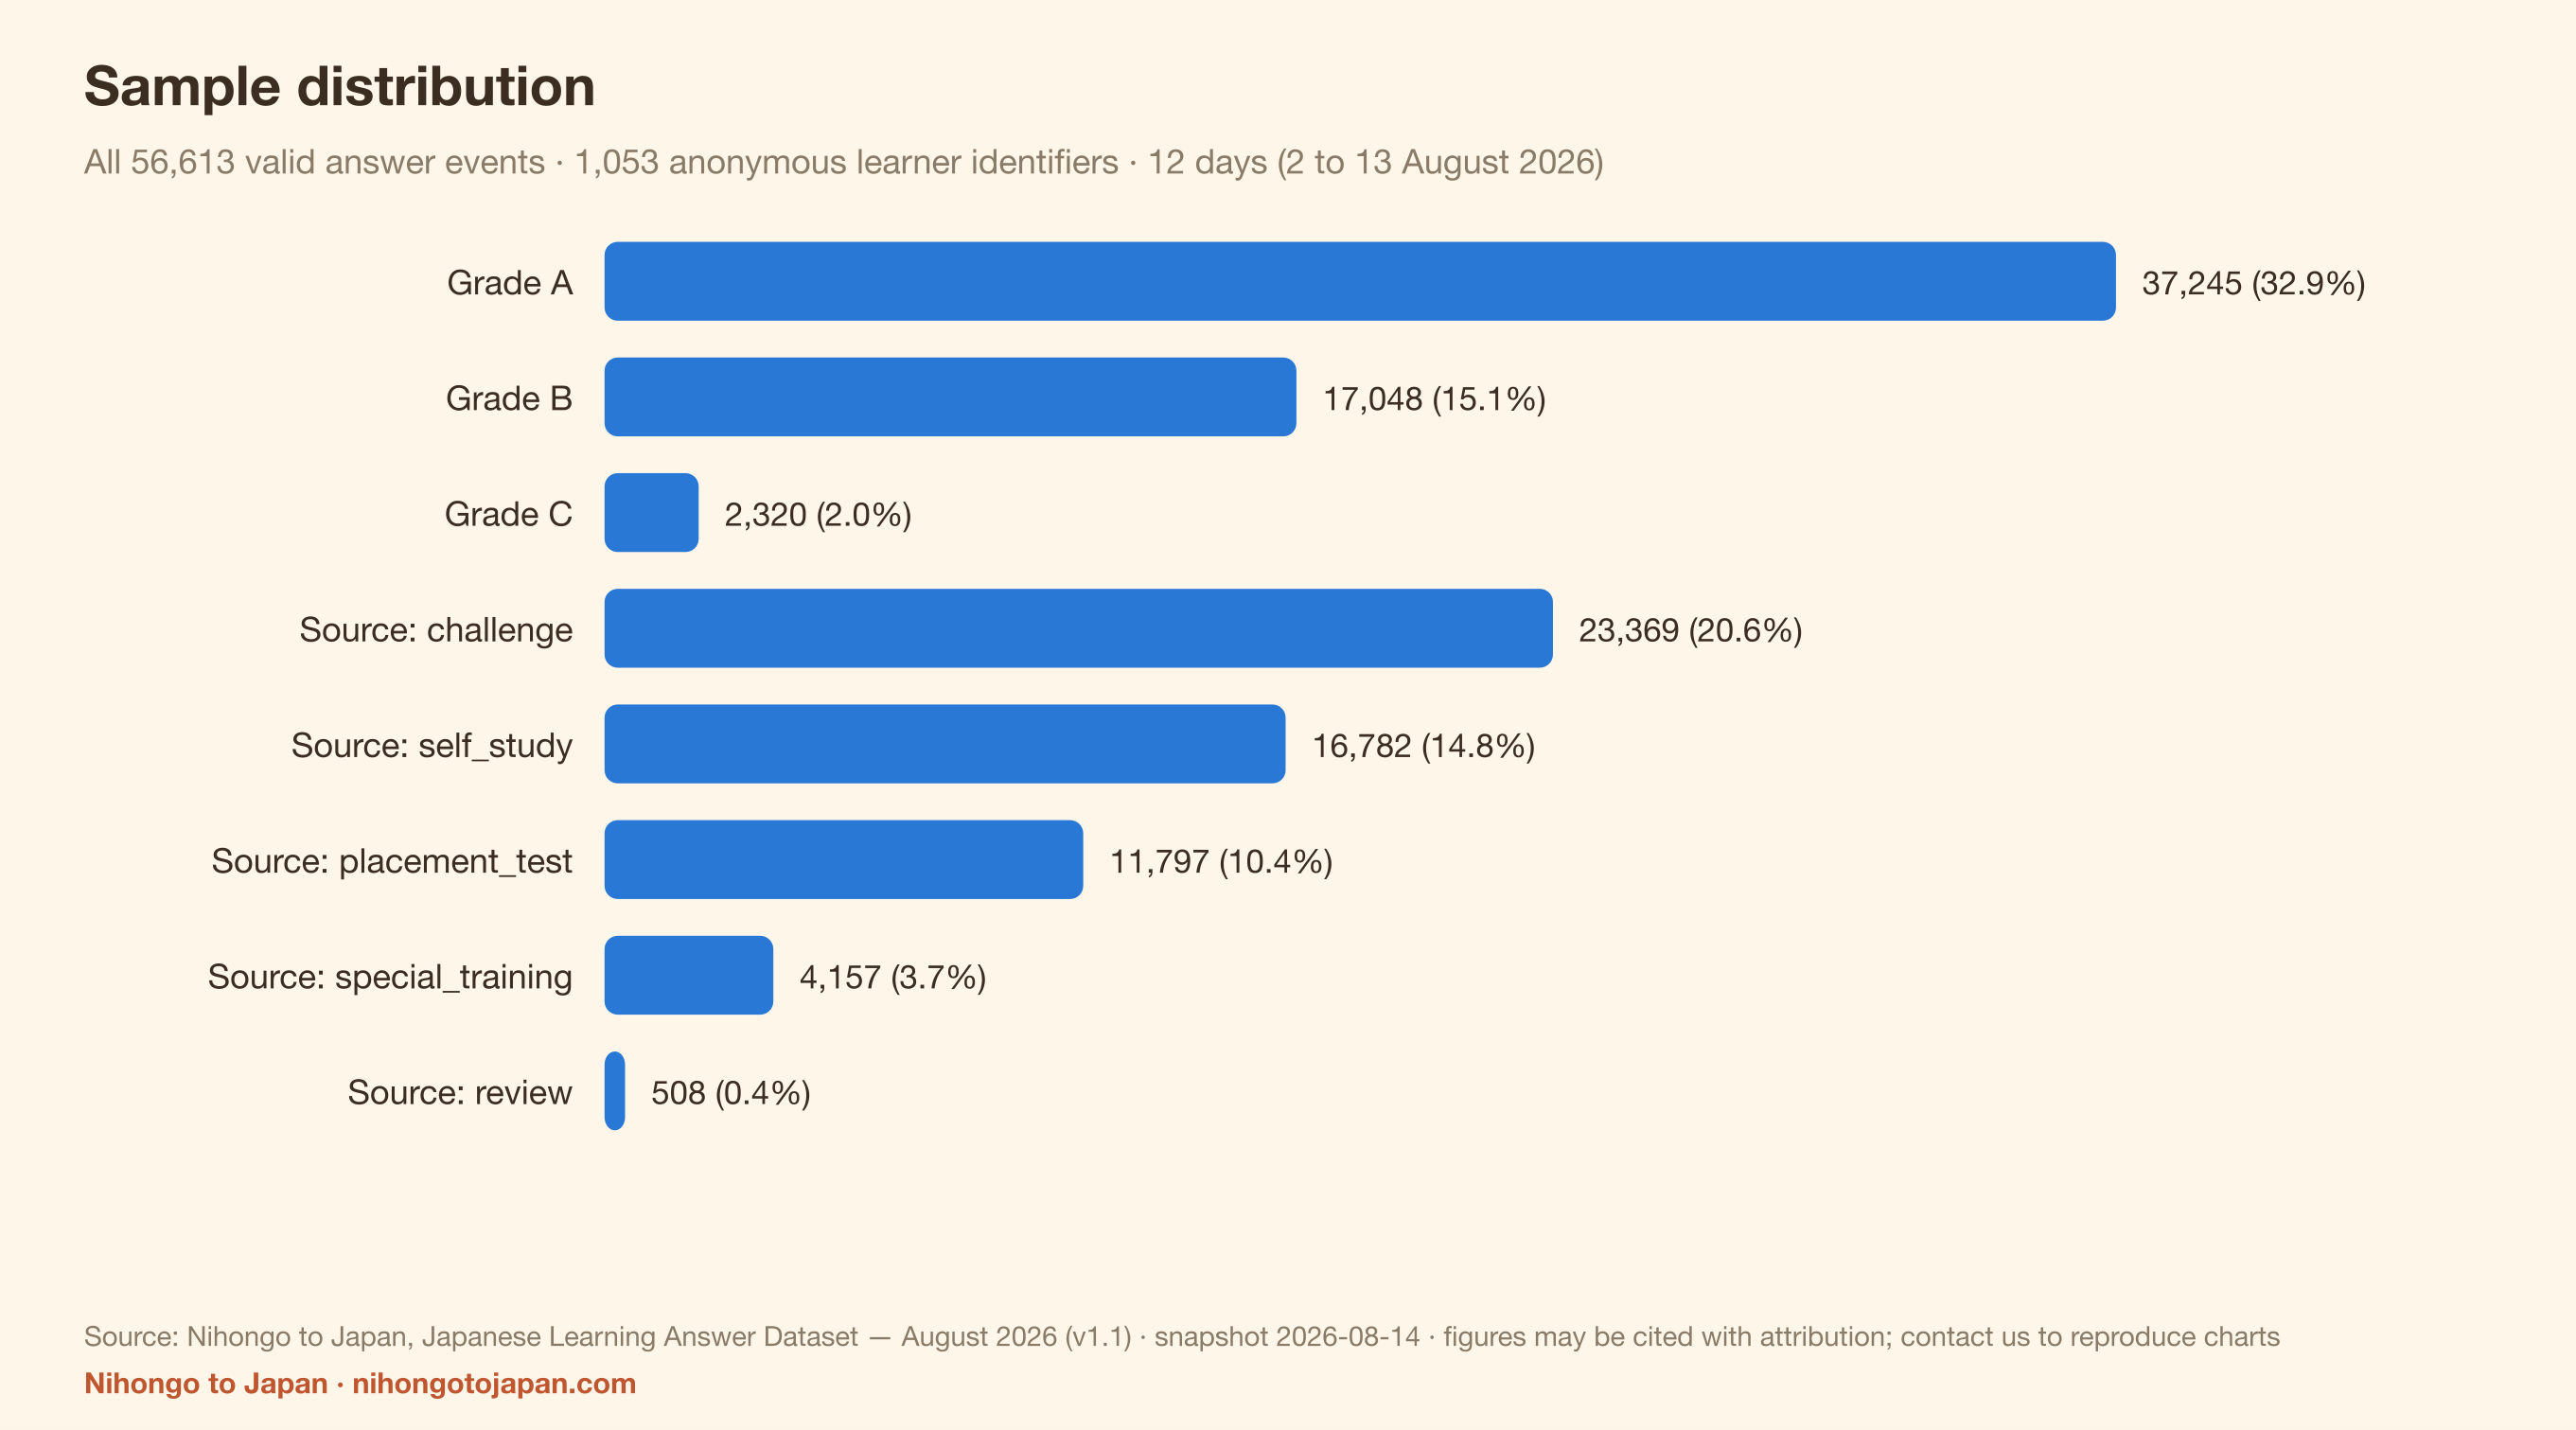
Réponses par source : challenge 23 369 (41,3%), self_study 16 782 (29,6%), placement_test 11 797 (20,8%), special_training 4 157 (7,3%), review 508 (0,9%).
Répartition de la colonne evidence_class de la base de données (un champ brut de la table, et non le nom d’un ensemble d’analyse de ce rapport) : A 37 245 (65,8%), B 17 048 (30,1%), C 2 320 (4,1%). L’ensemble d’analyse principal correspond exactement à evidence_class = A.

3. Taux de réussite par axe d’apprentissage

| Axe de compétence | n | Identifiants | Taux de réussite brut | IC à 95% | Indicateur |
|---|---|---|---|---|---|
| Structures grammaticales | 8 678 | 532 | 53,7% | 52,6%–54,7% | OK |
| Particules | 1 986 | 137 | 69,1% | 67,1%–71,1% | OK |
| Formes / conjugaison | 2 322 | 386 | 83,2% | 81,7%–84,7% | OK |
| Expressions idiomatiques | 1 341 | 261 | 86,4% | 84,5%–88,2% | OK |
| Vocabulaire | 22 869 | 627 | 92,1% | 91,8%–92,5% | OK |
Les axes suivants n’atteignent pas la taille minimale de cellule (n<30 ou moins de 5 identifiants d’apprenant) : aucun taux de réussite n’est publié, seulement le nombre d’événements : Mixte / polyvalent (n=27, 8 identifiants), Compréhension écrite (n=22, 4 identifiants).
4. Taux de réussite par niveau du JLPT
⚠️ C’est la section la plus facile à mal interpréter. Chaque niveau repose sur un ensemble de questions entièrement différent, et aucun équilibrage de difficulté par IRT n’a été effectué. Les chiffres ci-dessous indiquent la proportion de bonnes réponses à ces questions précises — et non une mesure du niveau le plus difficile.

| Niveau du JLPT | n | Identifiants | Taux de réussite brut | IC à 95% |
|---|---|---|---|---|
| N5 | 19 395 | 380 | 90,2% | 89,8%–90,6% |
| N4 | 6 099 | 313 | 73,4% | 72,3%–74,5% |
| N3 | 5 985 | 432 | 67,8% | 66,6%–69,0% |
| N2 | 2 726 | 212 | 69,4% | 67,6%–71,1% |
| N1 | 3 040 | 139 | 76,0% | 74,4%–77,5% |
Les mêmes niveaux dans les quatre ensembles d’analyse :
| Niveau | Premières tentatives, quiz (principal) | Premières tentatives, leçon | Premières tentatives (toutes) | Tous les événements |
|---|---|---|---|---|
| N5 | 90,2% (n=19 395) | 83,7% (n=11 154) | 87,8% (n=30 495) | 88,2% (n=33 286) |
| N4 | 73,4% (n=6 099) | 83,1% (n=2 694) | 76,5% (n=8 758) | 76,6% (n=9 262) |
| N3 | 67,8% (n=5 985) | 82,1% (n=1 507) | 70,8% (n=7 522) | 71,1% (n=7 727) |
| N2 | 69,4% (n=2 726) | 79,2% (n=260) | 70,2% (n=2 985) | 70,5% (n=3 072) |
| N1 | 76,0% (n=3 040) | 86,5% (n=126) | 76,4% (n=3 174) | 76,5% (n=3 266) |
5. Points de connaissance aux taux de réussite les plus bas
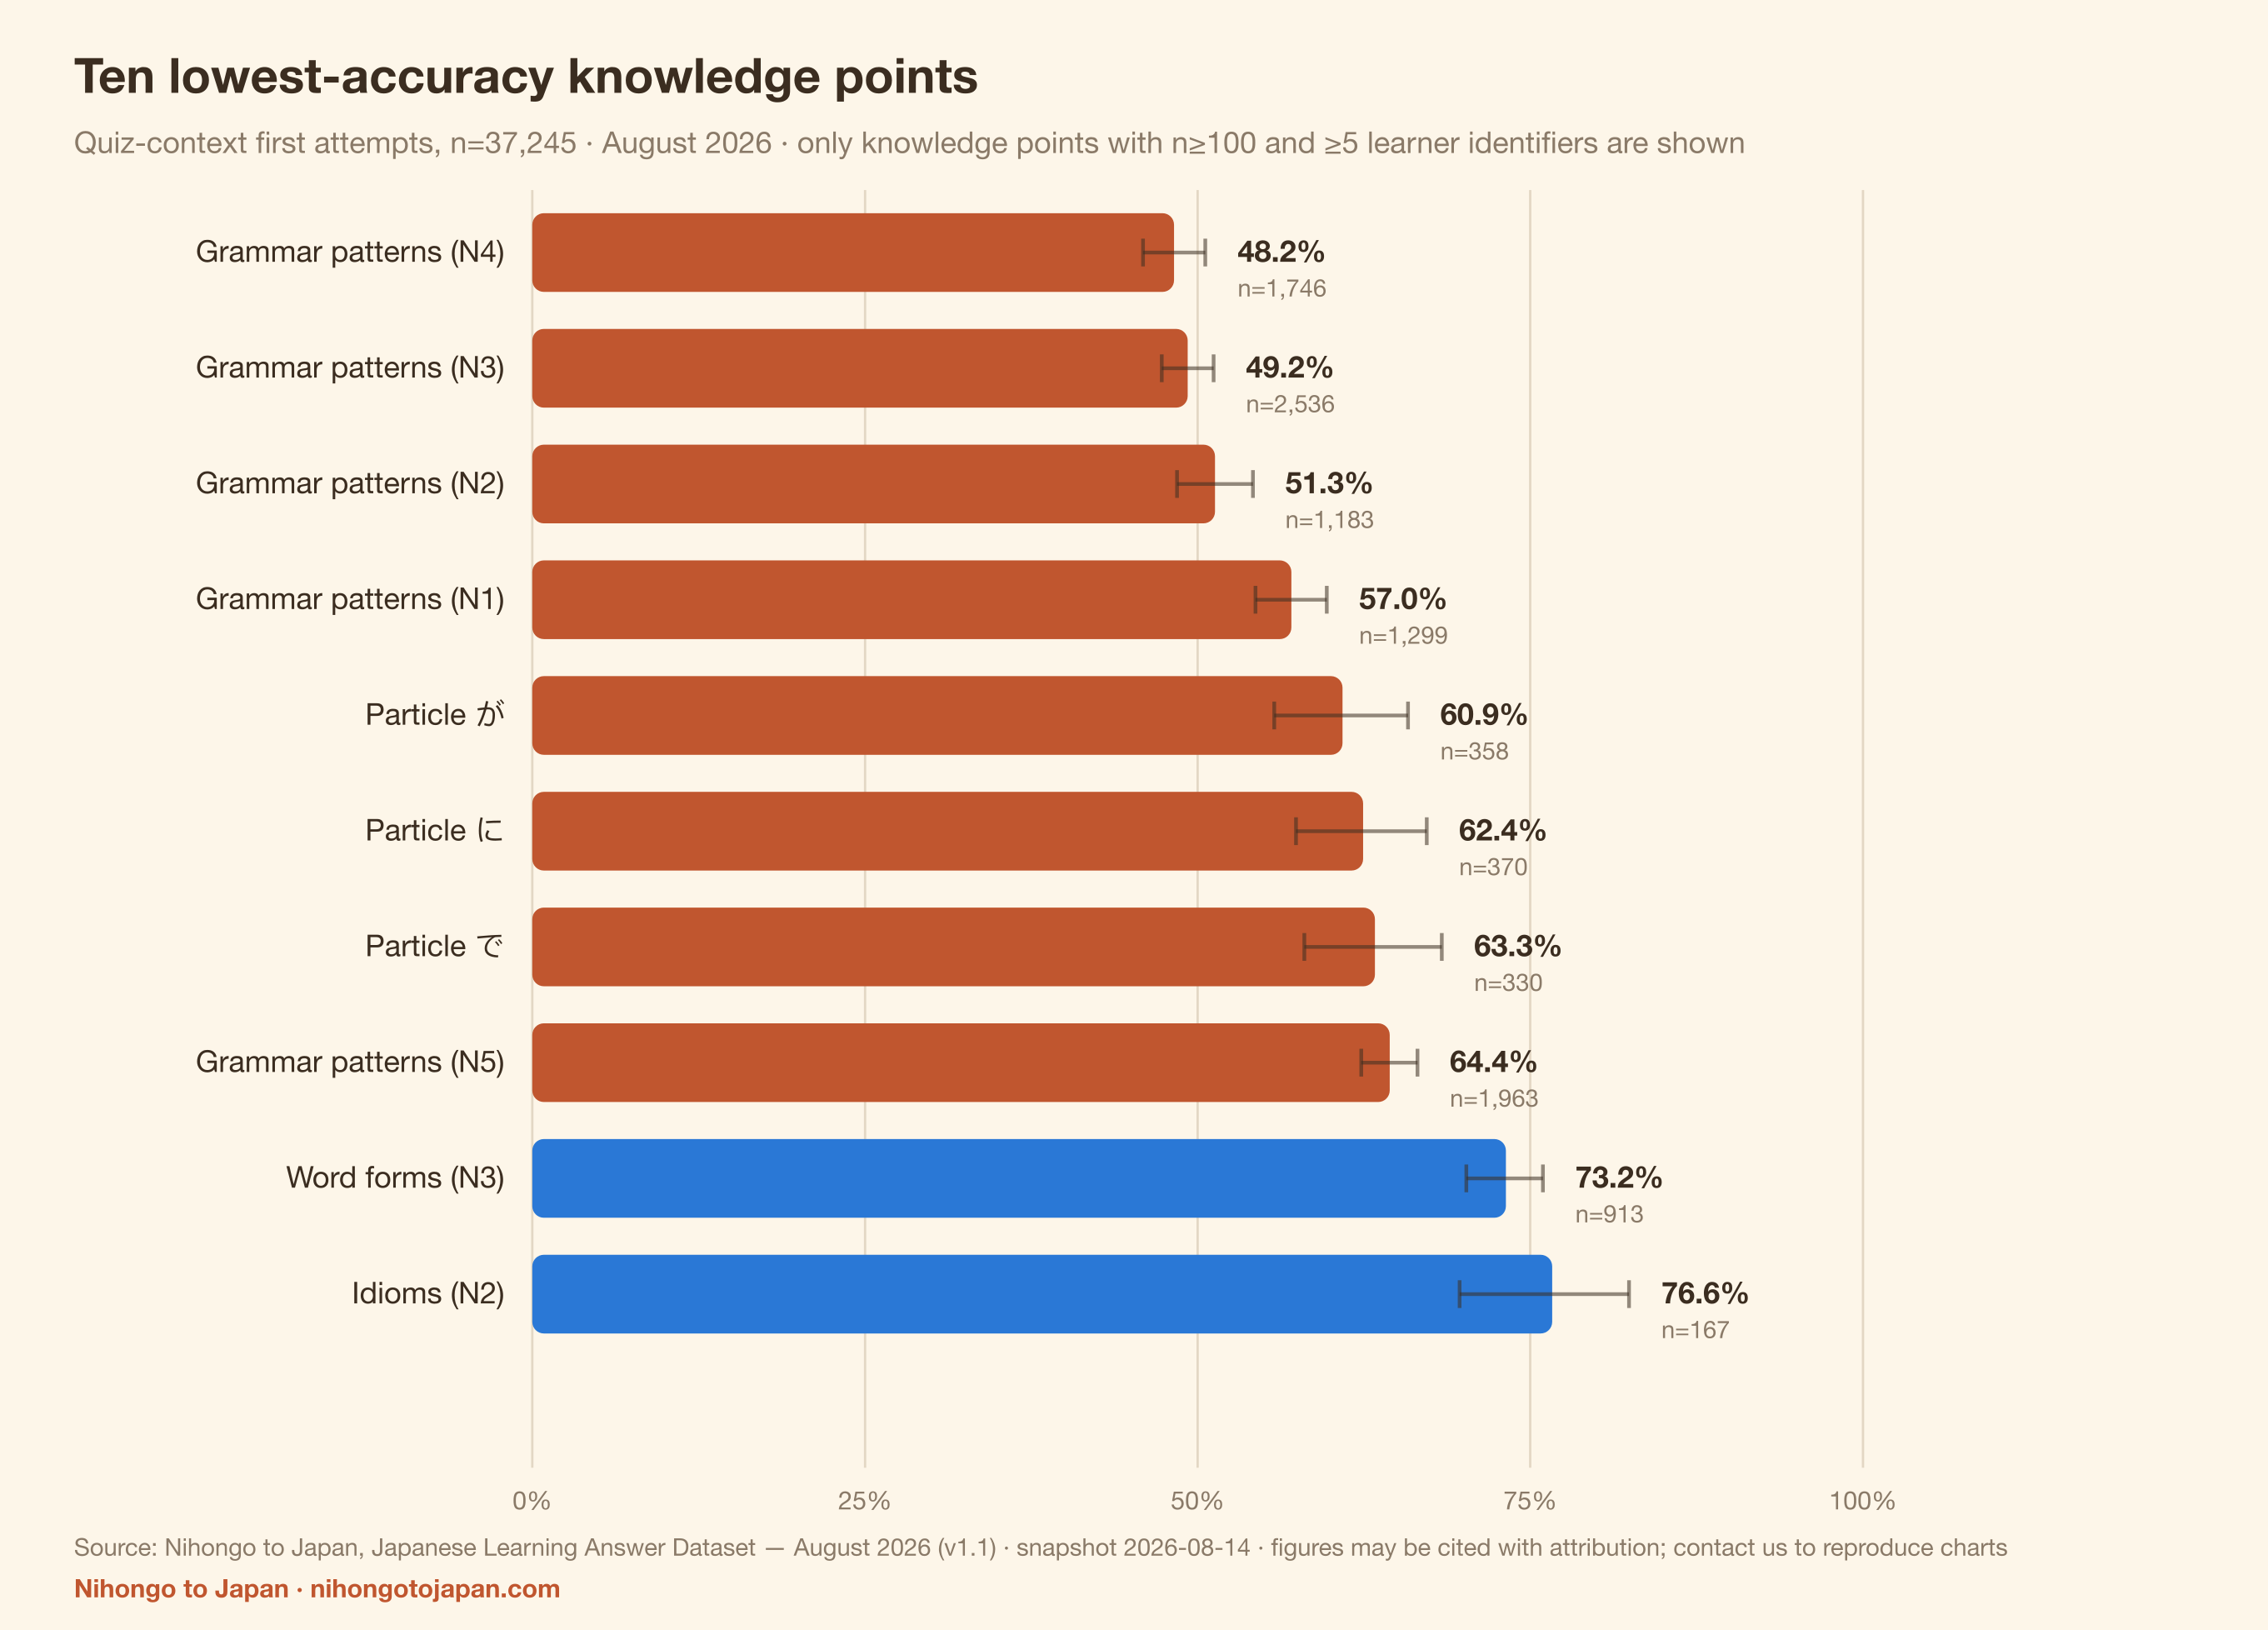
Seuls figurent les points de connaissance avec n≥100 et au moins 5 identifiants d’apprenant (23 remplissent ces conditions). Le n, le niveau et la catégorie sont indiqués à côté du pourcentage : les petites cellules paraissent extrêmes pour des raisons qui relèvent le plus souvent du simple bruit.

| # | Point de connaissance | Catégorie | Niveau | n | Identifiants | Taux de réussite brut | IC à 95% |
|---|---|---|---|---|---|---|---|
| 1 | Structures grammaticales (N4) | Structures grammaticales | N4 | 1 746 | 234 | 48,2% | 45,9%–50,6% |
| 2 | Structures grammaticales (N3) | Structures grammaticales | N3 | 2 536 | 390 | 49,2% | 47,3%–51,2% |
| 3 | Structures grammaticales (N2) | Structures grammaticales | N2 | 1 183 | 191 | 51,3% | 48,5%–54,1% |
| 4 | Structures grammaticales (N1) | Structures grammaticales | N1 | 1 299 | 118 | 57,0% | 54,3%–59,7% |
| 5 | Particule が | Particules | — | 358 | 81 | 60,9% | 55,8%–65,8% |
| 6 | Particule に | Particules | — | 370 | 75 | 62,4% | 57,4%–67,2% |
| 7 | Particule で | Particules | — | 330 | 85 | 63,3% | 58,0%–68,3% |
| 8 | Structures grammaticales (N5) | Structures grammaticales | N5 | 1 963 | 209 | 64,4% | 62,3%–66,5% |
| 9 | Formes (N3) | Formes | N3 | 913 | 294 | 73,2% | 70,2%–75,9% |
| 10 | Expressions idiomatiques (N2) | Expressions idiomatiques | N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| 11 | Particule を | Particules | — | 385 | 61 | 78,7% | 74,3%–82,5% |
| 12 | Formes (N2) | Formes | N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
6. Points forts les plus constants
| # | Point de connaissance | Catégorie | Niveau | n | Identifiants | Taux de réussite brut | IC à 95% |
|---|---|---|---|---|---|---|---|
| 1 | Formes (N1) | Formes | N1 | 296 | 79 | 95,6% | 92,6%–97,4% |
| 2 | Vocabulaire (N5) | Vocabulaire | N5 | 16 029 | 311 | 94,4% | 94,0%–94,8% |
| 3 | Vocabulaire (N1) | Vocabulaire | N1 | 703 | 94 | 89,2% | 86,7%–91,3% |
| 4 | Vocabulaire (N4) | Vocabulaire | N4 | 2 828 | 243 | 89,0% | 87,8%–90,1% |
| 5 | Expressions idiomatiques (N1) | Expressions idiomatiques | N1 | 742 | 111 | 88,8% | 86,3%–90,9% |
| 6 | Formes (N4) | Formes | N4 | 461 | 149 | 87,0% | 83,6%–89,8% |
| 7 | Expressions idiomatiques (N4) | Expressions idiomatiques | N4 | 140 | 91 | 86,4% | 79,8%–91,1% |
| 8 | Expressions idiomatiques (N3) | Expressions idiomatiques | N3 | 290 | 142 | 85,9% | 81,4%–89,4% |
7. Tendances observées à noter
Observation A : le taux de réussite brut du N1 dépasse ceux du N2 et du N3
Le N1, à 76,0% (n=3 040, 139 identifiants), se situe au-dessus du N2 (69,4%) et du N3 (67,8%).
Il s’agit d’une tendance observée, et non d’une preuve que le N1 est plus facile. Au moins trois explications ne peuvent pas être écartées avec ces données : seuls 139 identifiants ont répondu à des questions de N1, contre 432 pour le N3, de sorte que la composition des groupes diffère ; les ensembles de questions diffèrent ; et aucune estimation des compétences n’a été réalisée. Pour savoir « quel niveau est réellement plus difficile », il faudrait un équilibrage IRT et un dispositif d’items d’ancrage, dont ce jeu de données est dépourvu.
Observation B : l’axe des structures grammaticales est le plus bas à chaque niveau
| Axe × niveau | n | Identifiants | Taux de réussite brut | IC à 95% |
|---|---|---|---|---|
| Structures grammaticales × N4 | 1 734 | 233 | 48,0% | 45,6%–50,3% |
| Structures grammaticales × N3 | 2 531 | 389 | 49,2% | 47,2%–51,1% |
| Structures grammaticales × N2 | 1 179 | 191 | 51,1% | 48,3%–54,0% |
| Structures grammaticales × N1 | 1 295 | 118 | 57,0% | 54,3%–59,7% |
| Particules × N4 | 766 | 92 | 58,5% | 55,0%–61,9% |
| Structures grammaticales × N5 | 1 939 | 208 | 64,0% | 61,8%–66,1% |
| Formes / conjugaison × N3 | 948 | 302 | 74,2% | 71,3%–76,8% |
| Particules × N5 | 1 220 | 111 | 75,8% | 73,3%–78,1% |
| Expressions idiomatiques × N2 | 167 | 62 | 76,6% | 69,7%–82,4% |
| Formes / conjugaison × N2 | 278 | 107 | 80,2% | 75,1%–84,5% |
En croisant axe et niveau, presque toutes les cellules les plus basses relèvent des structures grammaticales. C’est plus instructif que la seule ventilation par niveau.
8. Ce que les enseignants et les concepteurs de supports peuvent en tirer
Cette section sépare délibérément les données de l’interprétation. Les données peuvent être citées ; l’interprétation relève de notre jugement, et vous êtes libre de ne pas la partager.
| Données (citables) | Interprétation (notre jugement, pas des données) |
|---|---|
| Premières tentatives en contexte de quiz : axe des structures grammaticales 53,7% contre vocabulaire 92,1% (n=8 678 et 22 869) | Sur cette plateforme, il existe un net écart entre reconnaître des mots et construire des phrases. S’il faut répartir le temps d’entraînement, les structures grammaticales offrent peut-être le meilleur rendement marginal. |
| が 60,9%, に 62,4% et で 63,3% se situent nettement en dessous de を 78,7% et の 83,3% | を et の ont des fonctions relativement restreintes, alors que が, に et で sont fortement polysémiques. Enseigner séparément les différentes fonctions d’une même particule pourrait être plus efficace que de présenter les particules une par une. |
| Les taux de réussite bruts du N2 et du N3 (69,4% / 67,8%) se situent en dessous de ceux du N4, du N1 et du N5 | ⚠️ Ne vous en servez pas pour classer les niveaux par difficulté. Une lecture plus plausible est que les apprenants qui répondent au N2/N3 diffèrent par leur composition de ceux des autres niveaux, plutôt qu’une différence liée aux questions. |
| Structures grammaticales : 85,4% en contexte de leçon (n=13 937) contre 53,7% en contexte de quiz (n=8 678) ; différence appariée de +27,5 pts sur 75 identifiants | Répondre pendant une leçon et répondre lors d’un quiz donnent des résultats très différents : à garder à l’esprit lorsque des scores d’entraînement sur une plateforme servent à juger des acquis. ⚠️ Mais les deux contextes utilisent des ensembles de questions presque disjoints : impossible de dire si cela tient au contexte ou simplement à des questions plus faciles. |
9. Méthodologie
| Élément | Détail |
|---|---|
| Population | Réponses enregistrées par les apprenants qui utilisent Nihongo to Japan. |
| Échantillonnage | Échantillon observationnel auto-sélectionné. Pas d’échantillonnage aléatoire ; non représentatif de la population. |
| Unité d’analyse | événement de réponse (un identifiant d’apprenant répondant une fois à une question). |
| Nombre d’utilisateurs | identifiants d’apprenant = identifiants anonymes distincts. Ils ne peuvent pas être fusionnés d’un appareil à l’autre : il s’agit donc d’une borne supérieure du nombre de personnes, et non d’un décompte vérifié. |
| Indicateur | taux de réussite brut = bonnes réponses ÷ événements de réponse valides. Ce n’est pas une estimation des compétences. |
| Intervalles de confiance | IC de Wilson à 95%. Ne reflète que l’erreur d’échantillonnage ; ne corrige pas le biais de sélection. |
Quatre ensembles d’analyse
| Ensemble | Définition | n |
|---|---|---|
| Premières tentatives en contexte de quiz (ensemble d’analyse principal) | Réponses provenant de challenge / placement_test / special_training lorsqu’il s’agit de la première tentative de l’identifiant d’apprenant sur cette question, qui n’est pas une répétition dans les 24 heures et dont les métadonnées de question sont complètes. | 37 245 |
| Premières tentatives en contexte de leçon (ensemble de comparaison) | Premières tentatives provenant de self_study / review — réponses données en parcourant les supports de cours. | 15 741 |
| Premières tentatives (tous contextes) | Première réponse de chaque identifiant d’apprenant à chaque question, quelle qu’en soit la source. | 52 934 |
| Ensemble des événements de réponse | Tous les événements de réponse valides, répétitions comprises. | 56 613 |
⚠️ L’ensemble principal n’affirme rien au sujet des indices ou des explications. Les champsused_hint/viewed_explanation/used_answer_keyvalent false dans toute la base de données, mais uniquement parce qu’aucun producteur ne les renseigne jamais : aucun des points d’appel qui enregistrent les réponses ne transmet ces paramètres, et le produit ne propose actuellement aucune fonction d’indice avant réponse ni d’affichage de la solution. Cette valeur constamment false est une propriété de l’instrumentation, et non une preuve concernant le comportement des apprenants. Ces champs ne sont donc pas utilisés comme conditions d’analyse, et rien n’est affirmé sur l’usage des indices.
Vérification indépendante de l’ensemble principal : en recalculant côté serveur l’événement le plus ancien pour chaque couple (identifiant, question), 99,59% des événements de l’ensemble principal (37 094 sur 37 245) passent le test de première tentative. Les 151 restants s’expliquent très probablement par l’usage de plusieurs appareils — une même personne répondant sur deux appareils, chacun enregistrant une première tentative. Tous les événements de l’ensemble ont attempt_number = 1.
Ce qui est exclu
- Questions défectueuses connues : 520 identifiants de question sont exclus de toutes les agrégations. Deux causes : (1) des exercices à trous non grammaticaux issus des supports de cours (conversion en kana, orthographe, réponses numériques) classés à tort dans l’axe des structures grammaticales ; (2) une ancienne version de la « question du jour » qui utilisait le jeton de réponse comme identifiant de question, regroupant ainsi des questions différentes sous un même identifiant. Le front-end a été corrigé ; les données historiques sont exclues au moyen d’une liste d’exclusion. Aucun événement brut n’a été supprimé : la table fonctionne en ajout seul.
- Événements postérieurs à la date de gel de l’instantané : ce rapport est figé au 2026-08-14T00:00:00Z. Les données continuent de s’accumuler, mais chaque chiffre de cette page et des fichiers téléchargeables provient de ce seul point figé.
Taille minimale de cellule
Les cellules avec n<30 ou moins de 5 identifiants d’apprenant sont marquées SUPPRESSED : le nombre d’événements est publié, mais pas le taux de réussite. Les cellules avec n≥30 et ≥5 identifiants, mais n<100, sont marquées LOW_SAMPLE et doivent toujours être citées avec leur n. Les cellules avec n≥100 et ≥5 identifiants sont marquées OK.
Dans cet instantané, 23 points de connaissance sont OK, 12 sont LOW_SAMPLE et 3 sont SUPPRESSED.
Anonymisation
- Chaque événement ne comporte qu’un UUID d’appareil anonyme généré dans le navigateur. Aucun nom, adresse e-mail, adresse IP, empreinte d’appareil ni saisie de texte libre d’aucune sorte.
- La Cloudflare Pages Function qui reçoit les données n’écrit que des colonnes figurant sur une liste blanche et n’écrit explicitement jamais d’adresse IP.
- Le jeu de données public ne contient que des statistiques agrégées — pas un seul événement de réponse brut.
- Les apprenants peuvent refuser la collecte agrégée en un clic sur la page de la politique de confidentialité.
10. Limites (merci de les citer avec les chiffres)
Si vous ne deviez lire qu’un paragraphe, lisez celui-ci. Ces données décrivent les résultats obtenus, sur des questions de Nihongo to Japan, par des personnes venues s’entraîner sur Nihongo to Japan. Elles ne dressent pas un portrait des apprenants de japonais à Taïwan, ne mesurent pas la difficulté du JLPT et ne peuvent pas servir à comparer la difficulté objective des différents niveaux.
- Biais de sélection : l’échantillon se compose de personnes qui ont choisi de s’entraîner ici. Elles sont probablement plus motivées que les apprenants en général, et peut-être plus jeunes et plus à l’aise avec les outils en ligne.
- Mesures répétées : l’identifiant le plus actif représente à lui seul 3,7% de toutes les réponses, et les dix premiers 19,4%. Sur les mêmes 372 identifiants, la pondération par événement et la pondération par identifiant diffèrent de 7,04 points de pourcentage.
- Les ensembles d’analyse ne peuvent pas être directement soustraits : les contextes de leçon et de quiz reposent sur des ensembles de questions presque disjoints (sur 5 772 questions de structures grammaticales, seules 6 apparaissent dans les deux) ; l’écart de taux de réussite entre eux ne peut donc pas être attribué à une cause unique.
- Le recours aux indices et aux explications n’est pas observable : les champs correspondants ne sont jamais renseignés ; ce jeu de données n’affirme donc absolument rien à leur sujet.
- Difficulté inégale des questions : chaque niveau et chaque axe reposent sur un ensemble de questions différent ; le taux de réussite brut n’est donc pas une mesure de difficulté normalisée.
- Pas d’équilibrage IRT : il n’y a ni équilibrage selon la théorie de la réponse à l’item, ni dispositif d’items d’ancrage entre les niveaux ; ces données ne permettent donc pas de dire quel niveau est le plus difficile.
- Tailles d’échantillon inégales : il y a plus de six fois plus de réponses au N5 qu’au N1.
- Fenêtre temporelle courte : 12 jours seulement (le pipeline d’agrégation a été mis en service le 2026-08-02). Aucune tendance longitudinale ne peut être tirée de ces données.
- Le trafic automatisé ne peut pas être identifié : aucun mécanisme ne permet de distinguer les humains des scripts. Le temps de réponse n’est pas renseigné (null) pour 94% des événements ; même un filtre élémentaire des réponses « impossiblement rapides » est donc indisponible. Il s’agit d’une lacune connue de la qualité des données.
- Non représentatif de la population : l’échantillon ne représente pas l’ensemble des apprenants de japonais à Taïwan ni dans aucun autre pays.
11. Comment citer
Les citations dans des articles scientifiques, des rapports de recherche, des supports pédagogiques et des articles de presse sont les bienvenues. Merci de mentionner la source avec un lien vers cette page.
APA (7e édition)
Nihongo to Japan. (2026). Japanese learning answer dataset — August 2026 (Version 1.1.0) [Data set]. https://www.nihongotojapan.com/en/research/japanese-learning-data-2026MLA (9e édition)
Nihongo to Japan. Japanese Learning Answer Dataset — August 2026. Version 1.1.0, 2026, https://www.nihongotojapan.com/en/research/japanese-learning-data-2026.BibTeX
@misc{ntj_jlad_2026,

  title = {Japanese Learning Answer Dataset --- August 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {1.1.0},

  note = {Snapshot 2026-08-14; aggregate statistics from 56,613 anonymous answer events, 2--13 August 2026},

  url = {https://www.nihongotojapan.com/en/research/japanese-learning-data-2026}

}
Statut de la licence
Les données sont publiées sous licence CC BY 4.0 : leur utilisation est libre, y compris à des fins commerciales, à condition d’en mentionner la source. Les graphiques et le texte du rapport ne sont pas couverts. Conditions complètes dans la section Licence.
Mention d’attribution suggérée :
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Licence : les données sont sous CC BY 4.0
Les données de ce jeu de données sont publiées sous licence Creative Commons Attribution 4.0 International (CC BY 4.0). Vous pouvez les copier, les redistribuer, les adapter et les réutiliser, y compris à des fins commerciales, à condition de créditer la source de manière appropriée et d’indiquer si des modifications ont été apportées.
⚠️ La licence ne couvre que les données. Ce que couvre la CC BY 4.0 : les chiffres agrégés de cette page et les deux fichiers téléchargeables,japanese-learning-2026.jsonetjapanese-learning-2026.csv. Les graphiques produits par Nihongo to Japan (SVG/PNG) et le texte du rapport ne sont pas couverts : tous droits réservés.
Ce que vous pouvez faire sans nous demander
- Citer les statistiques dans des articles scientifiques, des rapports de recherche, des supports pédagogiques et des articles de presse, y compris dans des publications commerciales.
- Réanalyser les chiffres agrégés et produire vos propres graphiques : les graphiques que vous réalisez vous appartiennent.
- Adapter, remixer, transformer et redistribuer sous quelque forme que ce soit, y compris redistribuer les fichiers de données dans leur intégralité ou les intégrer à votre propre produit de données.
- Utiliser les données en classe et dans des contextes éducatifs.
Attribution
Nihongo to Japan, Japanese Learning Answer Dataset — August 2026, v1.1.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026Ce que nous vous demandons (et qui ne relève pas de la licence)
Les demandes suivantes ne sont pas des conditions de la licence CC BY, et ne pas les respecter ne constitue pas une violation. Nous les formulons malgré tout, raison à l’appui :
- Mentionnez les limites de l’échantillonnage (échantillon observationnel auto-sélectionné, 12 jours seulement, non représentatif) : citer les chiffres sans elles revient à publier une statistique trompeuse.
- Faites un lien vers cette page, afin que vos lecteurs puissent consulter la méthodologie et la version.
- Écrivez « identifiants d’apprenant », et non « personnes » : le nombre d’identifiants est une borne supérieure du nombre de personnes, et non un décompte.
- Indiquez la version (par exemple v1.1.0, instantané du 2026-08-14), afin que les chiffres que vous avez cités restent identifiables après les mises à jour ultérieures.
Ce que la licence ne couvre pas
- Les graphiques que nous avons produits (
/images/research/*.svget*.png) : merci de nous contacter avant de les reproduire. Réaliser vos propres graphiques à partir des données ne nécessite aucune autorisation. - Le texte du rapport et de ce site : tous droits réservés.
- Le nom du site, le logo et les éléments de marque : cette licence ne confère aucun droit de les utiliser.
⚠️ La licence CC BY est irrévocable. Toute personne qui reçoit les données selon ces conditions conserve ces droits, même si nous modifions les conditions par la suite. Nous le précisons ici parce que quiconque cite ces données a le droit de savoir à quel point son autorisation est stable.
12. Télécharger les données
Deux formats au contenu identique, tous deux composés uniquement de statistiques agrégées (aucun événement de réponse brut) :
- japanese-learning-2026.json — métadonnées complètes, définitions, méthodologie, limites et toutes les cellules agrégées.
- japanese-learning-2026-LICENSE.txt — l’avis de licence (CC BY 4.0, périmètre, mention d’attribution). Un CSV ne peut pas le contenir ; il est donc fourni à part.
- japanese-learning-2026.csv — une ligne par cellule. Colonnes :
dimension, key, label_zh, label_en, category, jlpt_level, analysis_set, n, learners, accuracy, ci95_low, ci95_high, flag.
Version 1.1.0 · instantané du 2026-08-14 · version de la méthodologie 1.1. Les mises à jour futures incrémenteront le numéro de version et conserveront les chiffres antérieurs au lieu de les écraser.
Fichiers des graphiques : les quatre graphiques de cette page sont disponibles en PNG (résolution 2×, pour les présentations et la mise en page imprimée) et en SVG (vectoriel, redimensionnable).
- Taux de réussite brut par axe d’apprentissage : PNG・SVG
- Taux de réussite brut par niveau du JLPT : PNG・SVG
- Points de connaissance aux taux de réussite les plus bas : PNG・SVG
- Répartition de l’échantillon : PNG・SVG
Chaque graphique comporte son propre titre, son n, sa version et la mention de sa source : il indique donc son propre périmètre même lorsqu’il circule seul. Les textes alternatifs des quatre graphiques sont réunis dans alt-text.json. ⚠️ Les graphiques ne sont pas couverts par la licence CC BY : merci de nous contacter avant de les reproduire (voir contact) ; les données elles-mêmes sont sous CC BY 4.0 et libres d’utilisation avec attribution (voir Licence).
⚠️ Pour citer, utilisez le jeu de données figé et versionné plutôt que le point d’accès agrégé actualisé périodiquement.
Un point d’accès agrégé actualisé périodiquement existe également à l’adresse /api/aggregates ; ses chiffres évoluent dans le temps (il ne s’agit pas d’une version figée). Il repose sur des définitions différentes : une base « ensemble des événements de réponse » plutôt que les premières tentatives en contexte de quiz, et son champ totalUsers ne compte que les identifiants d’apprenant de l’ensemble principal (688), et non les 1 053. Ses chiffres changent chaque jour et ne se prêtent pas à la citation.
Pour les journalistes
- Échantillon : 56 613 réponses anonymes provenant de 1 053 identifiants d’apprenant anonymes (pas un décompte vérifié de personnes) sur 12 jours, du 2 au 13 août 2026.
- La méthode en une phrase : taux de réussite brut sur un échantillon observationnel auto-sélectionné ; les chiffres clés reposent sur l’ensemble des premières tentatives en contexte de quiz (premières tentatives dans les contextes défi, test de niveau et entraînement intensif).
- La limite en une phrase : il ne s’agit pas d’une enquête représentative des apprenants de japonais, et ces données ne peuvent pas servir à comparer la difficulté objective des niveaux du JLPT.
Trois chiffres à citer tels quels :
- Taux de réussite en structures grammaticales de 53,7% (n=8 678) contre 92,1% en vocabulaire (n=22 869), soit un écart de 38 points.
- La particule が obtient 60,9% de bonnes réponses (n=358) ; を atteint 78,7% (n=385).
- Le taux de réussite en structures grammaticales va de 53,7% à 74,1% selon les contextes de réponse pris en compte (contexte de leçon 85,4%, contexte de quiz 53,7%). ⚠️ Les deux contextes utilisent des ensembles de questions presque disjoints, si bien que la cause ne peut pas être établie — mais c’est en soi un sujet sur la manière dont les données des plateformes d’apprentissage sont citées.
Formats de citation · Télécharger les données · Contact
Intégrer ces données (à coller dans un article de blog ou un support pédagogique)
Collez le code HTML ci-dessous dans votre article ou votre document de cours. Il comporte déjà la taille de l’échantillon, la version, la licence et la mise en garde « non représentatif de la population » — précisément les éléments qui disparaissent lorsque des statistiques sont reprises de seconde main. Inutile de nous prévenir.
<blockquote style="margin:0;padding:16px 20px;border-left:4px solid #c0562f;background:#fdf6e9;color:#3b2d20;font-family:system-ui,sans-serif"><p style="margin:0 0 8px">Sur 56,613 réponses anonymes, le taux de réussite en structures grammaticales lors des premières tentatives en contexte de quiz était de <strong>53.7%</strong> (n=8,678), contre <strong>92.1%</strong> pour le vocabulaire (n=22,869).</p><p style="margin:0;font-size:13px;color:#8a7a68">Source : <a href="https://www.nihongotojapan.com/en/research/japanese-learning-data-2026">Nihongo to Japan, Japanese Learning Answer Dataset — August 2026</a> v1.1.0 · CC BY 4.0 · échantillon observationnel auto-sélectionné, non représentatif de la population</p></blockquote>
Pourquoi un bloc à coller plutôt qu’une iframe ? Pour deux raisons : ce site n’autorise pas son affichage dans un cadre (frame-ancestors 'none' sur l’ensemble du site, une protection contre le détournement de clic que nous préférons conserver) ; et le contenu d’une iframe est servi depuis notre domaine, il n’est donc pas perçu comme un lien donné par votre page — contrairement à un bloc collé. Vous êtes tout aussi libre d’en faire votre propre mise en page : les données sont sous CC BY 4.0, et nous ne demandons que l’attribution.
Pour les images : nos graphiques ne sont pas couverts par la licence, mais vous pouvez réaliser les vôtres à partir du CSV, et ce graphique vous appartiendra. Pour un usage pédagogique ou médiatique de nos propres graphiques, voir le dossier de presse.
Dossier de presse
Tout le contenu de cette section peut être copié et utilisé sans nous demander au préalable (à l’exception des graphiques — voir ci-dessous). Les faits essentiels et trois chiffres à citer tels quels se trouvent dans Pour les journalistes ; la série complète figure dans les dix constats à citer.
Texte de présentation
Version longue :
Nihongo to Japan est un site d’apprentissage du japonais géré de manière indépendante par un développeur seul. Il ne nécessite aucune inscription, son cours complet est gratuit pour toujours, et il couvre les niveaux N5 à N1 du JLPT au moyen d’explications grammaticales, de leçons en autonomie et de questions d’entraînement. Ce jeu de données est tiré des réponses anonymes enregistrées par les apprenants du site, agrégées à partir d’un instantané figé et publiées avec l’intégralité de leur méthodologie et de leurs limites.
Version courte :
Nihongo to Japan, site d’apprentissage du japonais géré de manière indépendante et dont le cours complet est gratuit pour toujours, publie un jeu de données agrégées issues des réponses anonymes de ses apprenants.
Images pour publication
Les graphiques que nous produisons ne sont pas couverts par la licence CC BY 4.0 (celle-ci ne couvre que les données — voir Licence). Nous ne voulons pas que cela devienne un obstacle ; il existe donc deux possibilités :
- Demandez-nous : nous envoyons des fichiers image prêts à publier sous 24 heures (PNG et SVG), avec la légende, la taille de l’échantillon et la mention de version correctes. C’est une voie rapide réservée aux images, plus rapide que les demandes générales (2 à 3 jours ouvrés).
- Ou n’attendez pas : réalisez les vôtres. Les données elles-mêmes sont sous CC BY 4.0 : vous pouvez construire vos propres graphiques directement à partir du JSON ou du CSV. Les graphiques que vous réalisez vous appartiennent : aucune autorisation n’est nécessaire, et inutile de nous prévenir.
Quatre remarques pour un traitement responsable
Ce ne sont pas des conditions : elles sont là pour vous éviter d’avoir à publier un rectificatif :
- ✅ Écrivez de préférence « dans cet ensemble de réponses » ou « lors des premières tentatives aux questions de quiz ». Chaque chiffre de cette page est une valeur observée au sein de ce jeu de données.
- ❌ N’en faites pas « les apprenants taïwanais font X ». L’échantillon se compose de personnes qui ont choisi de s’entraîner sur ce site ; il ne représente aucune population plus large.
- ❌ Ne comparez pas la difficulté des niveaux du JLPT. Les niveaux reposent sur des ensembles de questions différents, il n’y a pas d’équilibrage IRT et les intervalles de confiance du N3 et du N2 se chevauchent : ces données ne permettent pas de les distinguer.
- ❌ Ne formulez pas de lien de causalité. Les données permettent de dire « observés ensemble », pas « parce que ».
Si vous doutez qu’une formulation tienne la route, demandez-nous simplement — c’est bien moins coûteux qu’un rectificatif après publication.
Citations attribuables
Les deux citations ci-dessous peuvent être utilisées directement, sans demande préalable.
« Lors des premières tentatives aux questions de quiz, on obtient 92,1% en vocabulaire contre 53,7% en structures grammaticales. Cela ne décrit que les personnes qui ont choisi de s’entraîner sur notre site ; on ne peut pas le généraliser à l’ensemble des apprenants. Mais si vous en êtes au stade “je connais les mots, mais je n’arrive pas à construire la phrase”, vous n’êtes pas seul dans ce cas. »
— Fondateur, Nihongo to Japan
« Sur les mêmes données, il suffit de changer les réponses prises en compte pour que le taux de réussite en structures grammaticales passe de 53,7% à 85,4%. Nous publions les quatre définitions côte à côte, car un chiffre unique mis en avant ne permet pas au lecteur de savoir lequel il a sous les yeux. »
— Fondateur, Nihongo to Japan
Il n’y a ni équipe de recherche ni attaché de presse. Les citations ci-dessus sont attribuées à la personne qui a réellement construit ce jeu de données ; pour obtenir une réponse à une question précise, merci de passer par la section contact.
Pour les chercheurs et les enseignants
Structure : une ligne par cellule agrégée, indexée par dimension (axis / jlpt / knowledge_point / axis_x_jlpt) × analysis_set (quiz_first_attempt / lesson_first_attempt / first_attempt / all_events). Chaque cellule indique n, learners, accuracy, les bornes de Wilson ci95_low/ci95_high et un flag. Le JSON contient en outre la décomposition par ensemble d’analyse, la comparaison appariée et l’effet de pondération.
Échantillonnage : auto-sélectionné et observationnel ; l’unité d’analyse est l’événement de réponse ; un identifiant d’apprenant est un UUID anonyme, si bien que le nombre d’identifiants est une borne supérieure du nombre de personnes (une même personne sur deux appareils produit deux identifiants, et les identifiants ne peuvent pas être reliés entre eux).
Lacunes méthodologiques connues — nous estimons qu’il vaut mieux les signaler que les cacher :
- Pas d’équilibrage de difficulté par IRT ni d’items d’ancrage entre niveaux : les comparaisons entre niveaux ne tiennent donc pas.
- Les contextes de leçon et de quiz reposent sur des ensembles de questions presque disjoints (seules 6 des 5 772 questions de structures grammaticales se recoupent) : les effets de contexte et la difficulté des items ne peuvent donc pas être séparés.
- Les champs indice / explication / corrigé ne sont jamais renseignés : ces comportements sont donc inobservables. Ils ne peuvent pas servir de conditions d’analyse, et leur absence ne peut pas être interprétée comme « cela ne s’est pas produit ».
- Le temps de réponse n’est pas renseigné (null) pour 94% des événements : pas d’analyse du compromis vitesse–exactitude ni de filtrage des réponses invraisemblablement rapides.
- Aucune variable démographique (âge, langue maternelle, années d’étude, pays) : aucune analyse stratifiée n’est possible. Le jeu de données ne comporte ni champ de langue maternelle ni champ géographique ; ce rapport ne fait donc aucune inférence sur la langue maternelle ou la localisation des apprenants.
- Une fenêtre de 12 jours : pas de courbes d’apprentissage ni d’analyse de rétention.
- Les données individuelles des apprenants ne sont pas publiées (agrégats uniquement) : les modèles multiniveaux ne peuvent donc pas être réestimés de l’extérieur. Si c’est important pour vos recherches, contactez-nous.
Télécharger le JSON · Télécharger le CSV · Formats de citation · Méthodologie complète
Contact presse et données
Fondateur, Nihongo to Japan · E-mail : [email protected]
Nous répondons volontiers sur : les détails de la méthodologie, la revérification de tout chiffre agrégé, les demandes de reproduction des graphiques, les limites de ce que ces données permettent d’affirmer, et la capacité du jeu de données à répondre à une question précise. Réponse généralement sous 2 à 3 jours ouvrés ; les demandes d’images prêtes à publier émanant des médias bénéficient d’une voie rapide, avec réponse sous 24 heures (voir le dossier de presse).
Le site est géré de manière indépendante par un développeur seul. Il n’y a ni équipe de recherche ni attaché de presse : l’adresse ci-dessus vous met en contact avec la personne qui a réellement construit ce jeu de données, et non avec un accueil. Nous le précisons ici parce que quiconque cite ces données a le droit de savoir qui se trouve derrière.
Versions et historique des modifications
Cette URL pointe toujours vers l’instantané le plus récent. Chaque publication porte un numéro de version et une date de gel : merci d’indiquer la version lorsque vous citez (par exemple : v1.1.0, instantané du 2026-08-14). Ainsi, lorsque les chiffres seront mis à jour, la version que vous avez citée restera identifiable. Les fichiers JSON et CSV téléchargeables comportent les mêmes champs de version.
| Version | Instantané figé le | Couverture | Remarques |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | du 2026-08-02 au 10-21 (81 jours) | Version plus récente, publiée à sa propre URL (ensembles d’analyse différents). |
| v1.1.0 | 2026-08-14 | du 2 au 13 août 2026 (12 jours) | Première publication. Ensemble d’analyse principal : premières tentatives en contexte de quiz ; les quatre ensembles d’analyse sont publiés côte à côte. |
La prochaine publication est prévue après environ trois mois de données supplémentaires, soit le moment le plus précoce où une tendance pourrait être discutée. La mise à jour des données ne réécrira pas les chiffres d’une version déjà publiée : chaque nouvelle publication reçoit un nouveau numéro de version et une nouvelle date de gel, et les chiffres antérieurs restent identifiables par leur version. Si vous avez déjà cité une version et que ses chiffres changent, écrivez-nous et nous vous indiquerons précisément ce qui diffère.
← Retour à Recherche et données | Comment Taïwan apprend le japonais en 2026 | Pour les enseignants et les bibliothèques