Jeu de données des réponses d’apprentissage du japonais — octobre 2026 : 543 344 réponses, difficulté ajustée selon le niveau et espacement des révisions
En une phrase : des statistiques agrégées issues de 543 344 réponses anonymes sur Nihongo to Japan, couvrant la période du 2 août au 21 octobre 2026 (81 jours) et 25 850 questions — soit 9,6 fois le volume de la version d’août (v1.1.0).
⚠️ La v2 et la v1 reposent sur des ensembles d’analyse différents. Ne soustrayez pas le taux de réussite d’une version de celui de l’autre. La v1 a été calculée directement à partir de la base de données, avec les « premières tentatives en contexte de quiz » comme ensemble principal. La v2 utilise délibérément uniquement des points d’accès publics de données agrégées que tout le monde peut interroger (/api/aggregates,/api/community) ; ses mesures principales sont donc « toutes les réponses » et « premières tentatives au niveau des questions, une voix par question ». L’avantage est la reproductibilité : l’empreinte sha256 de chaque fichier d’entrée est consignée dans le fichier téléchargeable, ce qui permet à des chercheurs extérieurs de vérifier précisément quelles données nous avons utilisées. Voir la méthodologie.
Ce que ce jeu de données n’est pas. Ce n’est pas une enquête représentative des apprenants du japonais. L’échantillon est constitué de personnes qui ont choisi de s’entraîner sur ce site : un échantillon d’observation, auto-sélectionné. Chaque chiffre décrit uniquement ce qui s’est passé dans le journal des réponses de NTJ ; aucun ne se généralise à une population et aucun ne constitue une affirmation causale. Voir les limites.
Dix résultats citables
Chaque point est autonome : il nomme le jeu de données, la période, la taille de l’échantillon et l’ensemble d’analyse, de sorte qu’il peut être cité seul. Merci de citer également les limites.
- Le jeu de données NTJ des réponses d’apprentissage du japonais (octobre 2026, v2.0.0) contient 543 344 réponses anonymes sur 25 850 questions, enregistrées entre le 2 août et le 21 octobre 2026 — soit 9,6 fois les 56 613 réponses de la version d’août 2026 publiée par le site.
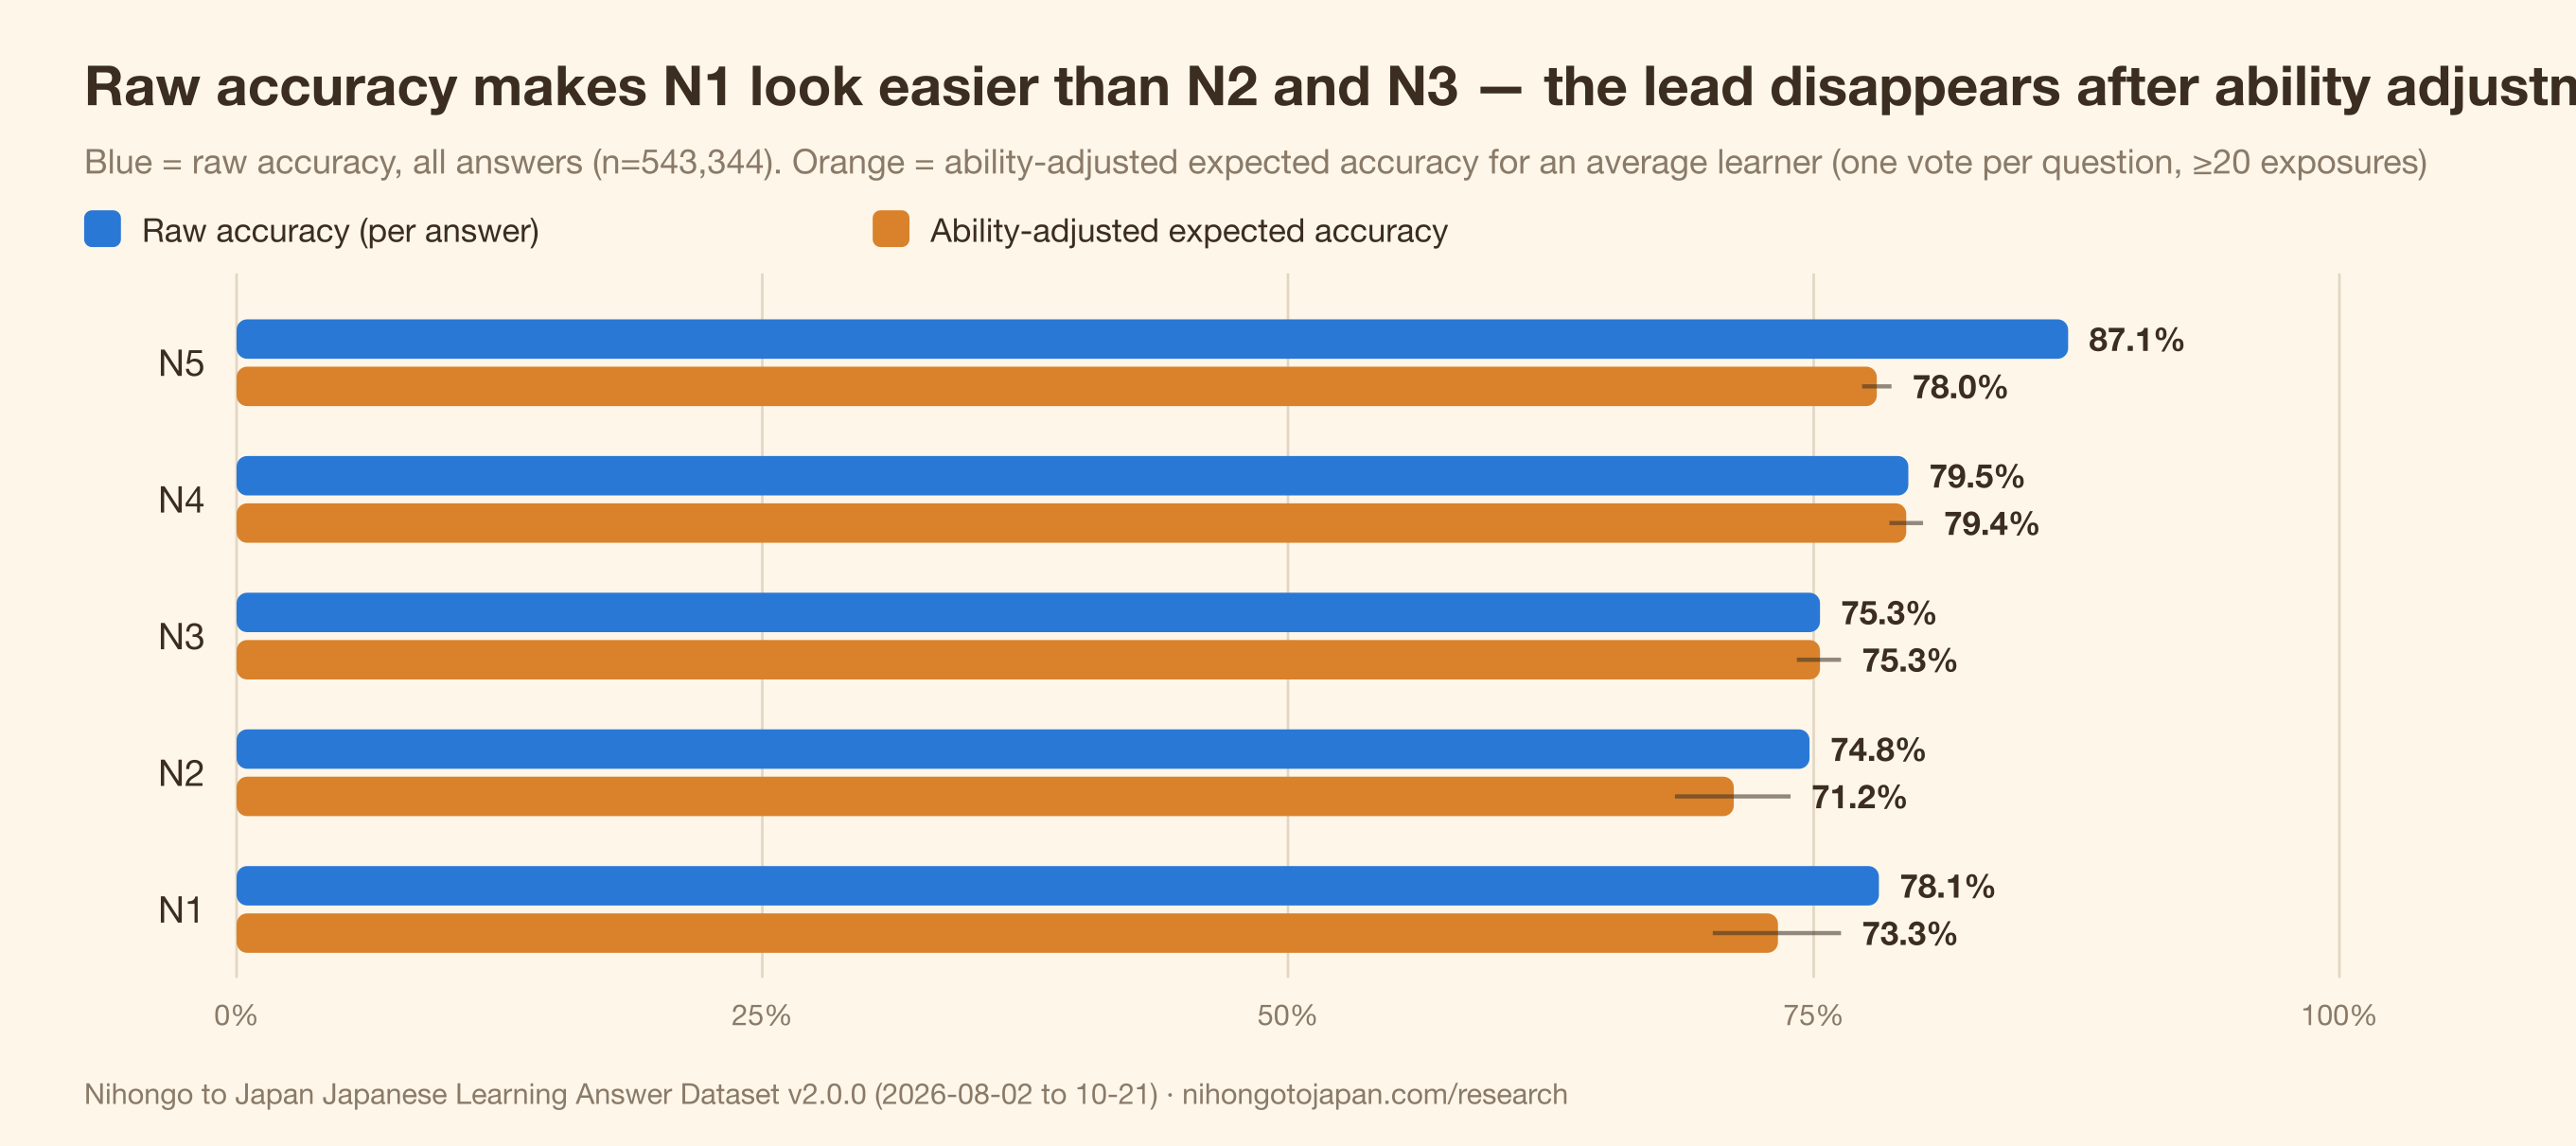
- Sur l’ensemble des réponses de ce même jeu de données, le taux de réussite brut par niveau du JLPT est de 87,1 % pour le N5, 79,5 % pour le N4, 75,3 % pour le N3, 74,8 % pour le N2 et 78,1 % pour le N1 (n=33 082) — le N1 obtient un score supérieur à la fois au N2 et au N3.
- Une fois le niveau des apprenants neutralisé par une estimation de Rasch en une étape (une voix par question, ≥20 expositions), le taux de réussite attendu pour un apprenant moyen est de 75,3 % pour le N3 (IC à 95 % 74,2–76,3 %, 847 questions), de 73,3 % pour le N1 (70,2–76,3 %, 210 questions) et de 71,2 % pour le N2 (68,4–73,9 %, 204 questions). L’avance du N1 sur le N3 disparaît, ce qui est cohérent avec un effet de sélection : ce sont les apprenants les plus forts qui s’attaquent aux questions de N1.
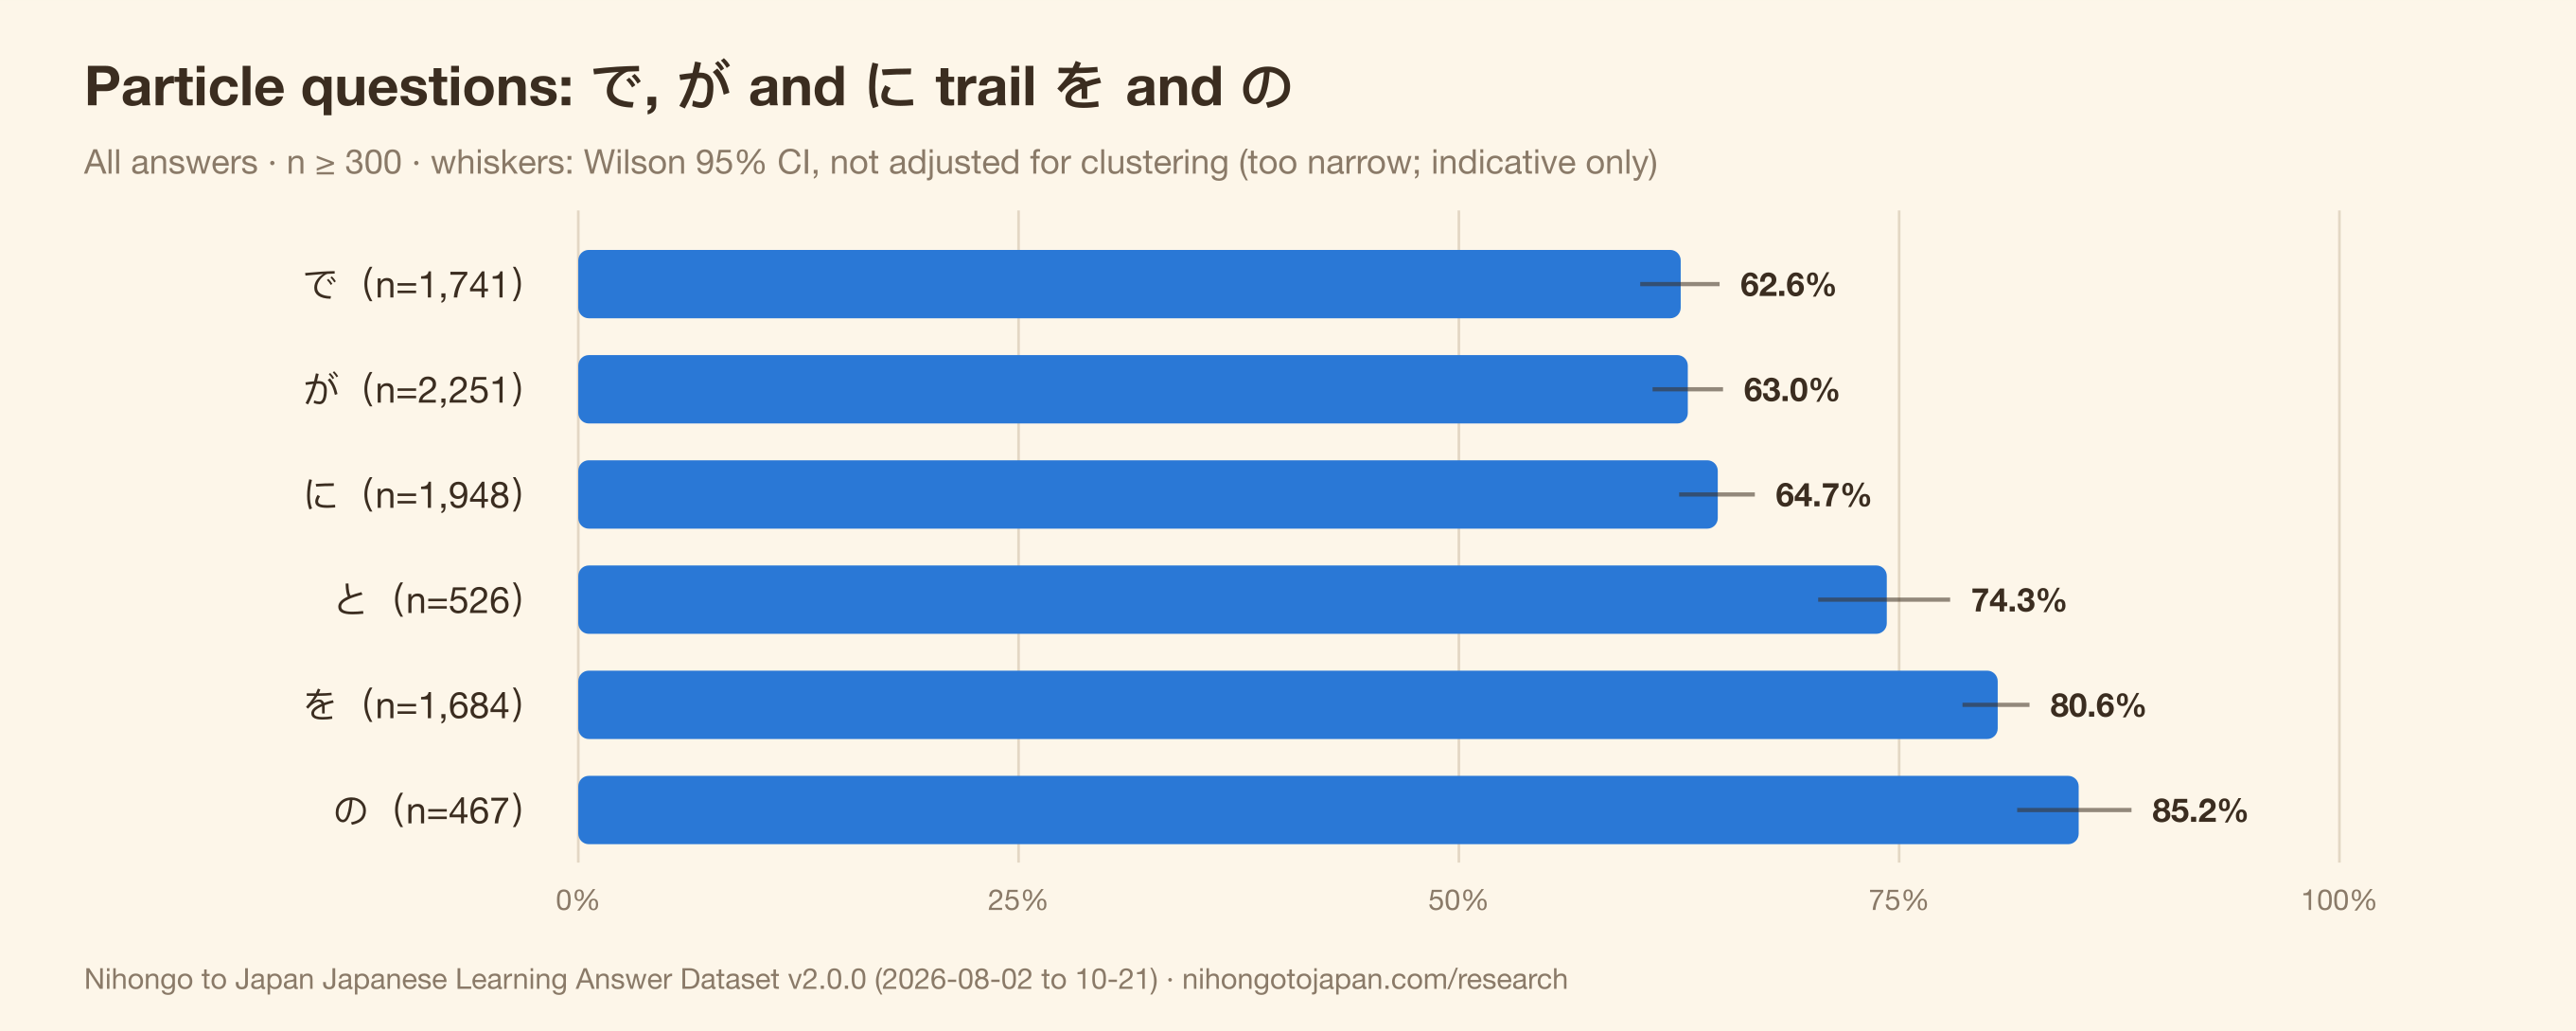
Les intervalles ajustés du N1 et du N3 se chevauchent : cela ne montre donc pas que le N1 est plus difficile que le N3 — seulement que l’ordre brut n’est pas fiable. - Sur l’ensemble des réponses, les particules au taux de réussite le plus bas sont で 62,6 % (n=1 741), が 63,0 % (n=2 251) et に 64,7 % (n=1 948) ; les plus élevées sont を 80,6 % (n=1 684) et の 85,2 % (n=467) — soit un écart de 22,6 points entre で et の.
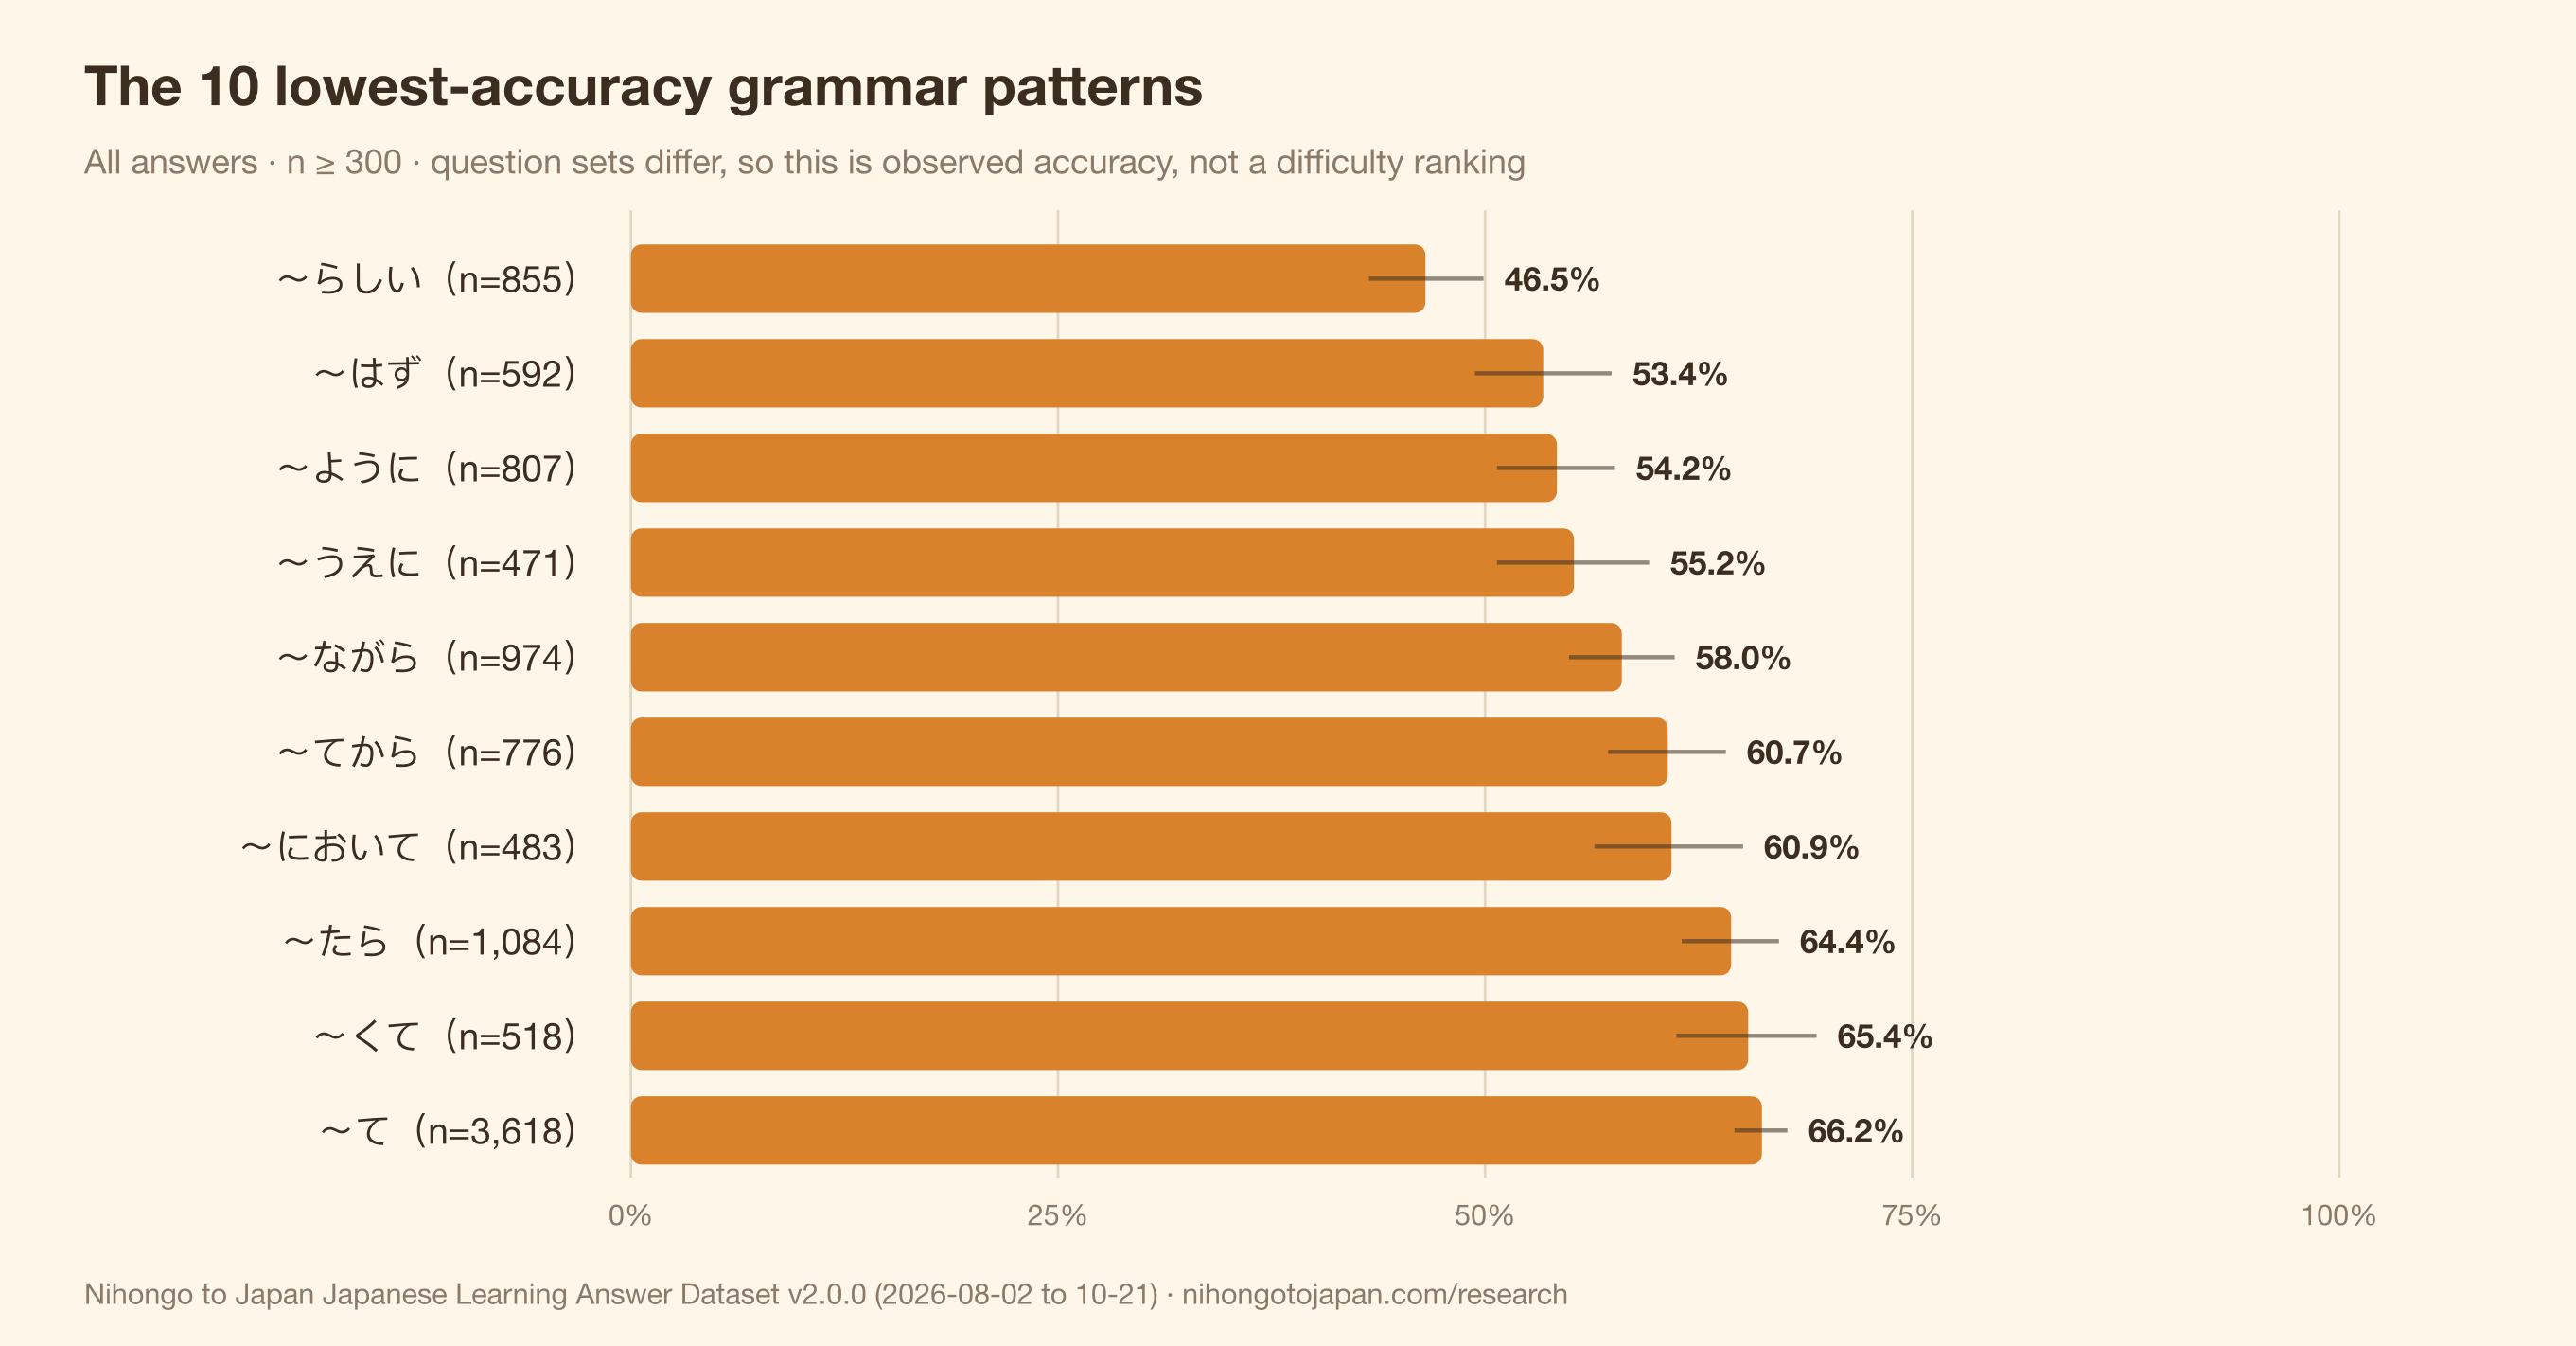
- Parmi les structures grammaticales avec n ≥ 300, le taux de réussite le plus bas sur l’ensemble des réponses est celui de 〜らしい 46,5 % (n=855), suivi de 〜はず 53,4 % (n=592), 〜ように 54,2 % (n=807), 〜うえに 55,2 % (n=471) et 〜ながら 58,0 % (n=974).
- Parmi les questions sur les formes verbales, la forme potentielle obtient le score le plus bas, 64,5 % (n=1 923), et la forme en ます le plus élevé, 84,0 % (n=2 270) ; la forme en た (70,7 %), la forme en て (74,1 %) et la forme en ない (75,0 %) se situent entre les deux.
- En comptant une voix par question (7 057 questions avec ≥20 expositions), le taux moyen de réussite à la première tentative est de 89,1 % pour le vocabulaire (IC à 95 % 88,7–89,5 %), de 73,9 % pour les structures grammaticales (73,1–74,7 %) et de 67,6 % pour les particules (64,9–70,4 %).
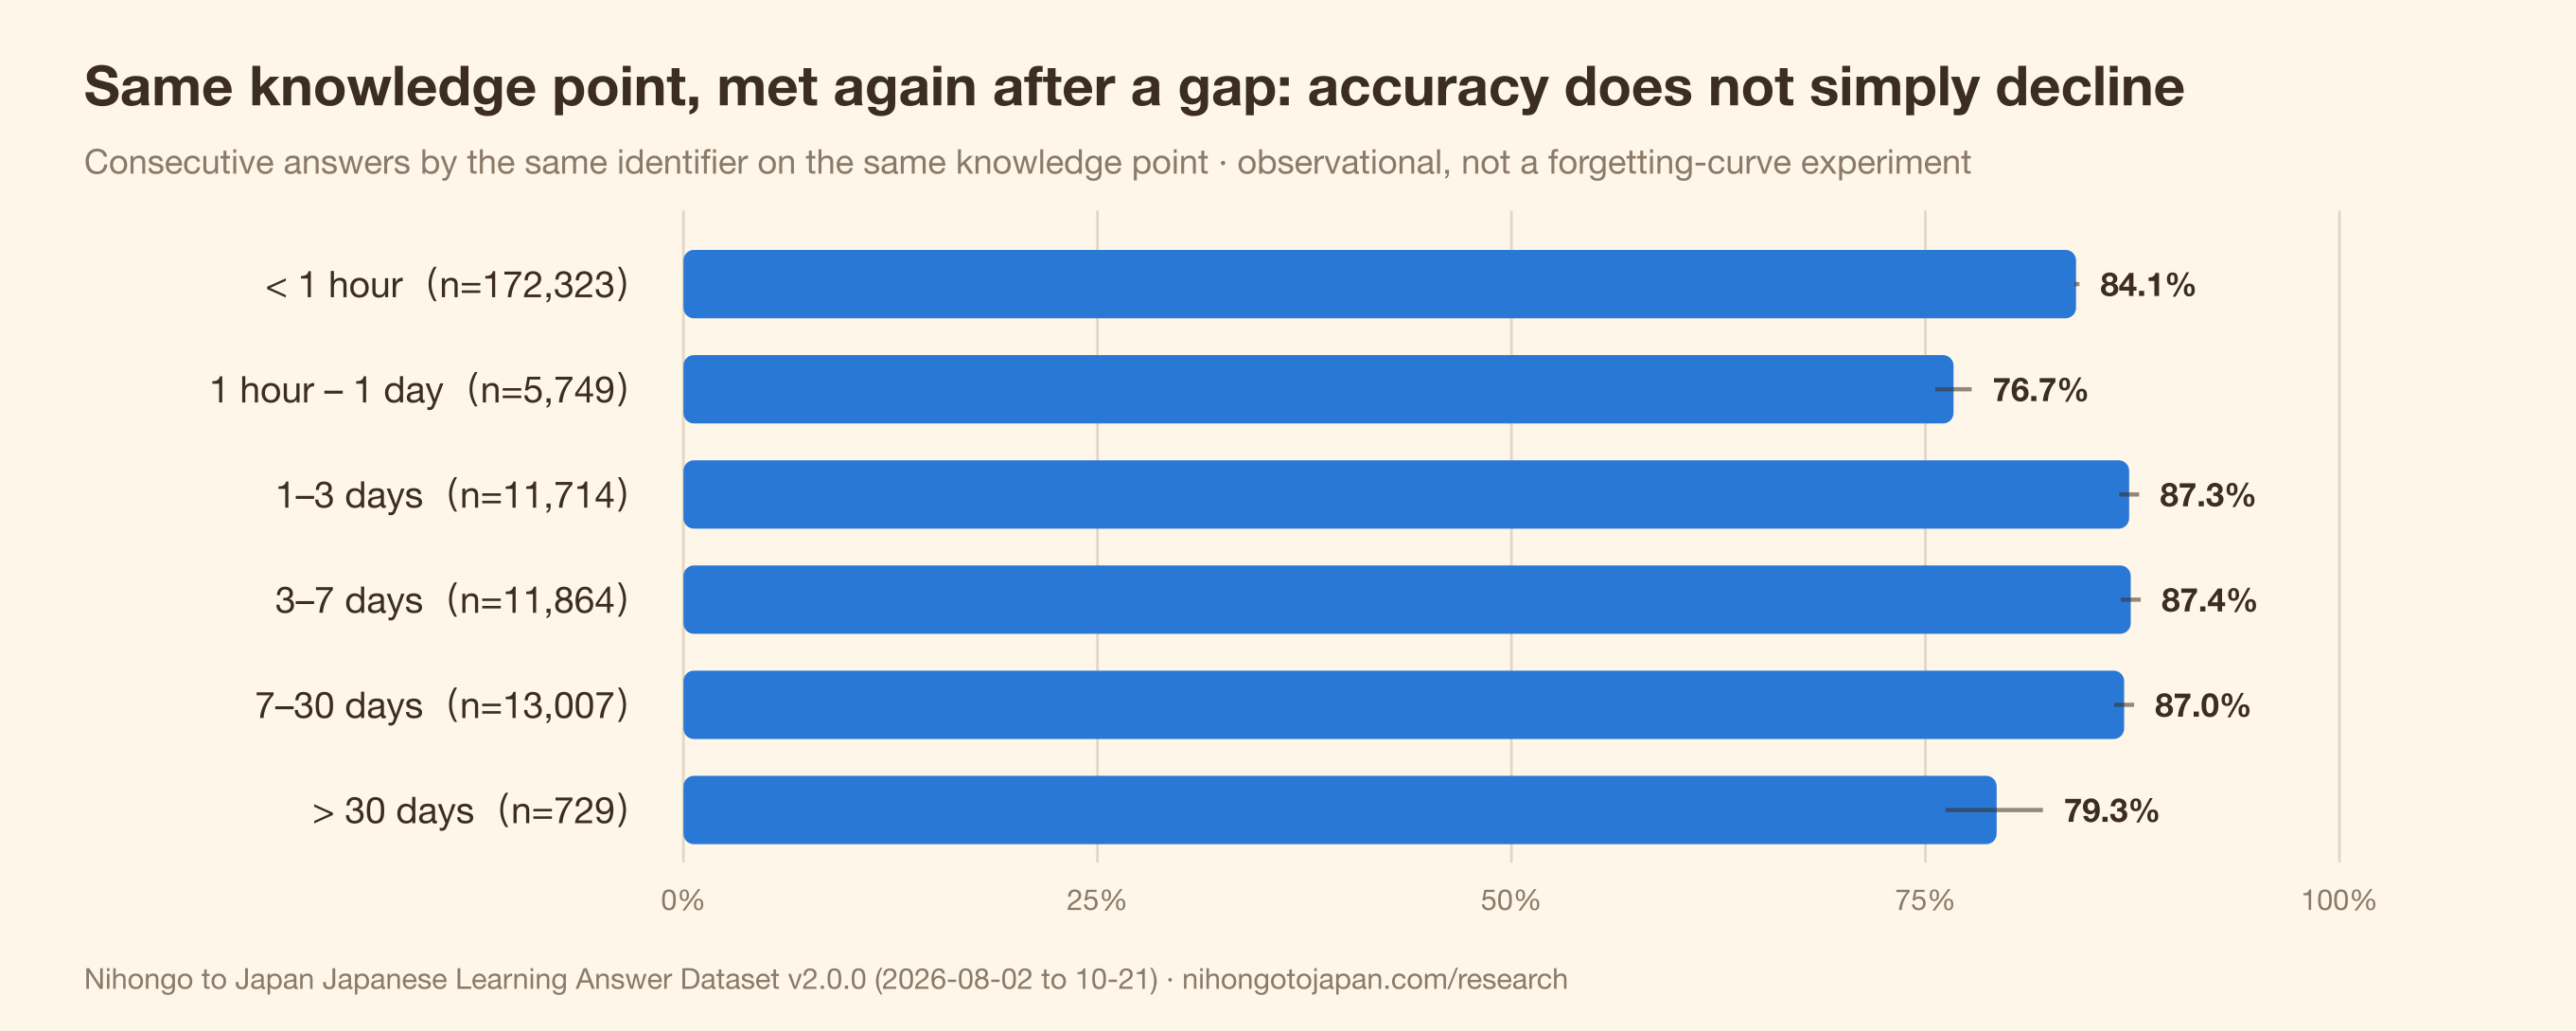
- Pour des réponses consécutives d’un même identifiant sur un même point de connaissance, le taux de réussite est de 84,1 % lorsque l’intervalle est inférieur à une heure, de 76,7 % entre 1 heure et 1 jour, de 87,0–87,4 % pour 1–3, 3–7 et 7–30 jours, et de 79,3 % au-delà de 30 jours (n=729). Le taux de réussite ne diminue pas de façon monotone avec l’intervalle.
Il s’agit de données d’observation : les personnes qui reviennent au bout de quelques jours ne le font pas au hasard. Cela ne montre pas qu’il vaut mieux réviser après quelques jours. - Sur 7 057 questions avec ≥20 expositions, 283 (4,0 %) ont un taux de réussite à la première tentative inférieur à 35 % (répondre au hasard parmi quatre options donne environ 25 %). Une cause fréquente est l’existence d’une deuxième option défendable ; ces questions sont dans une file de révision manuelle.
- Le modèle de prédiction des réponses du site, en v2, obtient un score de Brier de 0,199 sur 257 010 réponses, soit 51,4 % de moins que les 0,409 de la v1 — mais il reste moins bon que le 0,161 d’une référence constante qui prédit toujours le taux de réussite global de 79,9 %. Seule la version qui ajoute la difficulté au niveau des questions (0,130) fait mieux que cette référence.
1. Cinq résultats principaux
1. « Le N1 est plus facile que le N3 » est une illusion créée par la sélection
En taux de réussite brut sur l’ensemble des réponses, le N1 (78,1 %) devance le N3 (75,3 %) et le N2 (74,8 %). Cela n’a guère de sens, et la v1 avait constaté la même chose. L’explication la plus probable tient à qui répond : les personnes qui ouvrent des questions de N1 sont déjà plus fortes.
La v2 refait le calcul avec une difficulté ajustée selon le niveau des apprenants : le résultat observé pour chaque question est corrigé en fonction du niveau moyen des personnes qui y ont effectivement répondu, puis exprimé comme la probabilité qu’un apprenant moyen la réussisse. Après ajustement, l’avance du N1 disparaît (N3 75,3 %, N1 73,3 %, N2 71,2 %).
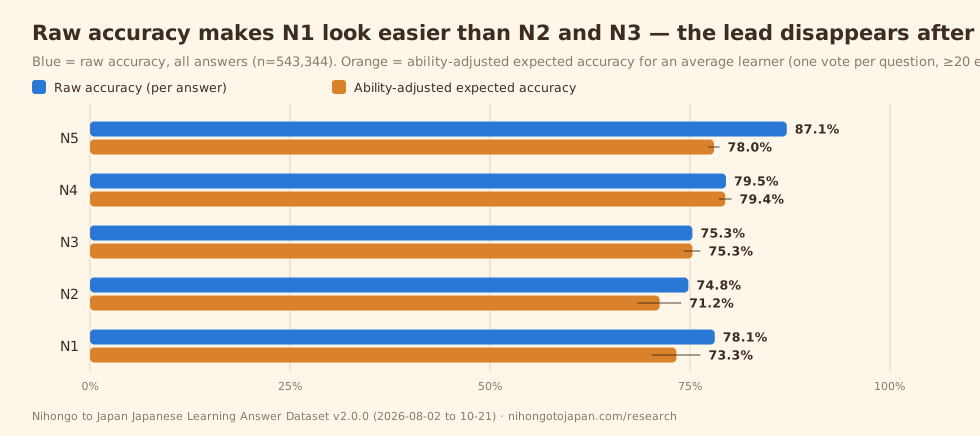
Deux réserves. Premièrement, les intervalles ajustés du N1 et du N3 se chevauchent encore : on ne peut donc pas dire que le N1 est plus difficile que le N3. Deuxièmement, le N5 ajusté (78,0 %) n’est pas au-dessus du N4 (79,4 %) : l’ajustement tient compte de qui répond, pas des questions que contient chaque niveau — 53 % des questions de N5 retenues dans l’analyse portent sur des structures grammaticales, contre 33 % au N4, et les questions de structure sont plus difficiles à réussir que celles de vocabulaire.
2. L’écart entre particules : で, が et に ont environ 20 points de retard sur を et の
で (62,6 %), が (63,0 %) et に (64,7 %) se situent près de 20 points sous を (80,6 %) et の (85,2 %). Ce que les trois moins réussies ont en commun, c’est une seule particule pour de nombreux emplois : で marque le lieu, le moyen, la cause et l’étendue ; に marque le moment, la destination, le destinataire et le but.
Cela concorde avec la v1 (« l’écart entre particules est plus grand que l’écart entre niveaux »), et l’échantillon plus large de la v2 rend cette tendance plus stable.
3. Les structures les plus difficiles se concentrent autour de la supposition et du but ou de l’état
Parmi les cinq structures les moins réussies, 〜らしい (46,5 %) et 〜はず (53,4 %) expriment toutes deux une supposition ou une attente et se confondent facilement avec 〜そう, 〜よう et 〜みたい ; 〜ように (54,2 %) couvre le but, le changement et la demande ; 〜ながら (58,0 %) est souvent confondu avec 〜て et 〜まま.
Les formes verbales présentent une structure similaire : la forme potentielle (64,5 %) est la plus basse des cinq. Ses règles diffèrent pour les verbes ichidan, godan et irréguliers, et les apprenants rencontrent aussi des variantes familières sans ら.
4. Le taux de réussite après un intervalle ne diminue pas simplement
En appariant les réponses consécutives d’un même identifiant sur un même point de connaissance, regroupées par intervalle :
| Intervalle | Réponses | Identifiants | Taux de réussite |
|---|---|---|---|
| < 1 heure | 172 323 | 3 472 | 84,1 % |
| 1 heure – 1 jour | 5 749 | 647 | 76,7 % |
| 1–3 jours | 11 714 | 532 | 87,3 % |
| 3–7 jours | 11 864 | 449 | 87,4 % |
| 7–30 jours | 13 007 | 405 | 87,0 % |
| > 30 jours | 729 | 126 | 79,3 % |
Selon la courbe de l’oubli des manuels, plus l’intervalle est long, plus on oublie. Ici, l’intervalle de 1 heure à 1 jour est le plus bas et celui de 1 à 30 jours le plus élevé. Nous n’en concluons pas qu’« il vaut mieux réviser après quelques jours » : les personnes qui reviennent au bout de quelques jours ne le font pas au hasard — les apprenants qui reviennent sont plus impliqués et peut-être plus forts. Le groupe de 1 heure à 1 jour ne compte que 647 identifiants et peut inclure des personnes qui refont une série sur un second appareil le même jour. Répondre à la question de l’espacement exigerait une expérience randomisée, ce que ce jeu de données ne peut pas offrir.
5. Le modèle de prédiction a divisé son erreur par deux mais n’a pas battu la référence la plus simple
Le système de recommandation de questions du site prédit d’abord la probabilité que vous répondiez correctement. Nous l’évaluons avec le score de Brier (écart quadratique moyen entre la probabilité prédite et le résultat ; plus il est bas, mieux c’est) :
- Modèle v1 : 0,409
- Modèle v2 : 0,199 (51,4 % de moins)
- v2 avec difficulté au niveau des questions : 0,130 (68,1 % de moins)
- Référence : une prédiction constante qui annonce toujours le taux global de 79,9 % : 0,161
La v2 divise par deux l’erreur de la v1 mais reste globalement moins bonne que la référence constante ; seul l’ajout de la difficulté au niveau des questions permet de la battre. Nous le publions parce que cela montre directement que la difficulté de la question prédit mieux la réussite que le niveau de l’apprenant — c’est aussi pour cette raison que le résultat 1 nécessite un ajustement selon le niveau.
2. Présentation du jeu de données
| Élément | Valeur | Remarques |
|---|---|---|
| Réponses valides | 543 344 | Instantané agrégé du 2026-10-21 à 19:18 UTC, périmètre all_clean_events (règles de nettoyage du site appliquées) |
| Identifiants d’apprenant (≥1 réponse de catégorie A) | 5 410 | totalUsers dans le point d’accès des agrégats |
| Identifiants d’apprenant (tous) | 8 073 | Point d’accès communautaire ; une borne supérieure du nombre de personnes |
| Questions ayant reçu une réponse | 25 850 | 7 057 questions avec ≥20 expositions entrent dans l’analyse au niveau des questions |
| Questions avec difficulté ajustée | 18 139 | Estimation de Rasch en une étape avec rétrécissement bayésien empirique |
| Catégorie de preuve | A 59,8 % · B 33,5 % · C 6,7 % | A = contexte de quiz ; B = exercices de leçon ; C = autres (comme dans la v1) |
| Période couverte | du 2026-08-02 au 10-21 | 81 jours |
À propos du compteur en direct : la mention de la page d’accueil « Les apprenants de NTJ ont déjà effectué 552 850 réponses d’entraînement » correspond au chiffre en direct du point d’accès communautaire le 2026-10-23, soit environ 9 500 de plus que ce jeu de données — les réponses ajoutées dans les deux jours qui ont suivi l’instantané. Citez 543 344.
3. Axes de compétence (toutes les réponses)
| Axe | Réponses | Taux de réussite | Première tentative au niveau des questions (questions) |
|---|---|---|---|
| Vocabulaire | 267 127 | 90,1 % | 89,1 % (3 398) |
| Structures grammaticales | 234 602 | 75,2 % | 73,9 % (3 252) |
| Formes verbales | 18 479 | 75,2 % | 76,2 % (154) |
| Particules | 13 870 | 71,3 % | 67,6 % (189) |
| Expressions idiomatiques | 7 413 | 88,1 % | 92,4 % (64) |
| Compréhension écrite | 1 103 | 78,7 % | — |
| Compréhension orale | 605 | 69,8 % | — |
| Expression orale | 118 | SUPPRIMÉ | — |
La compréhension écrite, la compréhension orale et l’expression orale sont des types de questions plus récents, aux échantillons réduits ; l’expression orale se situe sous le seuil de 300 réponses, si bien que seul son effectif est indiqué.
4. Niveaux du JLPT
| Niveau | Taux de réussite sur toutes les réponses (n) | Première tentative au niveau des questions (questions) | Taux de réussite attendu ajusté selon le niveau (IC à 95 %) |
|---|---|---|---|
| N5 | 87,1 % (297 809) | 82,6 % (3 817) | 78,0 % (77,3–78,7 %) |
| N4 | 79,5 % (93 609) | 84,5 % (1 766) | 79,4 % (78,6–80,2 %) |
| N3 | 75,3 % (82 010) | 75,7 % (1 008) | 75,3 % (74,2–76,3 %) |
| N2 | 74,8 % (36 837) | 66,9 % (249) | 71,2 % (68,4–73,9 %) |
| N1 | 78,1 % (33 082) | 74,2 % (217) | 73,3 % (70,2–76,3 %) |
Les trois colonnes reposent sur des ensembles d’analyse différents : comparez à l’intérieur d’une colonne, pas d’une colonne à l’autre. La colonne 1 compte toutes les réponses, y compris les répétitions, et dépend de la répartition des types de questions de chaque niveau ; la colonne 2 donne une voix à chaque question ; la colonne 3 neutralise en plus le niveau des apprenants.
5. Qualité des questions : notre propre banque de questions est elle aussi mesurée
| Taux de réussite à la première tentative | Questions |
|---|---|
| < 35 % | 283 |
| 35–50 % | 377 |
| 50–70 % | 971 |
| 70–85 % | 1 347 |
| 85–95 % | 1 937 |
| ≥ 95 % | 2 142 |
Les 283 questions (4,0 %) sous les 35 % ne sont pas forcément mauvaises — certaines sont simplement difficiles. Mais notre révision manuelle d’août a montré que cette tranche contient souvent une deuxième option défendable (par exemple, が et を conviennent tous deux dans 「ピアノ_弾けます」). Le système signale aussi 415 questions à réviser selon des critères comme une discrimination nettement négative. La précision de ce signalement est d’environ 0,19 : il s’agit d’une file de révision, pas d’une liste de mauvaises questions.
6. Comment les enseignants et les concepteurs de supports peuvent s’en servir
- Particules : で, が et に ont environ 20 points de retard sur を et の. Travailler un emploi à la fois, avec ses propres exemples, est plus ciblé que d’entraîner une particule dans son ensemble.
- Expressions de supposition : 〜らしい et 〜はず sont ici les structures les plus souvent manquées ; mettez-les en contraste avec 〜そう, 〜よう et 〜みたい.
- Forme potentielle : la plus basse des cinq formes verbales ; entraînez-la séparément selon le groupe du verbe.
- Lire vos propres données : si votre plateforme montre elle aussi des questions avancées mieux réussies que des questions intermédiaires, soupçonnez la sélection avant de soupçonner les questions.
7. Méthodologie
Sources et reproductibilité
Chaque chiffre de la v2 provient de six points d’accès publics, interrogés et figés le 2026-10-23 : /api/aggregates?kind=summary, kind=items, kind=difficulty, kind=spacing, kind=brier et /api/community?kind=overview. L’heure de l’instantané de chaque point d’accès et l’empreinte sha256 de chaque fichier d’entrée figurent dans le fichier JSON téléchargeable, sous dataset.source_snapshot_at_utc et dataset.input_sha256. Le script de construction, scripts/build-research-dataset-2026-10.py, n’a accès à aucune donnée au niveau de l’apprenant.
Cinq ensembles d’analyse
- Toutes les réponses (axes, niveaux, points de connaissance) : chaque réponse valide compte, y compris les répétitions d’un même identifiant.
- Premières tentatives au niveau des questions : pour chaque question, taux de réussite de la première tentative de chaque identifiant, puis moyenne sur l’ensemble des questions. Uniquement les questions avec ≥20 expositions ; les IC à 95 % prennent la question comme unité.
- Difficulté ajustée selon le niveau : estimation de Rasch en une étape b̂ = θ̄ (niveau moyen des personnes ayant effectivement répondu) − logit(p̂), rétrécie vers la moyenne de l’axe avec un poids n/(n+5), puis convertie en taux d’erreur attendu pour un apprenant de niveau moyen à l’échelle du site. Nous indiquons 1 − l’erreur attendue.
- Paires de réponses consécutives (espacement) : réponses consécutives d’un même identifiant sur un même point de connaissance, catégories de preuve A et B uniquement.
- Précision des prédictions : toutes les réponses de catégorie A portant à la fois une prédiction v1 et une prédiction v2 (les champs de prédiction existent depuis le 2026-08-20).
Taille minimale des cellules
Les cellules au niveau des réponses avec n < 300 sont supprimées ; les points de connaissance ne sont listés qu’à partir de n ≥ 300 ; les analyses au niveau des questions n’incluent que les questions avec ≥20 expositions.
Intervalles de confiance
Les IC de Wilson à 95 % au niveau des réponses ne sont pas ajustés pour les réponses répétées d’un même identifiant (les points d’accès publics n’exposent pas de données au niveau des identifiants) : ils sont donc trop étroits et seulement indicatifs. Les IC au niveau des questions prennent la question comme unité d’échantillonnage : ils décrivent cette banque de questions, pas une population d’apprenants.
Anonymat
Les points d’accès publics ne renvoient que des agrégats. Ce jeu de données ne contient aucune réponse brute, aucun identifiant et aucun horodatage au niveau des réponses.
8. Limites (merci de les citer avec les chiffres)
- Échantillon d’observation auto-sélectionné de personnes qui s’entraînent sur NTJ ; il n’est représentatif d’aucune population d’apprenants.
- Les identifiants ne sont pas des personnes : les identifiants anonymes de navigateur ne peuvent pas être fusionnés d’un appareil à l’autre ; 8 073 est une borne supérieure.
- Des jeux de questions différents : les niveaux, les axes et les points de connaissance utilisent des questions différentes ; les écarts de taux de réussite ne sont donc pas des classements de difficulté.
- Les chiffres sur toutes les réponses sont gonflés par l’entraînement répété.
- L’ajustement selon le niveau repose sur des hypothèses : le modèle de Rasch suppose une dimension de compétence unique ; le niveau n’est estimé que pour les identifiants ayant suffisamment de réponses.
- Les IC au niveau des réponses sont trop étroits (voir la méthodologie).
- Troncature de la liste des questions :
kind=itemsrenvoie au maximum 25 000 questions par exposition décroissante (sur 25 850) ; les 850 manquantes sont les moins exposées et n’affectent pas l’analyse à ≥20 expositions. - Uniquement les 100 premiers points de connaissance : le point d’accès des agrégats renvoie les 100 points de connaissance ayant reçu le plus de réponses.
- Le temps de réponse est inutilisable : des onglets restés ouverts sans activité gonflent la moyenne ; le temps de réponse n’est donc pas indiqué.
- Aucune affirmation causale dans l’ensemble de ce rapport.
9. Comment citer
Vous pouvez citer ce jeu de données dans des articles scientifiques, des rapports, des supports pédagogiques et des articles de presse. Merci d’indiquer la source, de préciser la version et de mettre un lien vers cette page.
APA (7th)
Nihongo to Japan. (2026). Japanese learning answer dataset — October 2026 (Version 2.0.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026-10MLA (9th)
Nihongo to Japan. Japanese Learning Answer Dataset — October 2026. Version 2.0.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10.BibTeX
@misc{ntj_jlad_2026_10,

  title = {Japanese Learning Answer Dataset --- October 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {2.0.0},

  note = {Snapshot 2026-10-21; aggregate statistics from 543,344 anonymous answer events, 2 August -- 21 October 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026-10}

}
Licence : les données sont sous CC BY 4.0
Les données de ce jeu de données sont publiées sous licence Creative Commons Attribution 4.0 International (CC BY 4.0). Vous pouvez les copier, les redistribuer, les adapter et vous en servir comme base, y compris à des fins commerciales, à condition d’en créditer la source de manière appropriée et d’indiquer si des modifications ont été apportées.
⚠️ La licence ne couvre que les données : les chiffres agrégés de cette page et les deux fichiers téléchargeablesjapanese-learning-2026-10.jsonetjapanese-learning-2026-10.csv. Nos graphiques (SVG/PNG) et le texte du rapport ne sont pas couverts ; tous droits réservés.
Mention de la source
Nihongo to Japan, Japanese Learning Answer Dataset — October 2026, v2.0.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10Nos demandes (qui ne sont pas des conditions de la licence)
- Reprenez les limites : échantillon auto-sélectionné, d’observation, non représentatif.
- Nommez l’ensemble d’analyse : les chiffres sur toutes les réponses, sur les premières tentatives au niveau des questions et les chiffres ajustés selon le niveau diffèrent beaucoup.
- Écrivez « identifiants d’apprenant », et non « personnes ».
- Précisez la version (v2.0.0, instantané du 2026-10-21).
⚠️ La licence CC BY est irrévocable. Toute personne qui obtient les données selon ces conditions conserve ces droits, même si nous modifions nos conditions par la suite.
10. Téléchargements
- japanese-learning-2026-10.json — métadonnées complètes, empreintes sha256 des fichiers d’entrée, seuils et toutes les cellules agrégées.
- japanese-learning-2026-10.csv — une ligne par cellule ; colonnes
table, key, n, value, ci95_low, ci95_high, unit, note. - japanese-learning-2026-10-LICENSE.txt — déclaration de licence.
Fichiers des graphiques (PNG en résolution 2×, SVG vectoriel ; les graphiques ne sont pas sous CC BY — merci de nous contacter avant d’en reproduire un) :
- Taux de réussite brut et ajusté selon le niveau : PNG · SVG
- Taux de réussite par particule : PNG · SVG
- Les 10 structures les moins réussies : PNG · SVG
- Taux de réussite selon l’intervalle de révision : PNG · SVG
Le texte alternatif de chaque graphique se trouve dans alt-text.json.
Contact presse et données
Pour des ventilations plus fines, une erreur présumée ou une question sur le chiffre à citer, écrivez à [email protected] en indiquant « Dataset v2.0.0 » dans l’objet.
Versions
| Version | Instantané | Période couverte | Remarques |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | du 2026-08-02 au 10-21 (81 jours) | Cette page. Construite à partir de points d’accès publics de données agrégées ; ajoute la difficulté ajustée selon le niveau, l’espacement, la qualité des questions et la précision des prédictions. |
| v1.1.0 | 2026-08-14 | du 2026-08-02 au 08-13 (12 jours) | Première version ; ensemble principal « premières tentatives en contexte de quiz ». Ses chiffres sont inchangés et restent citables. |
Les chiffres publiés ne sont jamais réécrits. ← Recherche et données | Pour les enseignants et les bibliothèques