日語學習作答彙總資料集:2026 年 10 月
一句話:這是 Nihongo to Japan 站上 543,344 筆匿名作答紀錄的彙總統計,涵蓋 2026 年 8 月 2 日至 10 月 21 日(81 天)、25,850 道題目。作答量是 8 月版(v1.1.0)的 9.6 倍。
⚠️ v2 和 v1 用的是不同的分析集合,兩版的正確率不能直接相減。 v1 直接查資料庫,主要分析集合是「測驗情境首答」。v2 刻意只用任何人都拿得到的公開彙總端點(/api/aggregates、/api/community),所以主要口徑是「全部作答」與「每題一票的題目層級首答」。這樣做的好處是可重現:輸入檔的 sha256 都寫在下載檔裡,外部研究者可以核對我們拿到的是哪一份資料。詳見方法。
先講清楚這份資料不是什麼。這不是日語學習者的代表性調查。樣本是「會主動來這個網站刷題的人」,是自選的觀察性樣本。所有數字只描述「在 NTJ 的這批作答裡發生了什麼」,不能外推到任何母體,也不含因果宣稱。詳見限制。
可直接引用的十條發現
以下每一條都是自足的:句子本身已帶資料集名稱、期間、樣本數與口徑,可以單獨複製使用。引用時請一併帶上限制。
- NTJ 日語學習作答彙總資料集(2026 年 10 月版,v2.0.0)收錄 2026 年 8 月 2 日至 10 月 21 日共 543,344 筆匿名作答、25,850 道題目,作答量是同站 8 月版(56,613 筆)的 9.6 倍。
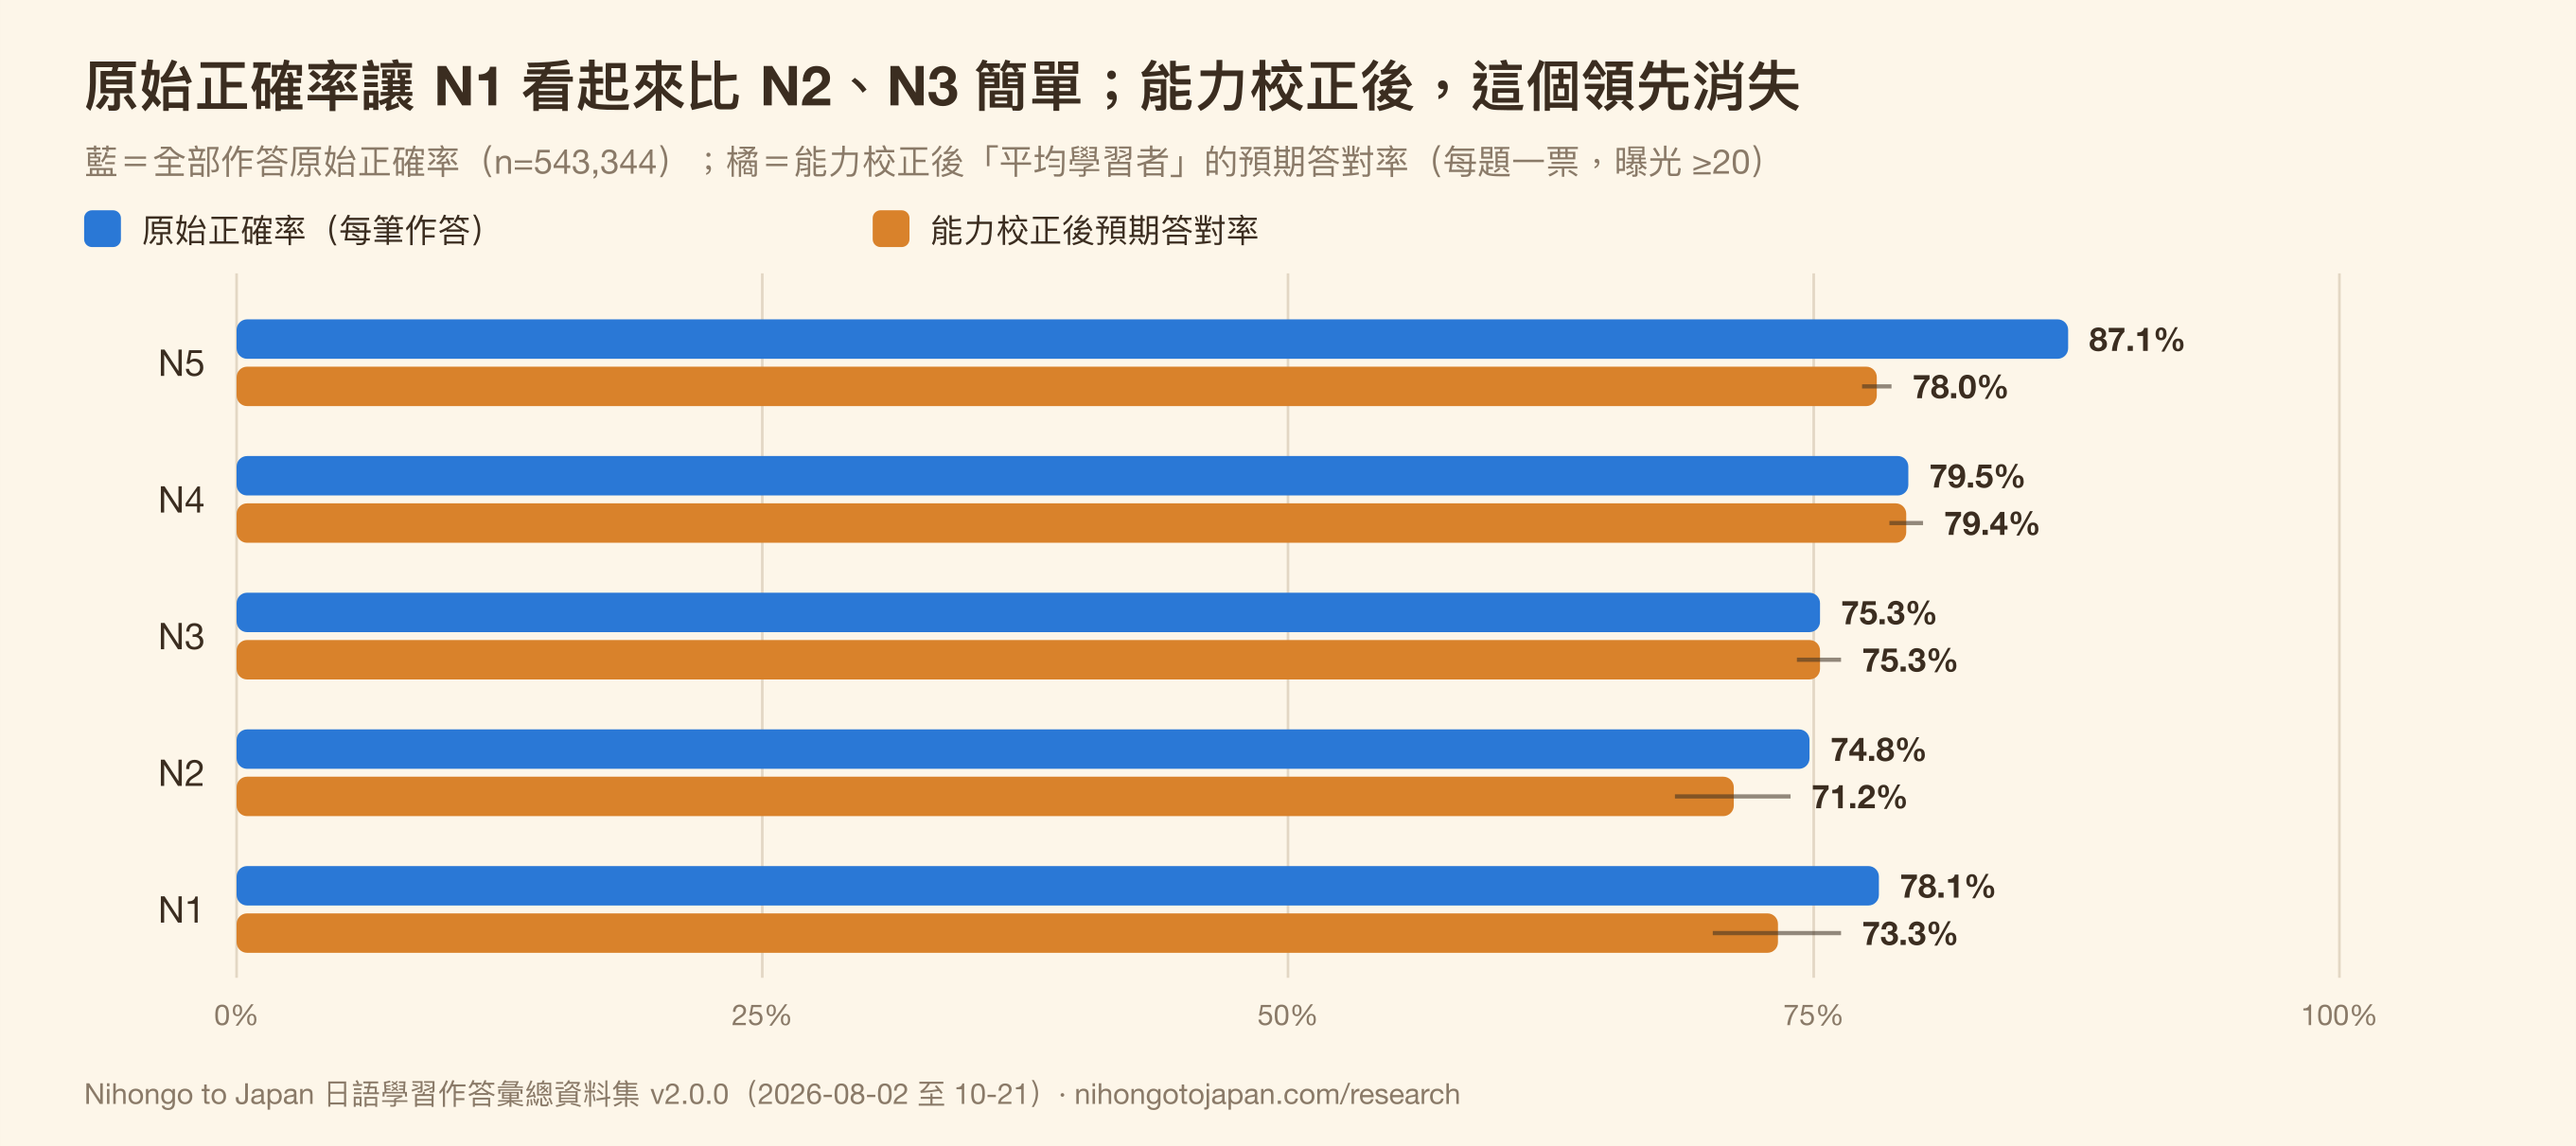
- 在同一份資料集的全部作答中,原始正確率依 JLPT 級別為 N5 87.1%、N4 79.5%、N3 75.3%、N2 74.8%、N1 78.1%(n=33,082)——N1 高於 N2 與 N3。
- 以 Rasch 一步估計扣除作答者能力後(每題一票,曝光 ≥20),「平均學習者」的預期答對率為 N3 75.3%(95% CI 74.2–76.3%,847 題)、N1 73.3%(70.2–76.3%,210 題)、N2 71.2%(68.4–73.9%,204 題);N1 高於 N3 的領先消失,與「強者才會去做 N1 題」的選擇效應一致。
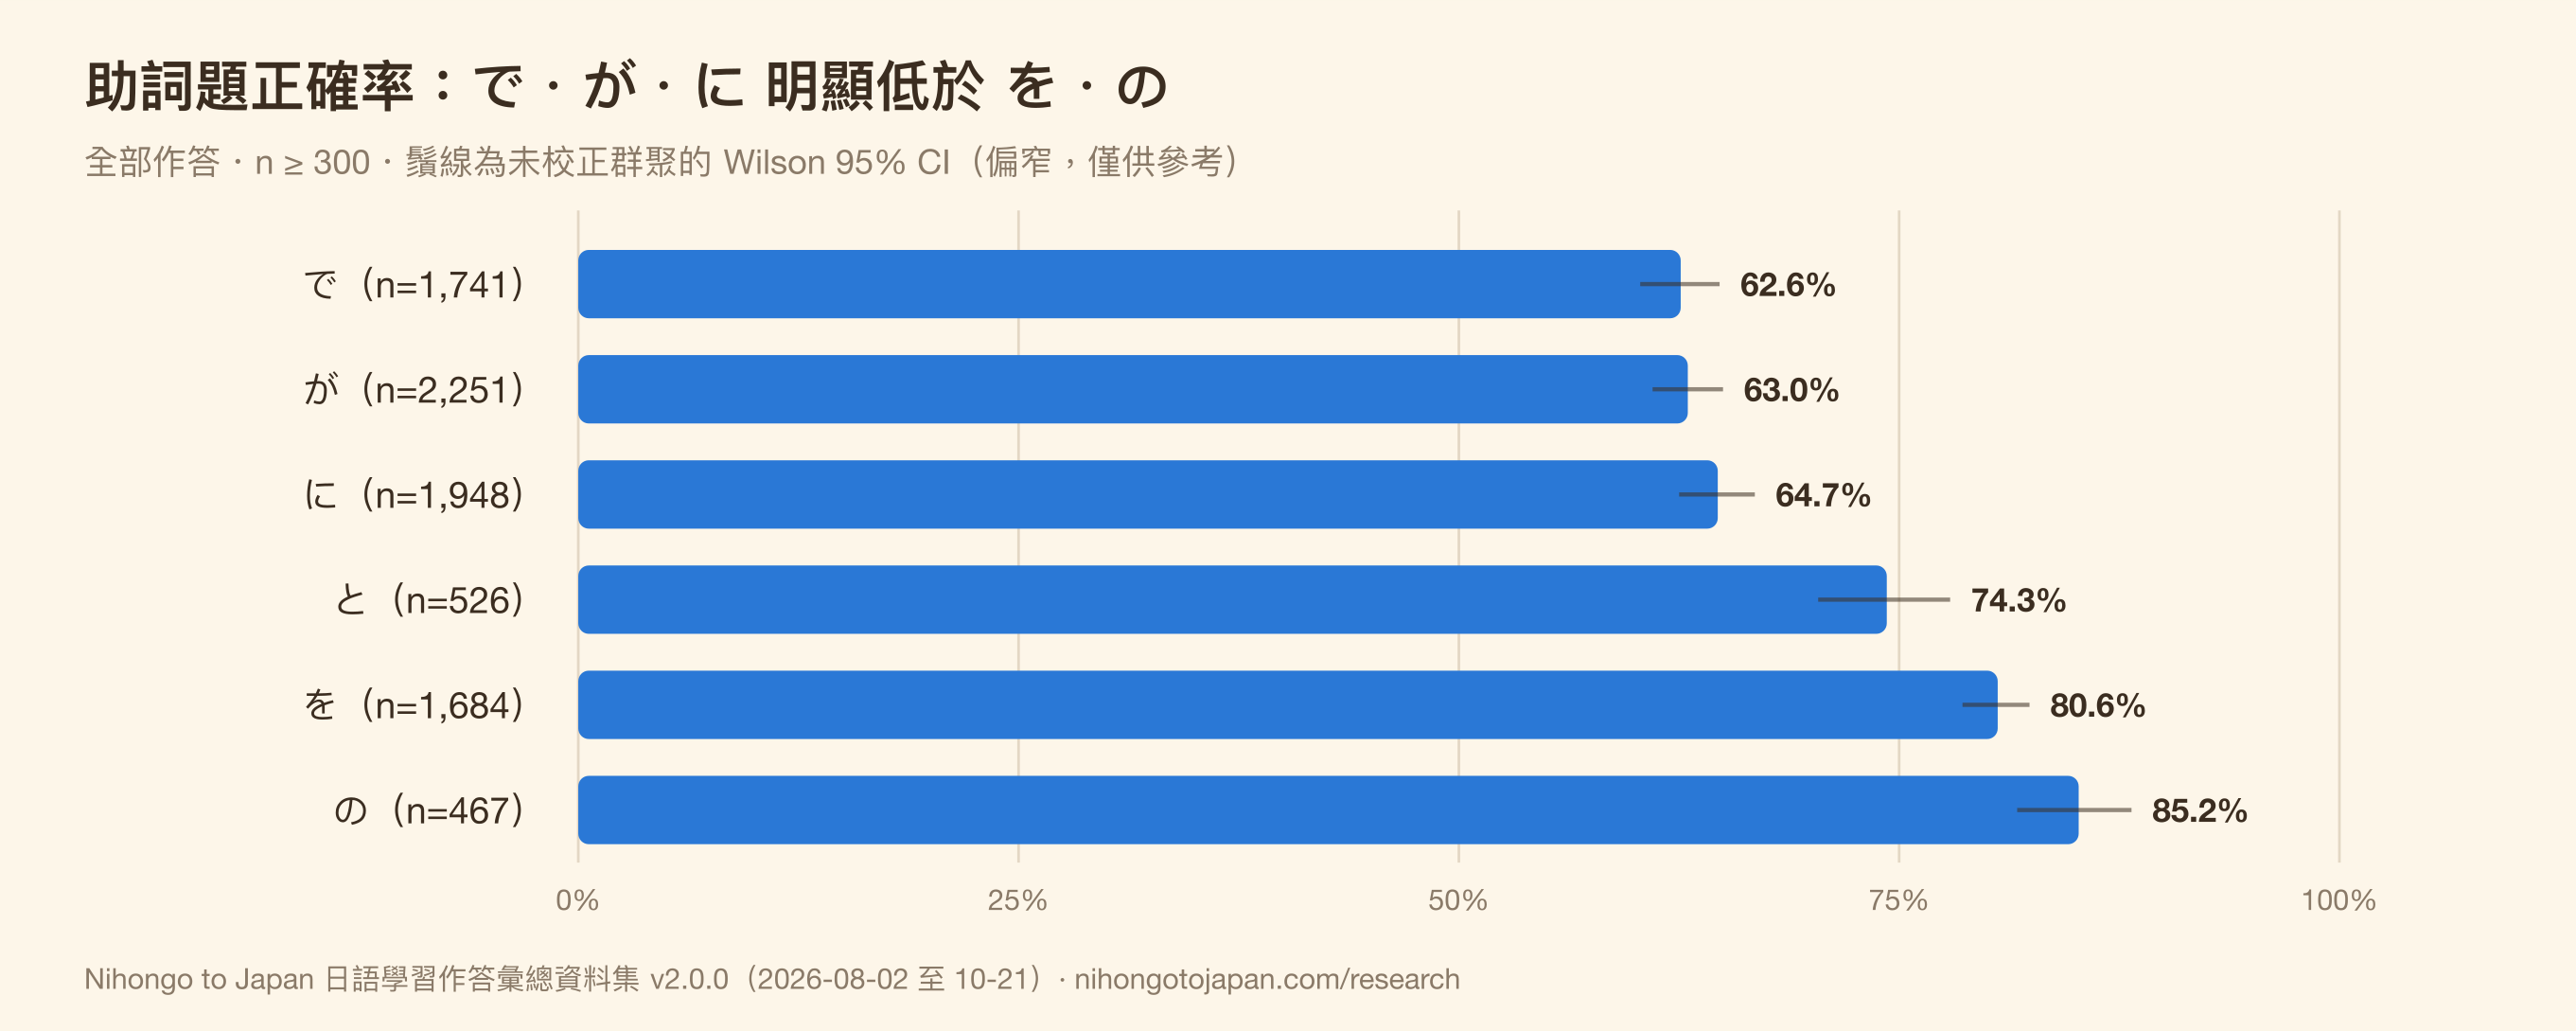
校正後 N1 與 N3 的區間重疊,不能說 N1 比 N3 難;只能說原始正確率的排序不可信。 - 在同一份資料集的全部作答中,助詞題的正確率以 で 62.6%(n=1,741)、が 63.0%(n=2,251)、に 64.7%(n=1,948)最低,を 80.6%(n=1,684)、の 85.2%(n=467)最高;で 與 の 相差 22.6 個百分點。
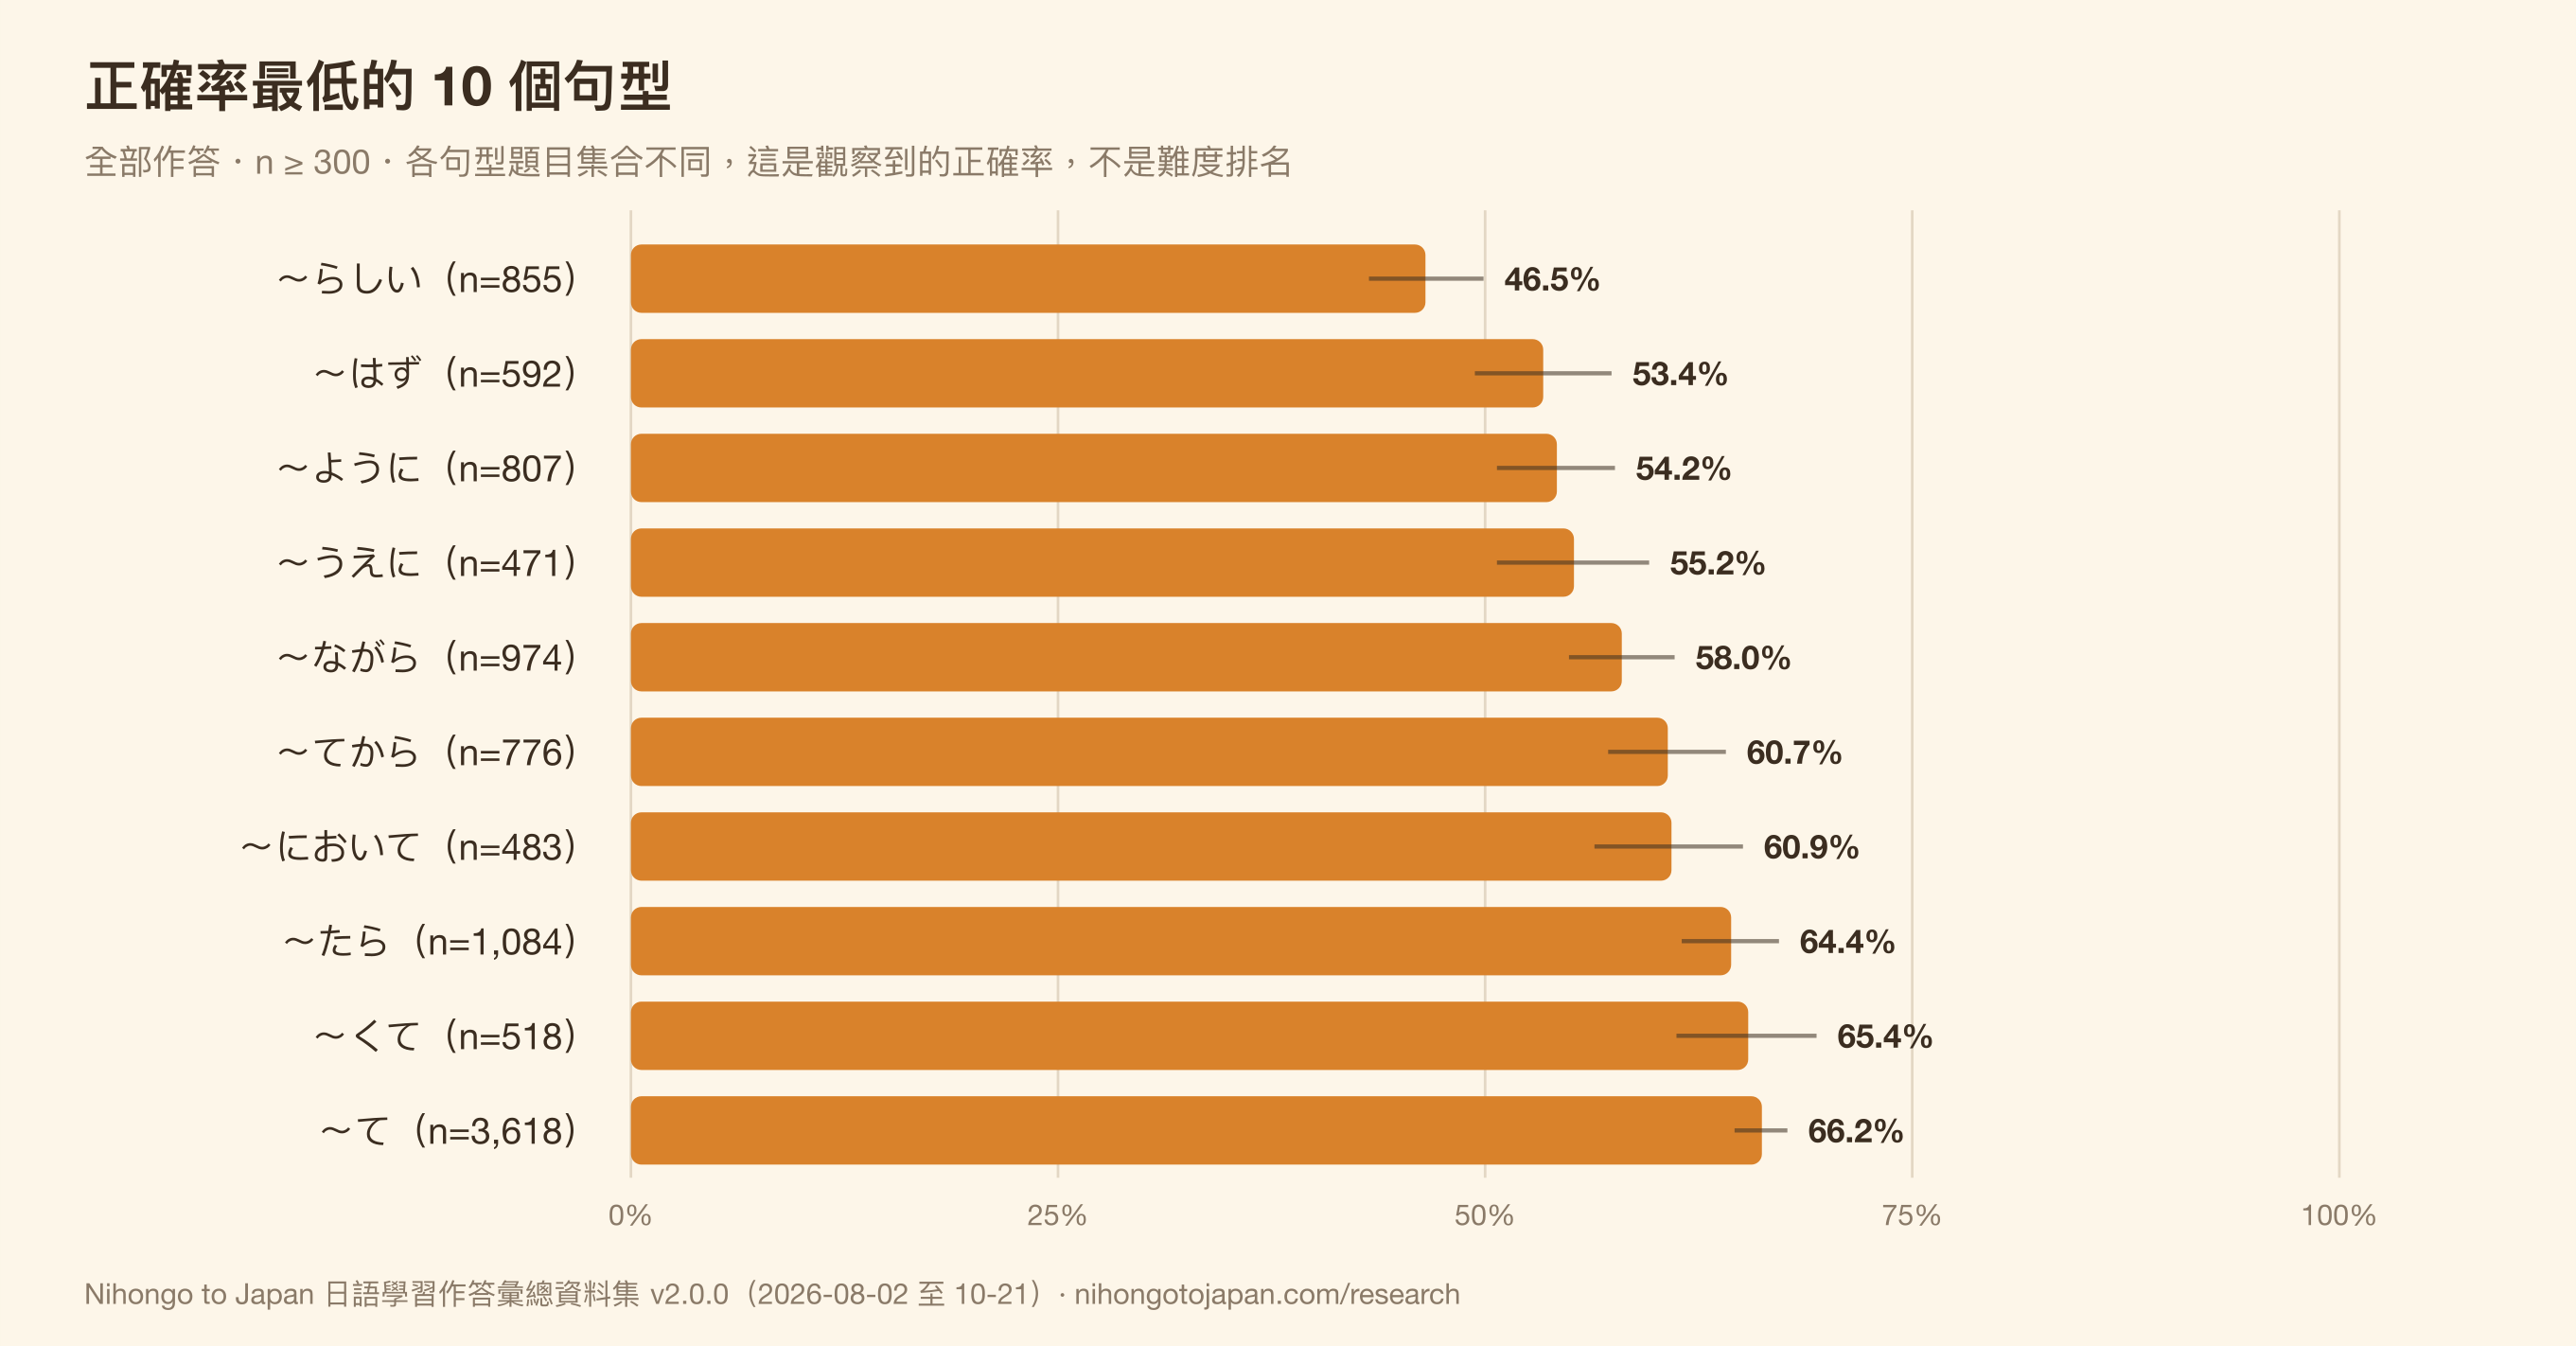
- 在 n ≥ 300 的句型中,全部作答正確率最低的是 〜らしい 46.5%(n=855)、〜はず 53.4%(n=592)、〜ように 54.2%(n=807)、〜うえに 55.2%(n=471)、〜ながら 58.0%(n=974)。
- 動詞變化題中,可能形 64.5%(n=1,923)最低,ます形 84.0%(n=2,270)最高;た形 70.7%、て形 74.1%、ない形 75.0% 介於其間。
- 以「每題一票」計算(7,057 道曝光 ≥20 的題目),詞彙題的平均首答正確率為 89.1%(95% CI 88.7–89.5%),句型題 73.9%(73.1–74.7%),助詞題 67.6%(64.9–70.4%)。
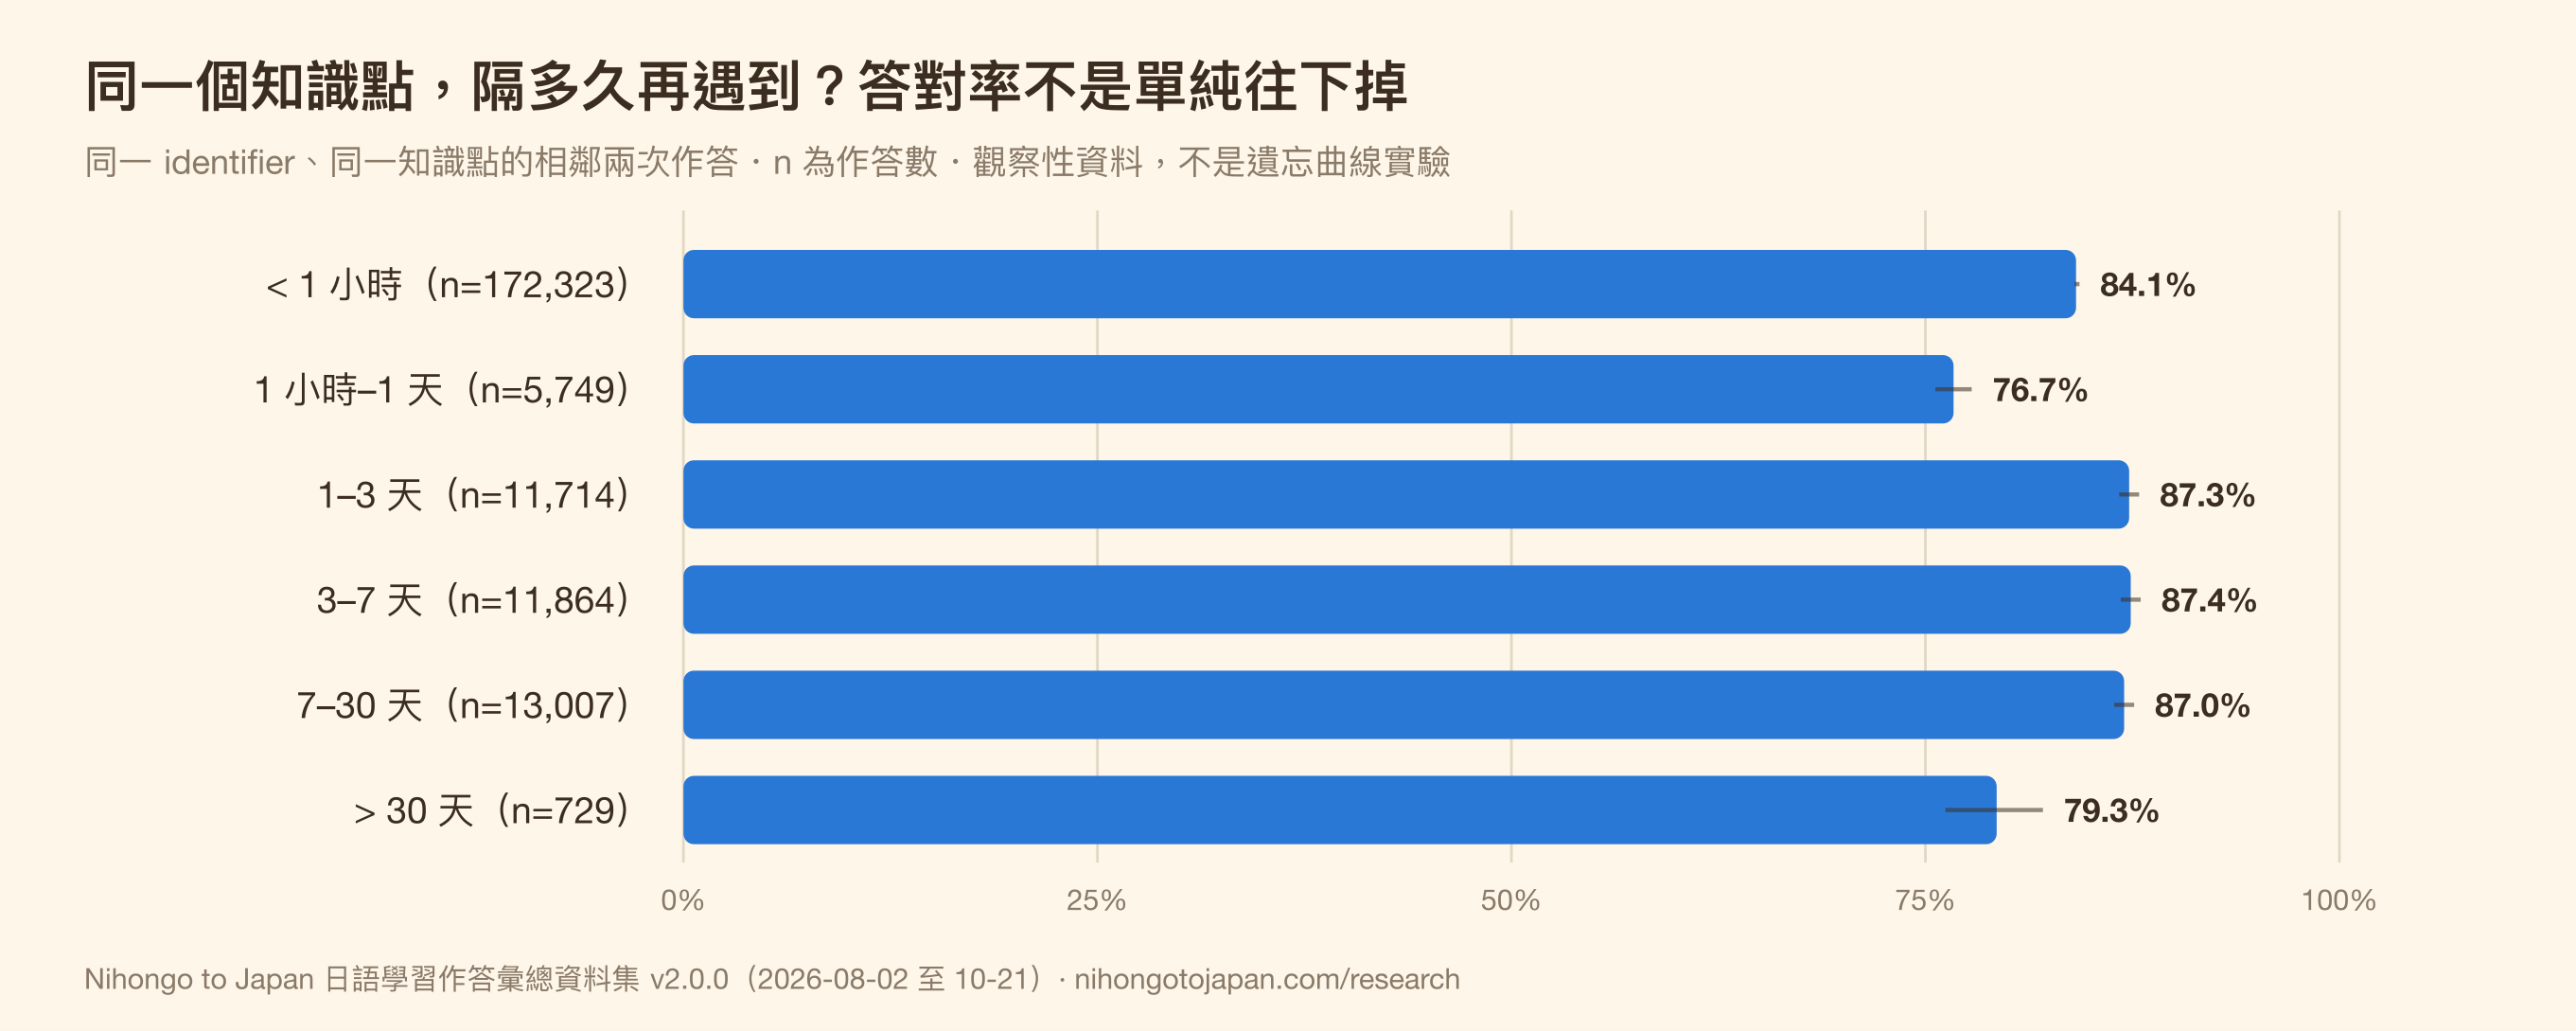
- 同一個 identifier 在同一個知識點的相鄰兩次作答中,間隔 1 小時以內的答對率為 84.1%,1 小時到 1 天為 76.7%,1–3 天、3–7 天、7–30 天都在 87.0–87.4%,超過 30 天為 79.3%(n=729)。答對率沒有隨間隔單調下降。
這是觀察性資料,誰會隔幾天回來本身就不是隨機的;不能解讀為「隔 1 天以上複習效果最好」。 - 7,057 道曝光 ≥20 的題目中,有 283 道(4.0%)首答正確率低於 35%(四選一亂猜約 25%)。這類題目常見的原因是選項中有第二個說得通的答案,已列入人工複查佇列。
- 本站的作答預測模型 v2,在 257,010 筆作答上的 Brier 分數為 0.199,比 v1 的 0.409 降低 51.4%;但仍高於「每次都猜全體答對率 79.9%」這個常數基準的 0.161。只有加入題目層級難度的版本(0.130)勝過常數基準。
一、五個主要發現
1. 「N1 比 N3 簡單」是選擇效應造成的錯覺
只看全部作答的原始正確率,N1(78.1%)高於 N3(75.3%)與 N2(74.8%)。這不合常理,但 v1 也看到同樣的現象。最可能的解釋是誰來作答:會去點 N1 題的人,本來就比較強。
v2 用能力校正後的難度重算:每一題都扣掉實際作答者的平均能力,換算成「一個平均程度的學習者」答對的機率。校正後 N1 的領先就消失了(N3 75.3%、N1 73.3%、N2 71.2%)。
要注意兩件事。第一,校正後 N1 和 N3 的區間仍有重疊,所以不能反過來說 N1 比 N3 難。第二,校正後 N5(78.0%)並沒有高於 N4(79.4%),代表這個校正只處理了「誰來作答」,處理不了「各級題目集合不同」——N5 進入分析的題目有 53% 是句型題,N4 只有 33%,而句型題本來就比詞彙題難答對。
2. 助詞的落差:で・が・に 比 を・の 低兩成
同樣是助詞,で(62.6%)、が(63.0%)、に(64.7%)三個的正確率比 を(80.6%)、の(85.2%)低了將近 20 個百分點。這三個助詞的共同點是一個助詞對應好幾種用法:で 可以是地點、手段、原因、範圍;に 可以是時間、目的地、對象、目的。
這和 v1 的觀察一致(v1:「助詞內部的落差比級別之間更大」),而 v2 的樣本量讓這個落差的方向更穩定。
3. 最難的句型集中在「推測」與「目的/狀態」
正確率最低的五個句型裡,〜らしい(46.5%)和〜はず(53.4%)都是推測、判斷的表現,常和〜そう、〜よう、〜みたい 混淆;〜ように(54.2%)同時有「目的」「變化」「請求」等多種用法;〜ながら(58.0%)則常被和〜て、〜まま 混用。
動詞變化也有類似的結構:可能形(64.5%)是五種變化中最低的。可能形的規則對一段動詞、五段動詞、不規則動詞各不相同,還要分辨「ら抜き」等口語形,題目常卡在這裡。
4. 隔一段時間再答,正確率沒有單純往下掉
把同一個 identifier 在同一個知識點的相鄰兩次作答配對,依間隔分組:
| 間隔 | 作答數 | identifiers | 正確率 |
|---|---|---|---|
| < 1 小時 | 172,323 | 3,472 | 84.1% |
| 1 小時–1 天 | 5,749 | 647 | 76.7% |
| 1–3 天 | 11,714 | 532 | 87.3% |
| 3–7 天 | 11,864 | 449 | 87.4% |
| 7–30 天 | 13,007 | 405 | 87.0% |
| > 30 天 | 729 | 126 | 79.3% |
教科書上的遺忘曲線是「間隔越長、越容易忘」。這裡看到的卻是 1 小時到 1 天最低、1 到 30 天反而最高。我們不把這解讀為「隔幾天複習效果最好」,因為誰會在隔幾天後回來本身就不是隨機的:持續回來練習的人,本來就比較投入、程度也可能比較好。1 小時到 1 天這一組只有 647 個 identifiers,也可能混入「當天換一台裝置再做一次」的情形。要回答間隔效果,需要隨機分派的實驗,這份資料做不到。
5. 預測模型進步了一半,但還沒贏過最簡單的基準
站上的題目推薦會先預測「你答對這題的機率」。我們用 Brier 分數(預測機率與實際結果的平方差,越低越好)評估它:
- v1 模型:0.409
- v2 模型:0.199(降低 51.4%)
- v2 加入題目層級難度:0.130(降低 68.1%)
- 對照:每次都猜全體答對率 79.9% 的常數基準:0.161
v2 雖然比 v1 進步了一半,整體仍輸給常數基準;只有加入題目層級難度之後才贏過它。我們把這個結果公開,是因為它直接說明了「題目本身的難度」比「學習者程度」更能預測答對與否——這也是第 1 點為什麼一定要做能力校正的原因。
二、資料集概觀
| 項目 | 數值 | 說明 |
|---|---|---|
| 有效作答事件 | 543,344 | 彙總快照 2026-10-21 19:18 UTC,彙總端點的 all_clean_events 口徑(已套用站方清理規則) |
| learner identifiers(至少一筆 A 級作答) | 5,410 | 彙總端點 totalUsers 的口徑 |
| learner identifiers(全部) | 8,073 | 社群統計端點的口徑;是自然人數的上界 |
| 被作答過的題目 | 25,850 | 其中 7,057 道曝光 ≥20,進入題目層級分析 |
| 有能力校正難度的題目 | 18,139 | Rasch 一步估計+Empirical-Bayes 收縮 |
| 證據等級 | A 59.8%・B 33.5%・C 6.7% | A=測驗情境;B=教材練習;C=其他(定義同 v1) |
| 涵蓋期間 | 2026-08-02 至 10-21 | 81 天 |
關於凍結時的即時計數:首頁顯示的「NTJ 學習者一起完成了 552,850 次練習」是社群統計端點在 2026-10-23 的即時數字,比本資料集多約 9,500 筆,差的是快照之後兩天新增的作答。引用時請以本資料集的 543,344 為準。
三、各能力軸向(全部作答)
| 軸向 | 作答數 | 正確率 | 每題一票首答(題數) |
|---|---|---|---|
| 詞彙 | 267,127 | 90.1% | 89.1%(3,398) |
| 句型/文法 | 234,602 | 75.2% | 73.9%(3,252) |
| 活用變化 | 18,479 | 75.2% | 76.2%(154) |
| 助詞 | 13,870 | 71.3% | 67.6%(189) |
| 慣用表現 | 7,413 | 88.1% | 92.4%(64) |
| 讀解 | 1,103 | 78.7% | — |
| 聽解 | 605 | 69.8% | — |
| 口說 | 118 | SUPPRESSED | — |
讀解、聽解、口說是較新的題型,樣本還少;口說低於 300 筆的門檻,只報作答數不報正確率。
四、各 JLPT 級別
| 級別 | 全部作答正確率(n) | 每題一票首答(題數) | 能力校正後預期答對率(95% CI) |
|---|---|---|---|
| N5 | 87.1%(297,809) | 82.6%(3,817) | 78.0%(77.3–78.7%) |
| N4 | 79.5%(93,609) | 84.5%(1,766) | 79.4%(78.6–80.2%) |
| N3 | 75.3%(82,010) | 75.7%(1,008) | 75.3%(74.2–76.3%) |
| N2 | 74.8%(36,837) | 66.9%(249) | 71.2%(68.4–73.9%) |
| N1 | 78.1%(33,082) | 74.2%(217) | 73.3%(70.2–76.3%) |
三欄的口徑不同,不能互相比較,只能各自在欄內比較。第一欄每一筆作答都算,包含重複練習,而且受各級題型比例影響;第二欄每題一票,不受練習次數影響;第三欄再扣掉作答者能力。
五、題目品質:我們自己的題庫也被量了
7,057 道曝光 ≥20 的題目,首答正確率的分布如下:
| 首答正確率 | 題數 |
|---|---|
| < 35% | 283 |
| 35–50% | 377 |
| 50–70% | 971 |
| 70–85% | 1,347 |
| 85–95% | 1,937 |
| ≥ 95% | 2,142 |
首答正確率低於 35% 的 283 題(4.0%)不一定是壞題,也可能只是真的難;但 8 月的人工複查發現,這一區常見「選項裡有第二個也說得通的答案」(例如「ピアノ_弾けます」が/を 都可)。系統另以負鑑別度等條件標記了 415 題進入人工複查佇列。這個旗標的精確度約 0.19,只能當複查清單,不能當「壞題」名單引用。
六、老師與教材設計者可以怎麼用
- 助詞教學:で・が・に 的正確率比 を・の 低約 20 個百分點。把一詞多義的助詞拆成「用法 × 例句」分開練習,比整體練習一個助詞更有針對性。
- 推測表現:〜らしい、〜はず 是本資料集裡最常答錯的句型,可以和〜そう、〜よう、〜みたい 放在一起做對比題。
- 可能形:五種動詞變化裡最低,值得按動詞種類分開練習。
- 看自己的數據時:如果你的平台也看到「高級題正確率比中級高」,先懷疑選擇效應,再懷疑題目。
七、方法
資料來源與可重現性
v2 的所有數字都來自以下六個公開端點,於 2026-10-23 取得並凍結:/api/aggregates?kind=summary、kind=items、kind=difficulty、kind=spacing、kind=brier,以及 /api/community?kind=overview。各端點的快照時間與輸入檔 sha256 都寫在 JSON 下載檔的 dataset.source_snapshot_at_utc 與 dataset.input_sha256。產生腳本是 scripts/build-research-dataset-2026-10.py,它接觸不到任何學習者層級資料。
五種分析集合
- 全部作答(能力軸、級別、知識點):每一筆有效作答都算,包含同一人重複作答。
- 每題一票的首答:每一題先算「每個 identifier 第一次作答」的正確率,再對題目取平均。只納入曝光 ≥20 的題目。95% CI 以題目為單位計算。
- 能力校正後難度:Rasch 一步估計 b̂=θ̄(實際作答者平均能力)−logit(p̂),再向同軸向的平均難度做 Empirical-Bayes 收縮(權重 n/(n+5)),換算成全站平均能力者的預期答錯率。我們報的是 1 − 預期答錯率。
- 相鄰作答配對(複習間隔):同一 identifier、同一知識點的相鄰兩次作答,只用 A、B 級證據。
- 預測準度:所有同時帶 v1 與 v2 預測值的 A 級作答(2026-08-20 起才有預測值欄位)。
最小格數規則
事件層級的格子 n < 300 不報正確率(SUPPRESSED);知識點只列 n ≥ 300;題目層級分析只納入曝光 ≥ 20 的題目。
信賴區間
事件層級的 Wilson 95% CI 沒有校正同一 identifier 的重複作答(公開端點不提供 identifier 層級資料),所以區間偏窄,只能當參考。題目層級的 CI 以題目為抽樣單位,是對「這個題庫」的區間,不是對學習者母體的區間。
匿名化
公開端點只回傳彙總值。本資料集沒有任何一筆原始作答事件、沒有 identifier、沒有時間戳記層級的資料。
八、限制(請務必一起引用)
- 自選觀察性樣本:只代表「主動來 NTJ 刷題的人」,不是任何學習者母體的代表性樣本。
- identifier 不等於人:瀏覽器端匿名識別碼,跨裝置無法合併;8,073 是人數的上界。
- 題目集合不同:各級別、各軸向、各知識點的題目不同,正確率差異不能直接讀成「這個文法比較難」。
- 全部作答口徑會被重複練習灌高:反覆練習的題目正確率較高。
- 能力校正有前提:Rasch 模型假設單一能力維度;能力估計只用作答數足夠的 identifier。
- 事件層級 CI 偏窄:見方法。
- 題目集合截斷:
kind=items依曝光由高到低最多回傳 25,000 題(總數 25,850),沒拿到的 850 題都是曝光最低的題目,不影響曝光 ≥20 的分析。 - 知識點只到前 100 個:彙總端點只回傳作答最多的 100 個知識點。
- 作答時間不可用:平均作答時間被「開著分頁不動」的極端值拉高,本資料集不報告作答時間。
- 無因果宣稱:本報告任何一句都不是「X 造成 Y」。
九、引用方式
歡迎在論文、研究報告、教學材料與新聞報導中引用。請註明來源、寫出版本號,並連結回本頁。
APA(7th)
Nihongo to Japan. (2026). 日語學習作答彙總資料集・2026 年 10 月 / Japanese learning answer dataset — October 2026 (Version 2.0.0) [Data set]. https://www.nihongotojapan.com/research/japanese-learning-data-2026-10MLA(9th)
Nihongo to Japan. 日語學習作答彙總資料集・2026 年 10 月. Version 2.0.0, 2026, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10.BibTeX
@misc{ntj_jlad_2026_10,

  title = {Japanese Learning Answer Dataset --- October 2026},

  author = {{Nihongo to Japan}},

  year = {2026},

  version = {2.0.0},

  note = {Snapshot 2026-10-21; aggregate statistics from 543,344 anonymous answer events, 2 August -- 21 October 2026},

  url = {https://www.nihongotojapan.com/research/japanese-learning-data-2026-10}

}
授權:資料採 CC BY 4.0
本資料集的資料採用 Creative Commons 姓名標示 4.0 國際(CC BY 4.0)。你可以自由重製、散布、改作與再發布,包含商業用途,唯一條件是適當標示出處並註明是否修改過。
⚠️ 授權範圍只到資料。受 CC BY 4.0 涵蓋的是:本頁的彙總統計數字,以及japanese-learning-2026-10.json與japanese-learning-2026-10.csv兩個下載檔。本站製作的圖表(SVG/PNG)與報告全文不在授權範圍內,仍保留權利。
標示方式
Nihongo to Japan,《日語學習作答彙總資料集・2026 年 10 月》v2.0.0, CC BY 4.0, https://www.nihongotojapan.com/research/japanese-learning-data-2026-10我們的請求(不是授權條件)
- 一併帶上樣本限制:自選觀察性樣本、非代表性。
- 寫出口徑:「全部作答」「每題一票首答」「能力校正後」三種數字差很多。
- 寫「learner identifiers」而不是「人數」。
- 寫出版本號(v2.0.0,snapshot 2026-10-21)。
⚠️ CC BY 是不可撤回的授權。任何依此條款取得資料的人,其權利不會因為本站日後變更條款而失效。
十、下載資料
- japanese-learning-2026-10.json — 完整後設資料、輸入檔 sha256、門檻與全部彙總格。
- japanese-learning-2026-10.csv — 一列一格,欄位:
table, key, n, value, ci95_low, ci95_high, unit, note。 - japanese-learning-2026-10-LICENSE.txt — 授權聲明。
圖表檔案(PNG 為 2 倍解析度,SVG 可縮放;圖表不在 CC BY 範圍,轉載請先來信):
替代文字集中在 alt-text.json。
媒體與資料聯絡窗口
需要更細的切分、發現數字有誤,或想引用但不確定口徑,請來信 [email protected],標題請註明「資料集 v2.0.0」。
版本與更新紀錄
| 版本 | snapshot | 涵蓋期間 | 說明 |
|---|---|---|---|
| v2.0.0 | 2026-10-21 | 2026-08-02 至 10-21(81 天) | 本頁。改用公開彙總端點;新增能力校正難度、複習間隔、題目品質、預測準度。 |
| v1.1.0 | 2026-08-14 | 2026-08-02 至 08-13(12 天) | 首次公開。主要分析集合為「測驗情境首答」。數字維持不變,可繼續引用。 |